
TRELLIS.2 预处理:透明图裁切范围
先查看罐盖、灯杆的 Alpha 边界,准备两种留白输入,在当前 pipeline.preprocess_image 路径保存真实处理图。
阅读文章正在打开页面…
正在加载内容,请稍候。
从 API Key、Base URL 配置到首次调用,按工具查找接入步骤与常见报错;也可浏览图像、视频、自动化和办公任务教程。
获取 API Key1450 篇教程,当前显示第 529–576 篇。选择页码继续浏览,或切换任务主题。
先查看罐盖、灯杆的 Alpha 边界,准备两种留白输入,在当前 pipeline.preprocess_image 路径保存真实处理图。
阅读文章
先读取本机 GPU、CUDA、PyTorch 和模型版本,对照官方运行前提,再选最小真实任务。把 H100 公开基准和本机时间分开记录;没有兼容硬件就标未运行,不能反复重装冒充已跑通。
阅读文章
固定同一输入和随机种子,B 组只把 tex_steps 改为 24,C 组再单独改变形状阶段。每组保存真实配置、输出和耗时,分别比较几何与贴图;不要同时改多项后把差异归因于一步数。
阅读文章
把体素分辨率、贴图尺寸、导出目标面数列为三个独立参数,读取当前 demo 的实际范围后每次只改一个。导出重载并测真实文件,不以控件数值直接推断几何或纹理质量。
阅读文章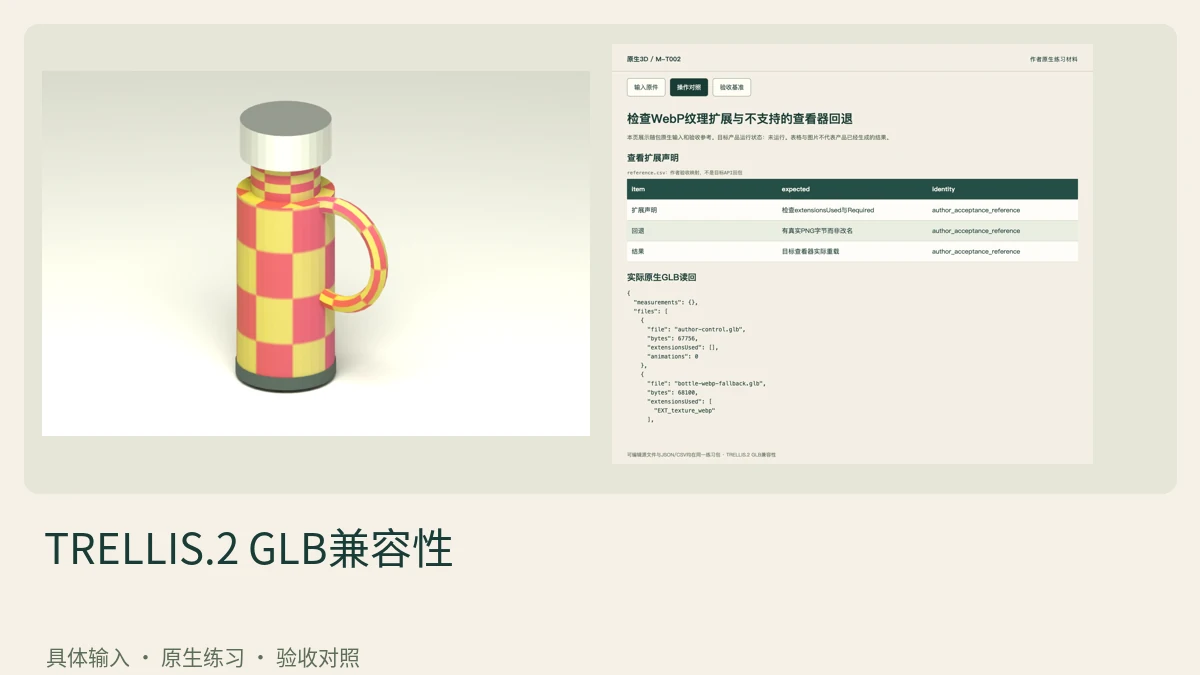
解析 GLB 的扩展、textures 和 image MIME,确认 WebP 实际引用与回退图片。到不支持目标扩展的查看器重载测试;文件名后缀不能证明编码,声明扩展也不代表所有查看器都支持。
阅读文章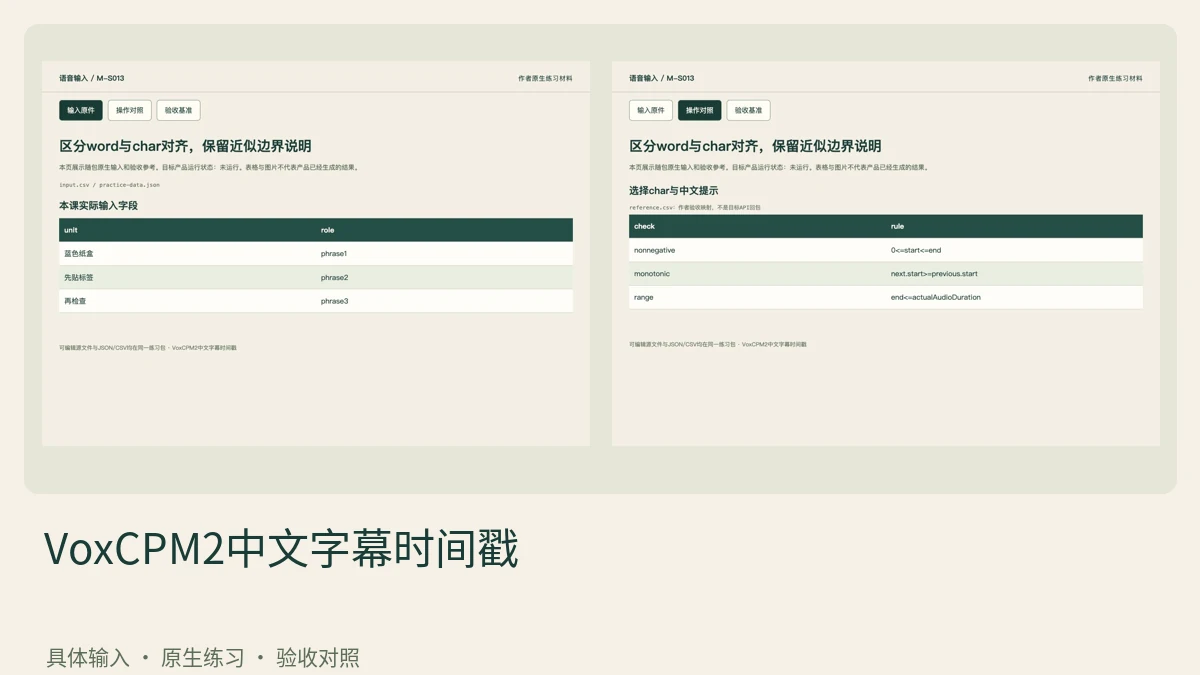
生成时启用--timestamps,设--timestamp-level char和--timestamp-language zh。另留word级对照配置,避免认为char只是文件扩展名。
阅读文章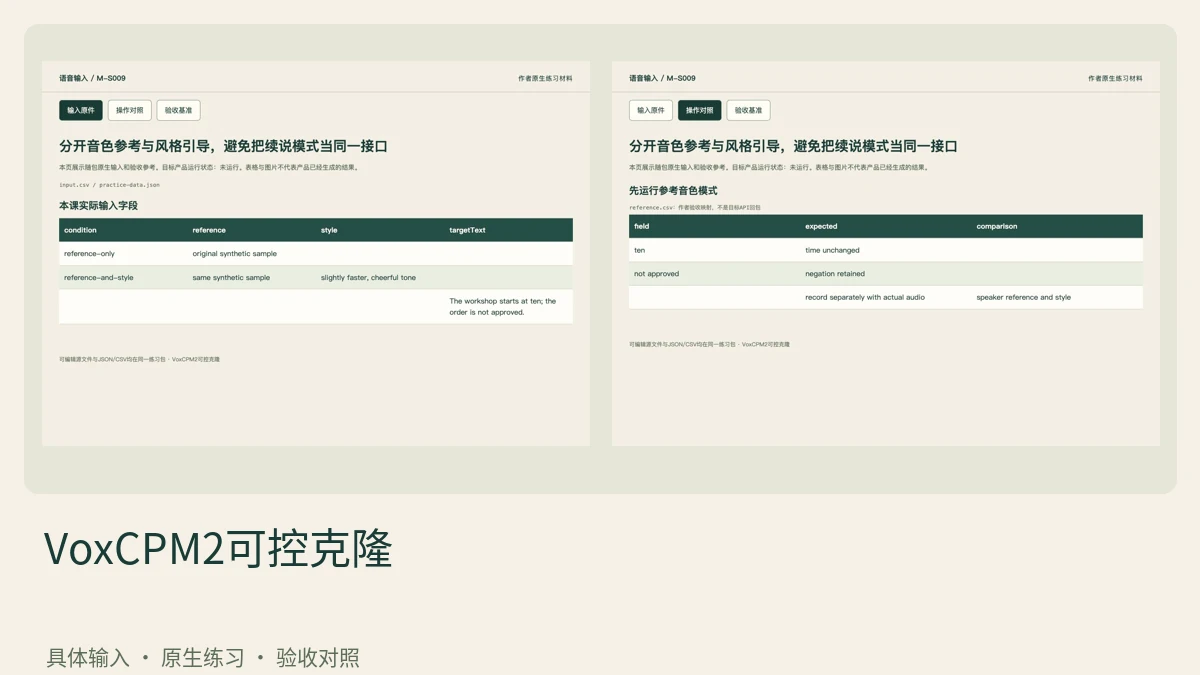
按当前官方API把参考路径放到reference_wav_path,text只填新台词。不要为这轮无意附加prompt_wav_path与prompt_text,后者属于音频续说式配置。
阅读文章
把三种语言分成独立文本,按官方 text 入口直接传入并固定参考和设备。分别回听实际内容,不插入接口不存在的语言标签;第三方包装参数不能冒充模型原生约定。
阅读文章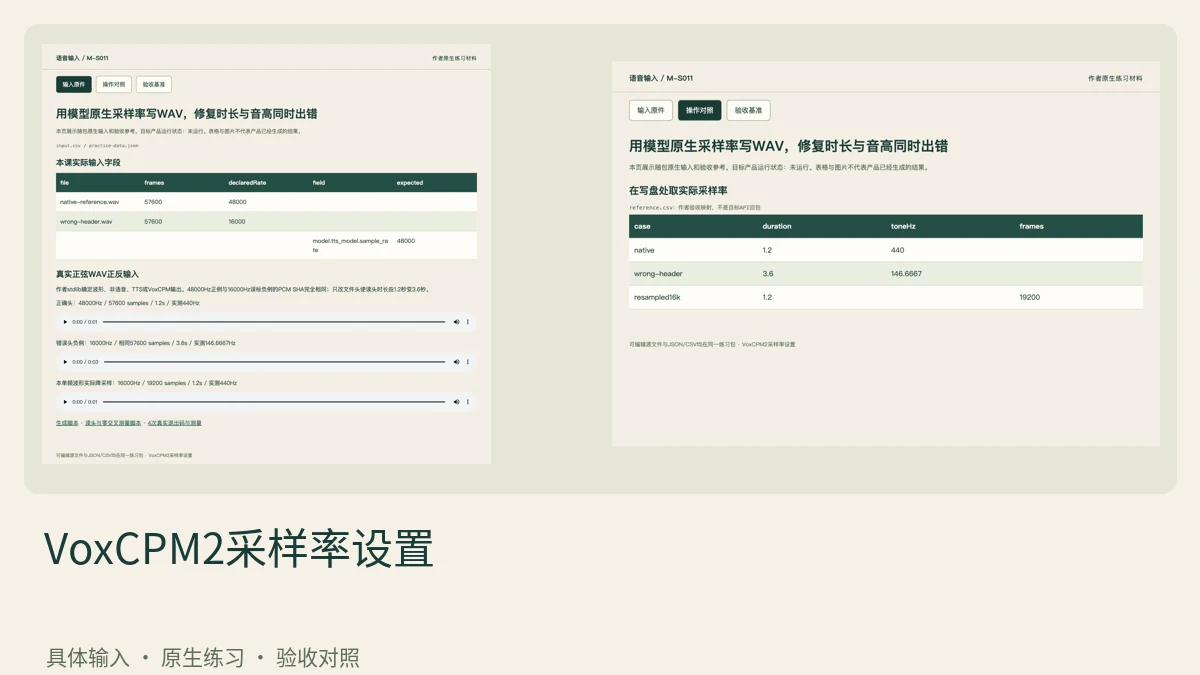
把生成的PCM与模型实际sample_rate一同传给sf.write。保存运行版本和该值,别在多个模块分别硬编码不同常量。
阅读文章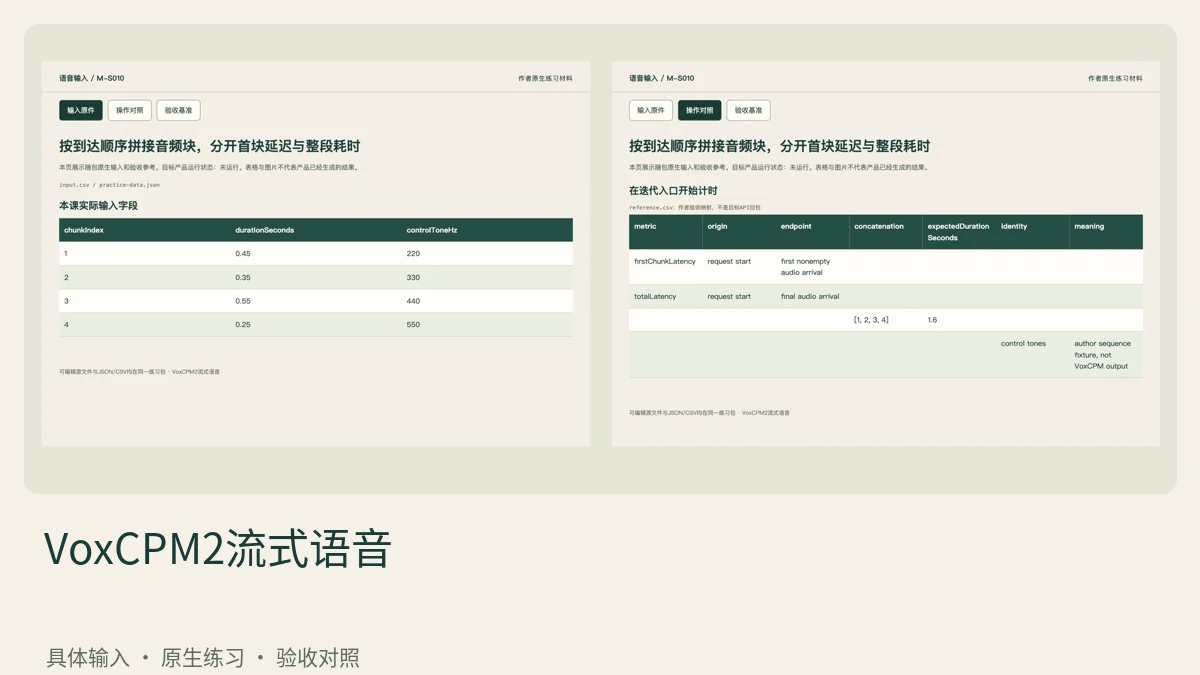
调用前记录单调时钟起点,每收到一块就保存到达序号、样本数与时间,再按原顺序拼 PCM。分别计算首块延迟与整段耗时,检查拼接边界;离线块样例不是在线性能实测。
阅读文章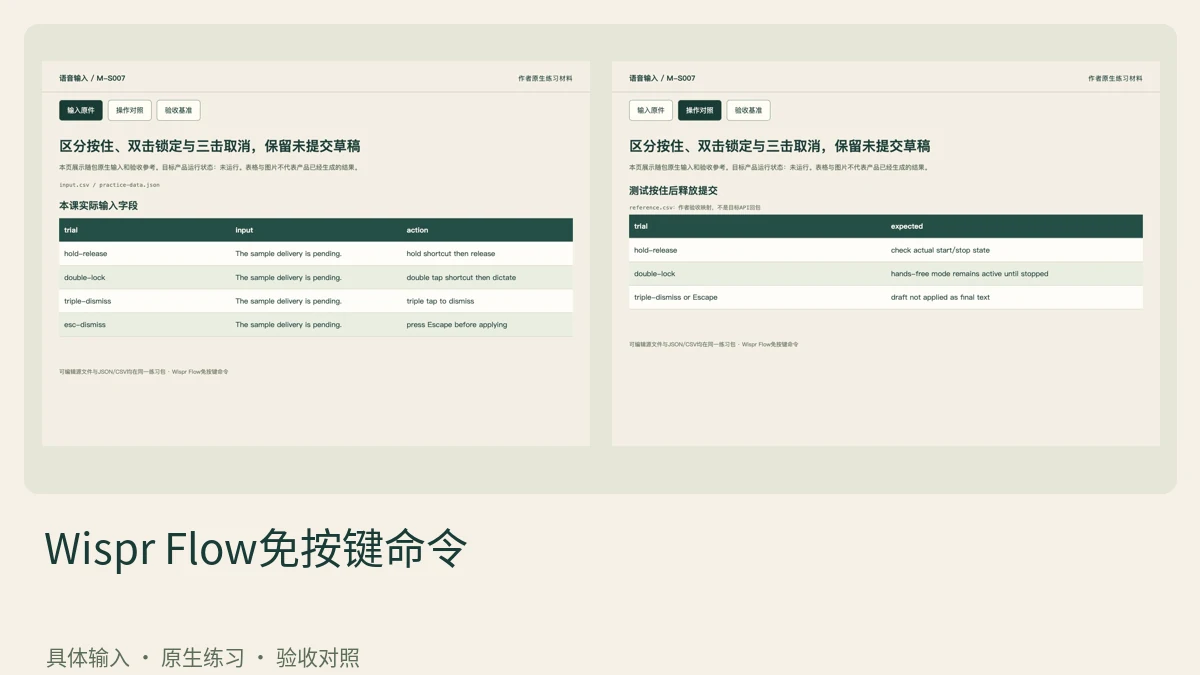
按住快捷键说一条短指令,释放后观察是否开始处理。非常快释放可能只结束会话,实际发生什么要留记录。
阅读文章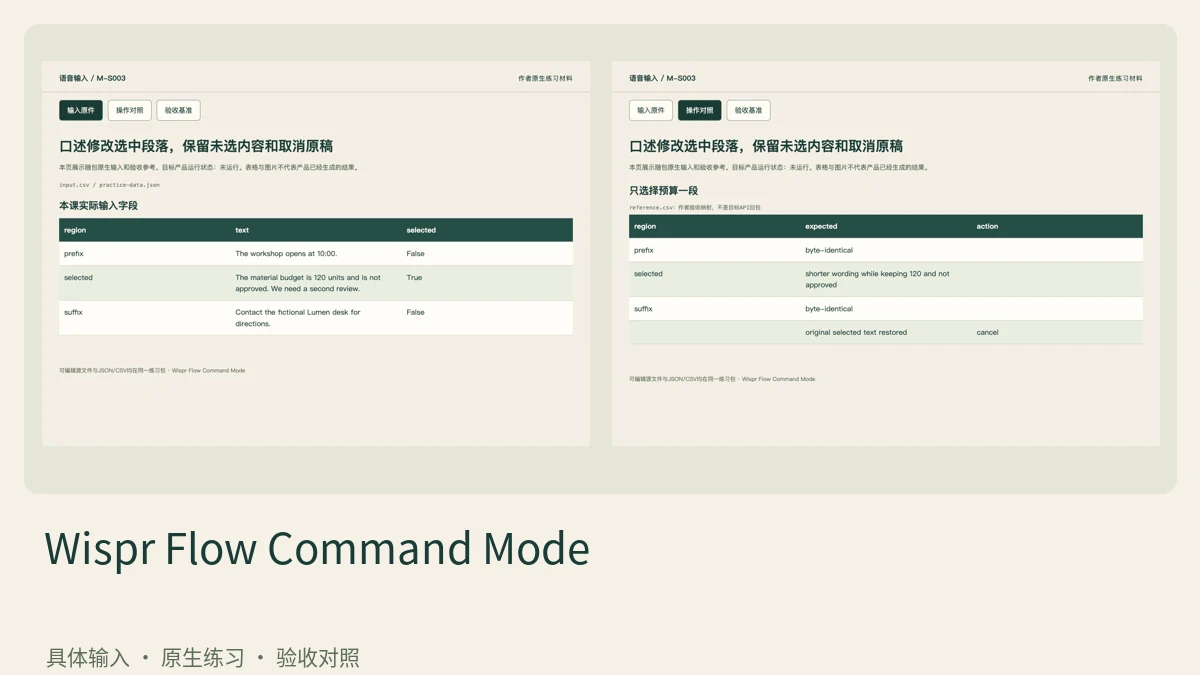
用鼠标选中预算段落,不要把标题、联系人或空白尾段一并选入。拍下选区和相邻文字,给后续差异核对留证据。
阅读文章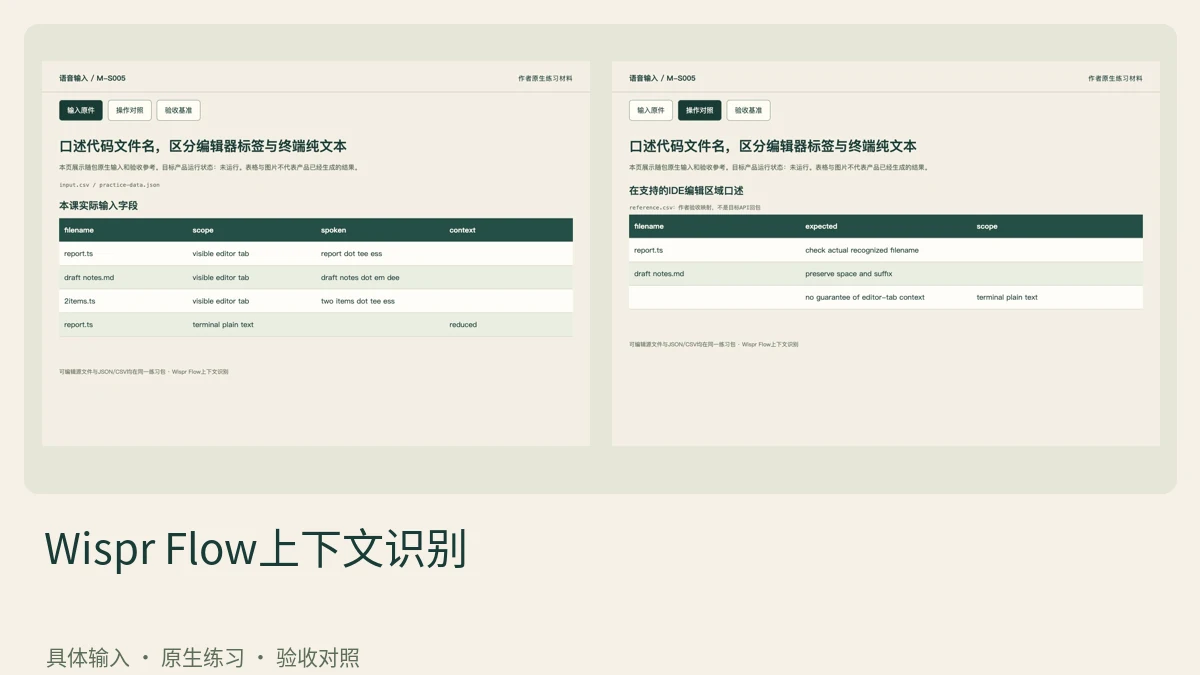
Wispr Flow上下文识别按本课具体材料完成口述代码文件名,区分编辑器标签与终端纯文本。包含七步操作、输入与异常对照、专属配图和可编辑练习材料,账号功能与本地检查分别记录。
阅读文章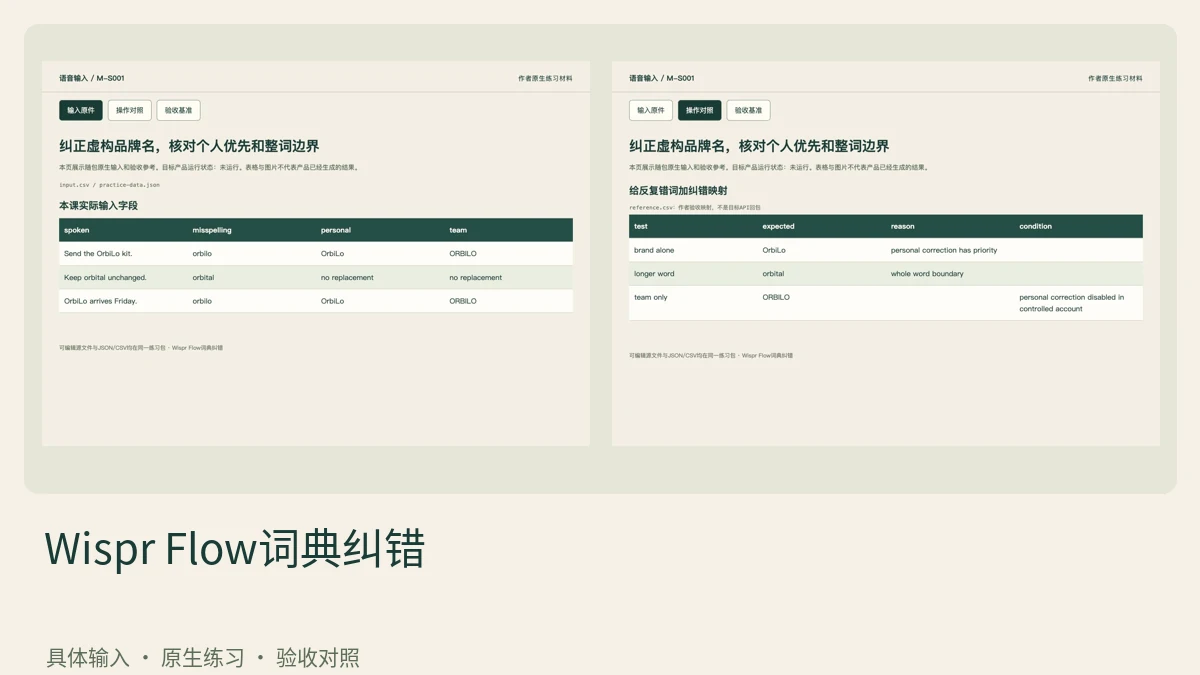
若原输出持续为orbilo,在新增条目启用Correct a misspelling,填错形与期望拼写。每个条目只持有一组纠错,先确认不是改了另一条团队词。
阅读文章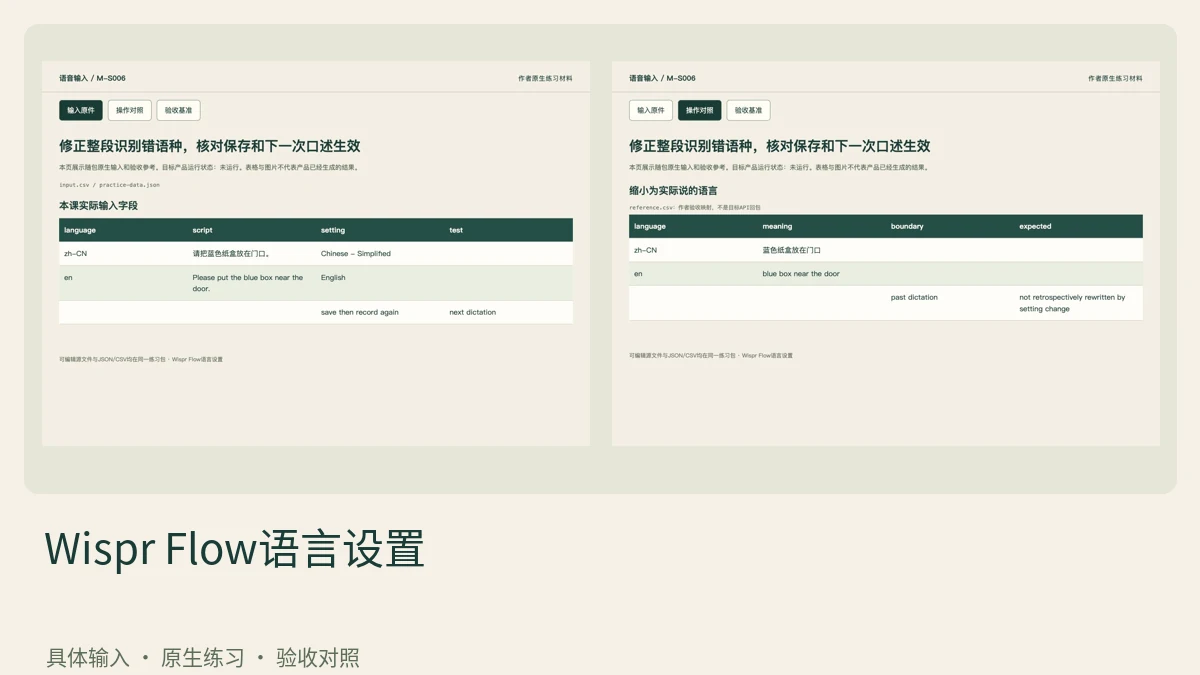
在桌面Settings的General进入Languages,关闭自动识别并只留Chinese-Simplified。选择同组变体会替换旧变体,核对最终列表而不是只看刚点过的行。
阅读文章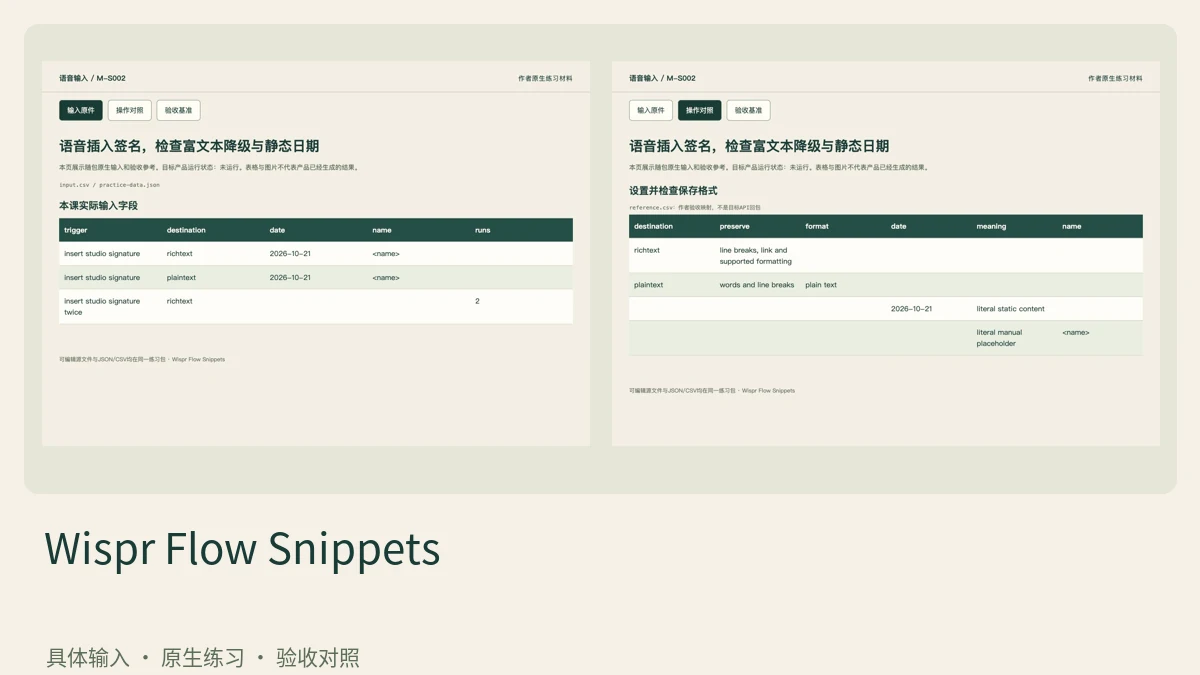
在 Snippets 建独特触发短语,为工作室名设置粗体、官网设置实际链接,再分别插入富文本和纯文本框。检查格式降级与静态日期;换行不等于富文本,文本中的日期不会自动变为当天。
阅读文章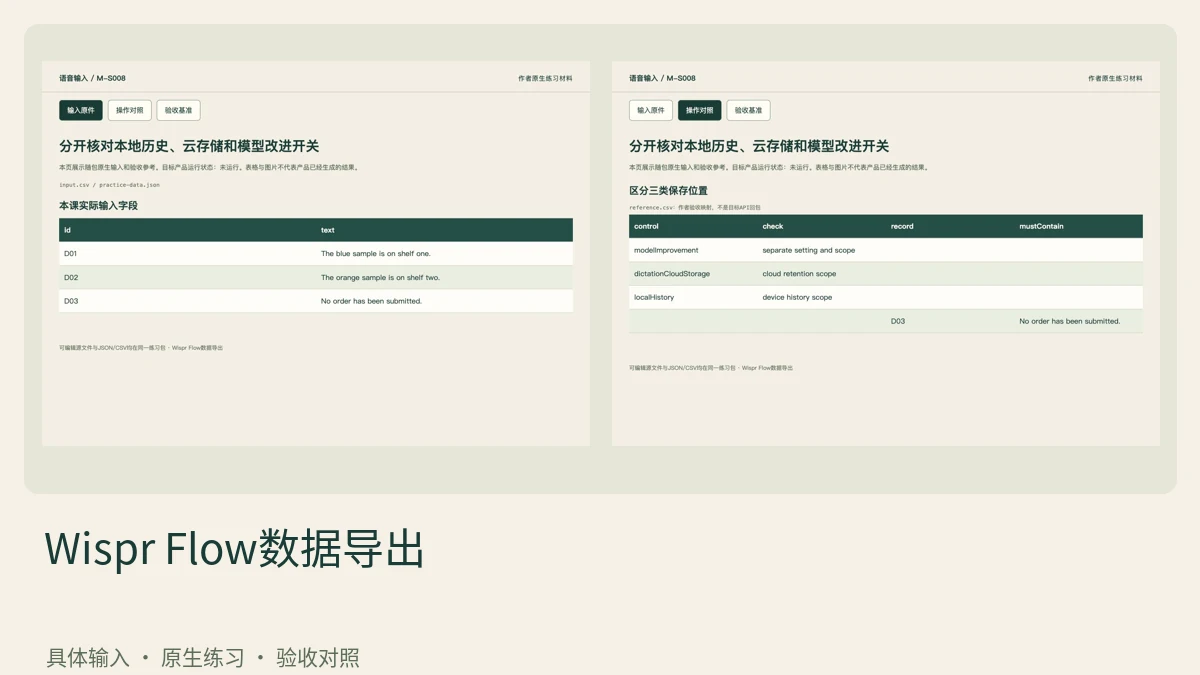
把设备上的本地口述历史、Wispr保留的云端口述和词典片段分成不同栏。会议Notetaker与Scratchpad也有独立范围,不用单一口述开关推断全部数据。
阅读文章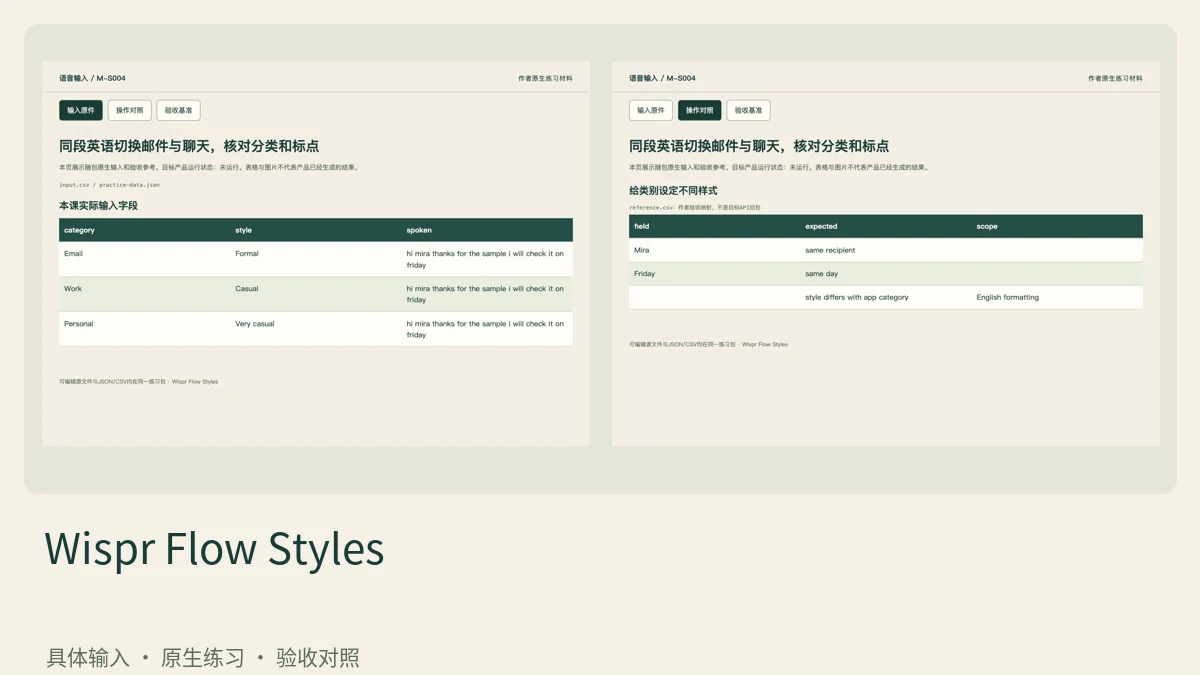
在桌面给Email选Formal、Personal选very casual,Work另选可用样式。桌面卡片即点即存,iOS某些布局需Save,按实际界面完成。
阅读文章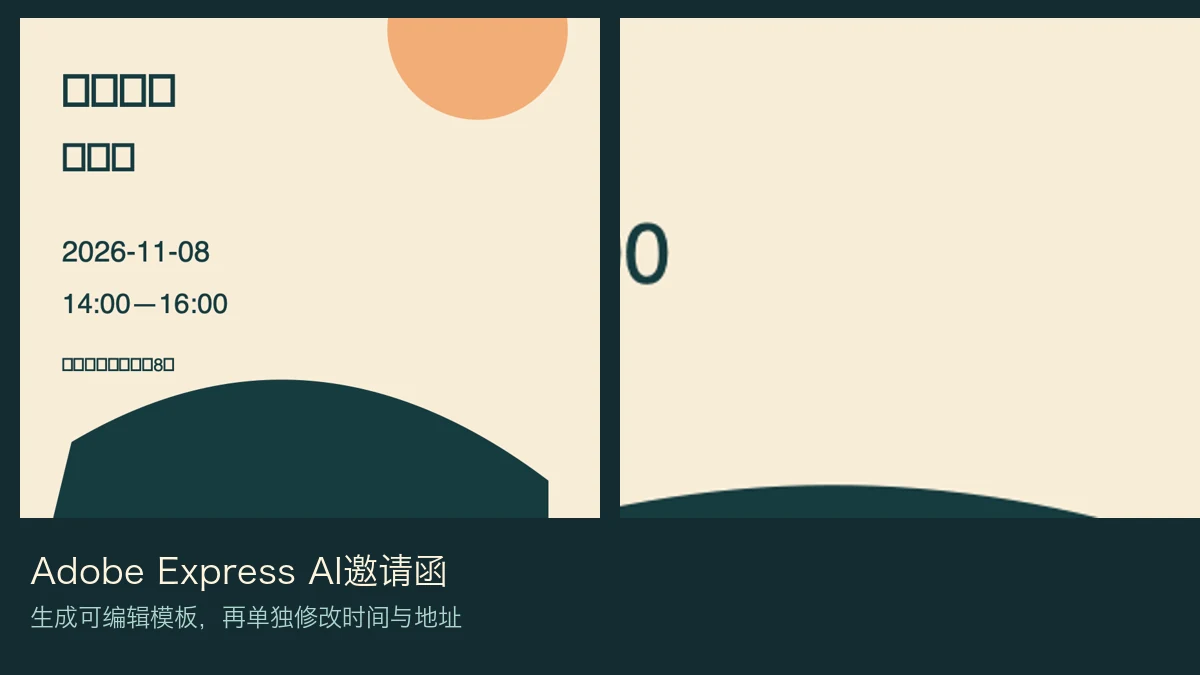
固定活动名称、日期、地址后运行 Generate template,选择候选进入 Edit template,分别修改时间与地点。
阅读文章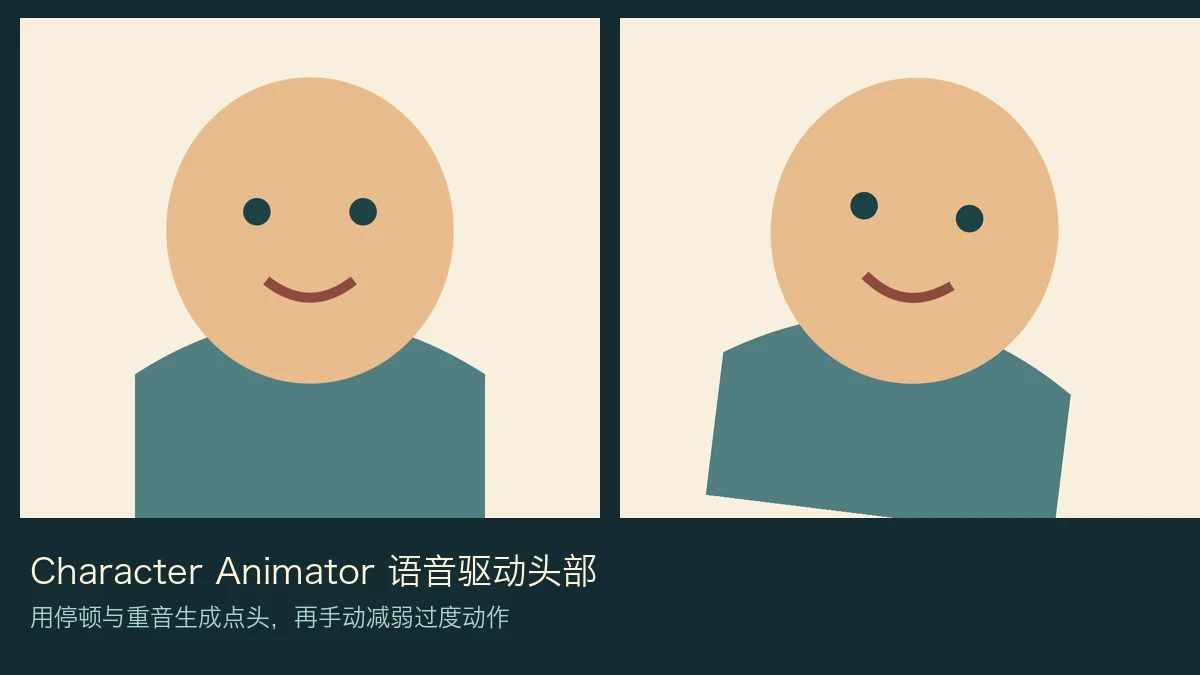
导入分层木偶和带停顿、重音的自有音频,运行 Speech 头部计算并保留原 take。先看未调整版,再减弱过度点头;长期功能文档不能用来证明近期搜索热度。
阅读文章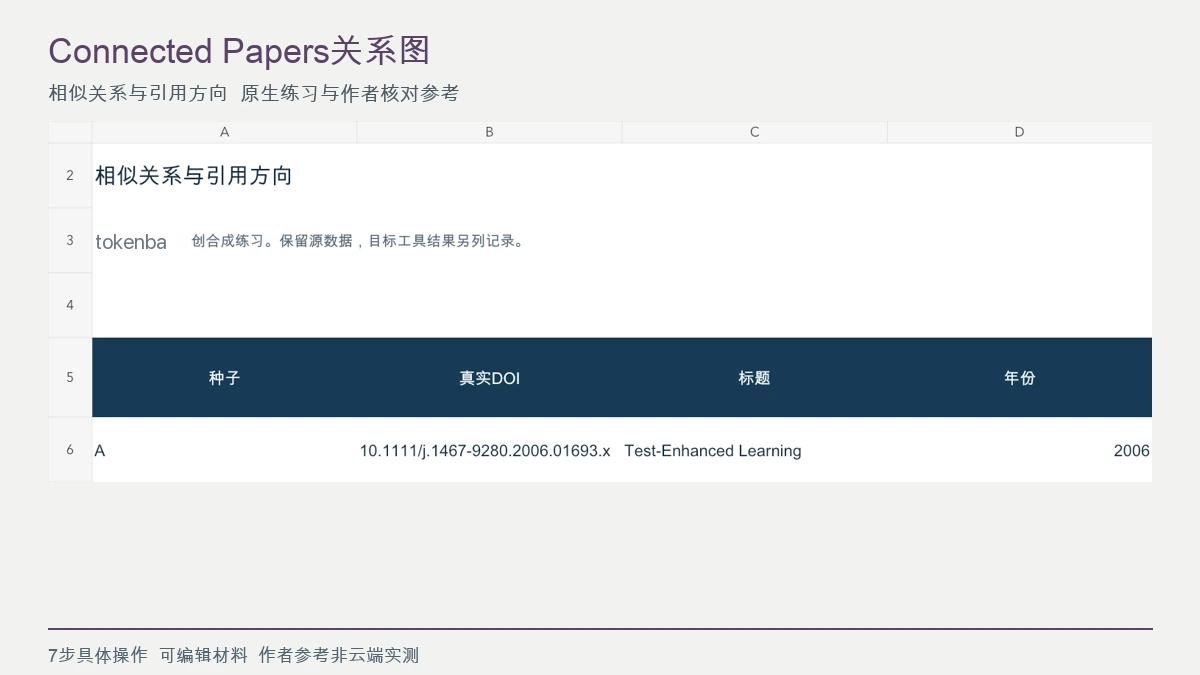
Connected Papers相似图和直接引用图不能混读;Prior、Derivative两份候选清单需分别回源核对方向。
阅读文章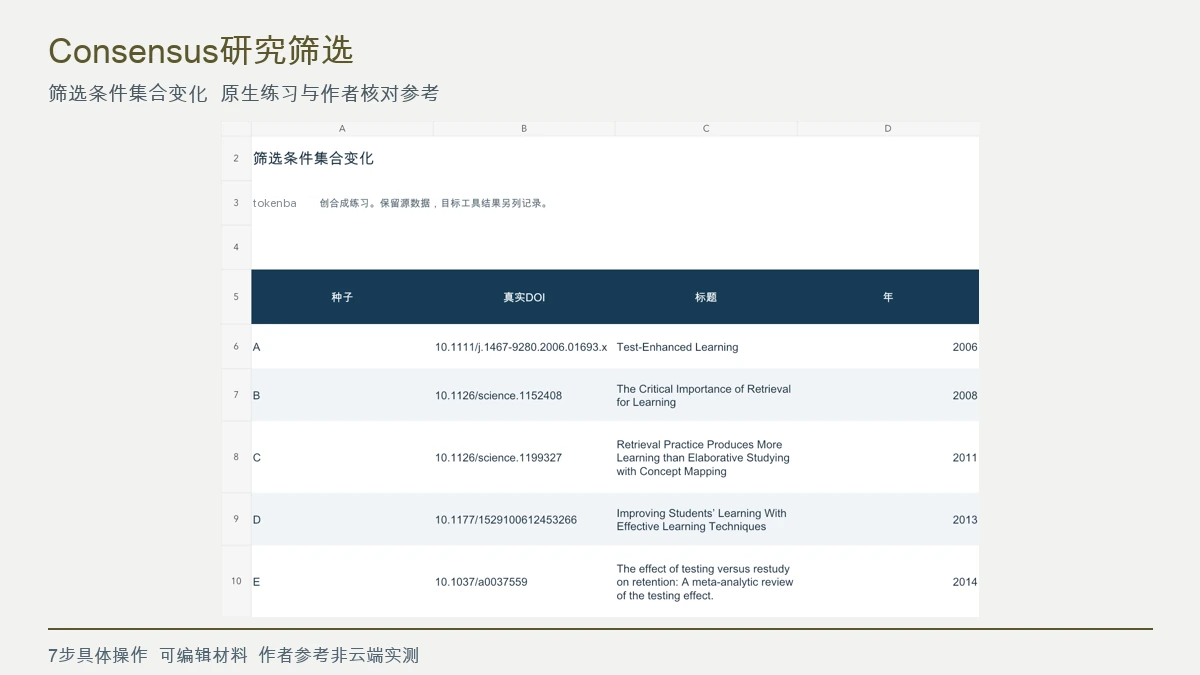
在 Consensus 保留未过滤的 S0 结果,再分别按研究类型、受试对象与开放获取建立独立集合,最后组合筛选。逐条回原文说明保留与排除理由,开放获取不代表研究质量更高。
阅读文章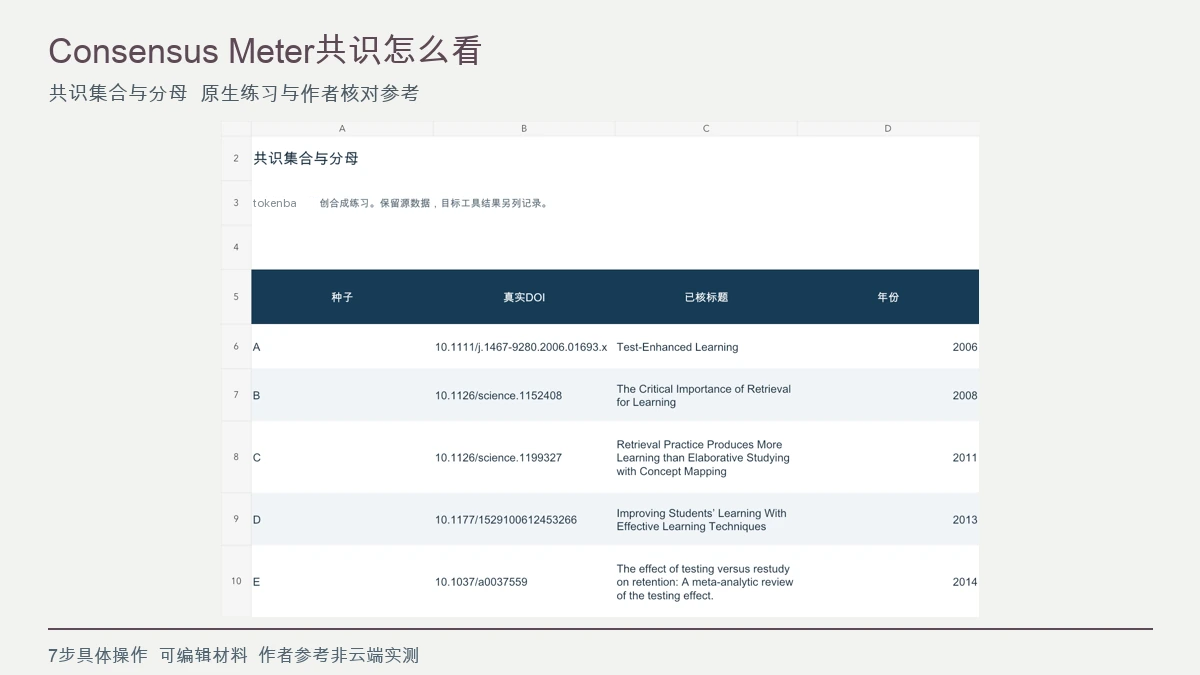
先看哪些研究进入分母,再读Yes、No、Possibly的原文条件;Meter百分比不等于总体真理概率。
阅读文章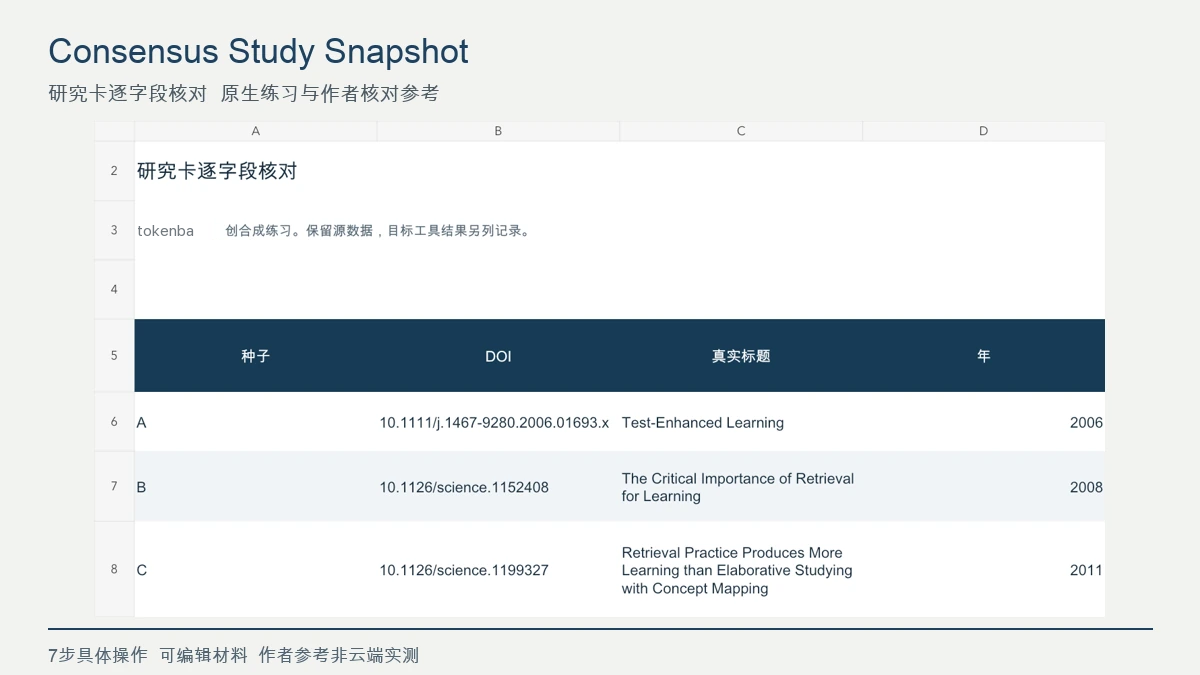
从真实研究卡记录设计、招募样本、分析样本与结果字段,逐项回论文原文定位条件和时间。分清不同分母并保留缺失项;Snapshot 是阅读入口,不是替代论文证据的最终结论。
阅读文章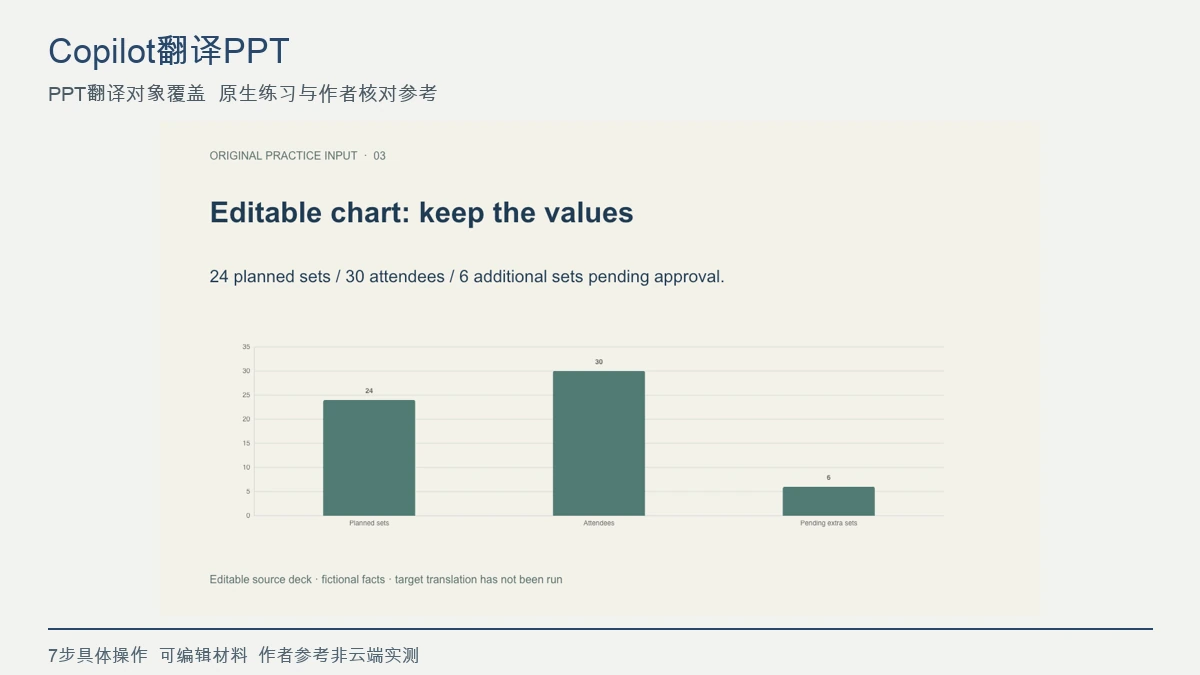
翻译副本应保留六页顺序与24/30/6数值;图片文字和备注按实际支持列为单独检查,不承诺全部自动翻译。
阅读文章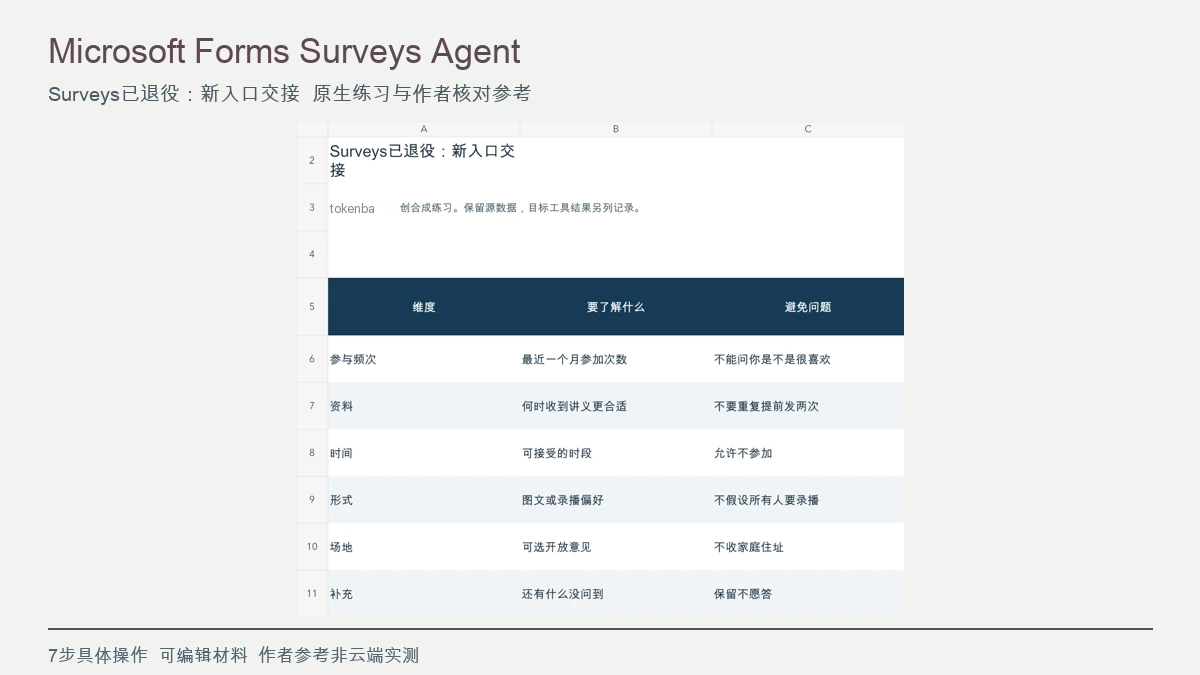
Microsoft Forms Surveys Agent:核对Surveys Agent退役说明,将六维度目标交接到Forms内集成Copilot,分别验证画布改动、受众和未发送状态。含7个操作步骤、对应输入与核对配图、独立缩略图及可编辑原生练习包。
阅读文章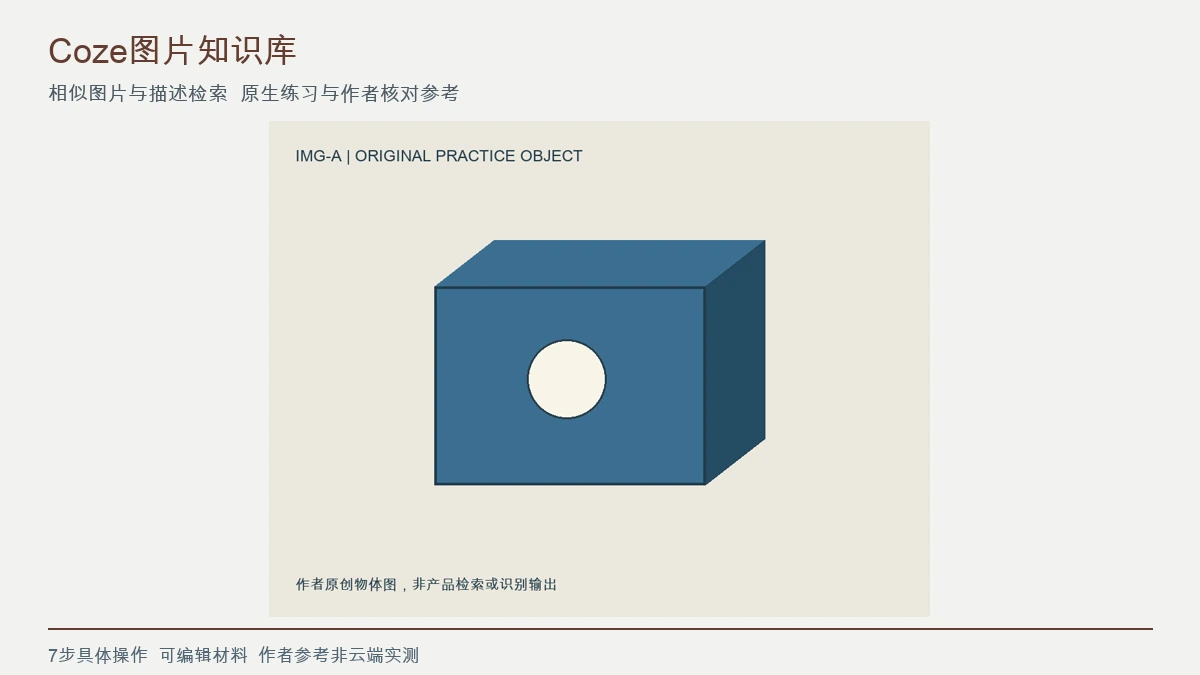
把四张原创物体图加入获授权知识库,为近似外观写区分性描述。先用精确查询,再用含糊与相似反例测试,回看实际原图;新生成图不能当作知识库检索命中。
阅读文章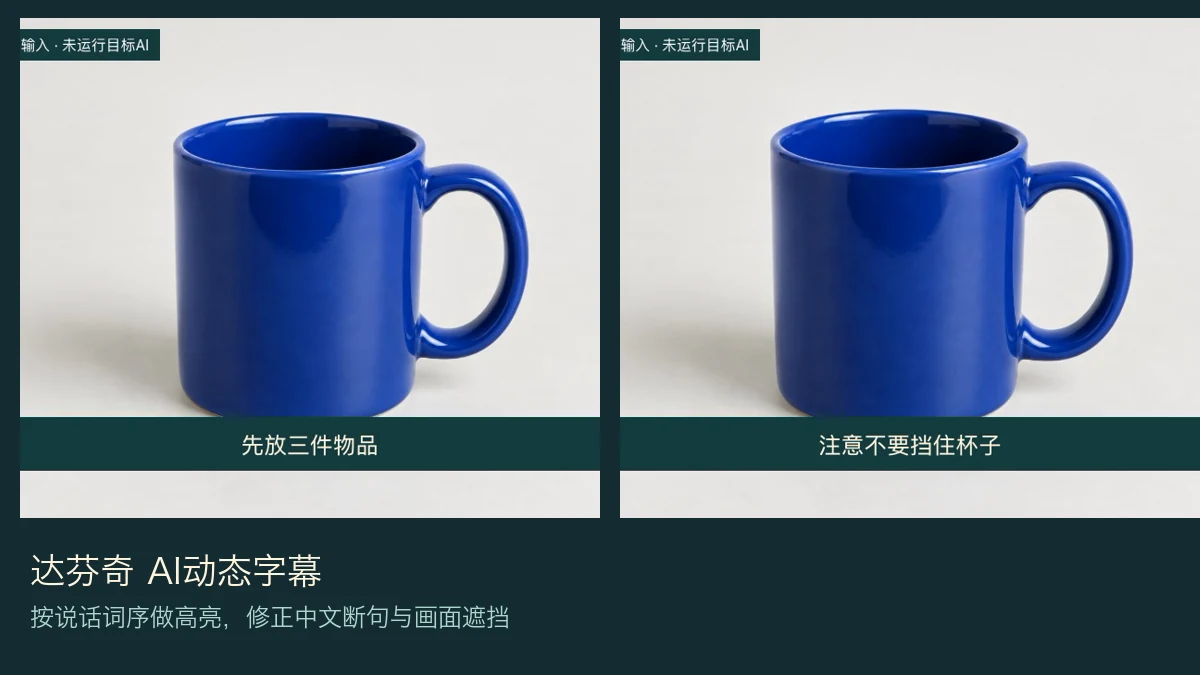
在达芬奇将自己的中文口播转录为字幕,选择当前可用的 AI Animated Subtitles 样式。纠正三件、二十四个等分词与数字,逐词回听高亮和停顿,再检查竖屏字幕不遮手部与商品。
阅读文章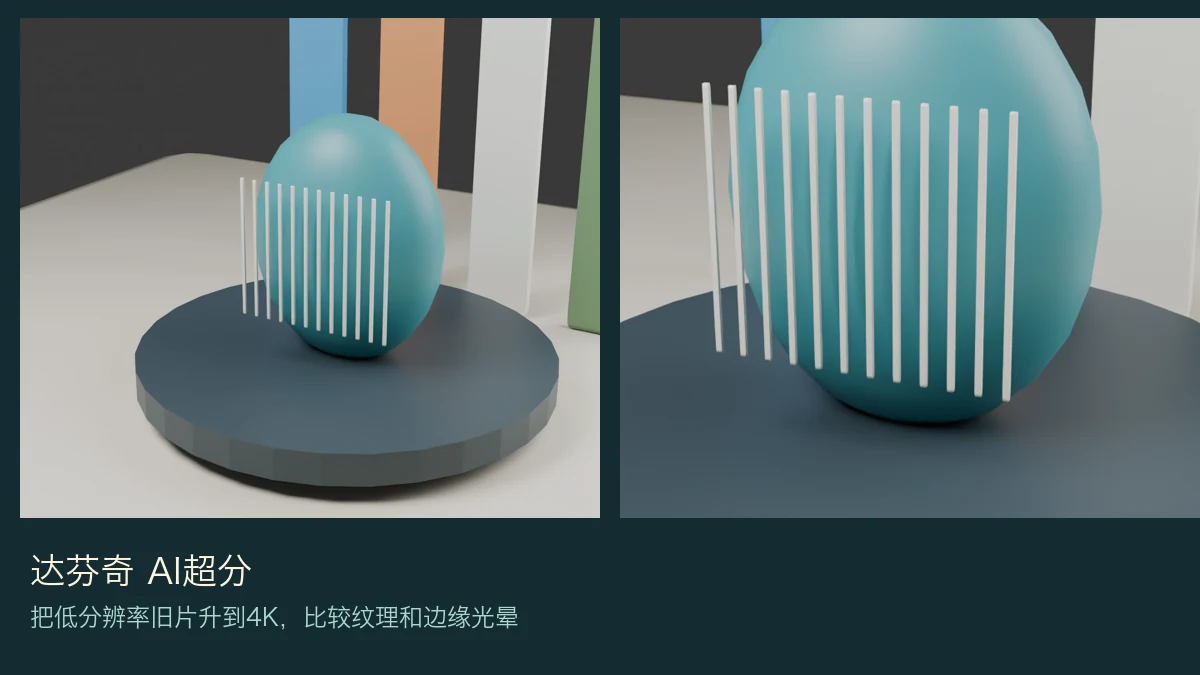
在同一 4K 时间线为低分辨率片分别导出普通缩放和 Super Scale 两版,固定帧率、裁切与色彩。对照同景高清参考,检查细条纹、轮廓光晕与运动闪烁,不能只凭单帧更锐判断修复成功。
阅读文章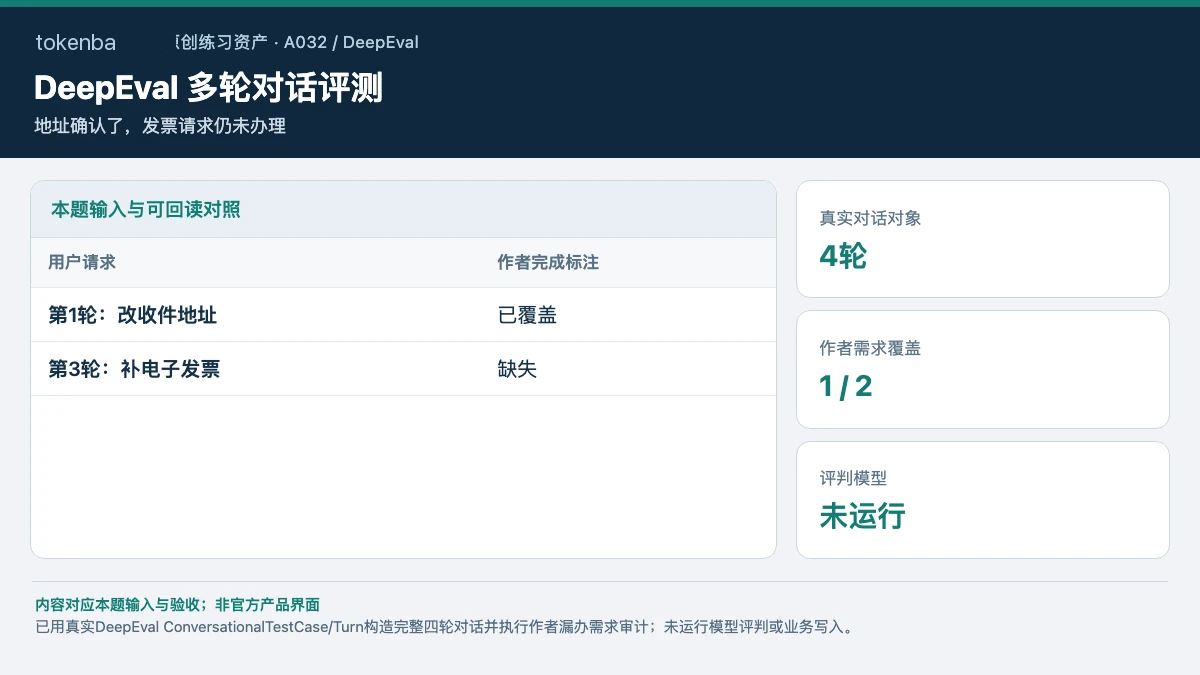
把完整四轮角色与顺序传入ConversationalTestCase,先列改地址和发票两项请求,再核对各自完成证据。指标应定位漏办的invoice,不凭末句流畅度打分;模型评价与真实业务回执分别保存。
阅读文章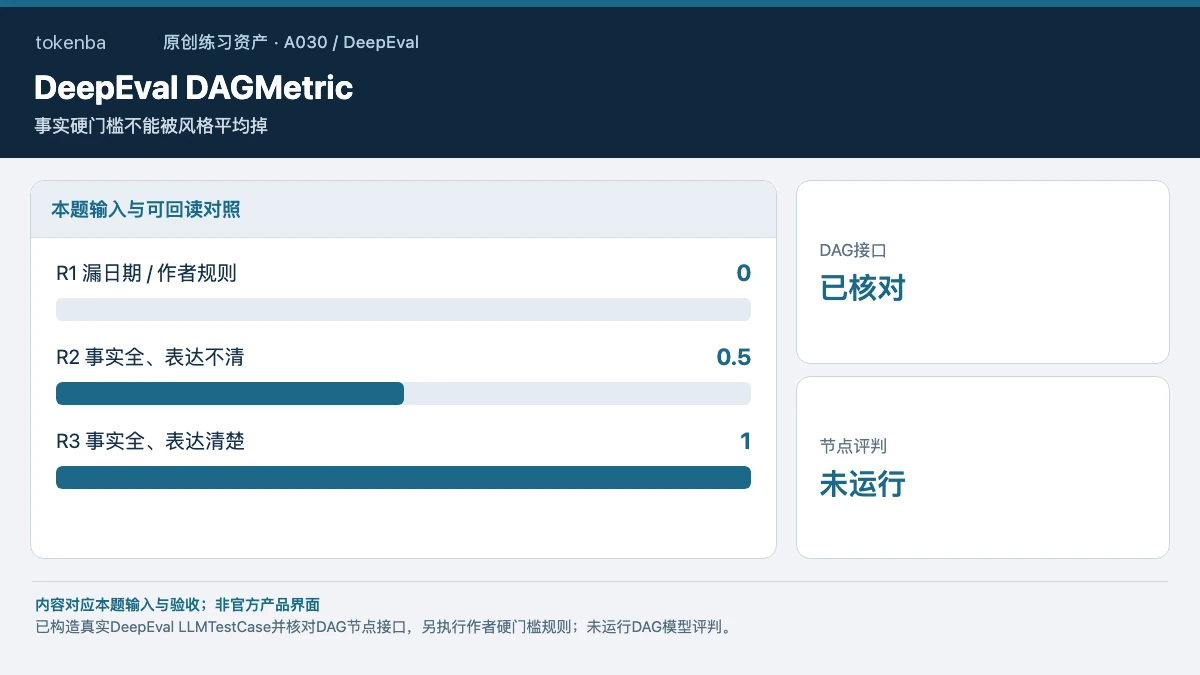
在 DeepEval 建立先验收必需事实、再评表达质量的 DAGMetric。对缺日期但文风好的 R1 先走失败门槛,完整答案再进入风格分支,逐节点保存真实判断路径与原文。
阅读文章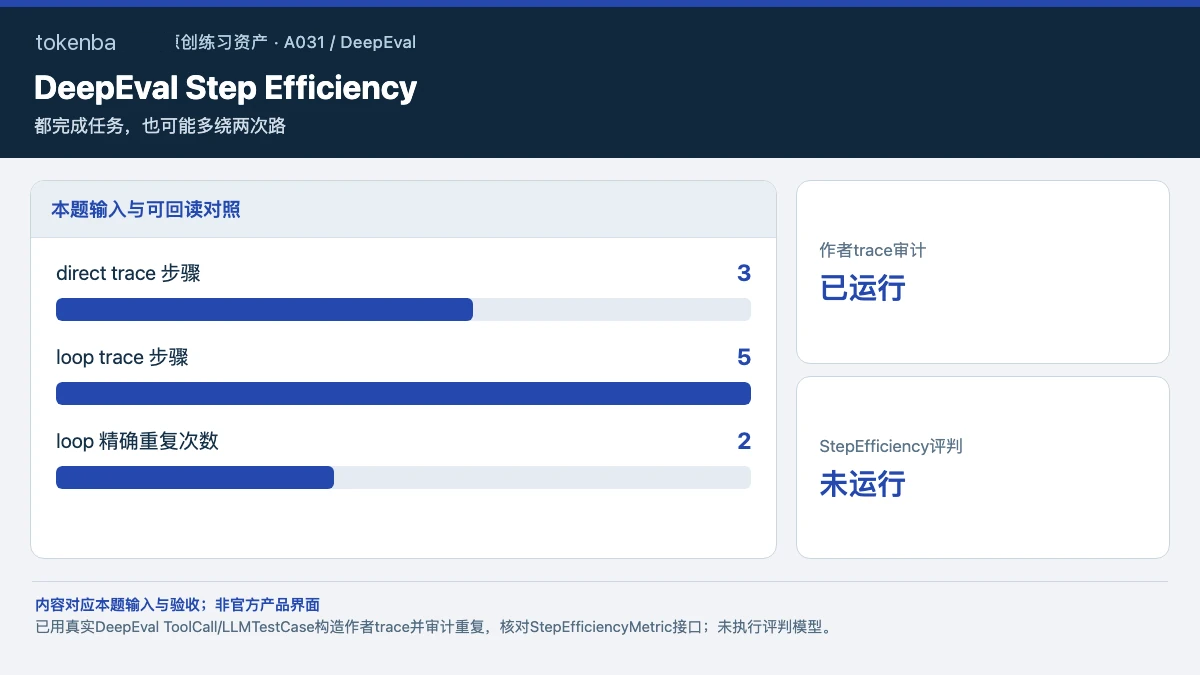
先确认两条trace完成同一目标,再保留真实工具步骤交给StepEfficiencyMetric评判,记录score、reason与模型版本。精确重复检测可提示无效搜索,但有新证据的重试不应机械删除,离线计数不能冒充评判分。
阅读文章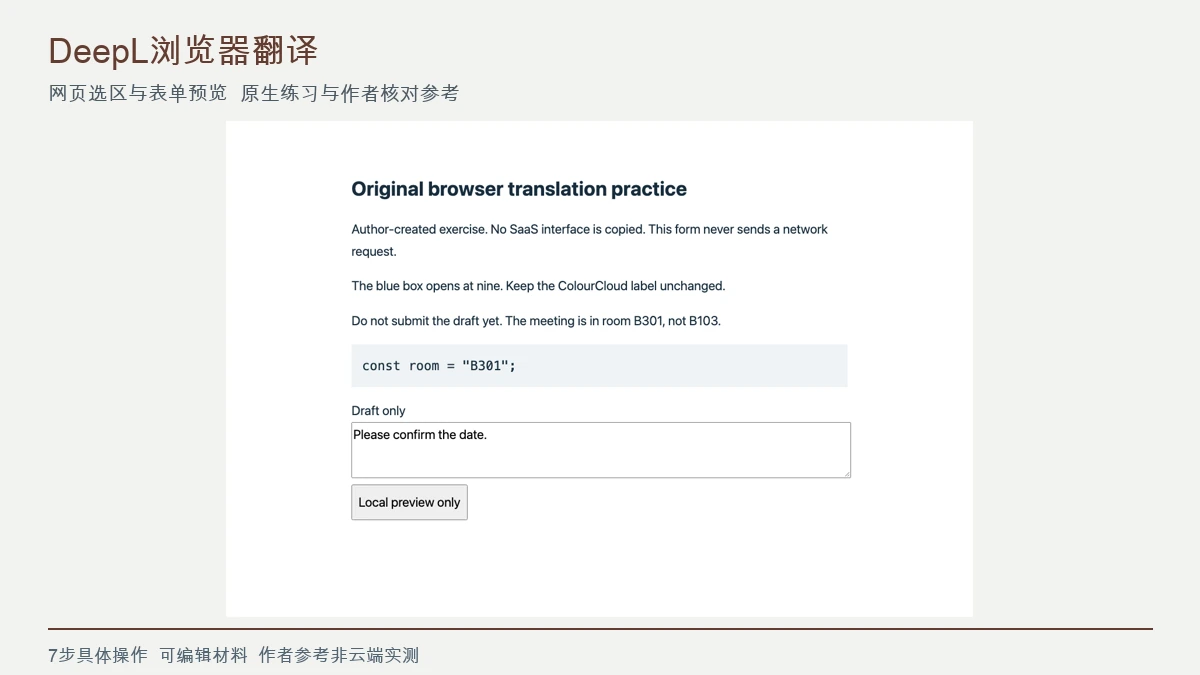
先分清选区、整页和输入框三种范围;本地练习表单没有网络提交,AI翻译也不等于发出消息。
阅读文章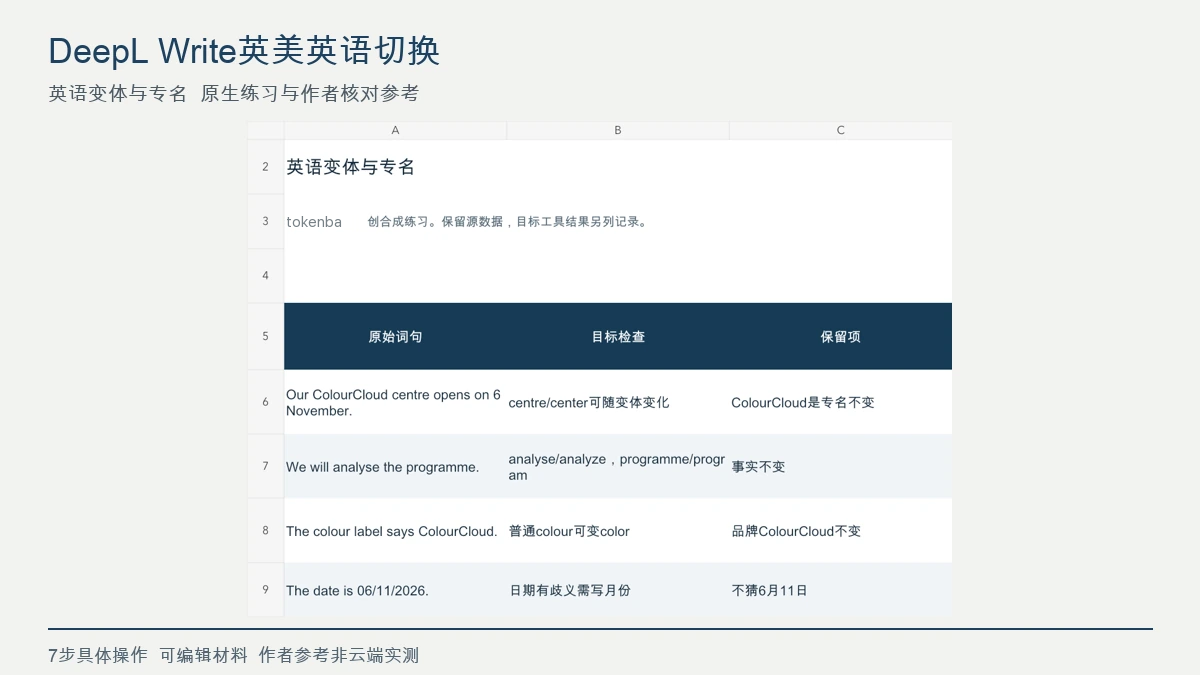
英美变体可统一普通拼写,但ColourCloud专名和2026年11月6日事实不应被误改。
阅读文章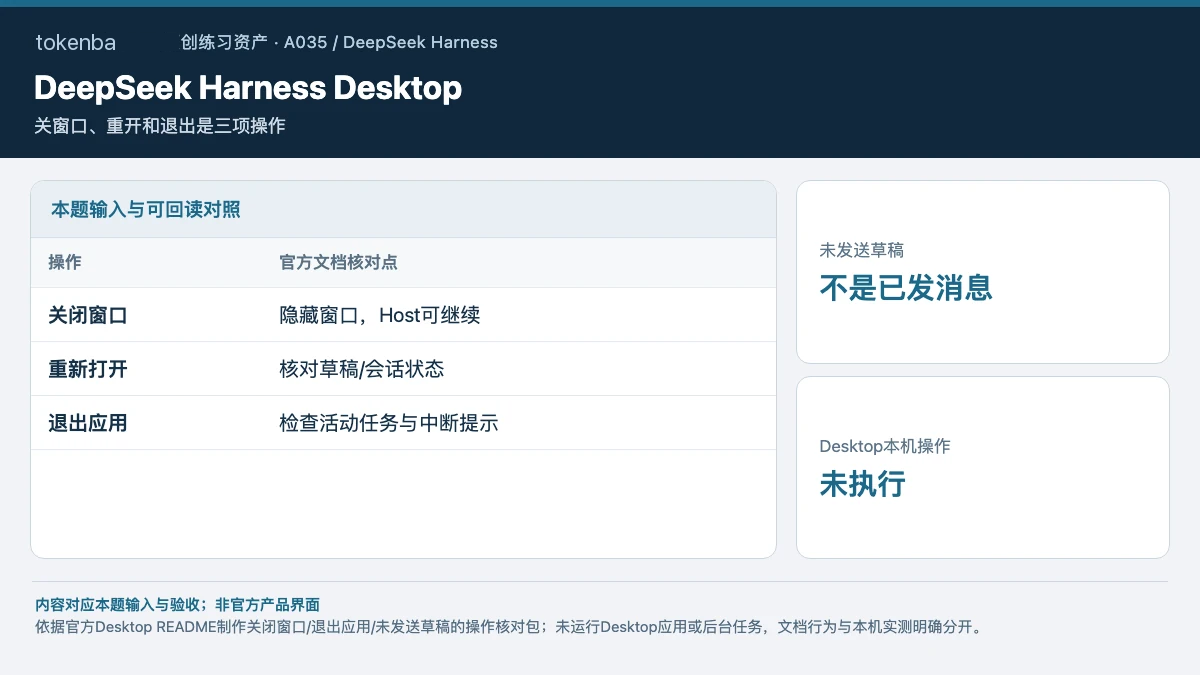
依据官方Desktop README制作关闭窗口/退出应用/未发送草稿的操作核对包;未运行Desktop应用或后台任务,文档行为与本机实测明确分开。
阅读文章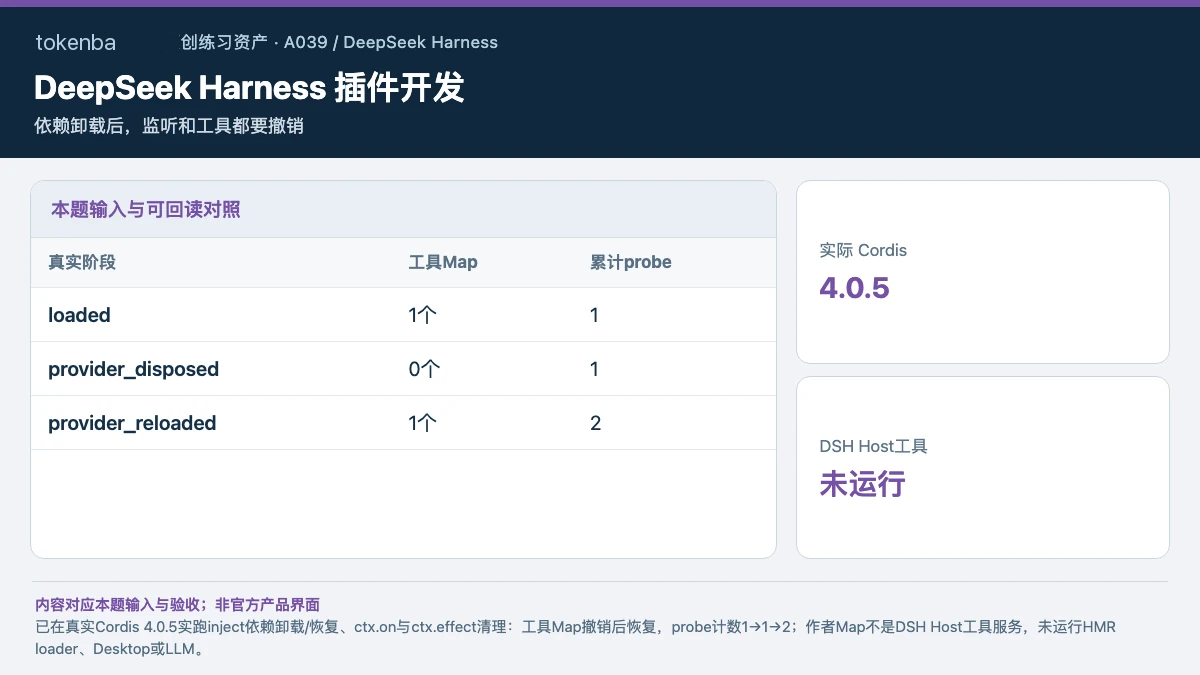
在 DeepSeek Harness 插件把目录服务与查询工具分开,使用 ctx.on 和 ctx.effect 绑定监听及释放逻辑。卸载 provider 后检查 dependent 工具撤销,重载后再 probe,确认不会留下重复监听。
阅读文章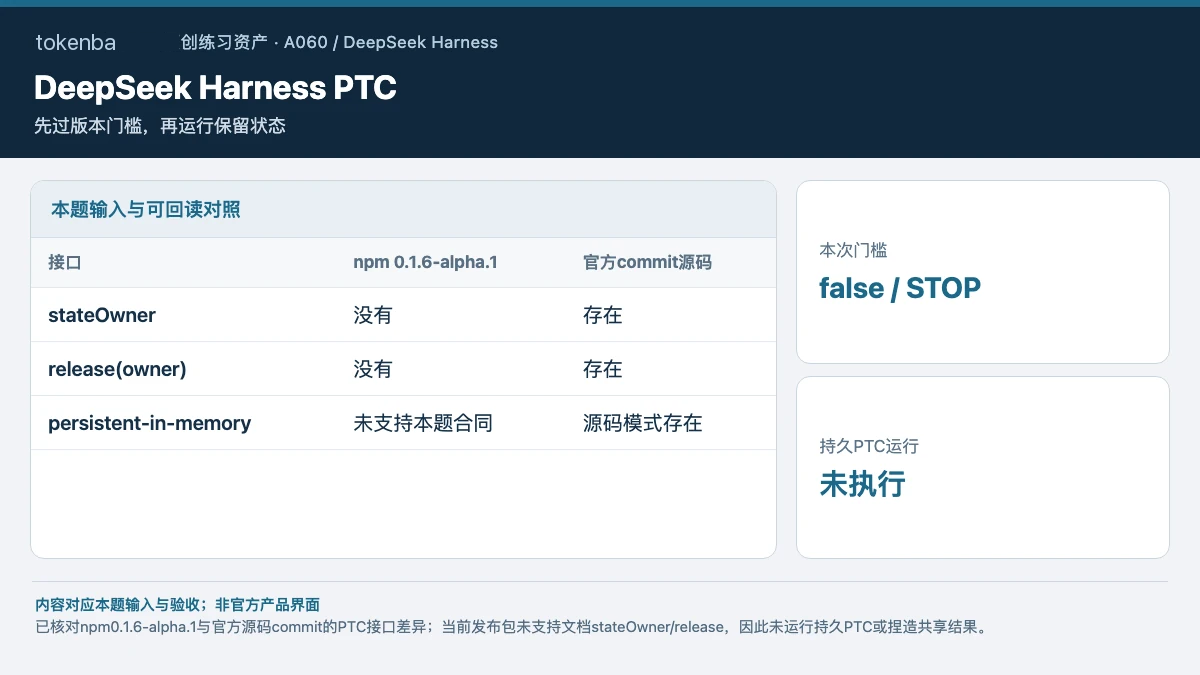
先核对目标 DeepSeek Harness 的 Node PTC runtime 是否支持 persistent-in-memory、stateOwner 与 release。只有版本满足时才用同一 owner 对象跨两段程序复用变量,并以新 owner 和释放后访问验证隔离。
阅读文章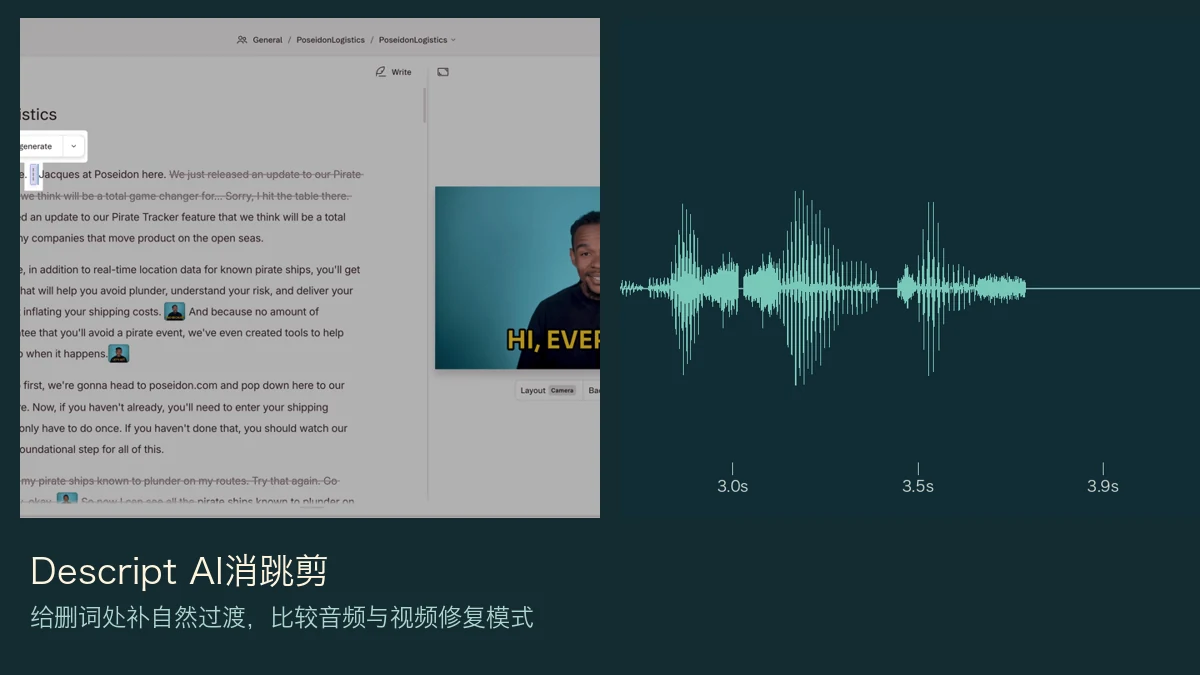
在同场景、单说话人的英语片段制造真实删词边界,先比较 Audio only,再试 Audio & video。回听接缝并看头部与背景变化,保留可还原原片;不能将该路线外推到跨场景或多人镜头。
阅读文章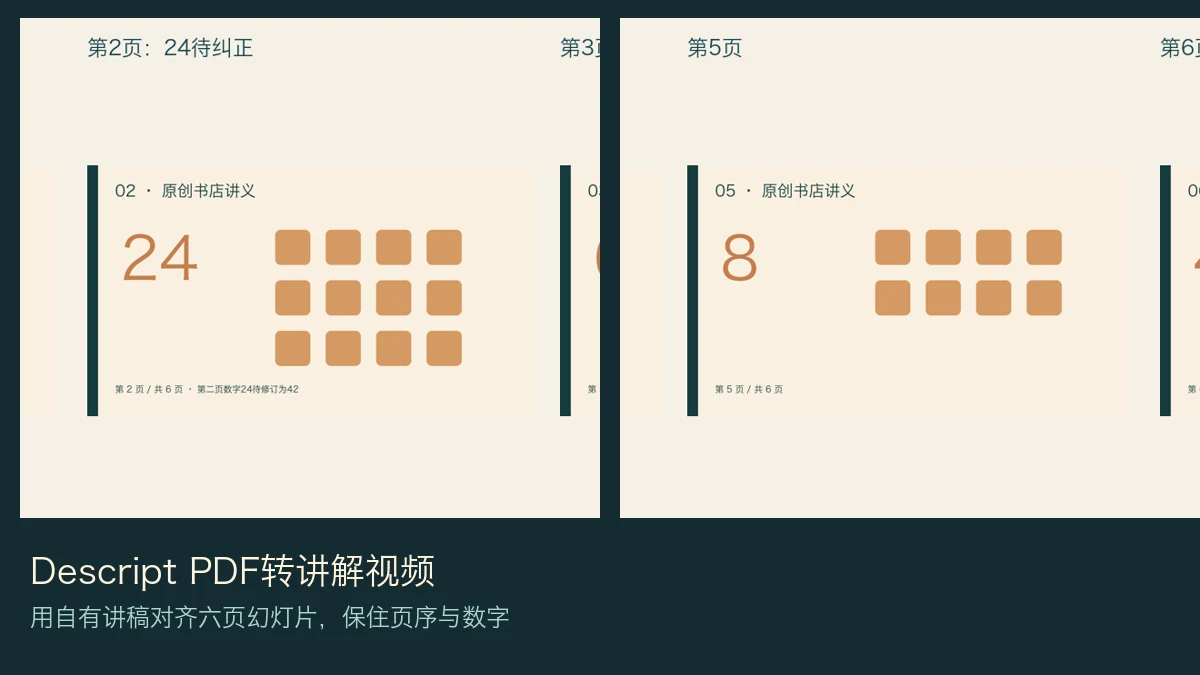
上传自有 PDF 与逐页讲稿/录音,先检查页面顺序和资料数字,再在 Underlord 可用路径中安排对应 B-roll。回看每页讲解覆盖与时长;翻页能播放不证明讲稿事实正确。
阅读文章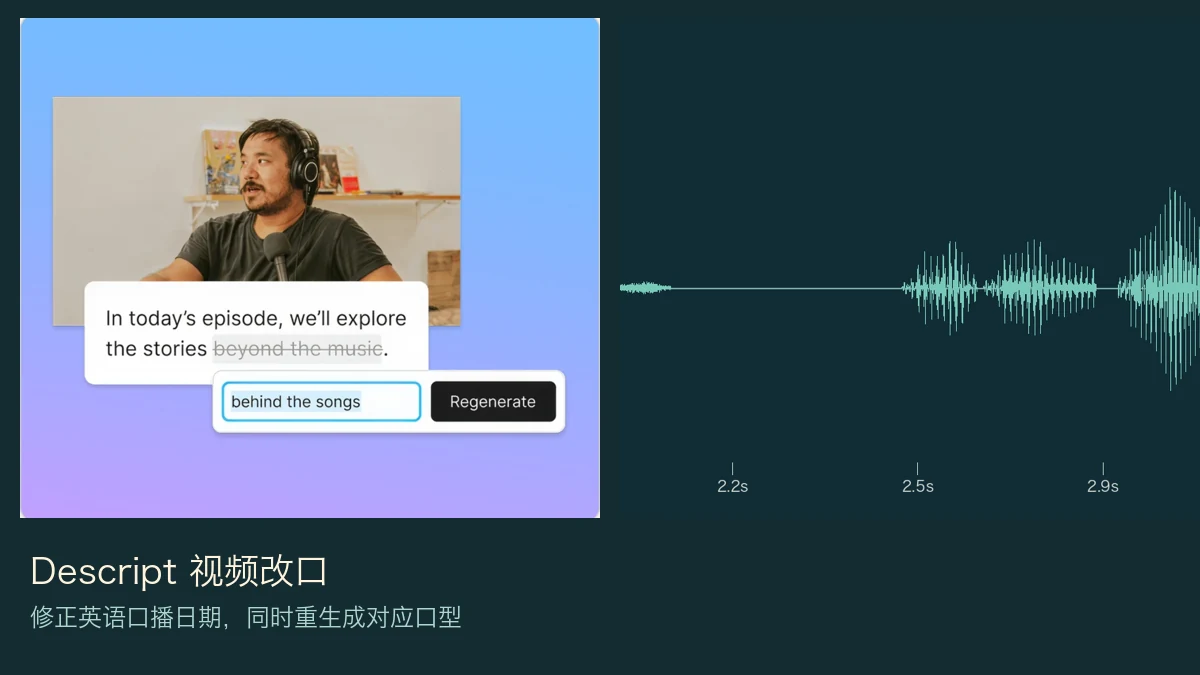
先完成本人声音同意核验,在同一英语口播中定位日期词并选择音视频重生成。保存实际结果后对齐前后音节与嘴形;包内文本和参考不等于已生成的本人音视频。
阅读文章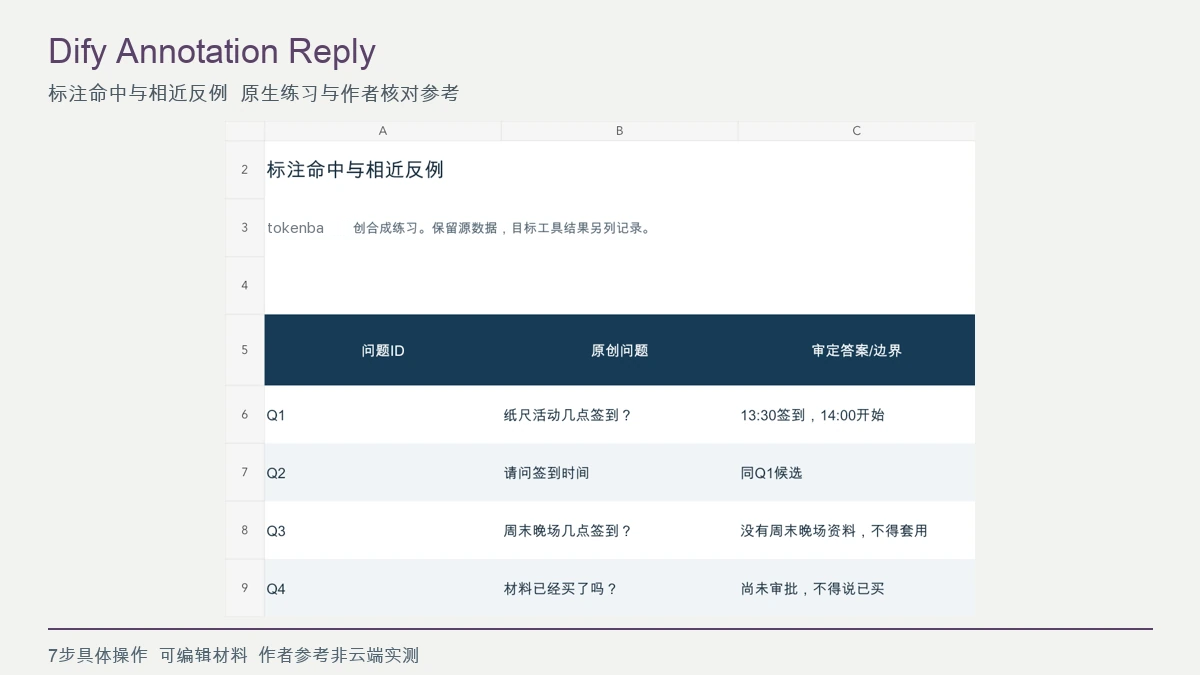
Annotation Reply要记录真正标注直答路径,调score_threshold后用相近但不同场次反例验证,不能只看答案像不像。
阅读文章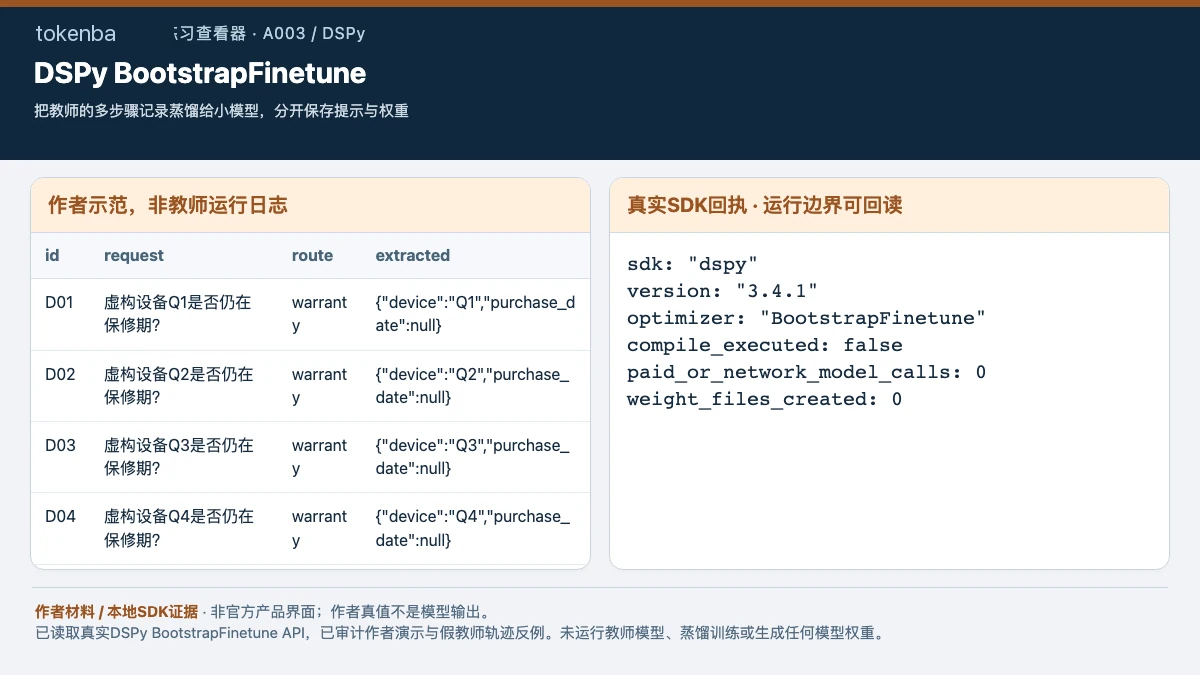
在 DSPy BootstrapFinetune 为兼容教师和学生保存版本,采集真实逐模块输入输出轨迹。剔除教师错误并隔离留出题,再编译学生;提示程序、训练轨迹与实际权重分别保存,人工示例不充当教师采样。
阅读文章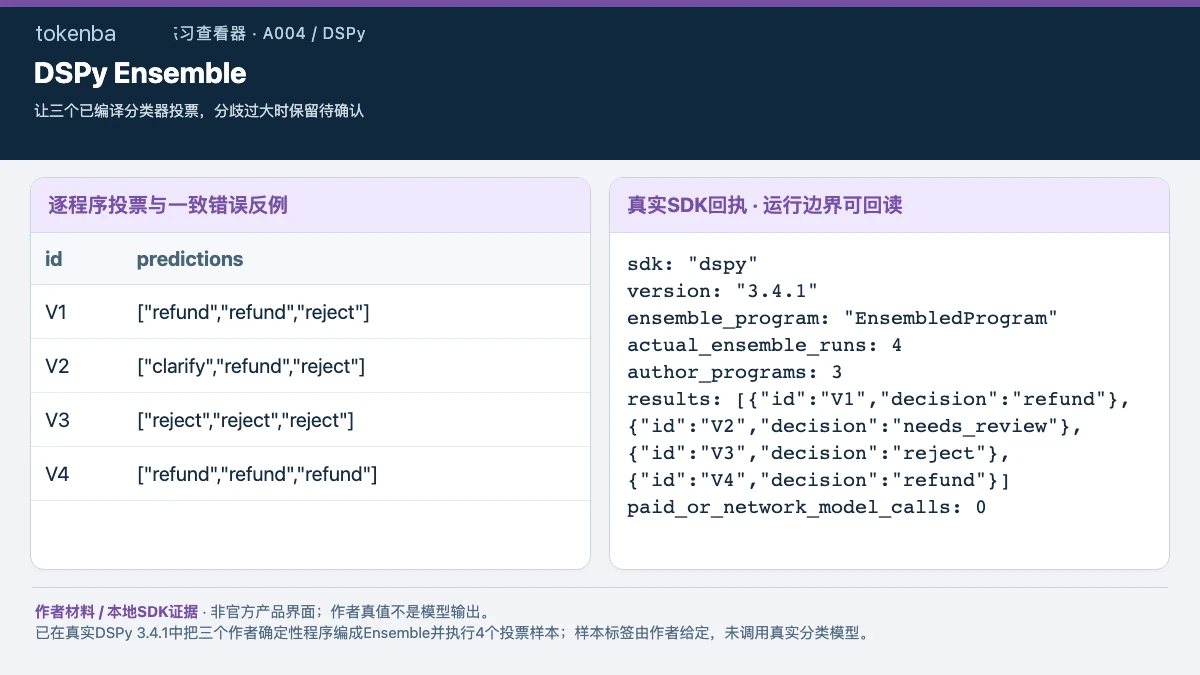
用 DSPy Ensemble 组合三个已编译分类器,先保存每个输入的三票原文,再按至少两票一致归约。三种不同结果返回待确认,同时保留一致但错误的反例,不能把多数票当正确保证。
阅读文章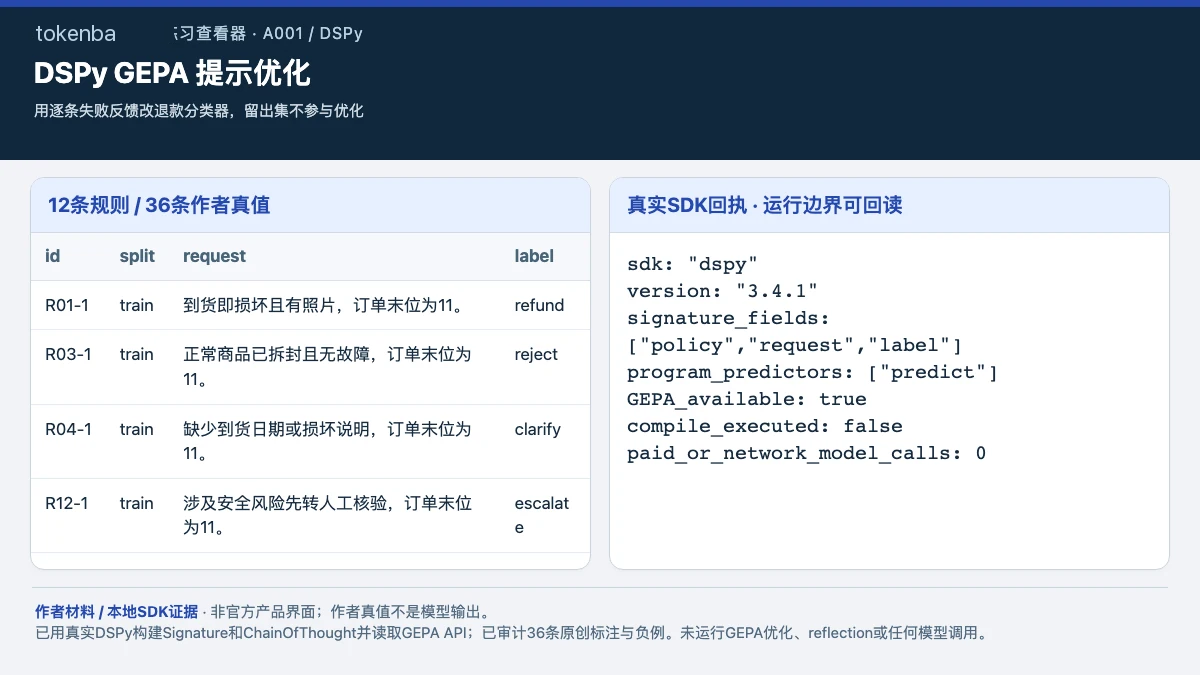
在 DSPy 为退款分类器定义带失败理由的 GEPA metric,分开训练、验证和留出题。授权运行优化时保存逐轮反馈与候选程序,只在优化结束后测留出集,不能让留出答案参与提示搜索。
阅读文章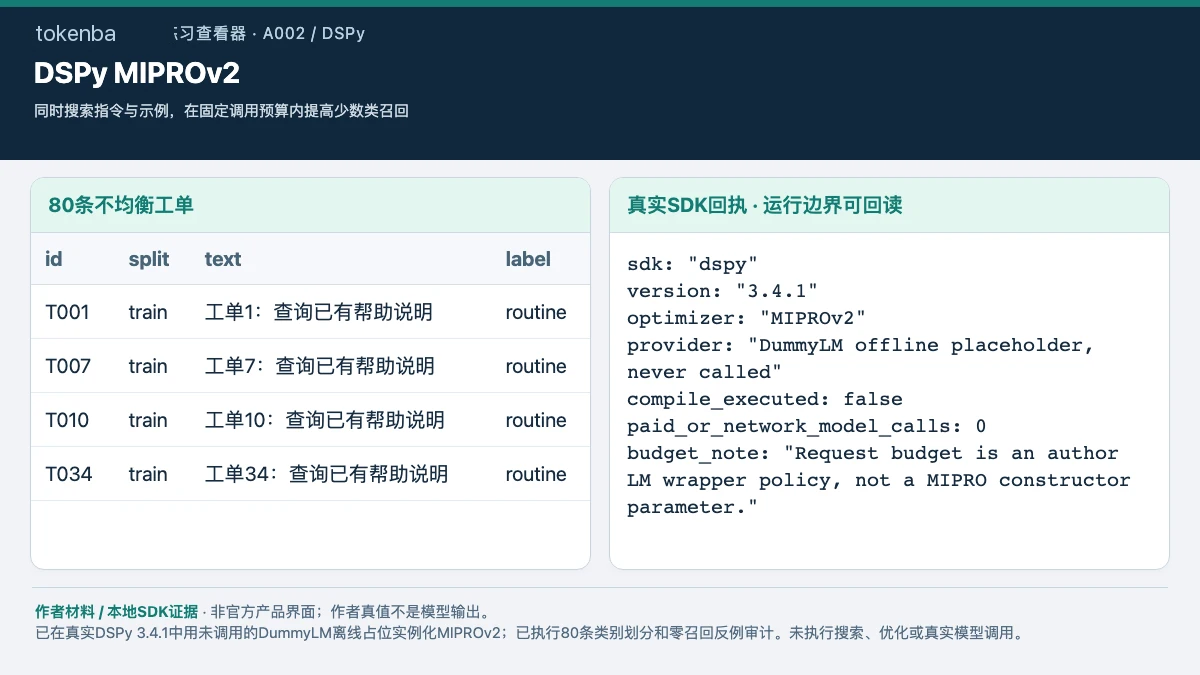
在 DSPy MIPROv2 分开搜索指令与示例,先保存少数类全漏的基线,再固定候选数和真实 LM 调用预算运行 compile。报告少数类召回、整体结果和调用轨迹;本包只完成接口与夹具检查,未执行模型搜索。
阅读文章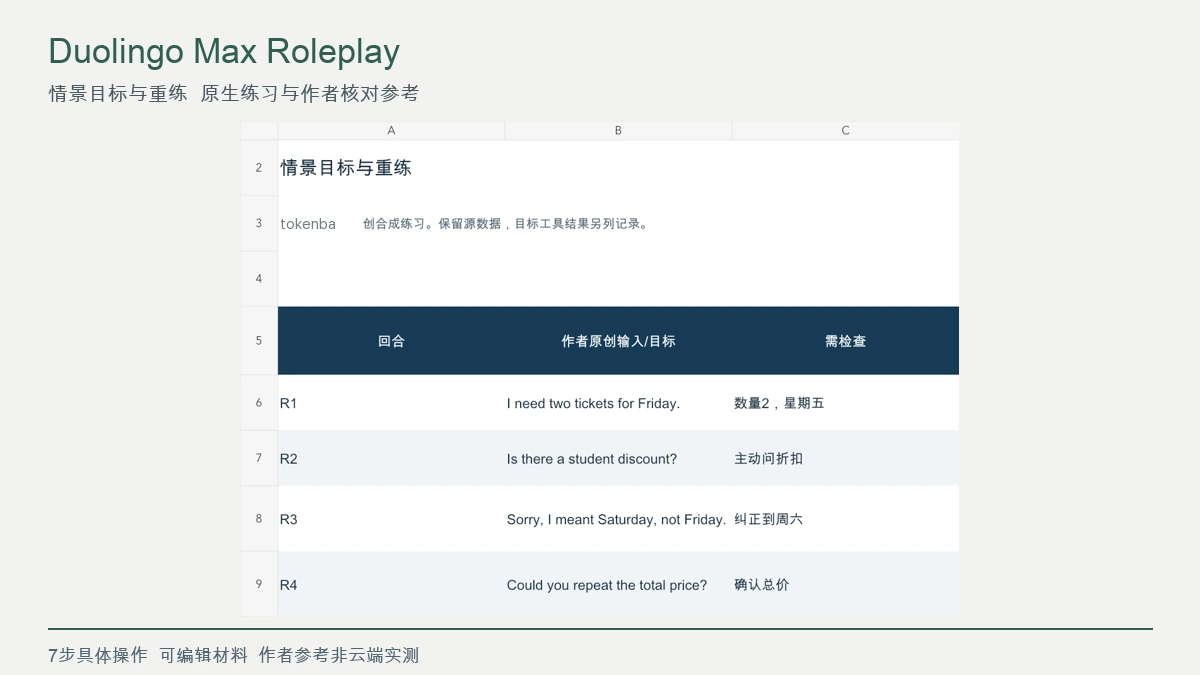
Roleplay先核对情景目标,再看针对实际说法的反馈;目标达成和语法无误分别判断,只重练一个缺口。
阅读文章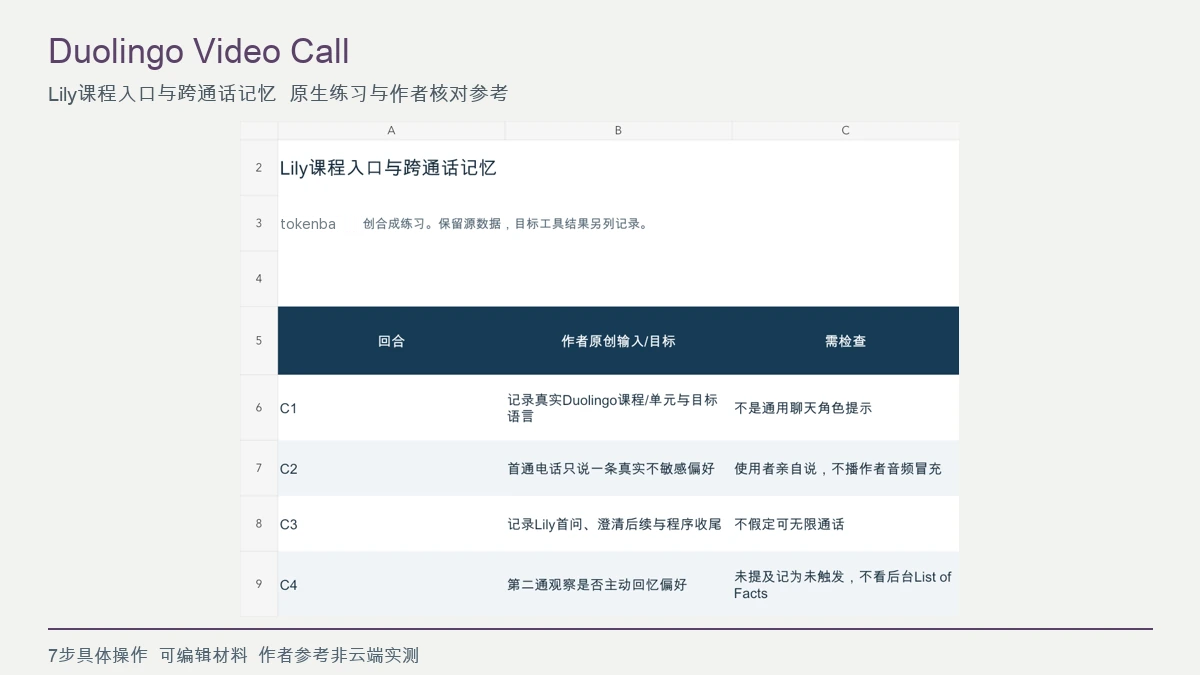
从实际课程的 Video Call 入口开始,记录 Lily 首问,亲自表达一条偏好并完成澄清,等待自然结束。第二次通话再观察是否回忆,不强行补写成功;通用语音助手角色扮演不能替代原生通话。
阅读文章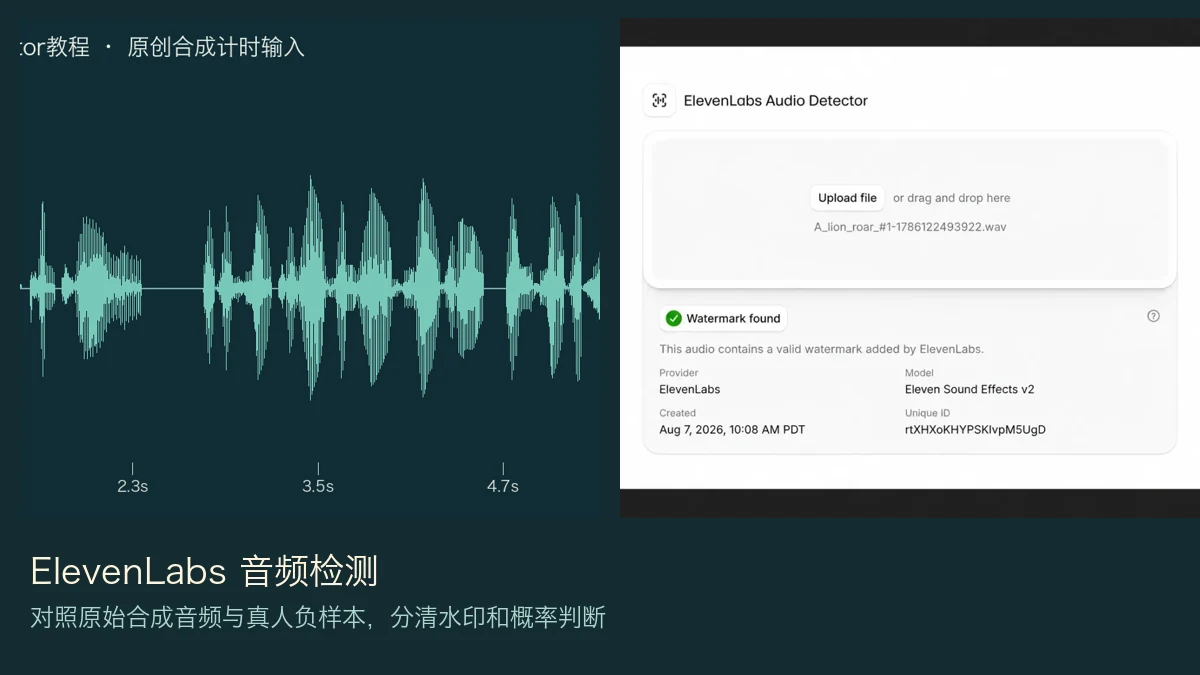
准备有来源的 ElevenLabs 原始输出和本人真实负样本,先保留文件摘要,再分别上传并记录水印、分类结果。重编码副本另测;该检测不是所有 AI 音频的通用来源鉴定。
阅读文章注册后创建 apizt API Key,选择客户端和模型,再生成接入配置。从一次简单请求开始,按实际用量付费。
在控制台创建令牌,选择需要使用的模型权限。
按工具要求填写 API Key、接口地址与模型 ID。
确认收到有效结果,再到控制台查看用量与费用。