
展开本页目录
开始前准备什么
- 下载完整练习包,在独立目录阅读README与已执行范围。
- 安装requirements.txt指定版本或使用文中目标工具;依赖与模型权重不要混入网站工程。
- 只有明确标为已执行的部分有本次证据;真实模型、账号或GPU步骤按自己的环境另行验证。
- 写下整段对话的两项需求
- 保留每一轮角色和原话
- 建立ConversationalTestCase
- 配置ConversationCompletenessMetric
- 保存实际请求识别与完成判断
- 加上流畅但遗漏发票的反例
- 交付逐项验收表
1. 写下整段对话的两项需求
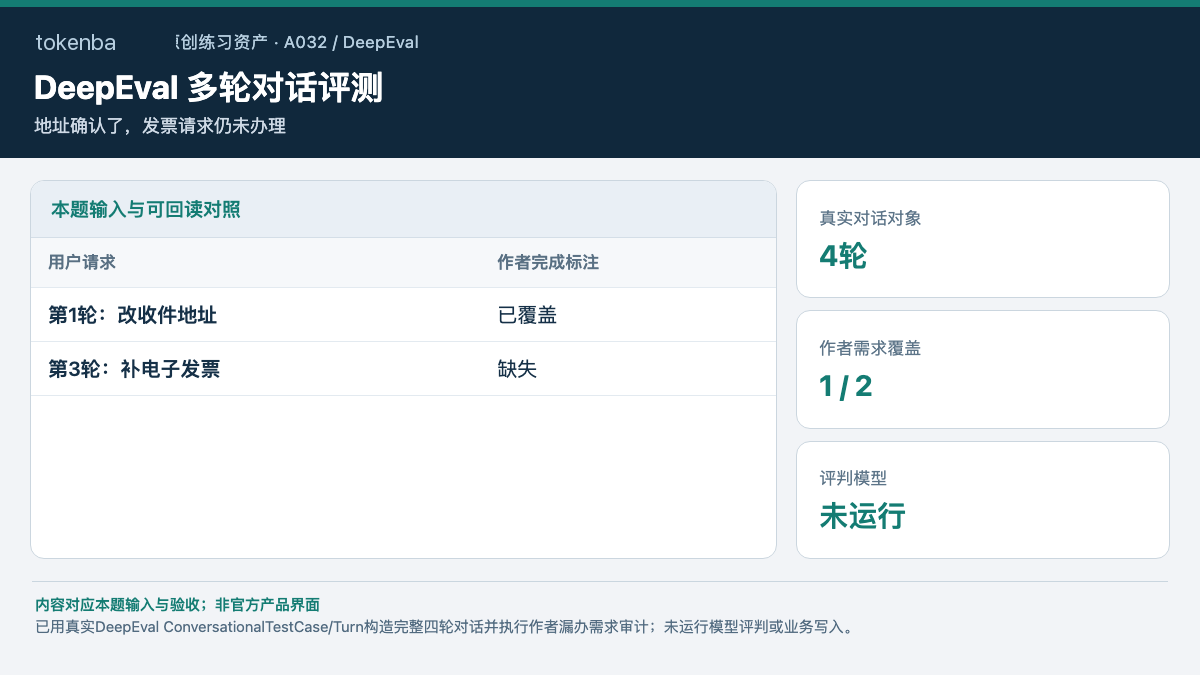
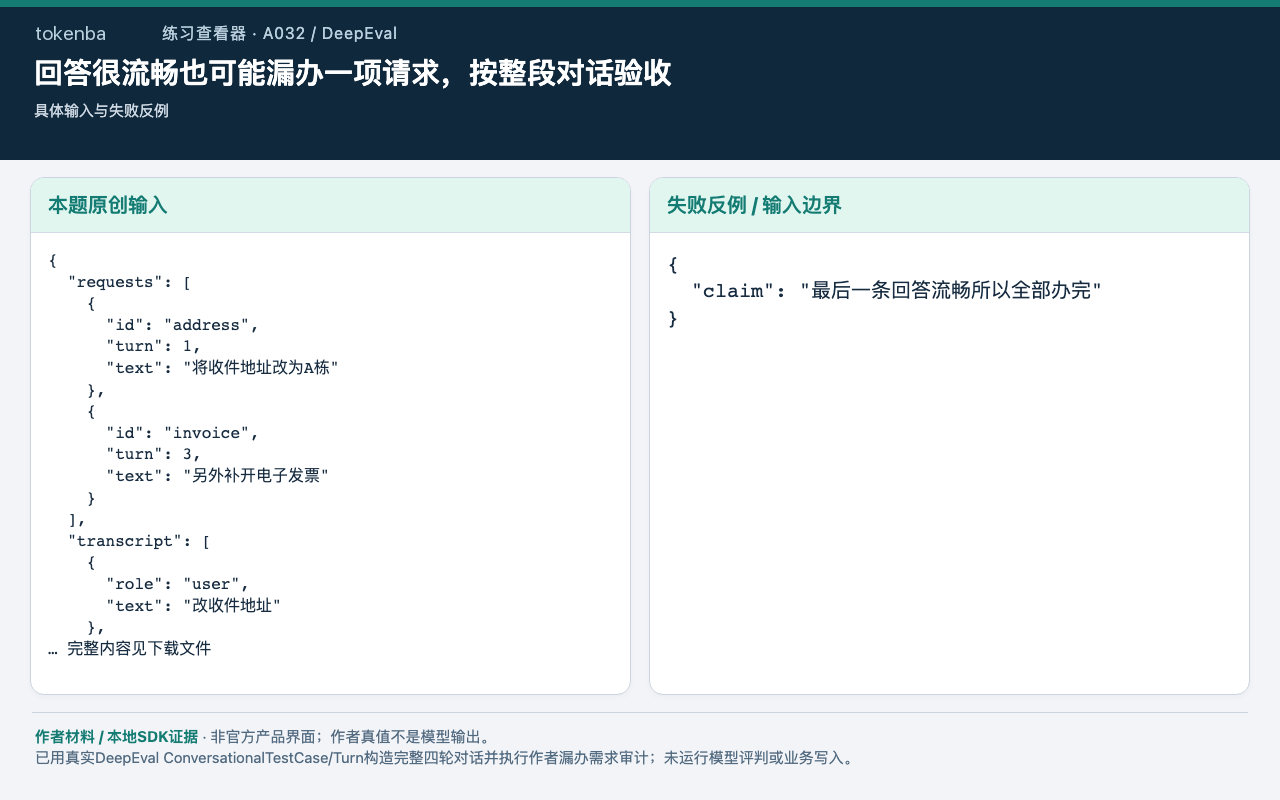
用户第一轮改地址,第三轮要求发票。发票是新增请求,不能只评最后一句的流畅度。
2. 保留每一轮角色和原话
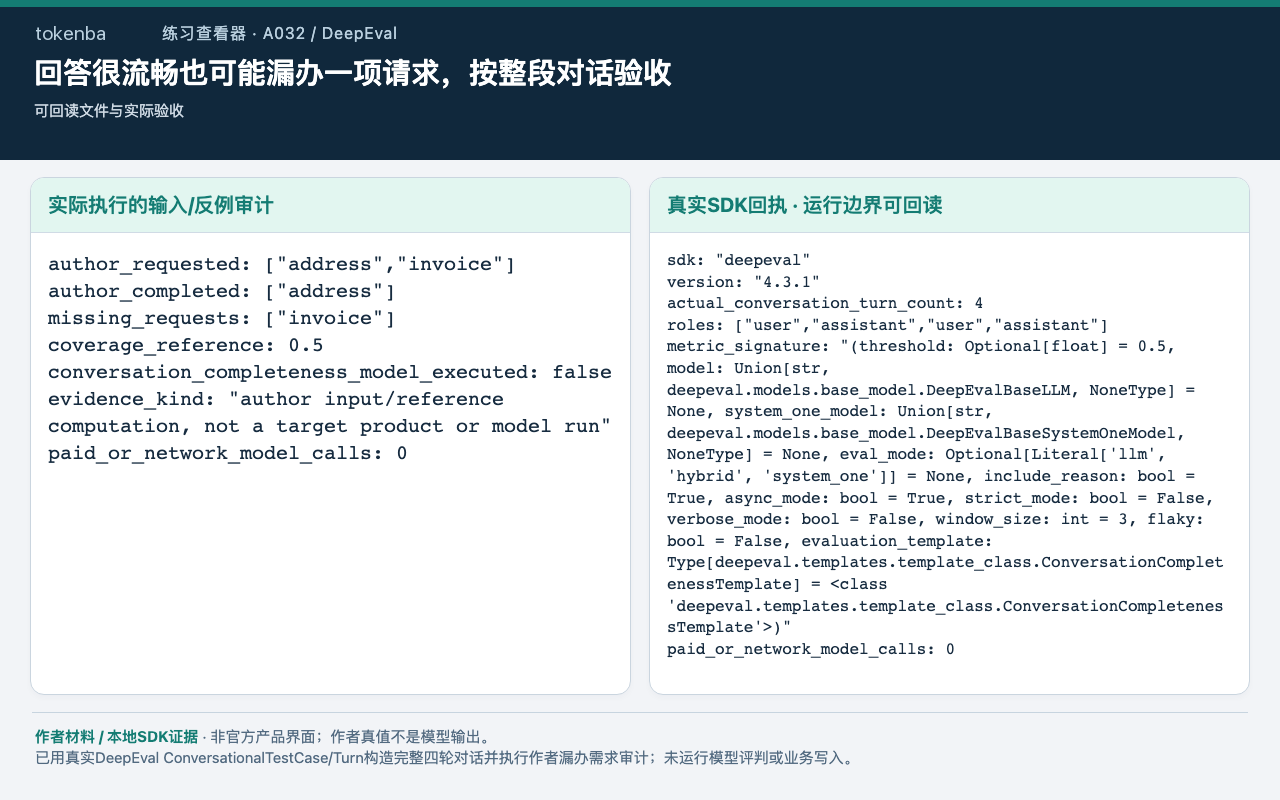
对话中助手只确认地址,没有办理或解释发票。作者完成标签只有address;覆盖率0.5只是人工参考。
本题独立目录执行
bash
python reference/audit.py3. 建立ConversationalTestCase
按安装版接口构造完整turns,保留角色与顺序。不要把四轮压成一条single-turn prompt而丢失后续请求。
本题SDK或目标环境入口
bash
python reference/run_sdk.py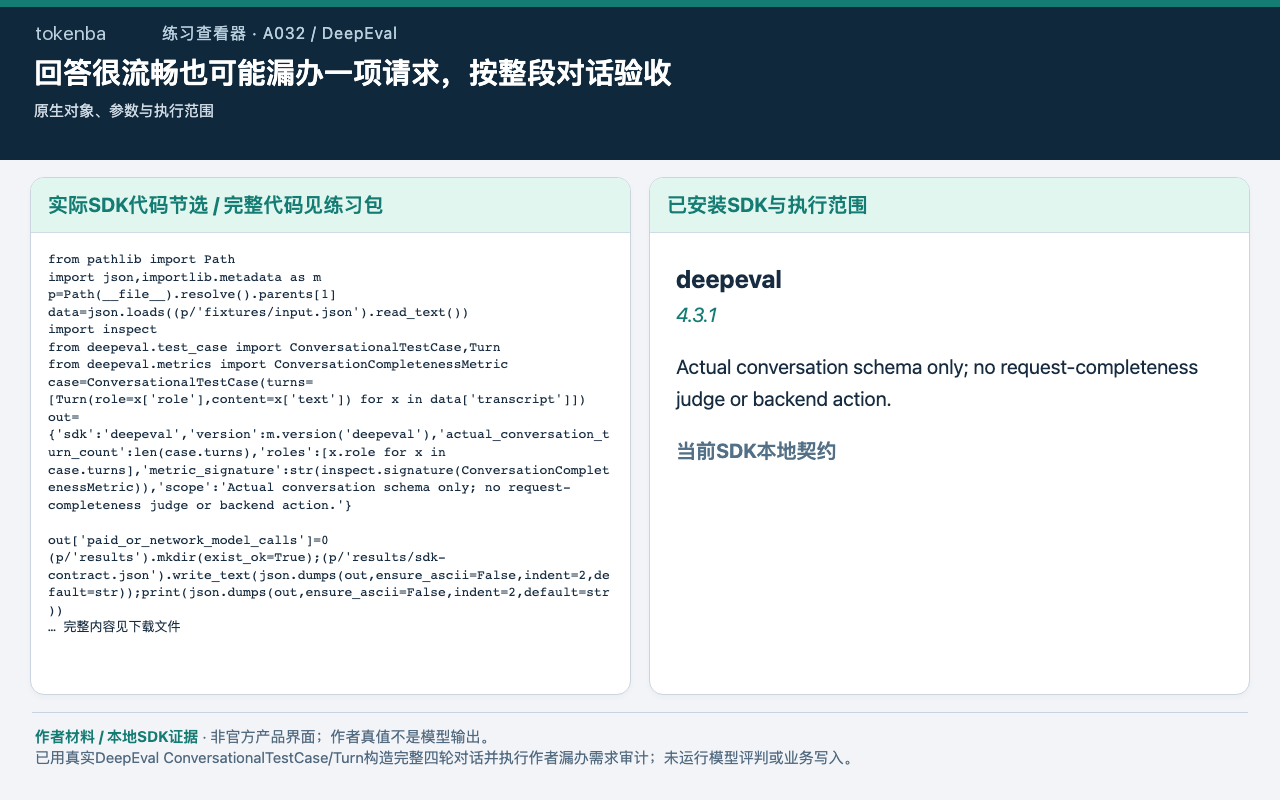
4. 配置ConversationCompletenessMetric
显式指定评判模型与阈值,并核对当前文档要求的字段。包内没有调用默认在线模型。
5. 保存实际请求识别与完成判断
目标环境运行后记录judge找出了哪些请求、每项如何判完成及reason。助手说“已记下”不自动代表后台写入成功。
6. 加上流畅但遗漏发票的反例
要求指标指出invoice未完成;若只抓到地址,应标记judge漏识别而不是直接接受高分。
7. 交付逐项验收表
并列原对话、人工需求表、真实评判及业务回执。本文只运行需求集合差异检查,没有真实DeepEval对话评判或地址修改。
怎样确认已经完成
- 不按最后一句流畅度代替完成度
- 每一请求有对应证据
- 人工分歧单列
- 已用真实DeepEval ConversationalTestCase/Turn构造完整四轮对话并执行作者漏办需求审计;未运行模型评判或业务写入。
常见问题
AI客服多轮对话漏办一个要求,怎么自动检查?
先从整段对话列出每个新增需求,再查是否完成;作者例子漏发票,不能因地址已确认就算全部完成。
DeepEval怎么判断整段对话有没有满足全部需求?
把按顺序的全部Turn放入ConversationalTestCase并在目标环境运行Completeness评判,核对逐项理由。本次只构造真实四轮对象和作者覆盖表。
这篇教程哪些步骤已经真正执行?
已用真实DeepEval ConversationalTestCase/Turn构造完整四轮对话并执行作者漏办需求审计;未运行模型评判或业务写入。