
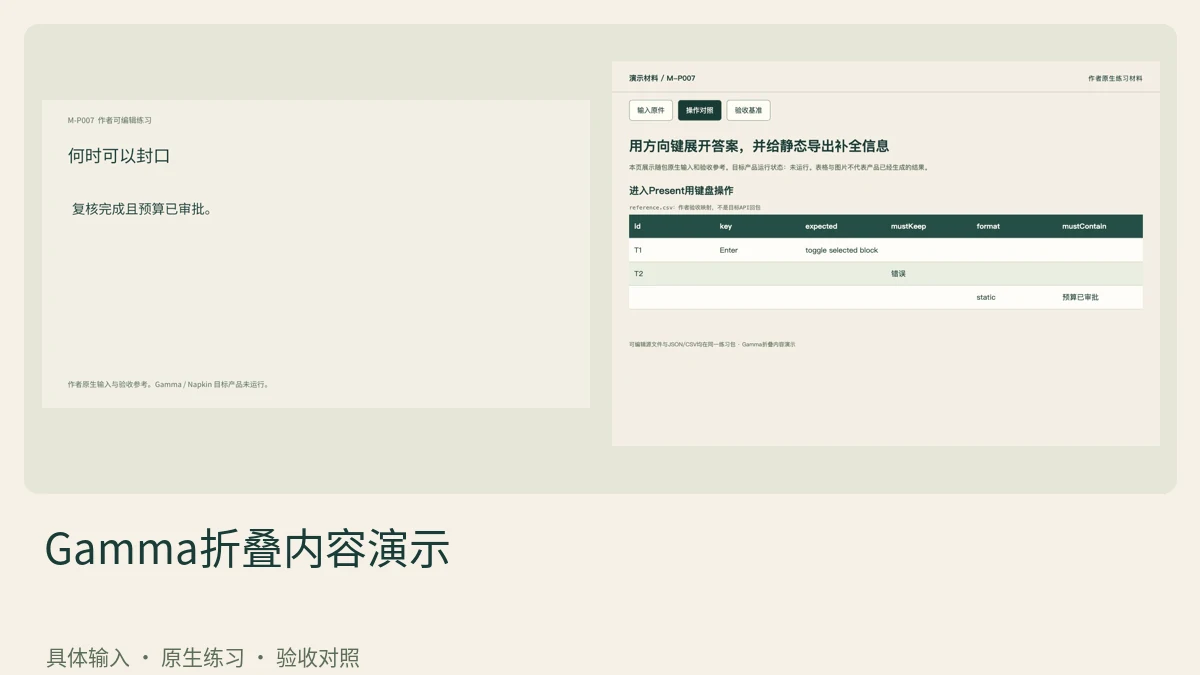
Gamma折叠内容演示:用方向键展开答案,并给静态导出补全信息
使用上下键高亮可展开项,按Enter切换。左右换页与上下选块分开记录,不把页面滚动当已展开。
阅读文章正在打开页面…
正在加载内容,请稍候。
从 API Key、Base URL 配置到首次调用,按工具查找接入步骤与常见报错;也可浏览图像、视频、自动化和办公任务教程。
获取 API Key1450 篇教程,当前显示第 385–432 篇。选择页码继续浏览,或切换任务主题。
使用上下键高亮可展开项,按Enter切换。左右换页与上下选块分开记录,不把页面滚动当已展开。
阅读文章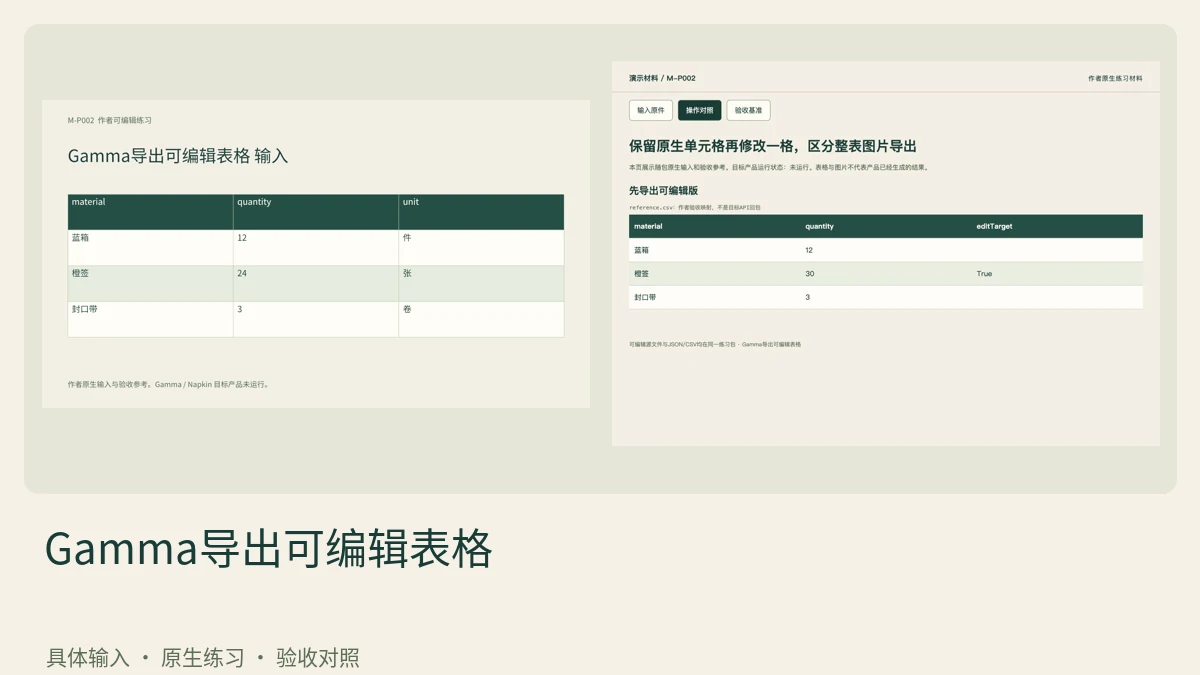
先在 Gamma 建真正的三列表格,导出 PowerPoint 时确认 editable tables 选项并下载文件。到目标演示软件修改指定一格,再查看其它单元格;弹窗或整表图片不证明可编辑导出。
阅读文章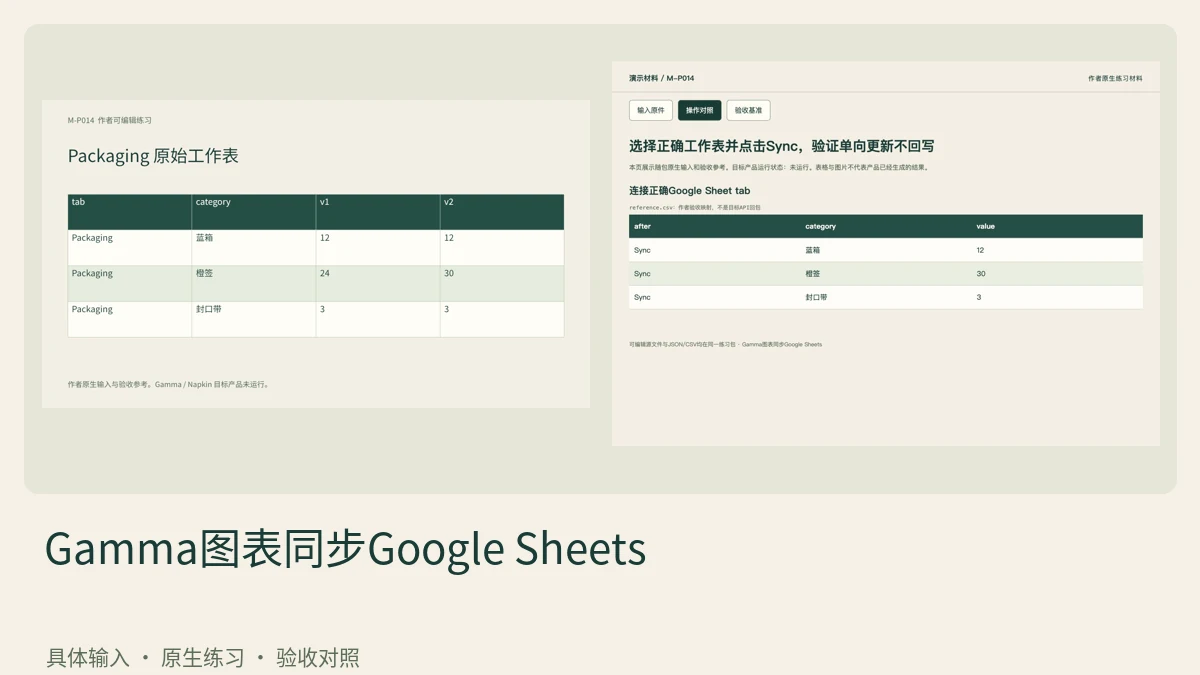
在图表编辑器授权自有测试表,明确选Packaging。查看分类和橙签24,若99出现先纠正tab。
阅读文章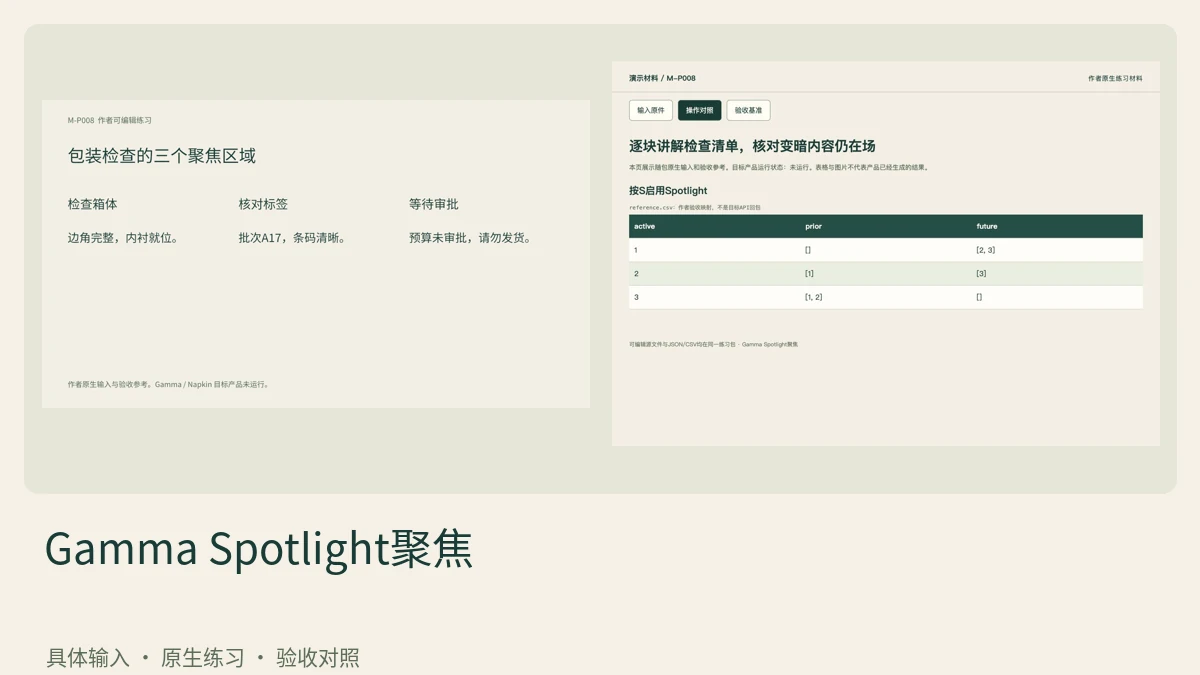
按当前快捷键S切换,观察当前块突出、先前变暗、后续淡化。界面不同先核对Present焦点,避免快捷键落在文本编辑框。
阅读文章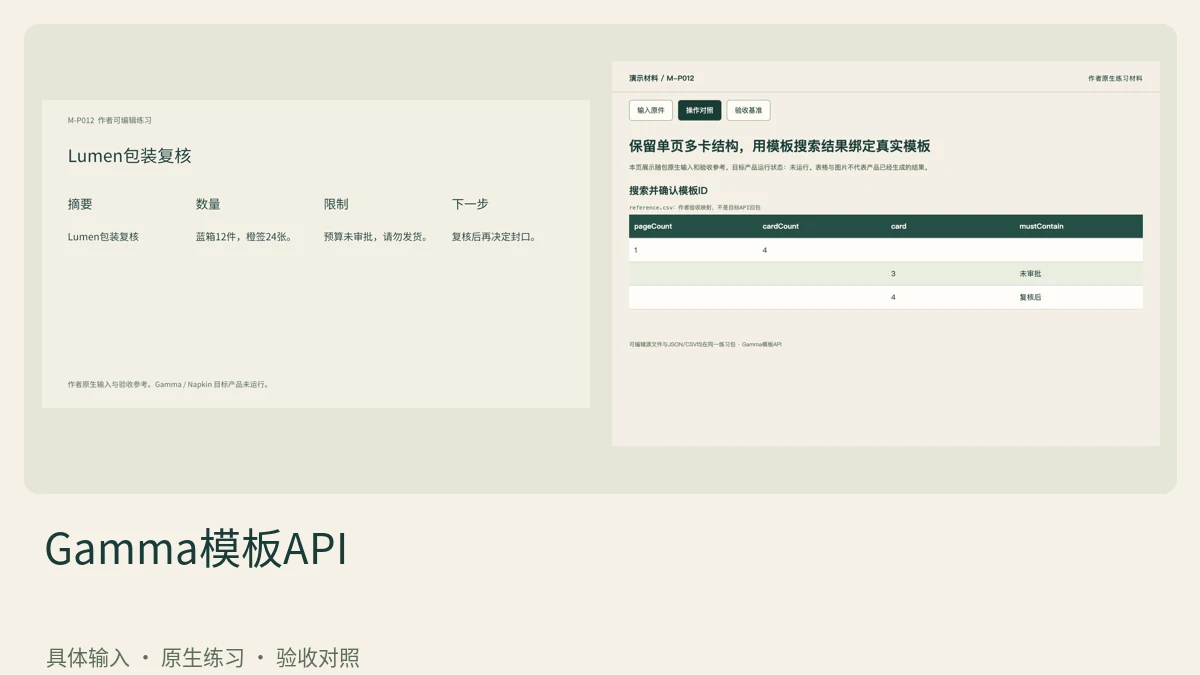
使用GET /v1.0/templates/search找到实际模板,打开检查结构。示例REPLACE_TEMPLATE_ID必须替换,不能当作官方公共模板ID。
阅读文章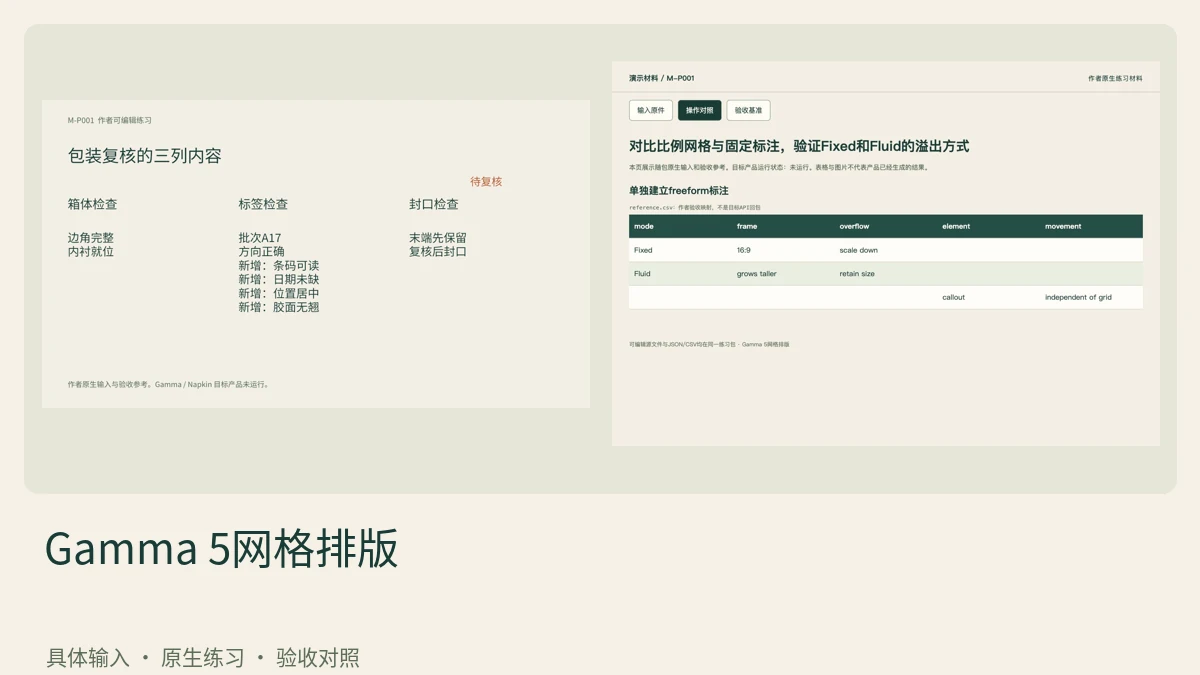
在 Gamma 5 用 Grid 放三列内容,再单独建立右上角 freeform 标注。只给中列增加文字,分别在 Fixed 与 Fluid 副本观察溢出或重排,检查标注位置与正文顺序。
阅读文章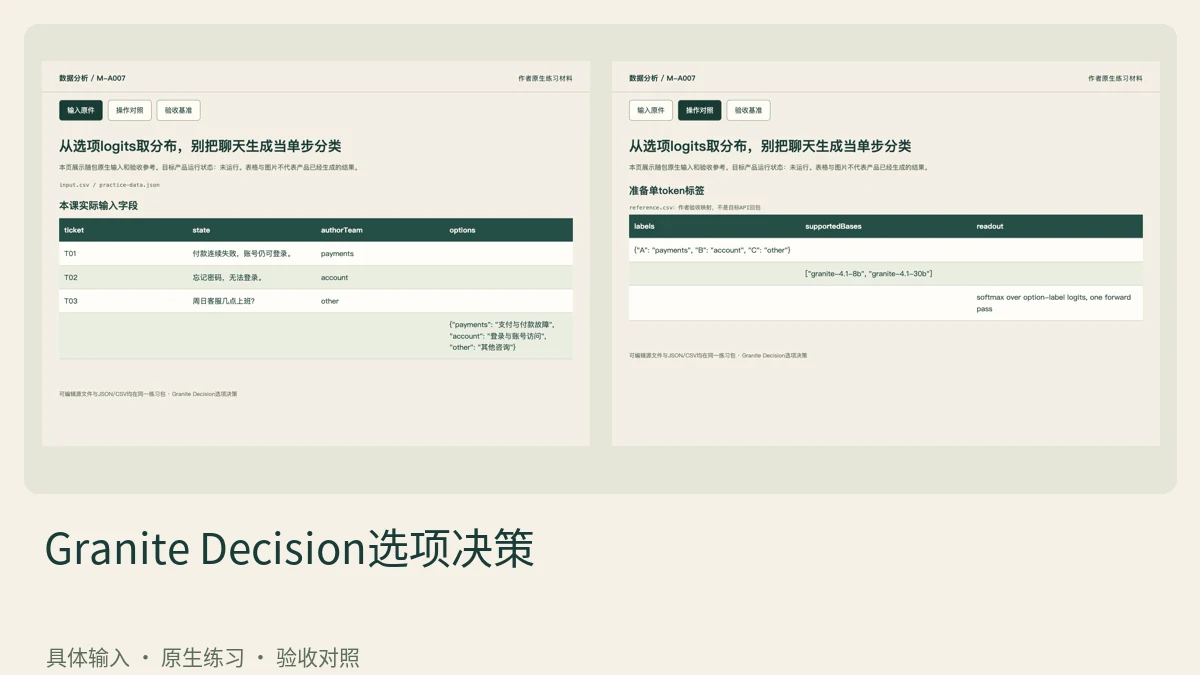
Granite Decision选项决策用文本工单在固定团队间选择。它读取选项标签的下一token logits,而非生成解释长文;当前Decision适配8B和30B,不能照搬3B预组合示例。
阅读文章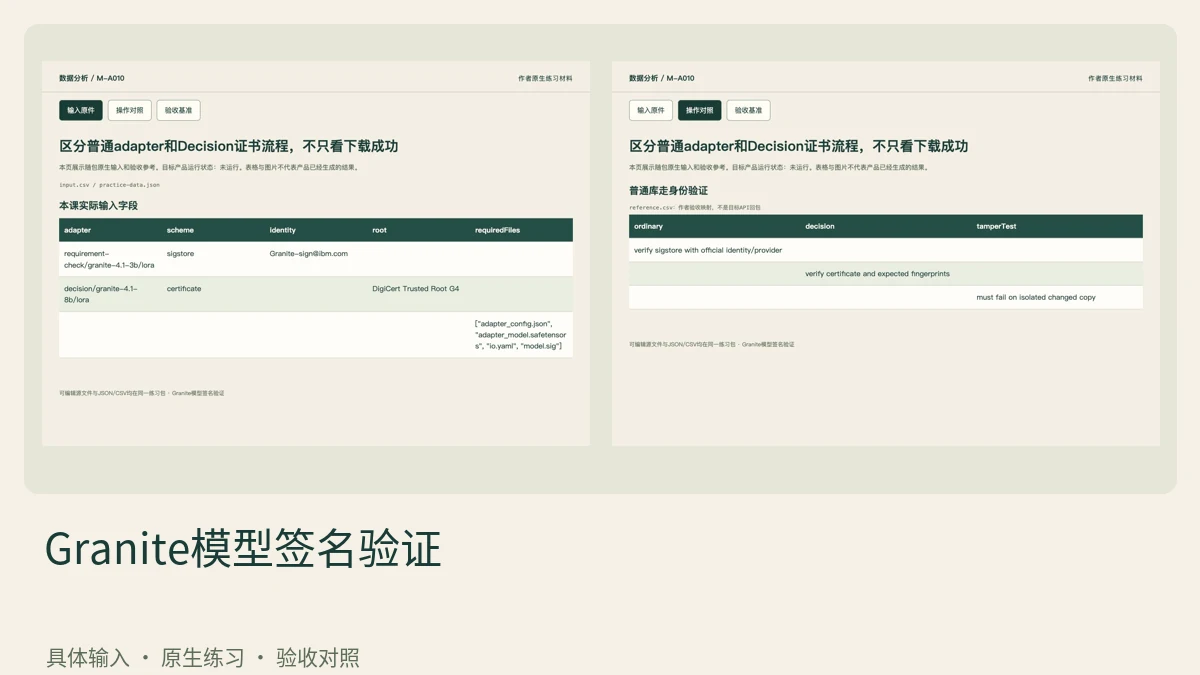
Granite模型签名验证对下载的adapter目录检查来源和完整性。普通库采用IBM Sigstore身份流程,Decision有独立证书链流程;同样叫model.sig不能用一条验证命令覆盖全部。
阅读文章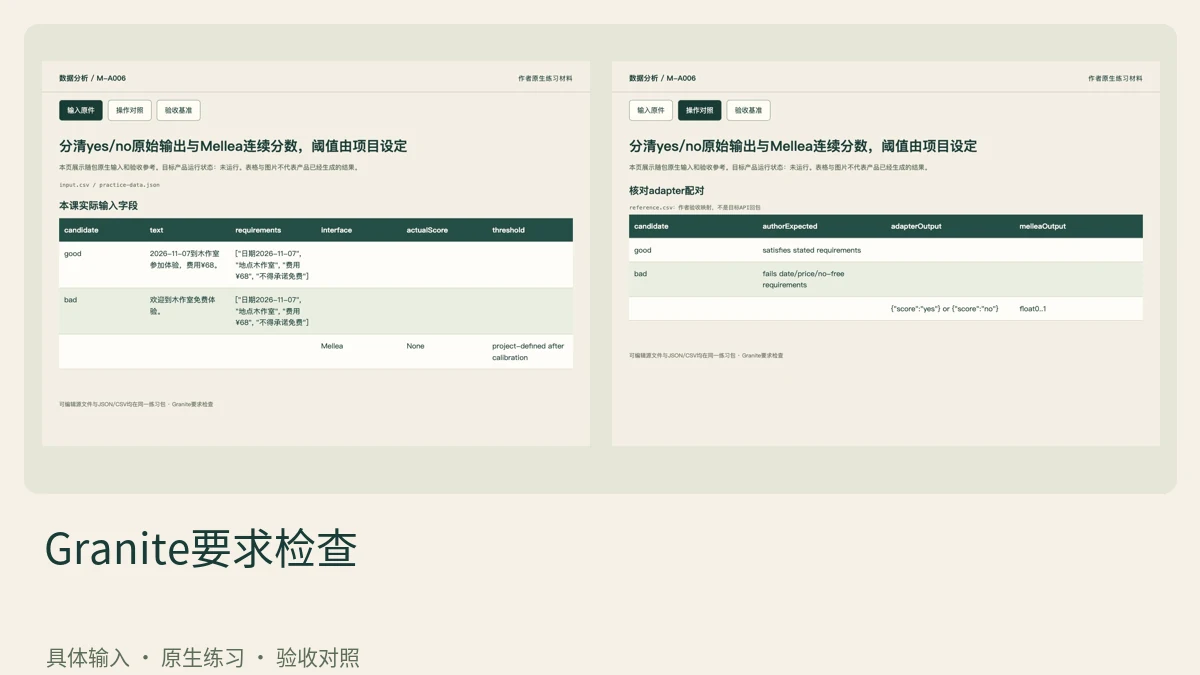
Granite要求检查用相同公告的合格与缺字段版本验证约束。官方adapter直接输出yes/no格式,Mellea可将yes的token概率转连续值;本课不把任意非零分数当作通过。
阅读文章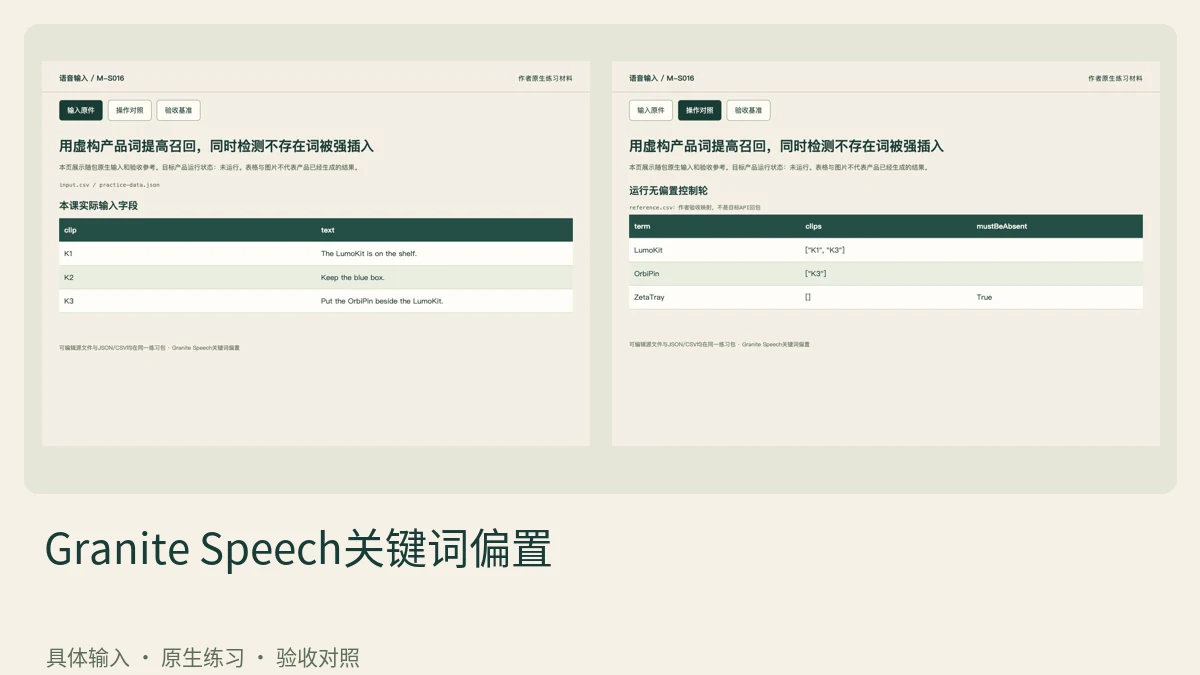
用含词与缺席词两类同源音频先跑无偏置基线,再只添加实际支持的关键词提示。分别统计命中和不存在词被插入的情况;基线本来正确也如实保留,不能人为改坏来制造改善。
阅读文章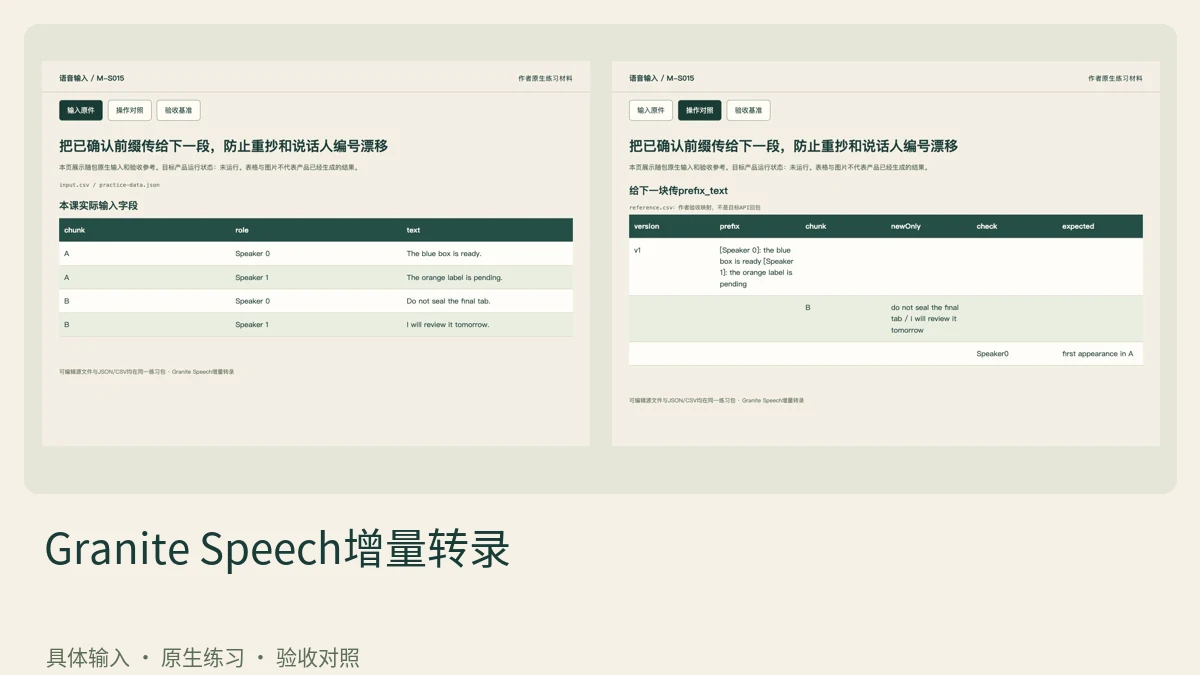
确认上一块逐字稿后,把它按当前 Plus 格式放入 prefix_text,下一块分别保存原始返回与新增文字。回查重抄和说话人编号延续;前缀表示此前文本,不是让模型重新转录同一音频。
阅读文章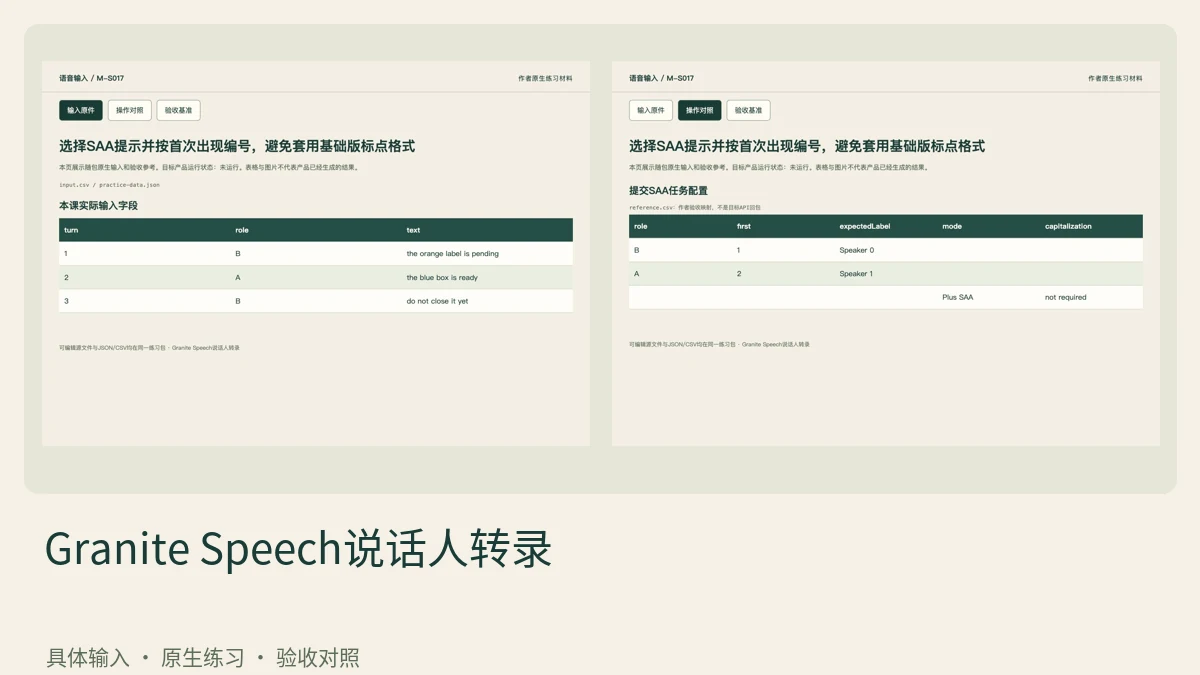
保持单声道音频不变,按 Plus 官方示例选择 SAA 任务,先保存原始返回再处理格式。按首次出现顺序核对说话人编号,区分识别内容与排版;不要用基础 ASR 提示替代 SAA。
阅读文章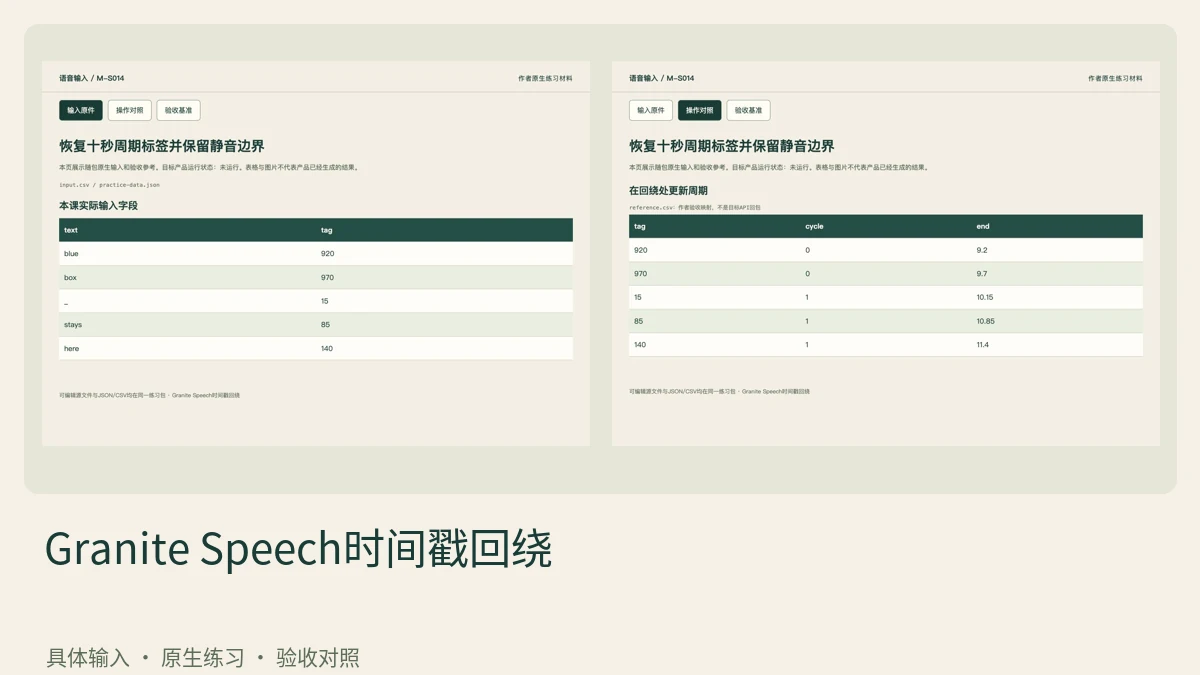
保存原始顺序标签,从 920、970 到 15 时增加周期计数,用 N/100+10R 恢复绝对秒数。保留静音端点并检查单调和音频长度;解析练习不是新的语音识别结果。
阅读文章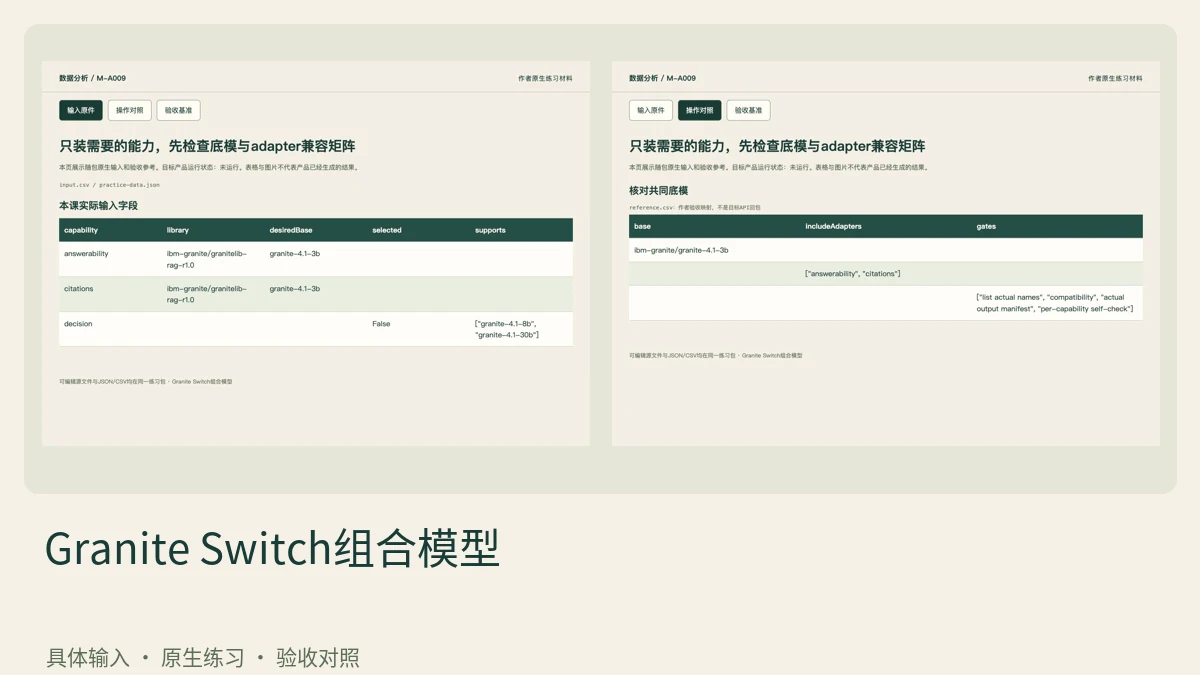
Granite Switch组合模型可先用--list-adapters查看库,再用--include-adapters只选择需要的函数。本课按官方源码示例选择answerability与citations,核对3B共同支持和最终产物,不将整个RAG库下载当作已裁剪完成。
阅读文章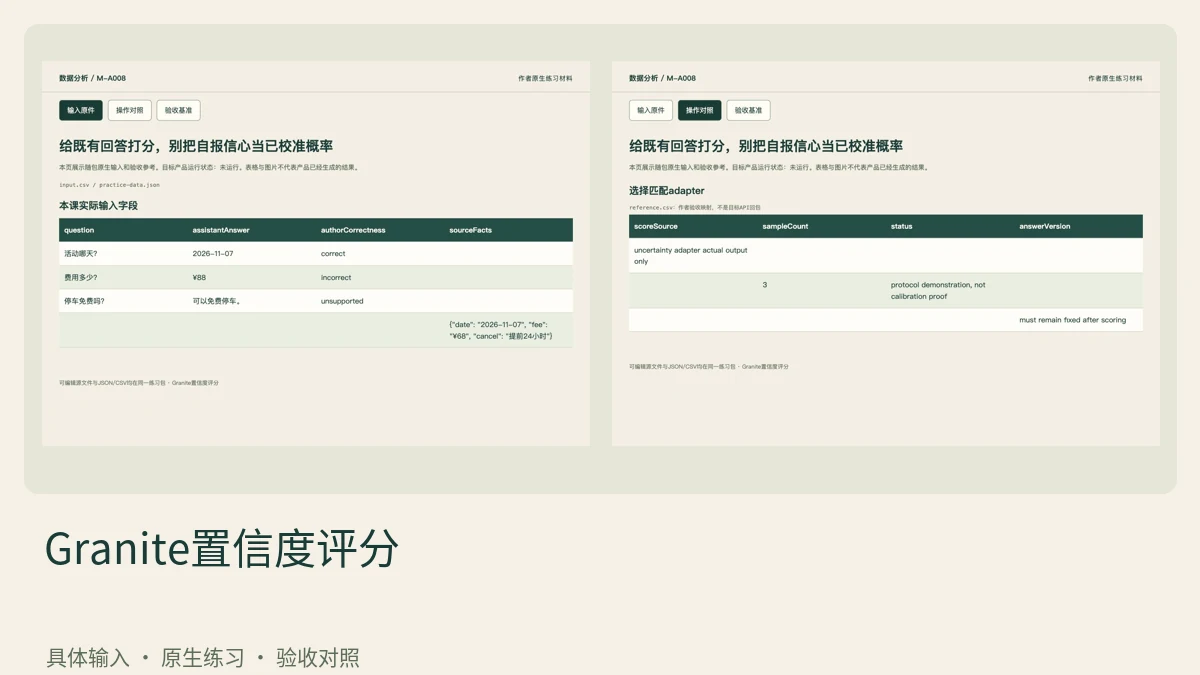
Granite置信度评分在assistant回答之后调用专门adapter。练习保留正确、错误和资料不足三类回答,检查分数分组的实际正确率,而不是直接相信聊天中自称“我很确定”。
阅读文章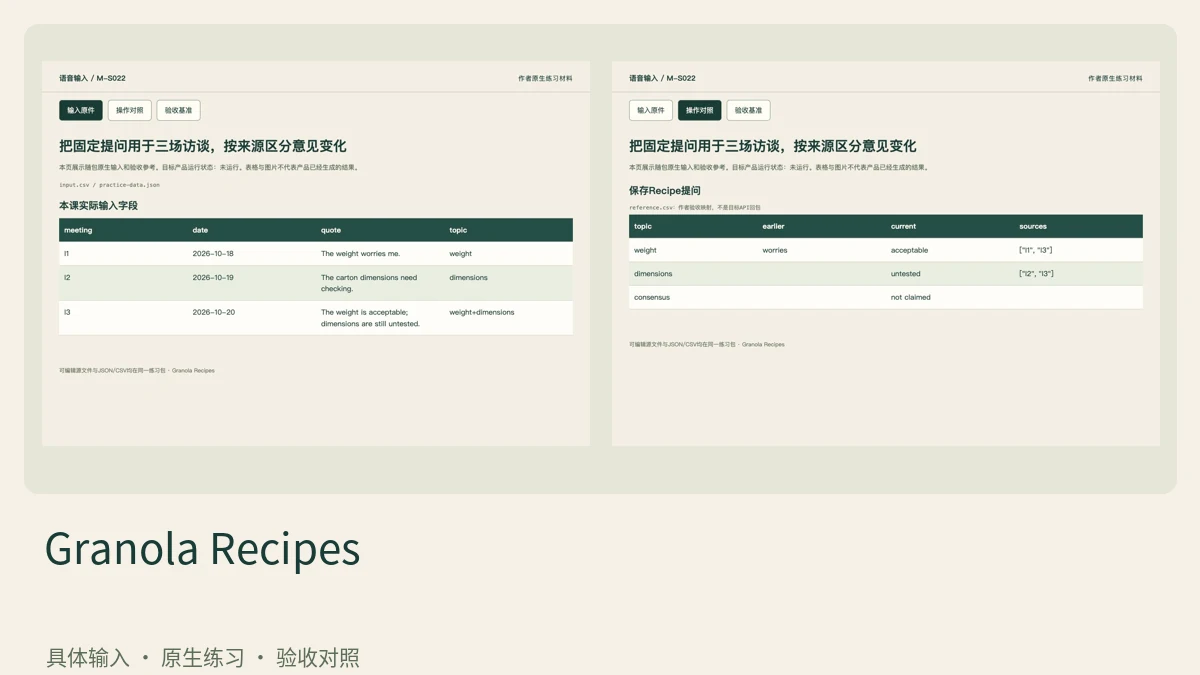
把原意见、最新状态、变化依据、引用来源写进可复用Recipe。提示中明确证据不足就标待确认,不要求AI制造一致结论。
阅读文章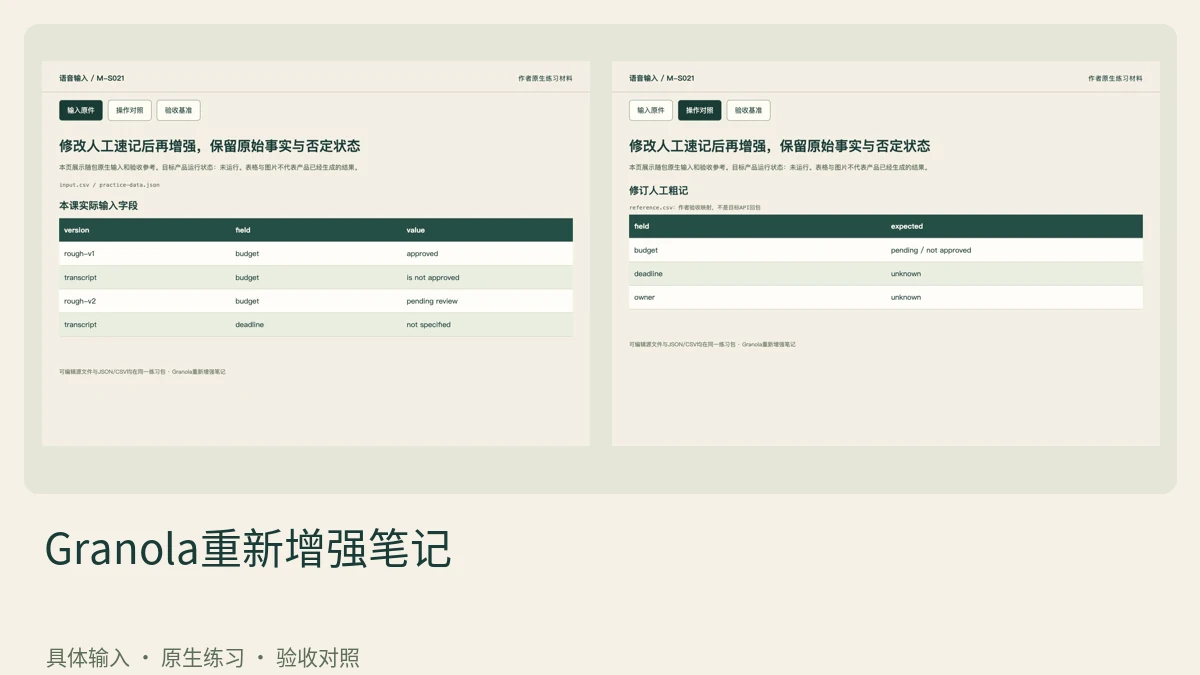
在自己的练习笔记把预算状态改成pending review,保留修改前副本。只改变这一事实,避免连主题结构也重写导致无法归因。
阅读文章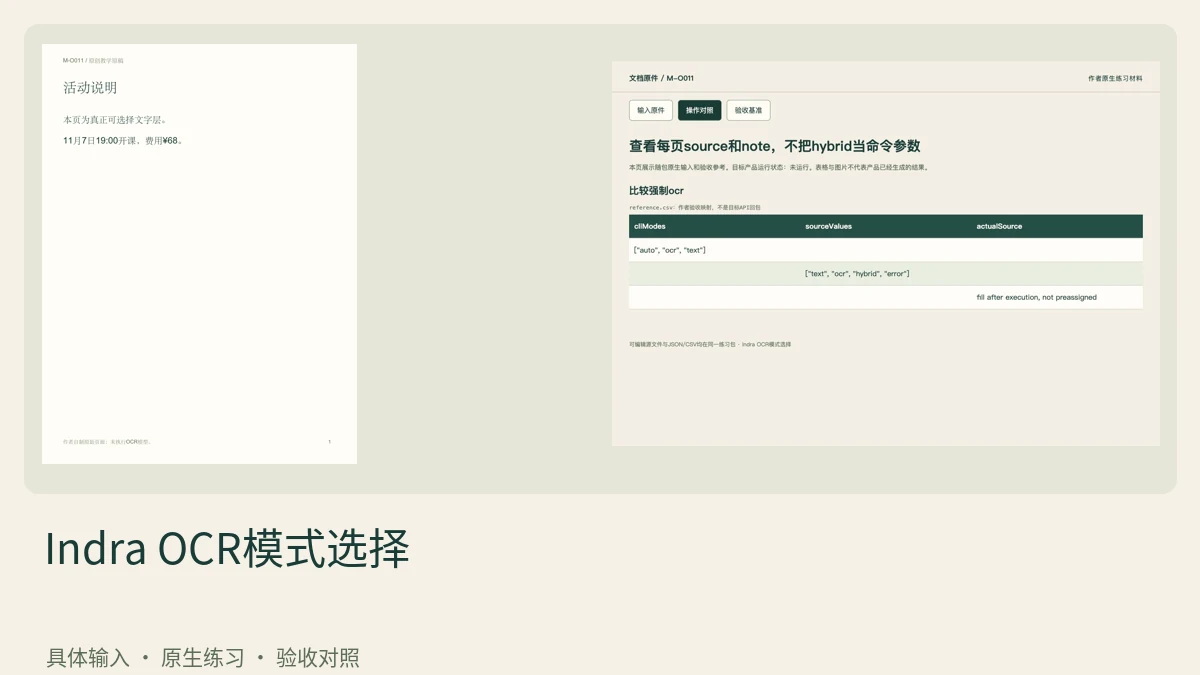
Indra OCR模式选择用可选择文字PDF、纯扫描页和混合页比较路由。命令只允许auto、ocr或text,hybrid是结果来源标签,必须从实际page.source和note判断。
阅读文章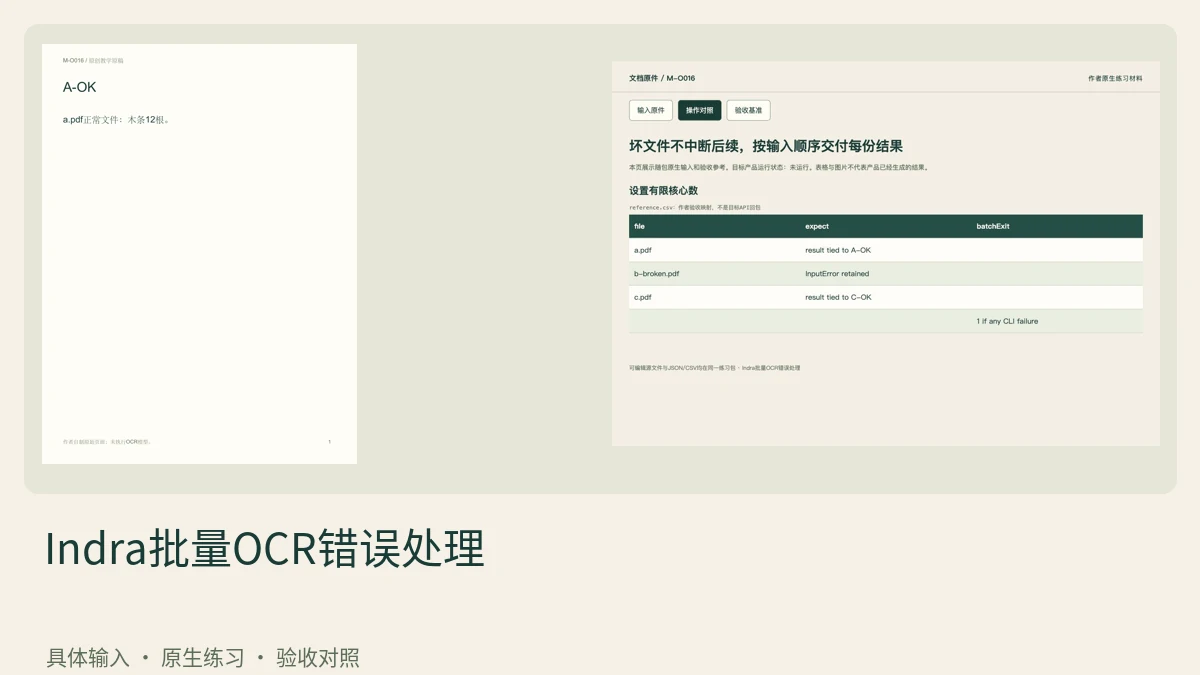
Indra批量OCR错误处理用一份正常PDF、一份损坏PDF和另一份正常PDF验证容错。既要继续处理后面的文件,也要把失败文件留在清单里,不能只交成功输出冒充全批完成。
阅读文章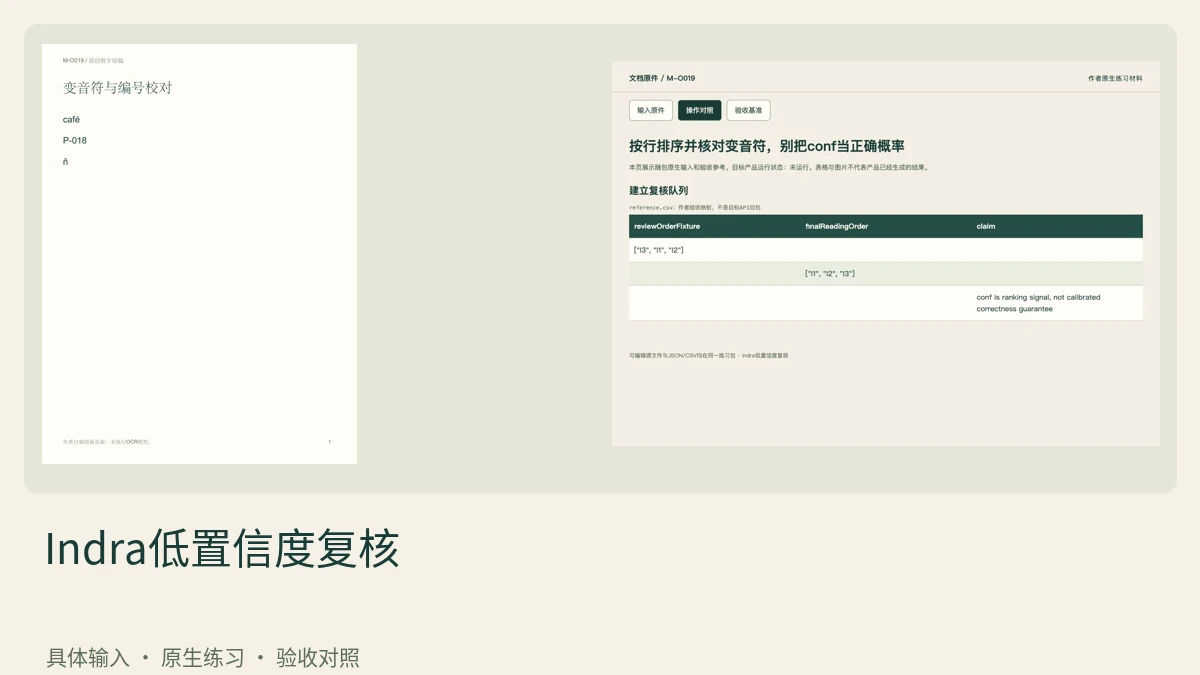
Indra低置信度复核将line.conf作为复查排序信号。练习包含普通英文、带变音符编号和中文标签,既查低分行,也抽查高分行,避免把内部confidence直接解释为字符正确概率。
阅读文章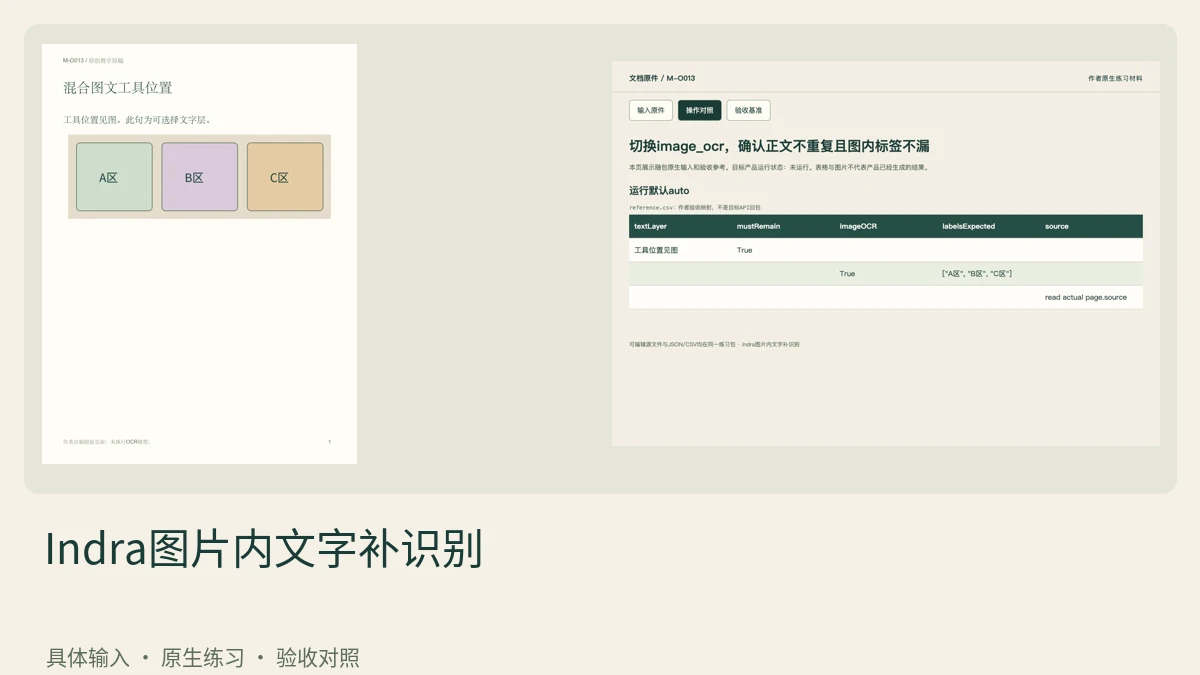
Indra图片内文字补识别在有效PDF文字层之外补读嵌入图像。本课对比开启与--no-image-ocr,检查图片标签进入结果的同时,文字层正文没有被重复加入。
阅读文章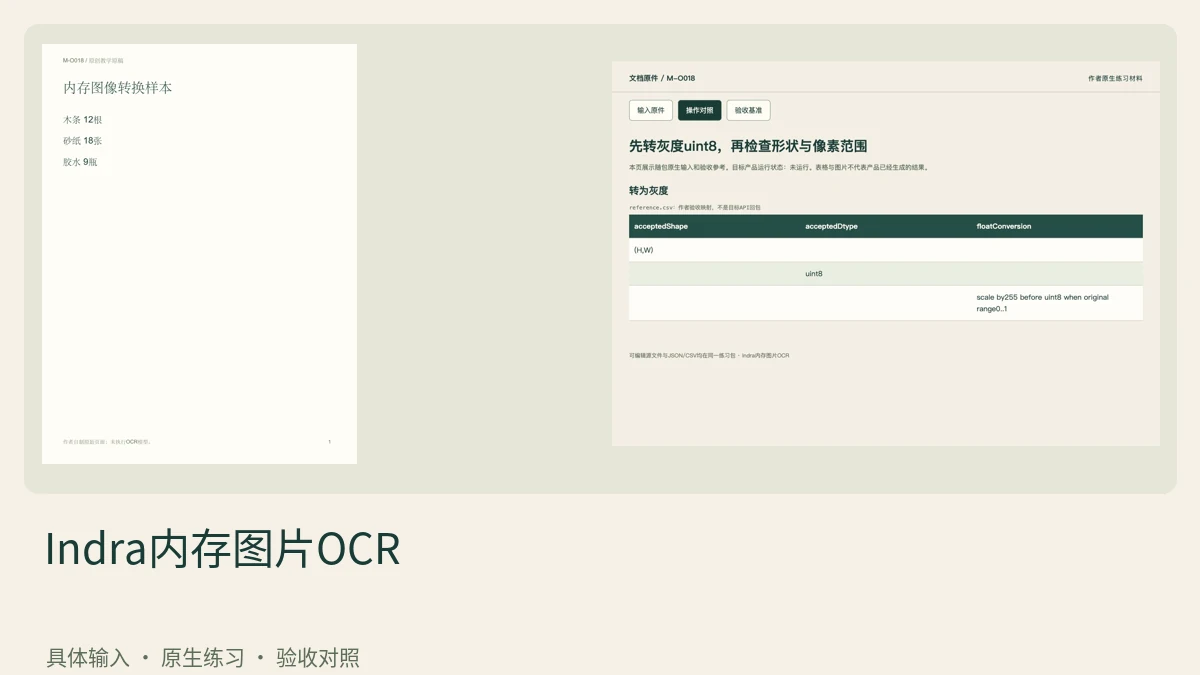
Indra内存图片OCR要求灰度uint8数组。练习比较BGR图、0到1浮点图与正确灰度图,检查数据类型和通道转换,避免图像看似正常但接口输入语义错误。
阅读文章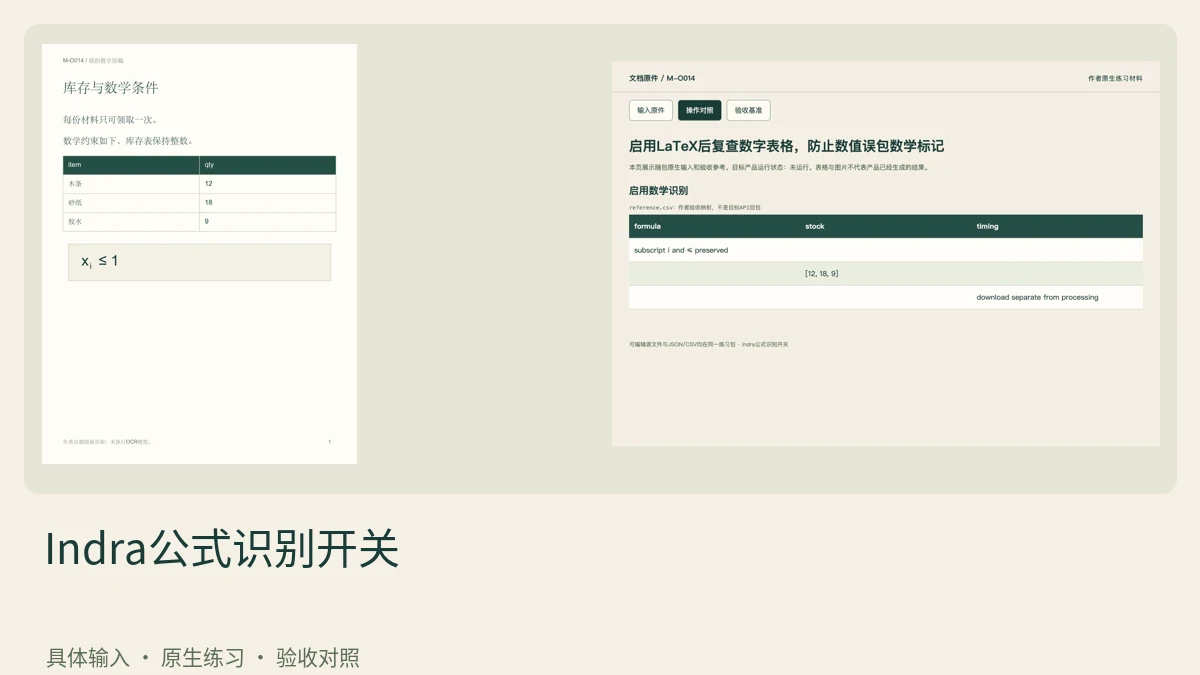
Indra公式识别开关会改变数学行处理,也可能影响普通数字表格。本课同时放一行不等式与三行库存,比较默认和--math结果,按内容类型决定是否接受修订。
阅读文章
Indra限制处理页数将每份文件最多两页与整批两页区分。练习同时给三页和四页PDF,产物附覆盖清单,让“任务完成”不被误读成“原文全量完成”。
阅读文章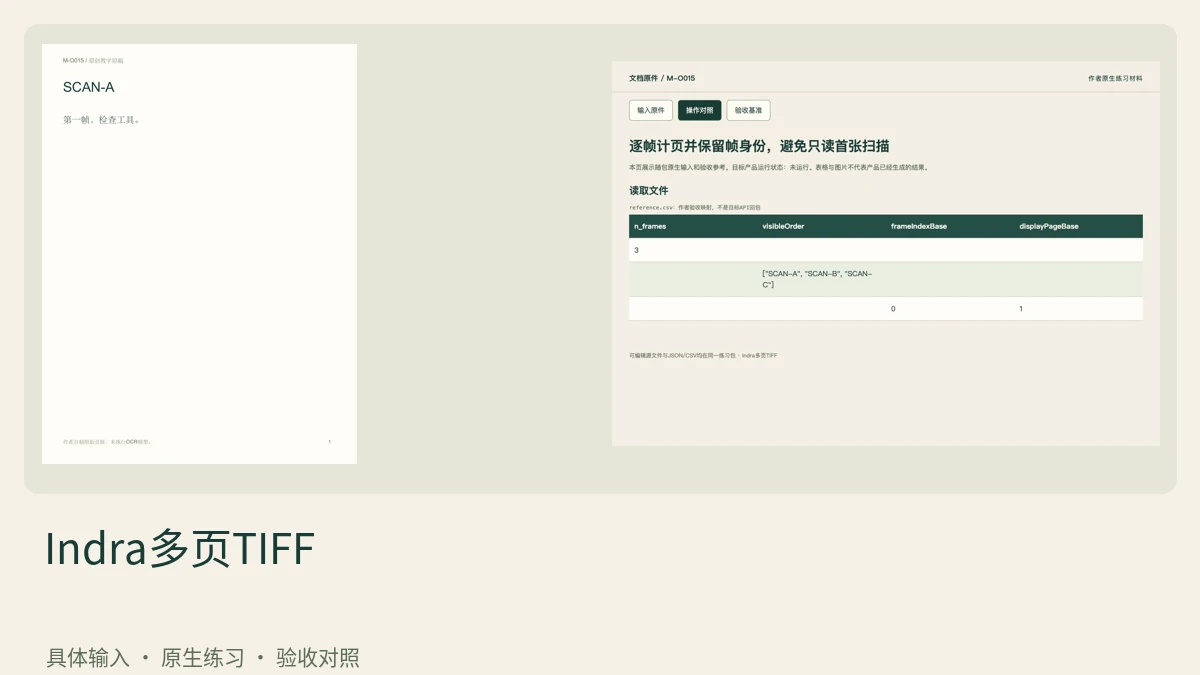
Indra多页TIFF按每个frame产出页面。练习把三张不同编号的扫描封装为一份TIFF,检查输出页数与帧序,而不是只看文件成功读取。
阅读文章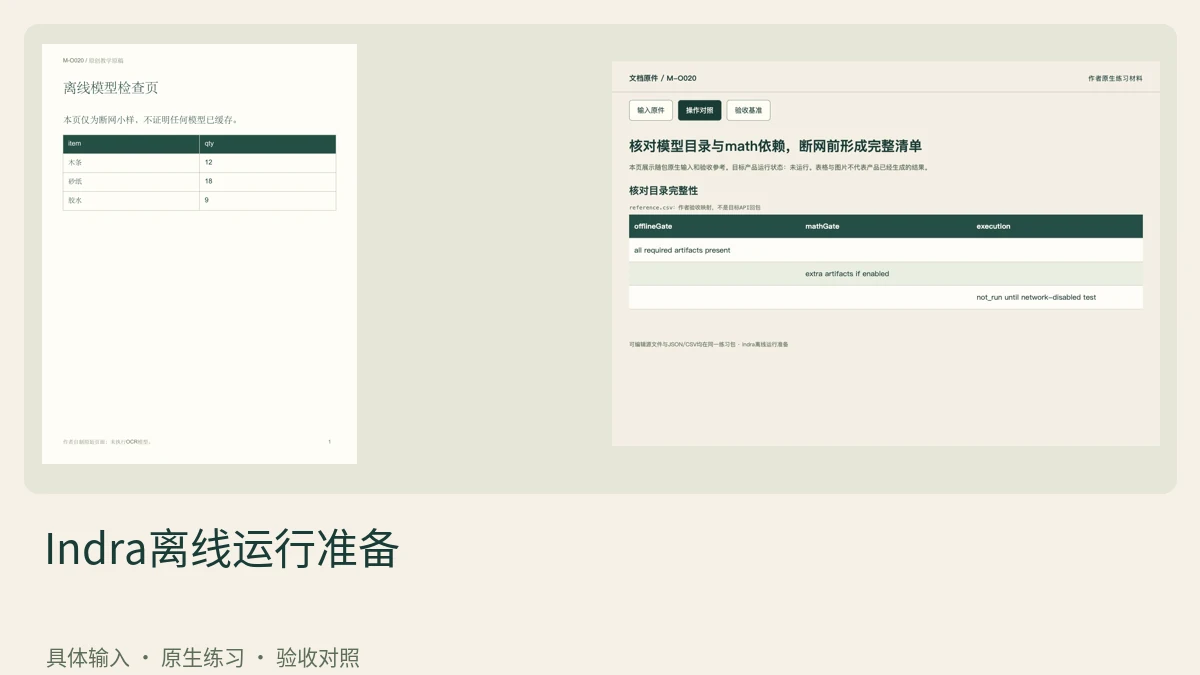
Indra离线运行准备把“CPU可跑”和“首次不联网”区分。先下载并核对默认模型与可选math依赖,再用显式模型目录试跑;代码许可与权重许可也分别记录。
阅读文章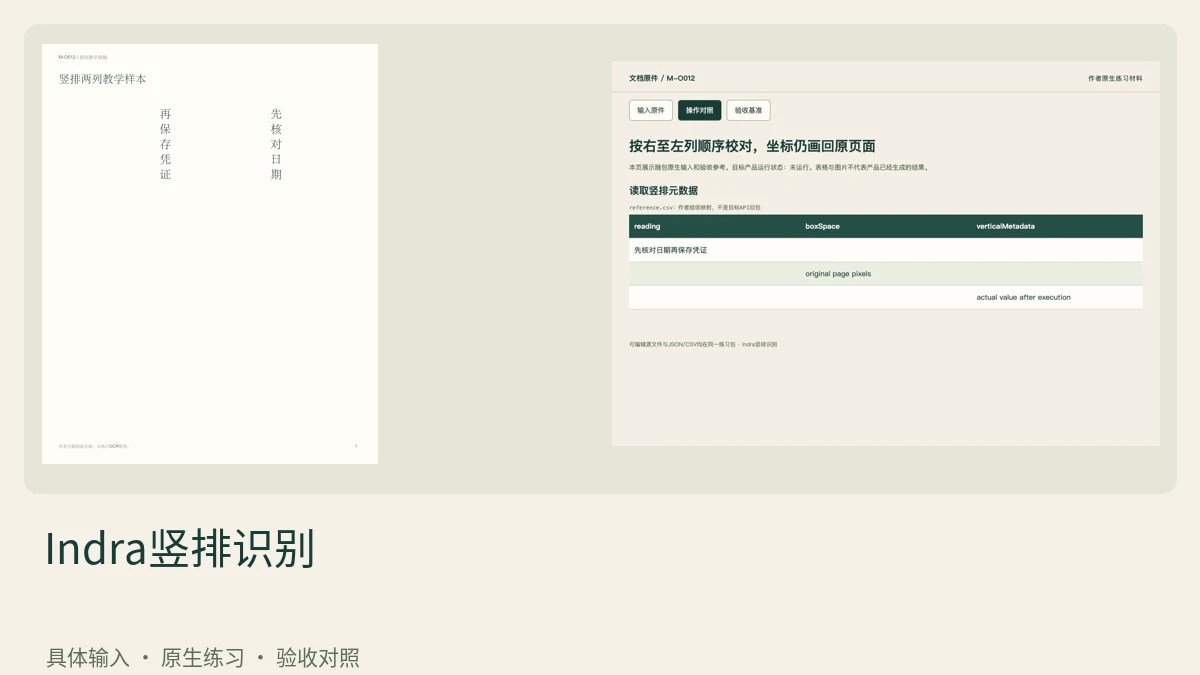
Indra竖排识别检查列顺序与原页面坐标。模型会按转向后的文字行读取竖列,但官方说明boxes仍落在页面原样位置,不能再额外旋转一次造成错框。
阅读文章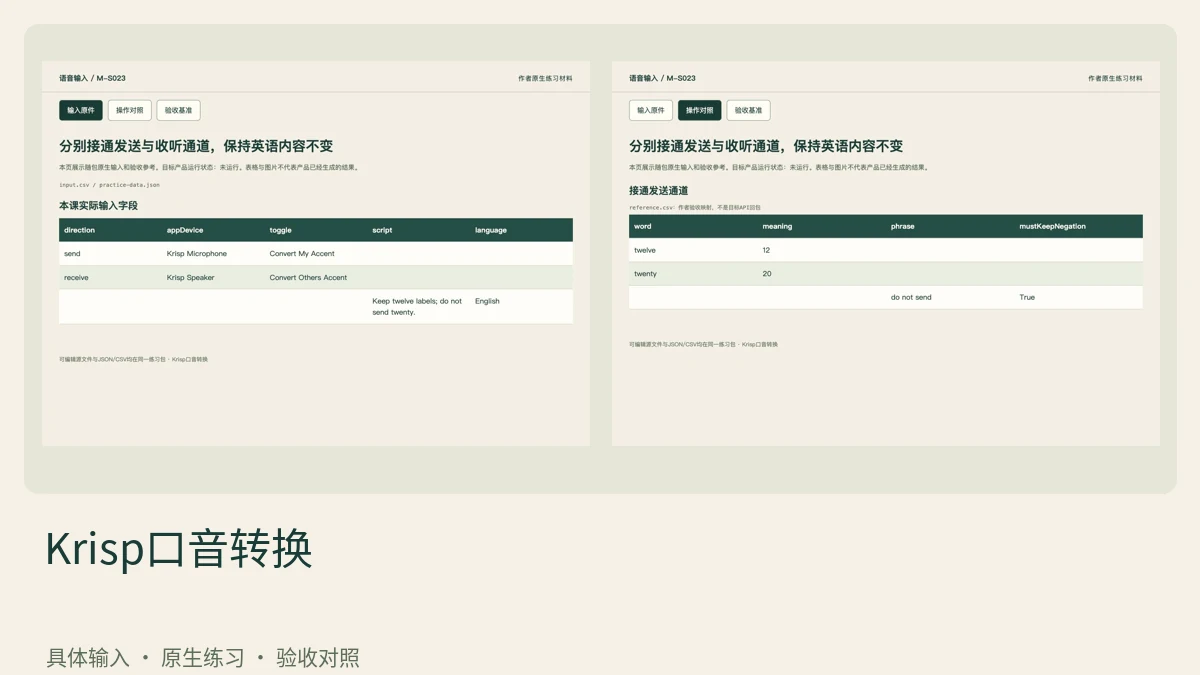
在Krisp选实际输入设备并启用Convert My Accent,再把会议软件输入改为Krisp Microphone。只打开Krisp窗口不足以证明会议音频经过它。
阅读文章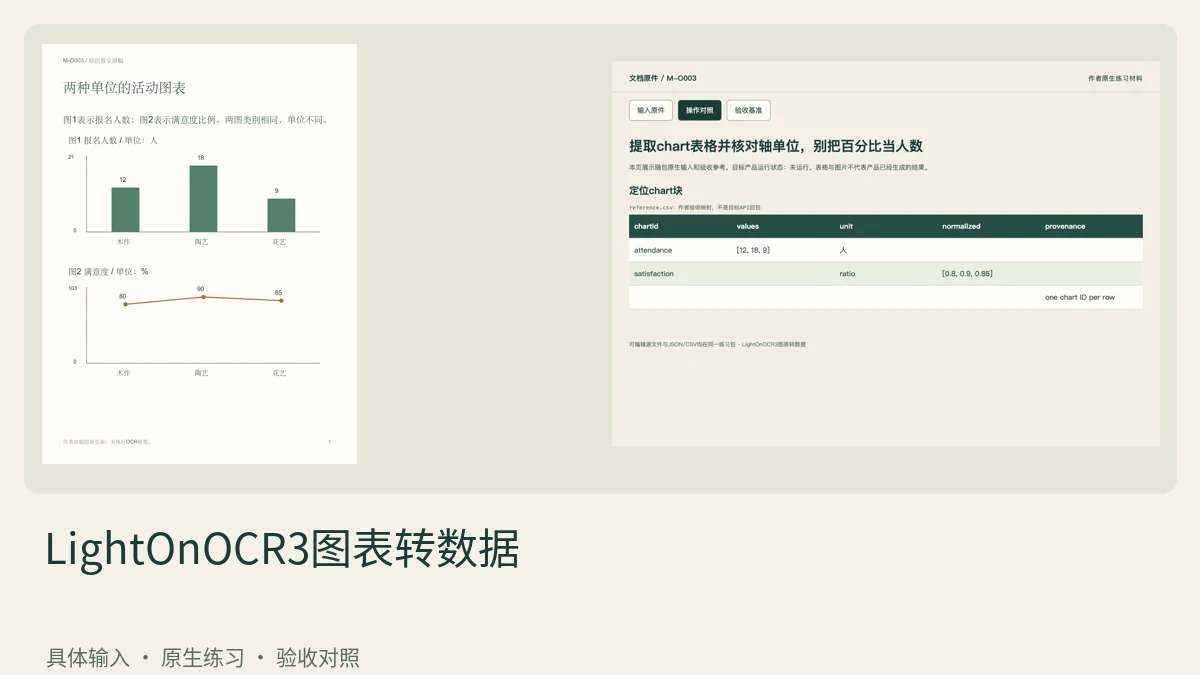
LightOnOCR3图表转数据针对chart块内的HTML表格。练习把人数柱图与满意度百分比折线放在同一页,检查每个表格的单位、类别和原图来源,避免正确数字配上错误含义。
阅读文章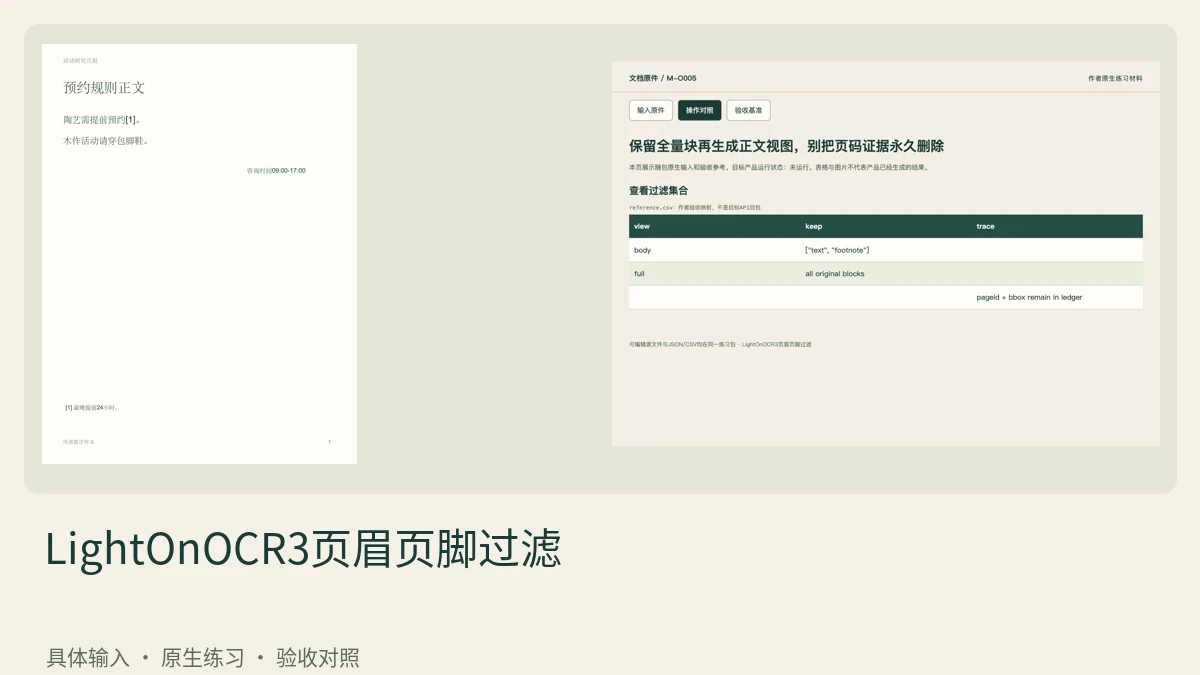
LightOnOCR3页眉页脚过滤使用官方to_markdown的drop集合生成正文视图。全量grounding块继续保留,用来追溯页码、脚注和图注,避免清洗后证据位置丢失。
阅读文章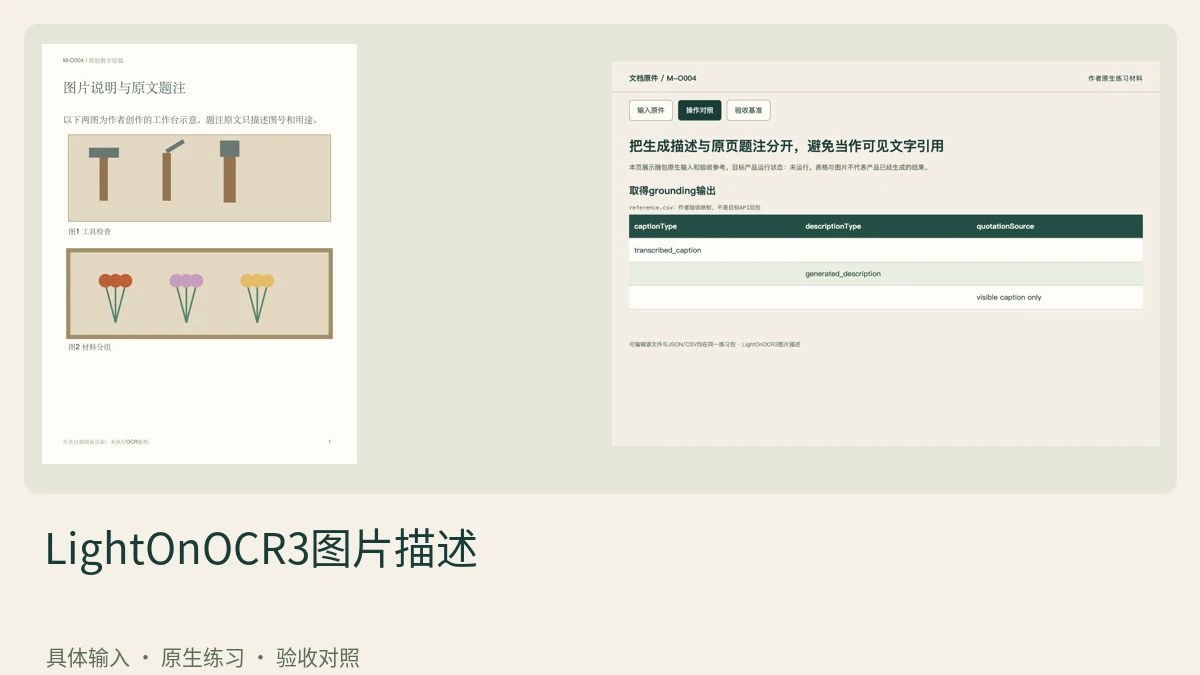
LightOnOCR3图片描述会为image块产生视觉说明。练习同时保存原页题注和模型描述,给两者不同证据类型,防止把模型看图推测误写成原文逐字引用。
阅读文章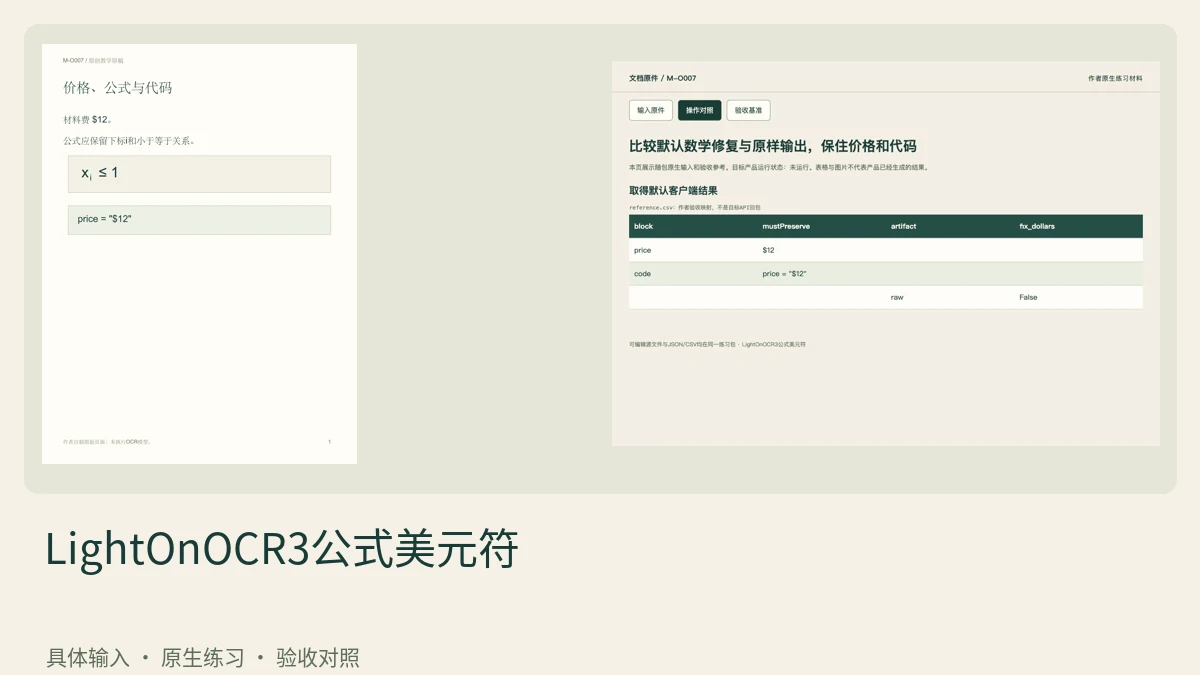
LightOnOCR3公式美元符使用官方客户端的数学分隔符修复开关。练习把价格$12、公式和代码字符串放在同页,检查修复是否只作用于应处理的数学表达,原始输出始终保留。
阅读文章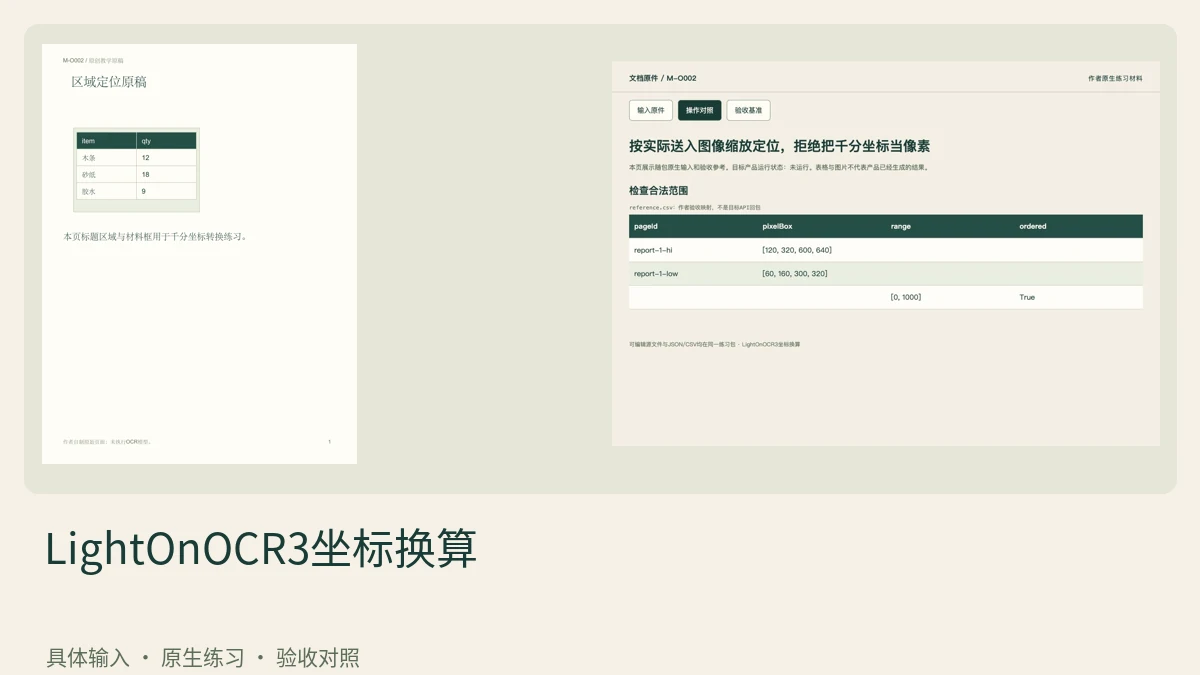
LightOnOCR3坐标换算将0到1000的框转换回实际页面像素。练习同时提供1200×1600与600×800两种渲染,检查框落在相同内容上,并记录坐标属于哪张图。
阅读文章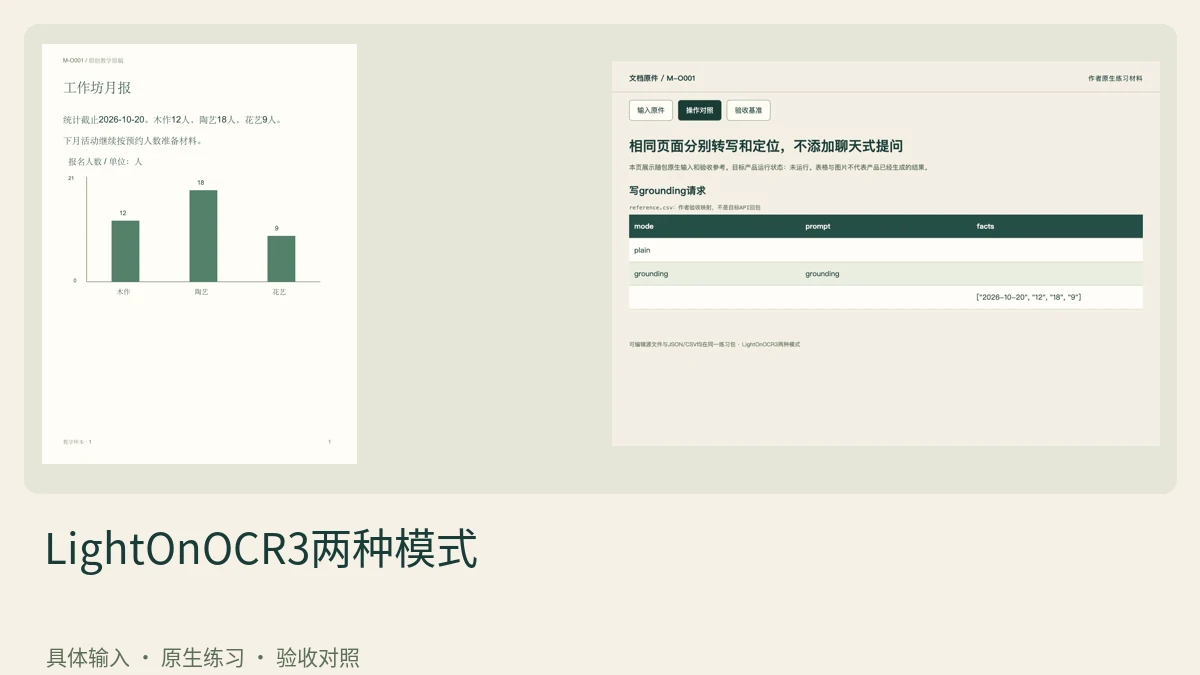
LightOnOCR3两种模式用同一页报告比较纯转写与带坐标输出。模型只推荐空prompt或grounding,本课不会用“请找金额”这类自由指令冒充受支持的文档问答。
阅读文章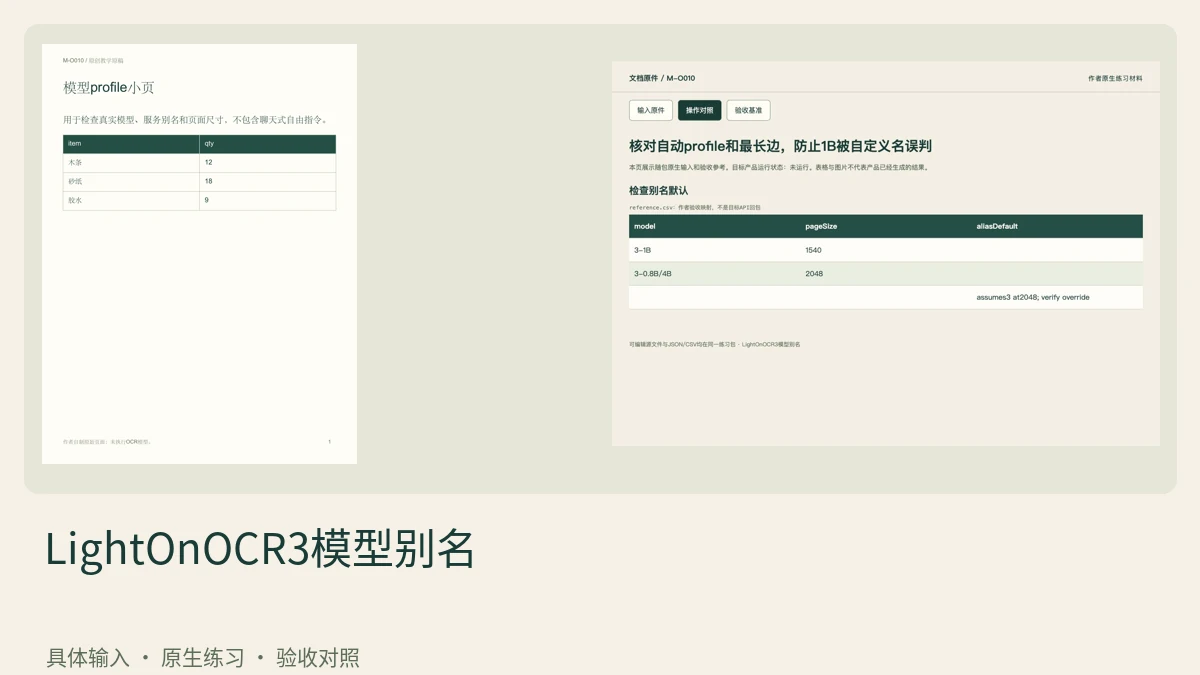
LightOnOCR3模型别名影响官方客户端自动选择页面尺寸和模式。练习比较真实模型名与自定义served-model-name,检查1B的1540px目标不会因别名被误当成2048px默认。
阅读文章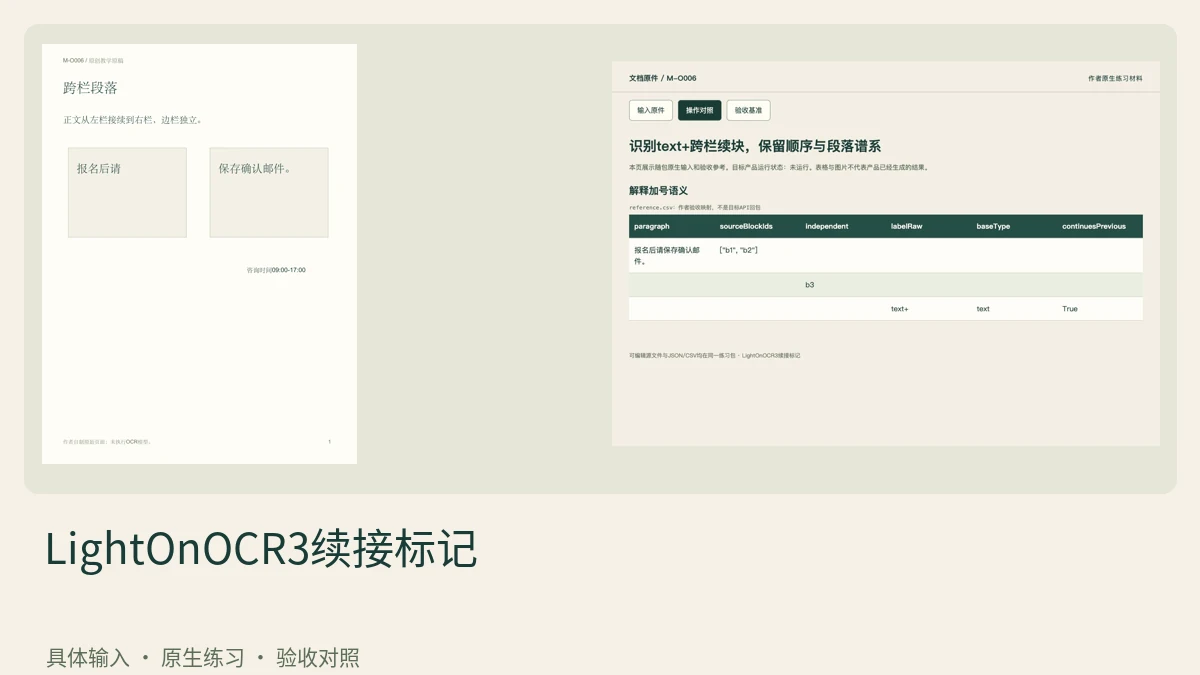
LightOnOCR3续接标记中的加号表示接续上一块,不是新的业务类别。本课用跨栏长段和独立边栏比较合并规则,既恢复连续段落,也保留每个原框的定位。
阅读文章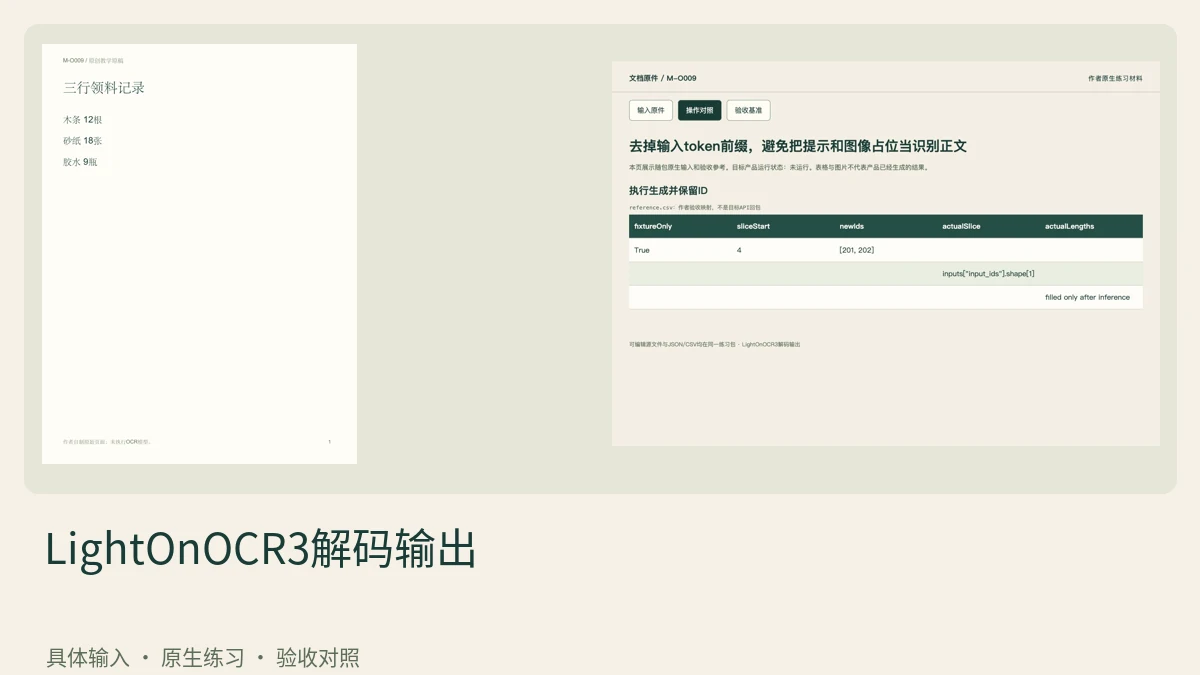
LightOnOCR3解码输出按官方Transformers示例切出新生成token。练习同时保存输入长度与完整生成长度,解释为什么解码整个output_ids会夹带对话提示,影响后续解析。
阅读文章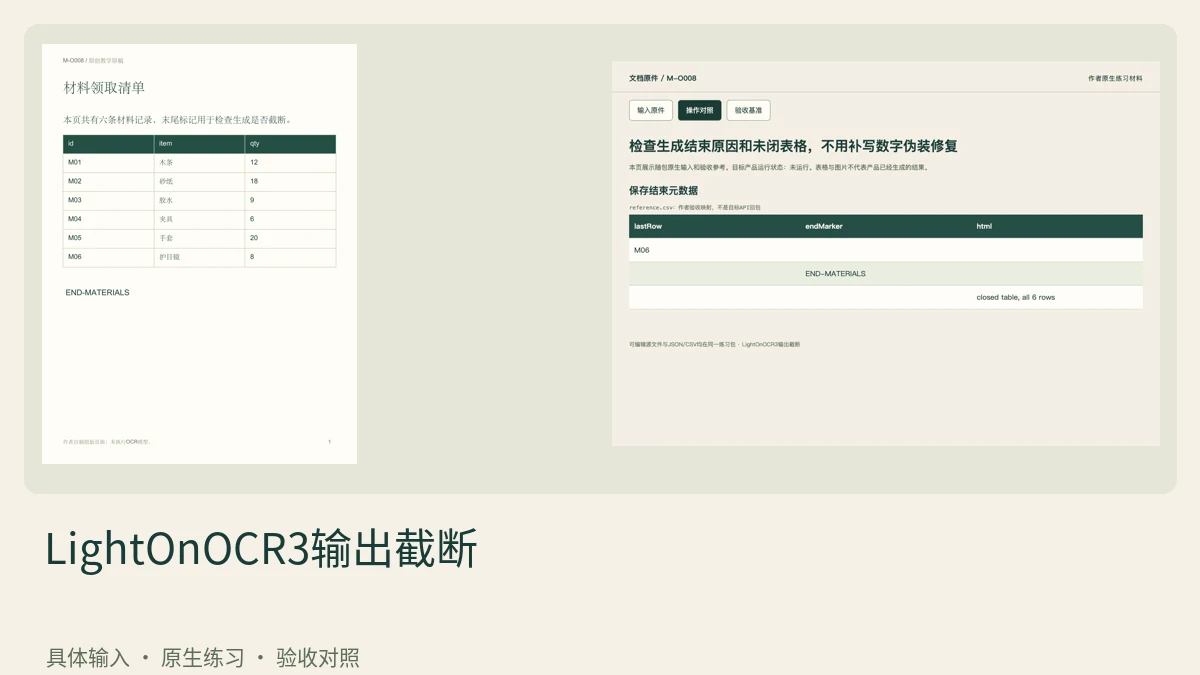
LightOnOCR3输出截断把长表格末尾不完整与正常空值区分。练习用明确的行数、页脚终止标记和HTML闭合检查判断是否需要重跑,绝不手工猜最后几行数字。
阅读文章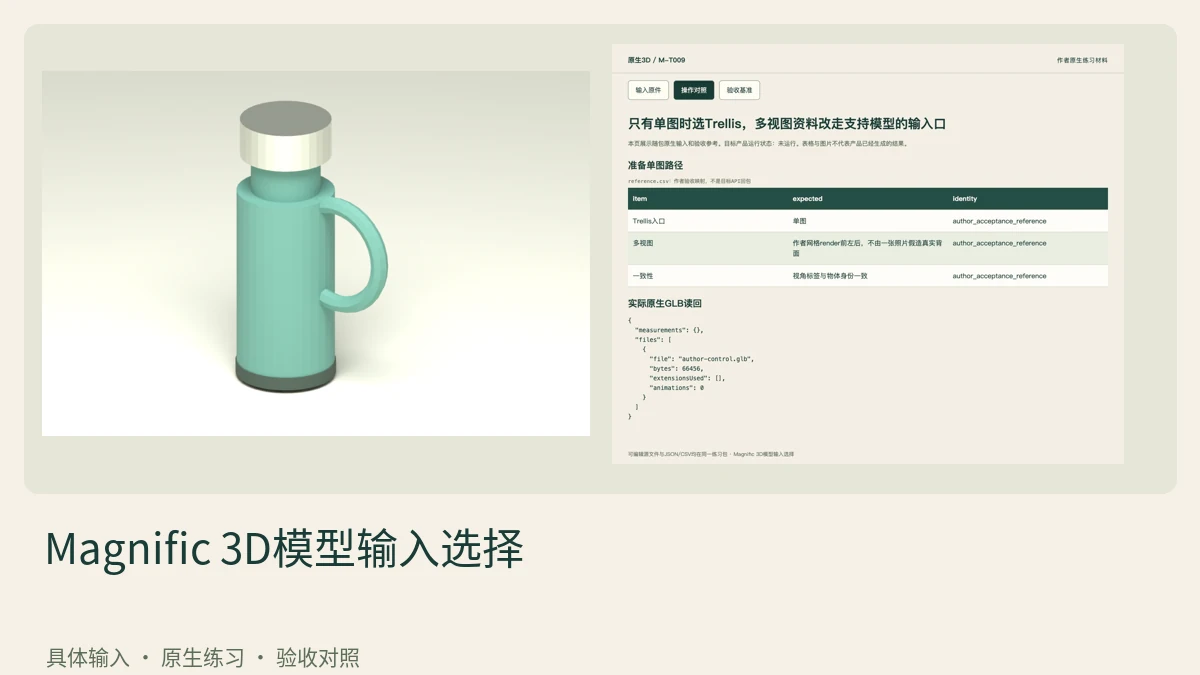
先清点真实存在的视角:只有正面就走当前支持单图的模型,具备多视图时再选支持的输入口。分开上传同一物件各视角,保留背面未知;多张接触表不是标准单物体参考。
阅读文章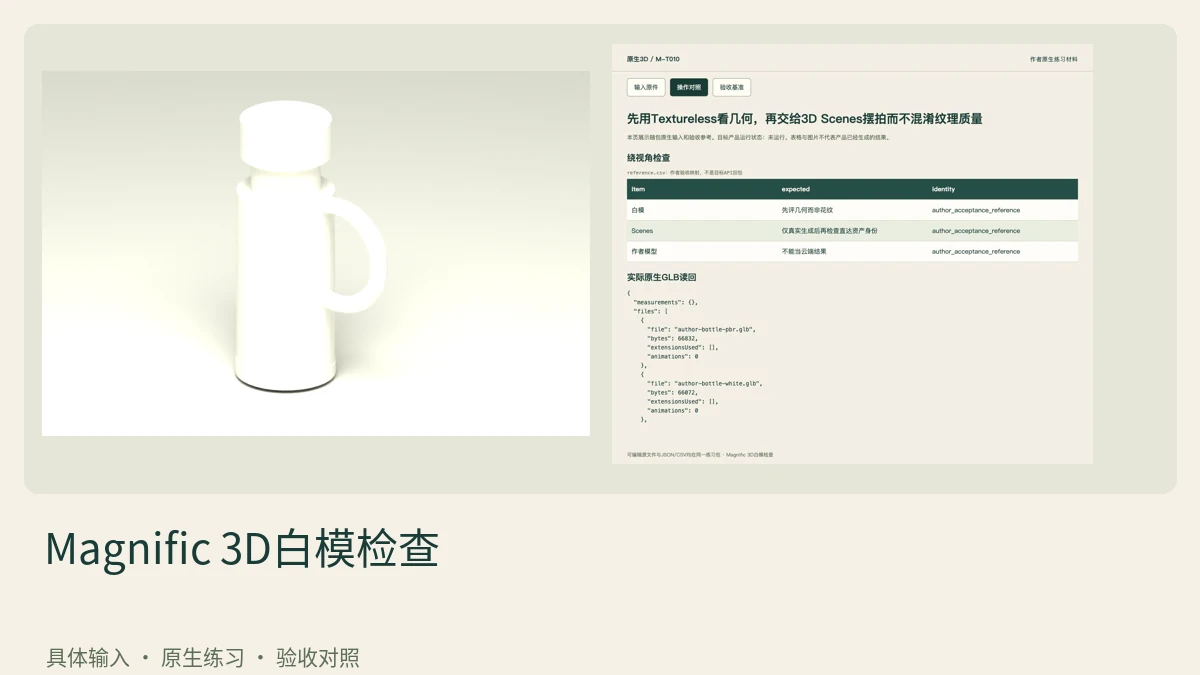
实际生成后先用 Textureless 绕看正、侧、背、底,检查孔洞与轮廓,再单独审材质版本。通过后再转 3D Scenes 摆拍;正面纹理好看不能证明几何完整或模型可打印。
阅读文章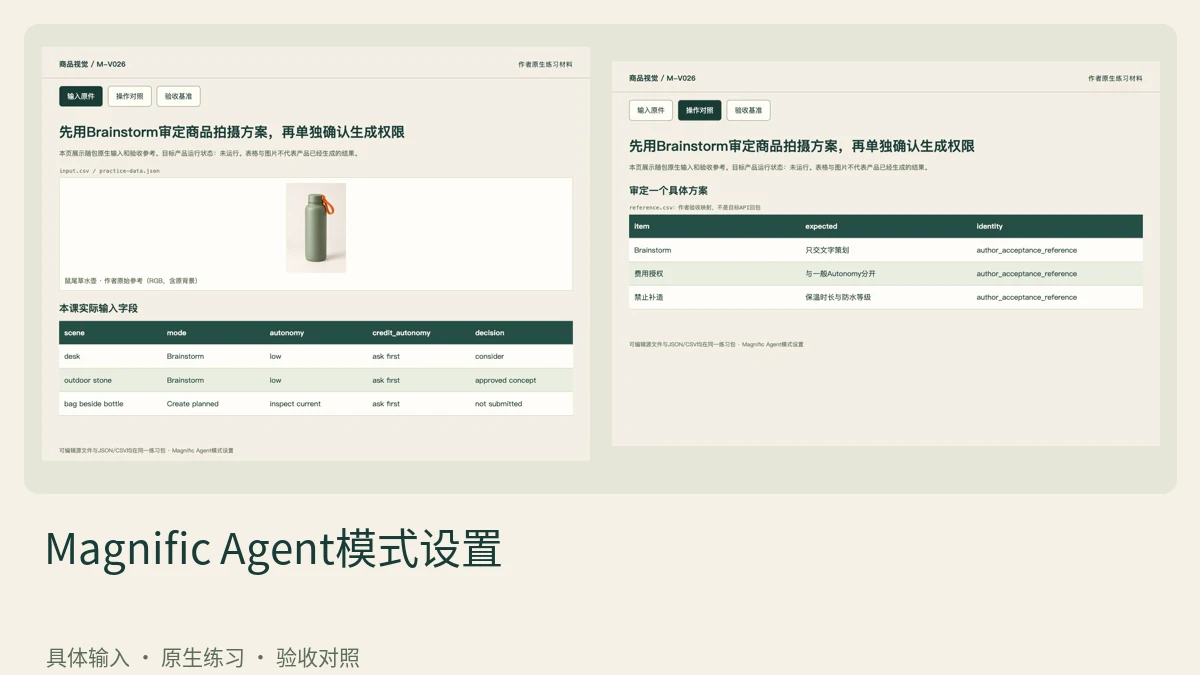
先在 Brainstorm 比较桌面、石台和包袋旁三个场景,明确选中方案与商品保留项。再分别检查创建内容和使用额度的权限,确认后才运行生成;聊天中的方案不是已产出的图片。
阅读文章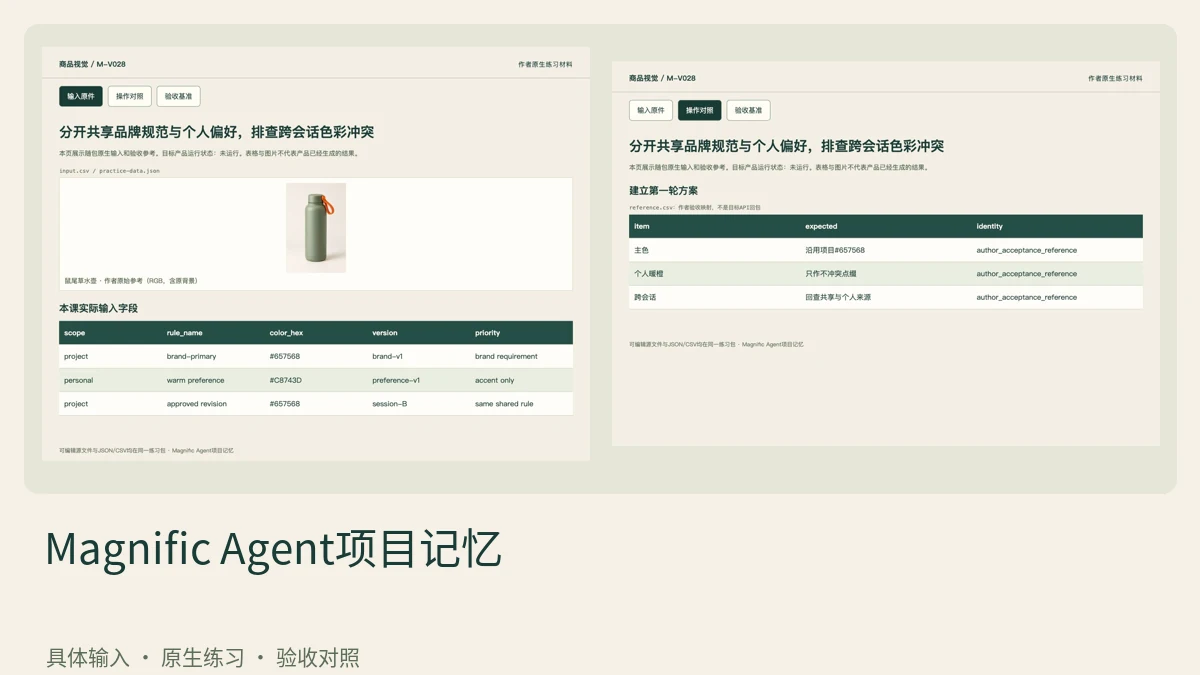
把共享品牌色与个人偏好分别注明作用域,在会话 A 明确引用规范,新会话再要求列所用色值。用原始色板核对冲突并追查记忆来源;不能仅凭显示器上颜色相近判断规则生效。
阅读文章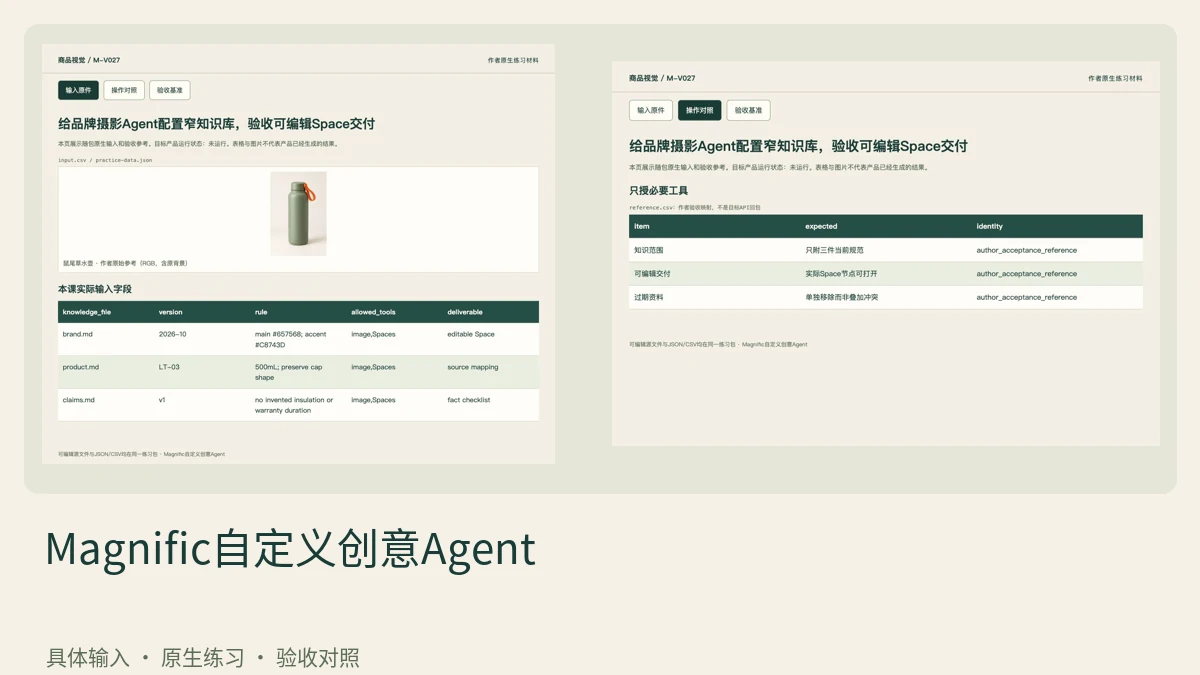
为品牌摄影任务附窄范围规范和商品参考,只开启必要 Image/Spaces 能力。先要求说明引用来源,再完成一个可编辑 Space 并检查节点、素材和标题;本站未运行该云端 Agent。
阅读文章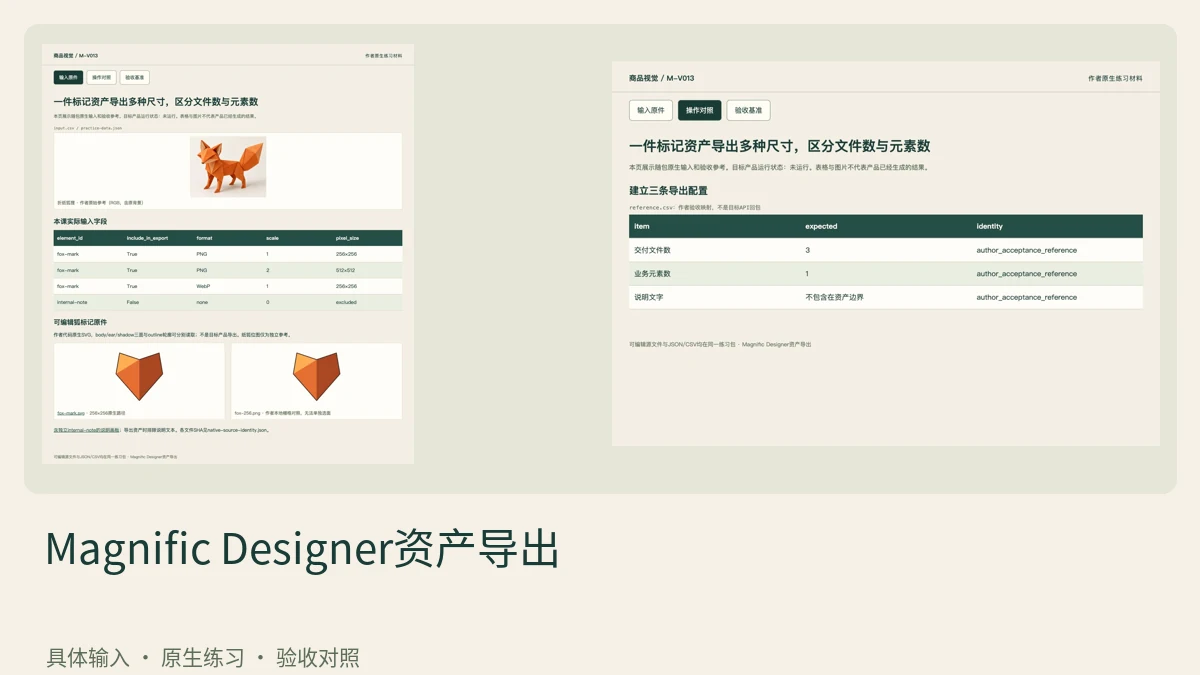
给一个选中资产标记 Include in export,在同一元素配置 PNG 1x、PNG 2x 和 WebP 1x。导出后测实际像素、透明边与文件数;三套导出配置不需要复制成三个图层。
阅读文章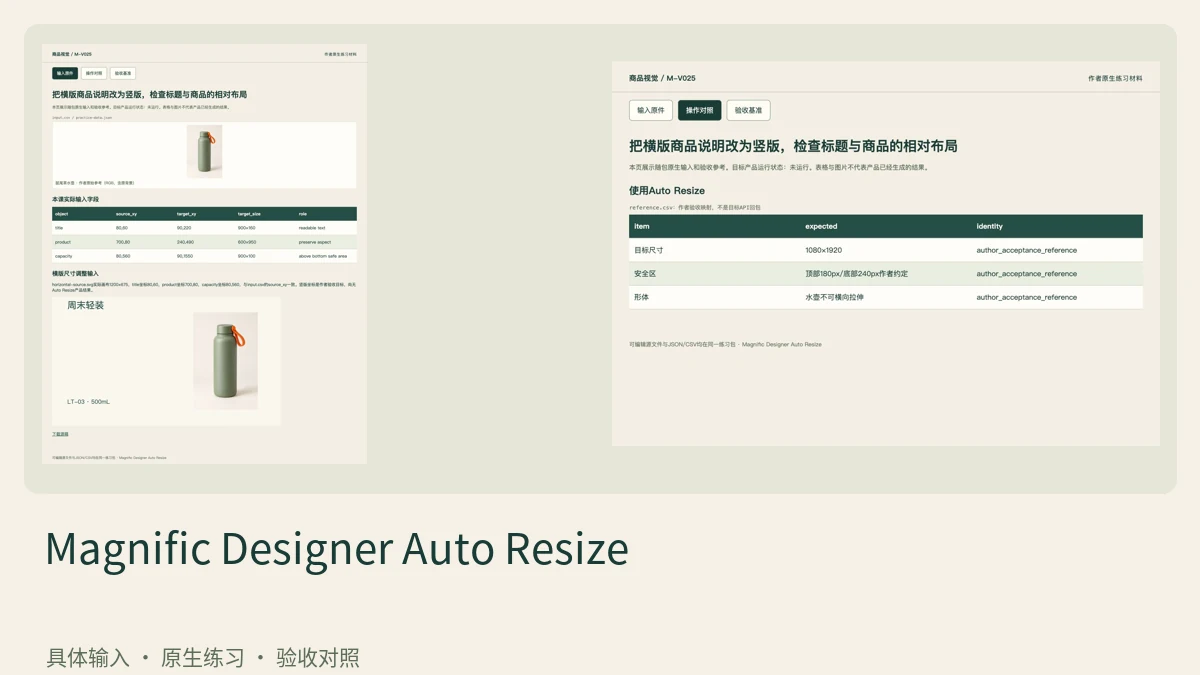
保存横版源设计并规定竖版信息优先级,使用当前 Auto Resize 入口后逐项检查标题、商品和说明的相对位置。复测文字换行与主体比例,再导出真实尺寸;自动重排不保证所有对象都合理。
阅读文章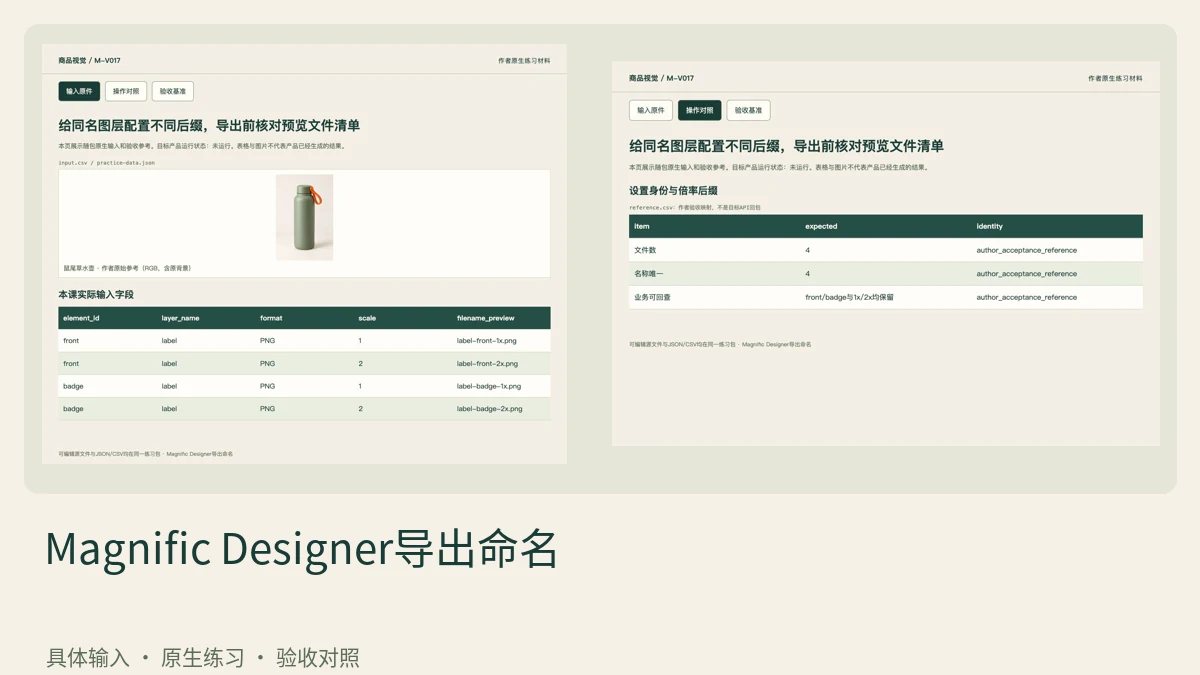
为 front 与 badge 两个同名元素设身份后缀,并分别配置 1x、2x 名称。导出前查看实际文件预览,导出到新目录后核对四件文件;只使用当前面板支持的命名语法。
阅读文章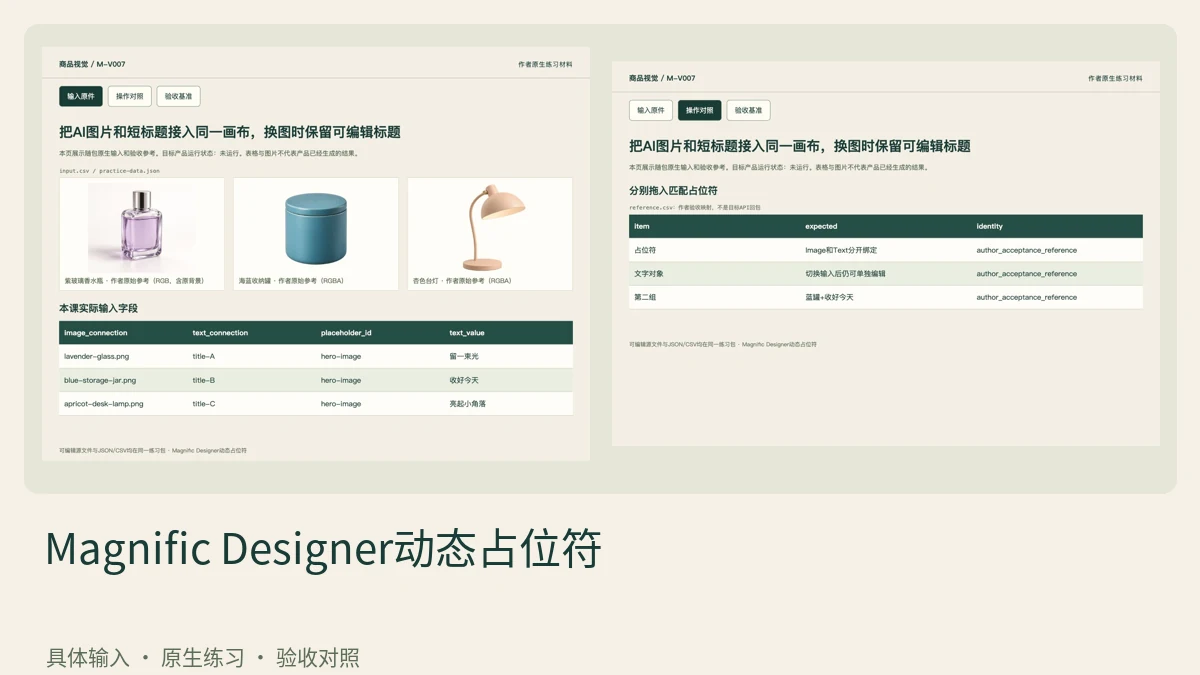
从 Spaces 打开 Designer,把图片线接图像占位符、标题线接文字占位符。先改一个标题确认文字可编辑,再换图片检查框内填充,不能把带字位图当成独立动态标题。
阅读文章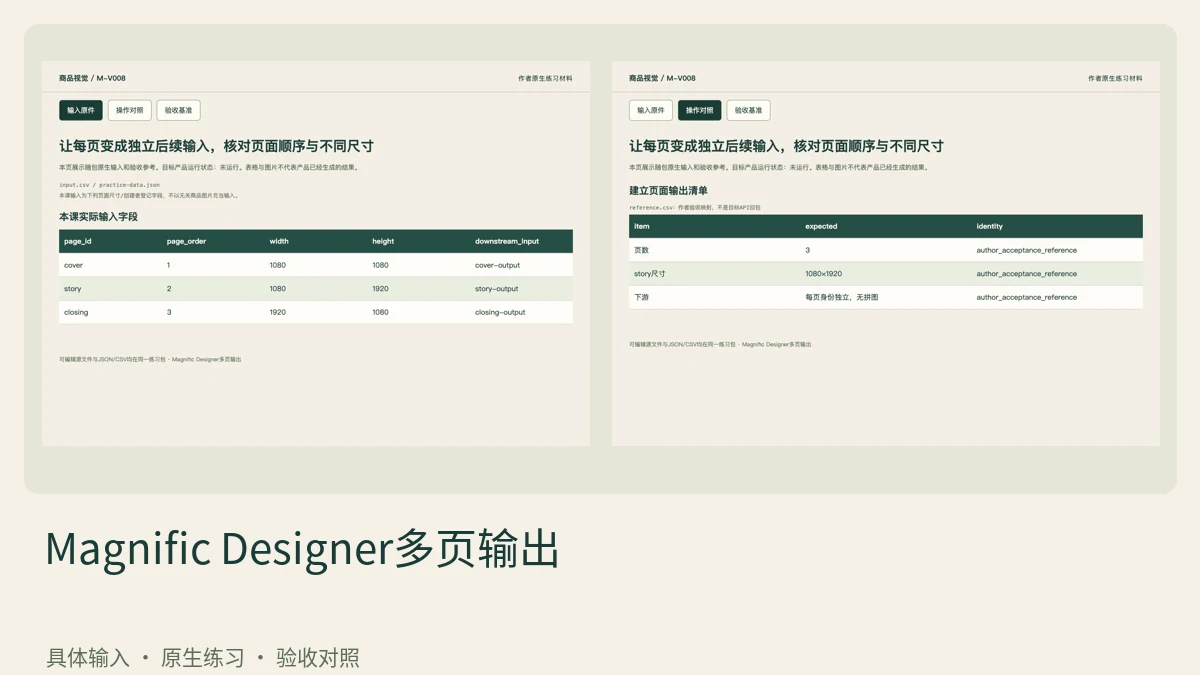
在 Designer 中建立三种尺寸页面,从节点取得实际页面结果后,逐页登记 ID、尺寸与顺序。只把指定页接到下游,再核对实际输入,避免把联系表或所有页合成图当独立页面列表。
阅读文章注册后创建 apizt API Key,选择客户端和模型,再生成接入配置。从一次简单请求开始,按实际用量付费。
在控制台创建令牌,选择需要使用的模型权限。
按工具要求填写 API Key、接口地址与模型 ID。
确认收到有效结果,再到控制台查看用量与费用。