
Dyad 导入已有项目:保留 React 路由后增加客户详情页
以最小 React 参考项目保存现有路由清单,新增客户详情并对未知 ID 返回明确空状态。
阅读文章正在打开页面…
正在加载内容,请稍候。
从 API Key、Base URL 配置到首次调用,按工具查找接入步骤与常见报错;也可浏览图像、视频、自动化和办公任务教程。
获取 API Key1450 篇教程,当前显示第 1153–1200 篇。选择页码继续浏览,或切换任务主题。
以最小 React 参考项目保存现有路由清单,新增客户详情并对未知 ID 返回明确空状态。
阅读文章
把修改限定到一个预约表单,增加明确校验,保存其他文件哈希后核对局部修改边界。
阅读文章
为两个匿名测试身份写出预约表、RLS策略和真正发到数据库的验证脚本,把“页面没显示”与权限隔离分开验收。
阅读文章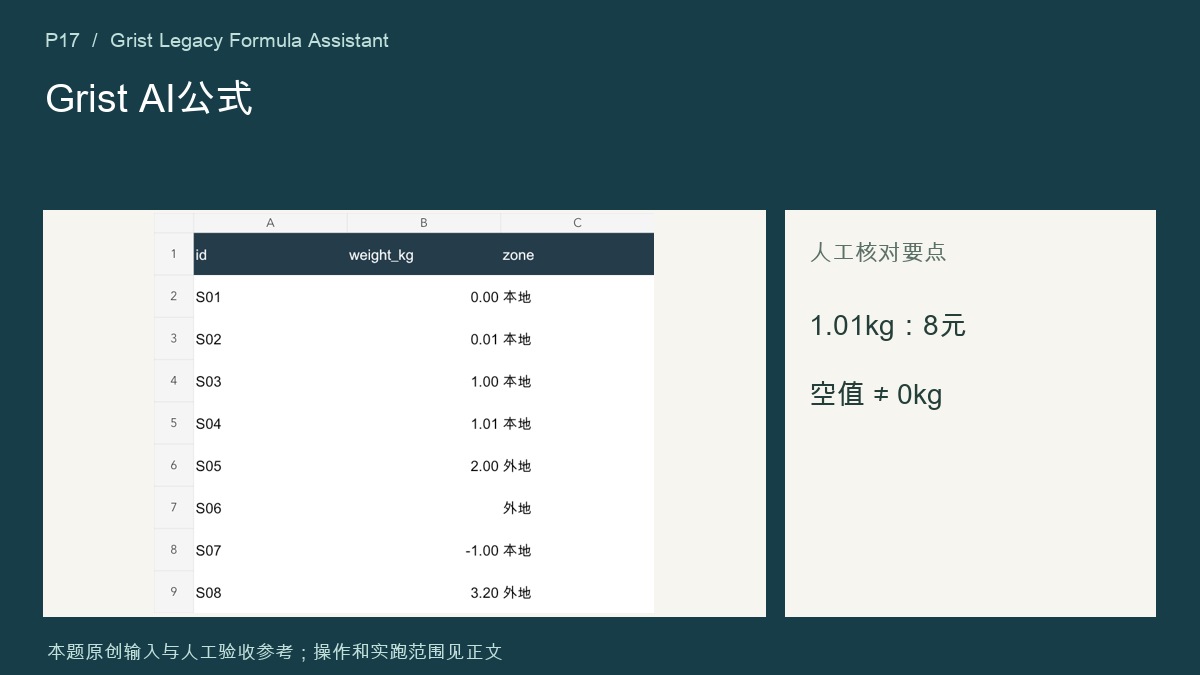
预览整列阶梯运费,区别零重量与空白输入。先下载输入、保留原始文件,再在真实工具执行;人工参考只用于本题事实验收。Grist社区代码Apache-2.0;Legacy仅生成公式,需配置AI provider。本包实际运行人工规则计算器,未运行Grist或AI。
阅读文章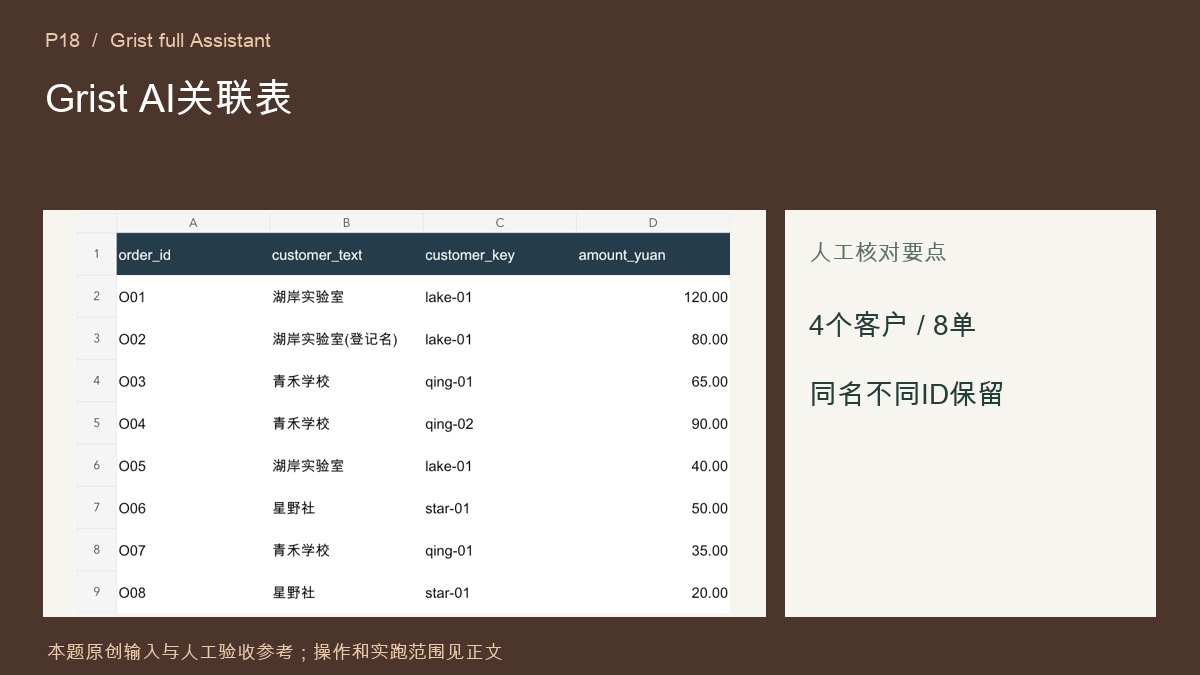
把八条订单关联到四个客户,保留同名不同ID。先下载输入、保留原始文件,再在真实工具执行;人工参考只用于本题事实验收。新版Assistant本地需full edition;社区Legacy不足以执行本题。云端额度依实际计划,模型需tools能力。
阅读文章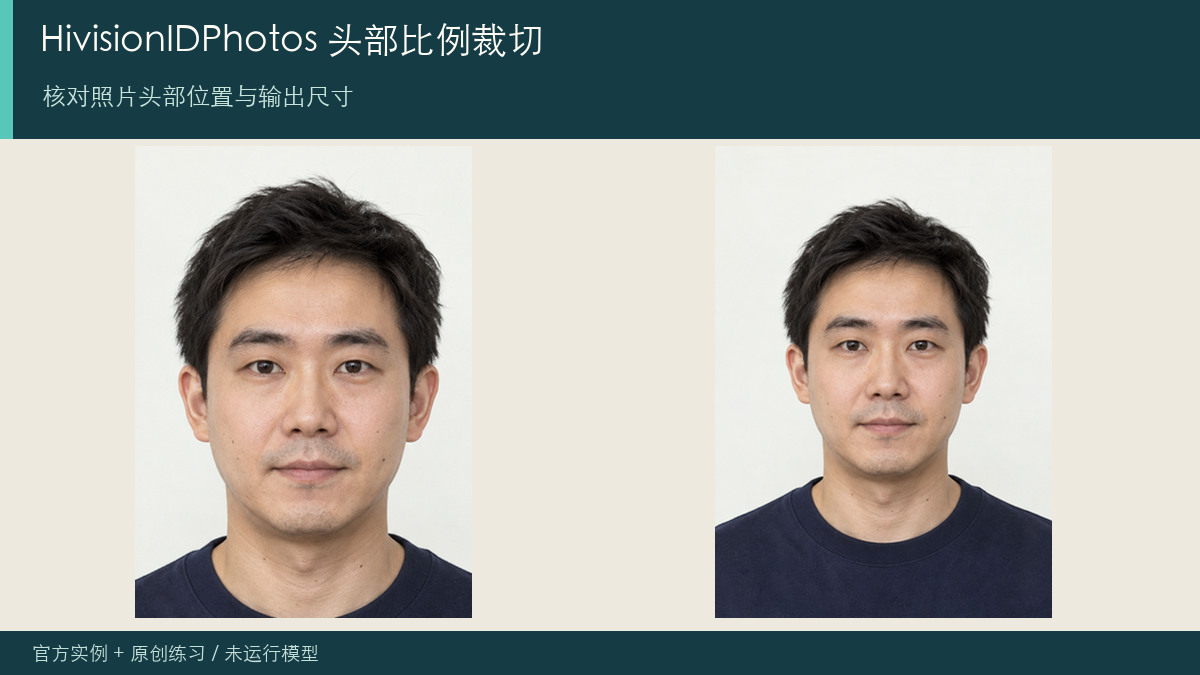
在保留原图的副本上确认 head_measure_ratio、head_height_ratio 与输出尺寸,先比较两种裁切参考,再运行有模型的实际接口。
阅读文章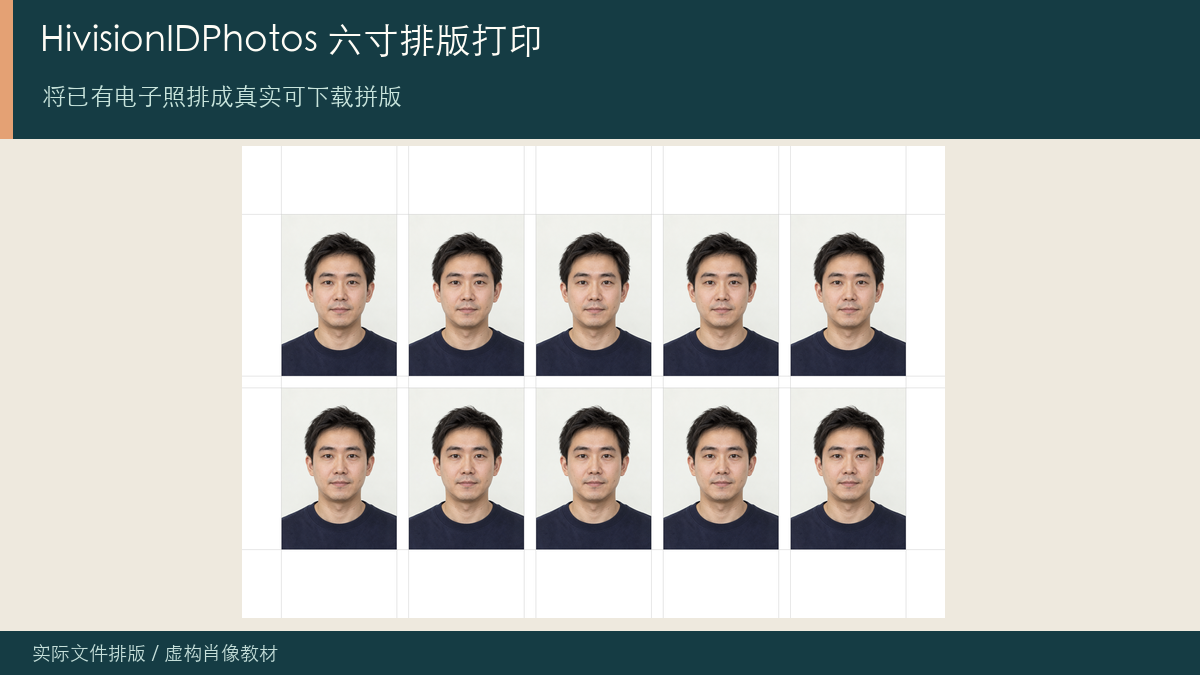
用 HivisionIDPhotos 的无模型排版代码,把 295×413 像素电子照放入六寸画布并生成 print-layout.png。读回每张位置和尺寸,打印预览选择实际大小 100%,不让适应页面缩放改变成品规格。
阅读文章
描述橙色狐狸、青色围巾与浅色背景,控制层保留轮廓。原始线稿锁定在最上方,生成结果放独立层,便于看出生成改线与原线叠加的差别。 7 个步骤使用同一明确输入,真实结果与人工/官方参考分别标识。 已完成原创输入、可下载材料和文件预检;未运行本页工具的模型、TTS、付费 API 或外部生成。
阅读文章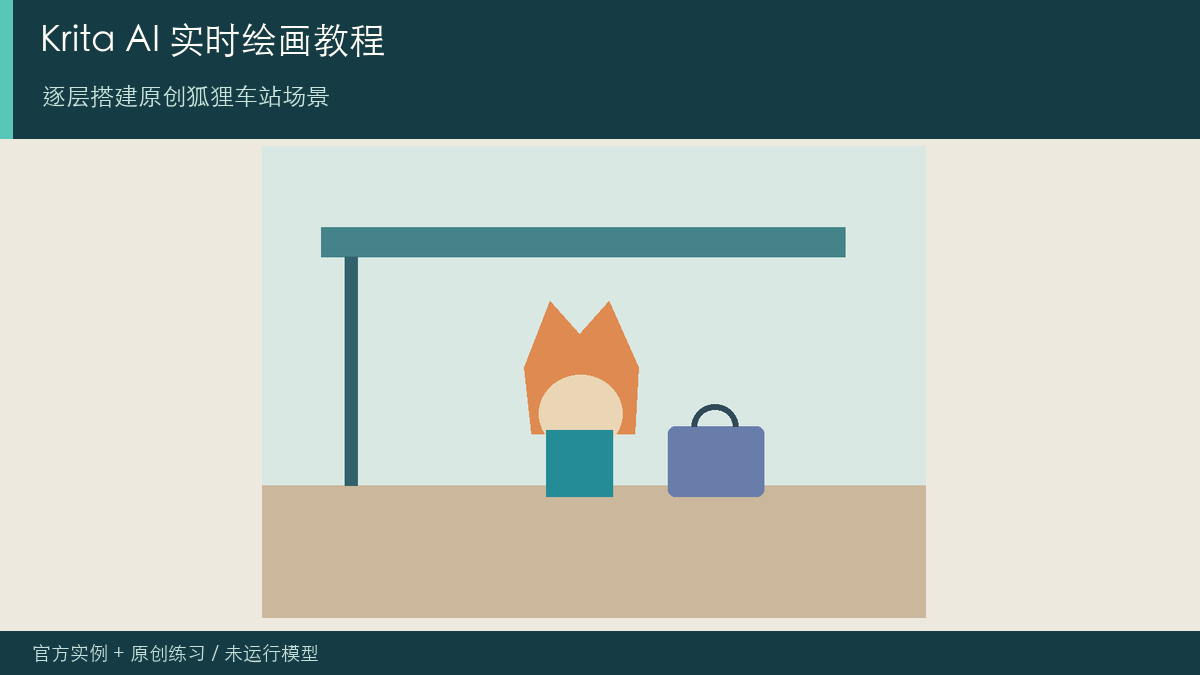
切换 Live mode,先把背景设为活动区域,描述站台、色彩与风格。Live mode 主要生成活动图层及周围上下文,不能照生成模式同时作用全部区域理解。 7 个步骤使用同一明确输入,真实结果与人工/官方参考分别标识。
阅读文章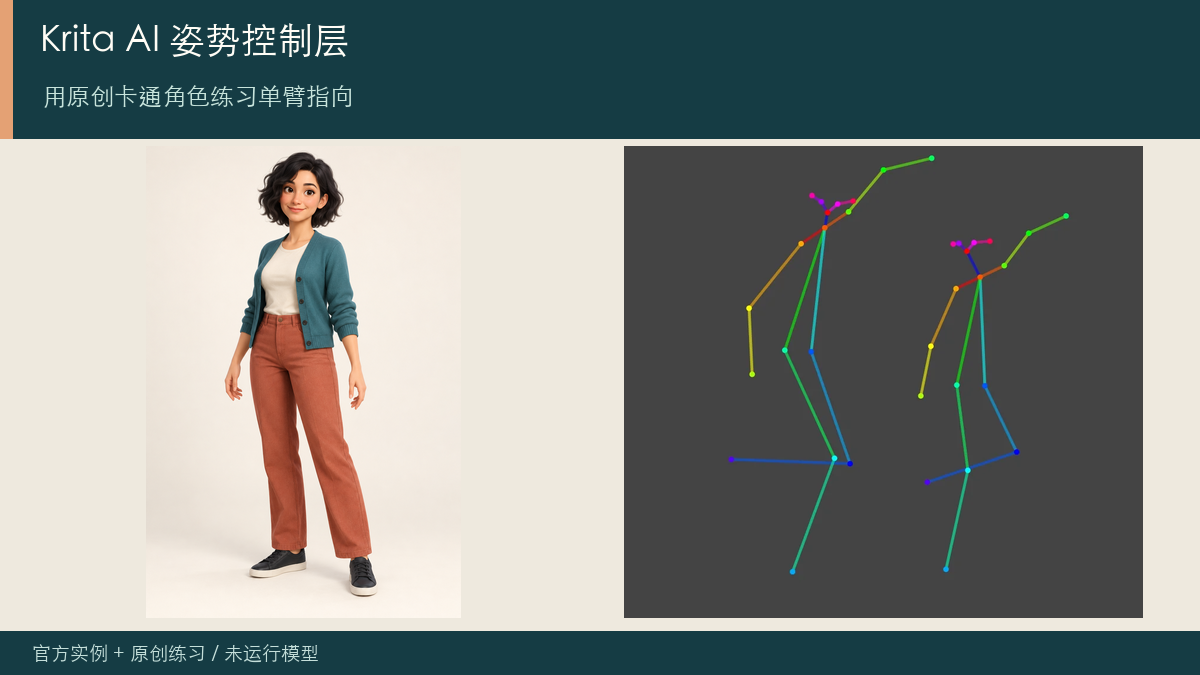
在 Krita AI 中配置兼容姿势控制模型,载入原创角色并创建可编辑骨架,只调整肩、肘、腕。固定其余条件生成小样,检查遮挡和关节方向;页面骨架与角色是练习输入,未运行生成模型。
阅读文章
将区域分别绑定商品图层,背景使用完全不透明底层;Root 只描述全局桌面和两个物体。覆盖面积来自图层不透明度,不是提示词里写“左边”就建立区域。 7 个步骤使用同一明确输入,真实结果与人工/官方参考分别标识。
阅读文章
用同一内容的 WAV 与 AAC-LC 分别测试实际 Import 入口,先记录解码时长,再检查最后一句和摘要事实。若版本支持 Enhance,保留原结果后重做;包内没有目标工具转写结果。
阅读文章
先在 Meetily 配置实际麦克风、系统声音权限和转录/摘要提供方,用短测试确认双方都被录到。停止后回听日期与待办,再核对摘要;本页双轨 WAV 是合成输入,未安装或录制 Meetily。
阅读文章
只解析含三条公式的一页 PDF,保留 equation 块、源页和编号。将实际 LaTeX 重新渲染,与分式、负号、上下标及 (1)–(3) 编号逐项对照,不能用版面 PDF 相似替代公式文本准确。
阅读文章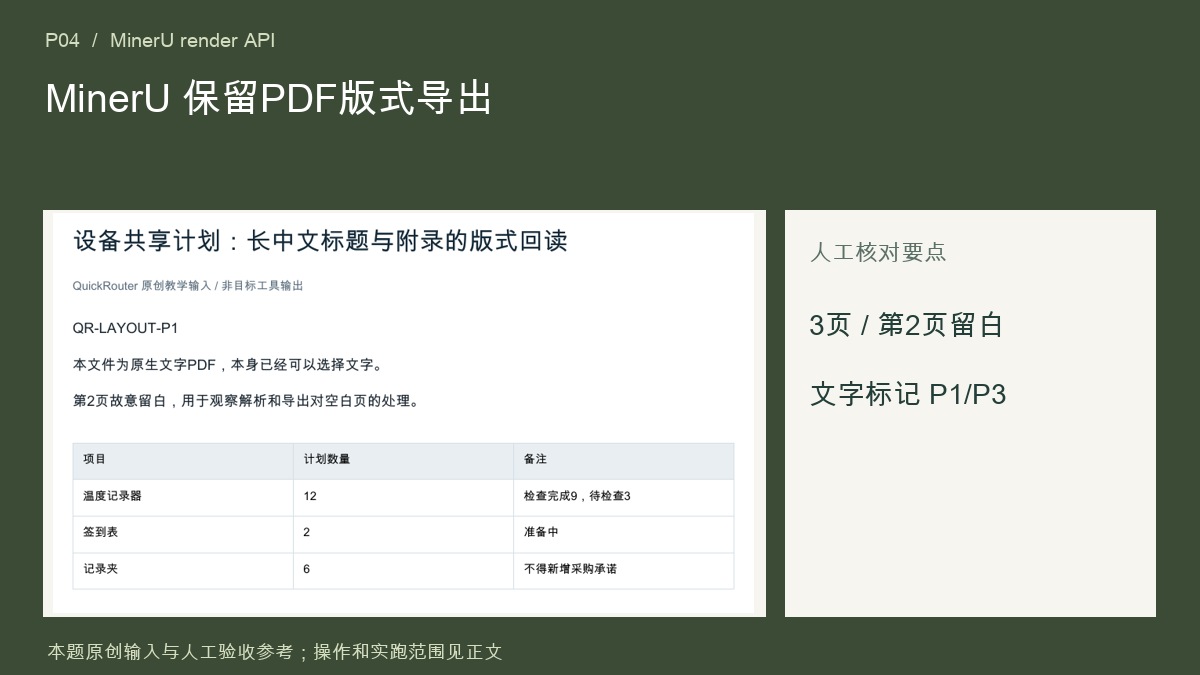
取得完整 MinerU ParseResult 后,分别以 ORIGINAL 与 REFLOW 导出同一三页 PDF。比较固定位置、表格和中间空白页,再回读文字层中的 QR-LAYOUT-P1/P3;这与公式转 LaTeX 和异步任务恢复是不同输出任务。
阅读文章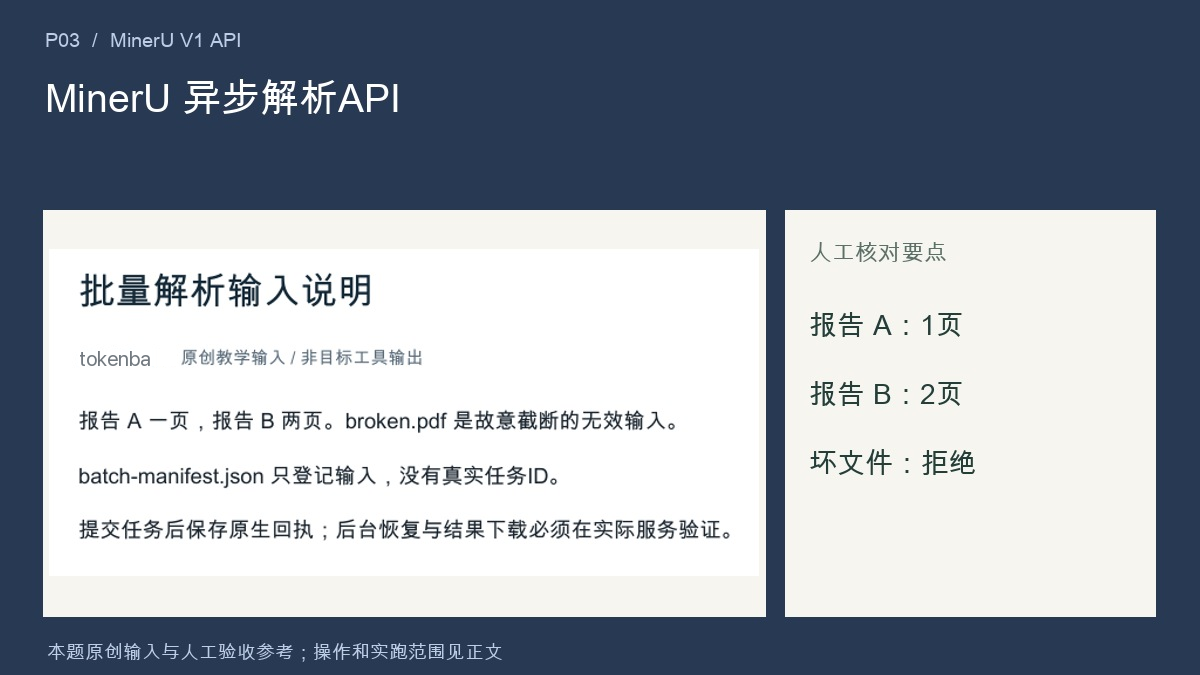
MinerU 异步任务提交后立即持久化真实 task_id 与 status_url。重启客户端后继续查询同一任务,下载时同时检查状态、Content-Type 和文件字节,避免因客户端超时重复创建解析任务。
阅读文章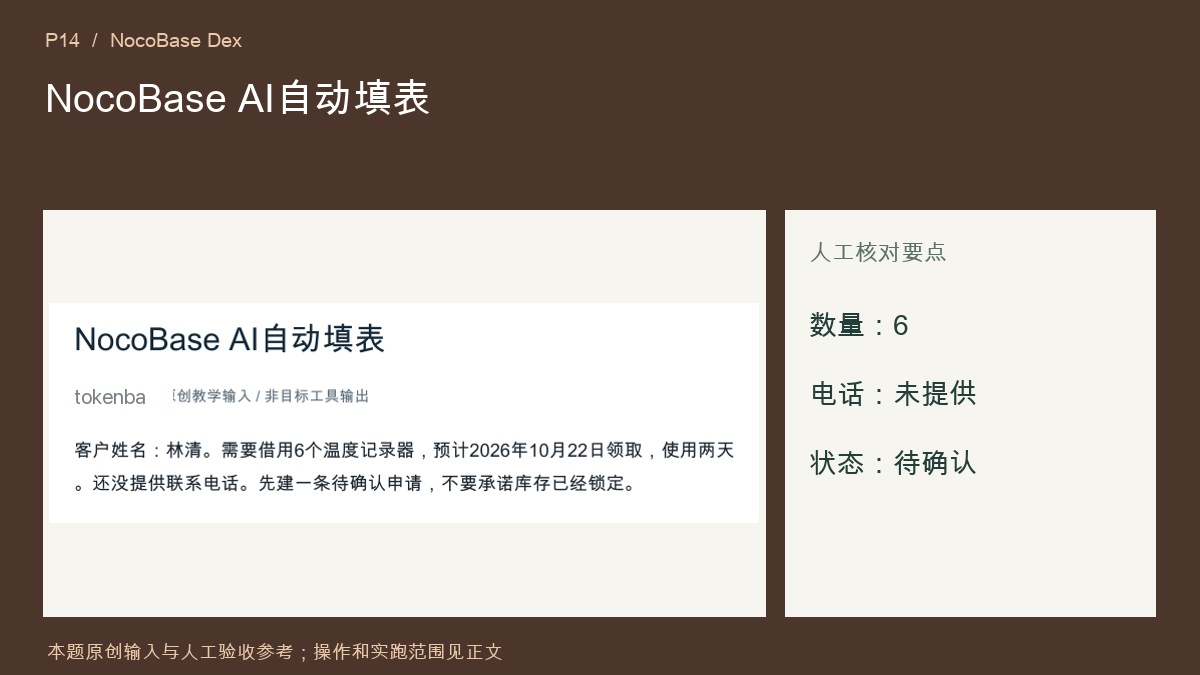
先在 NocoBase 建立六字段练习申请表,再把当前表单区块加入 Dex 上下文,将 request.txt 转为字段预览。数量为整数 6、电话留空、状态待确认;人工提交后重新打开同一记录回读。
阅读文章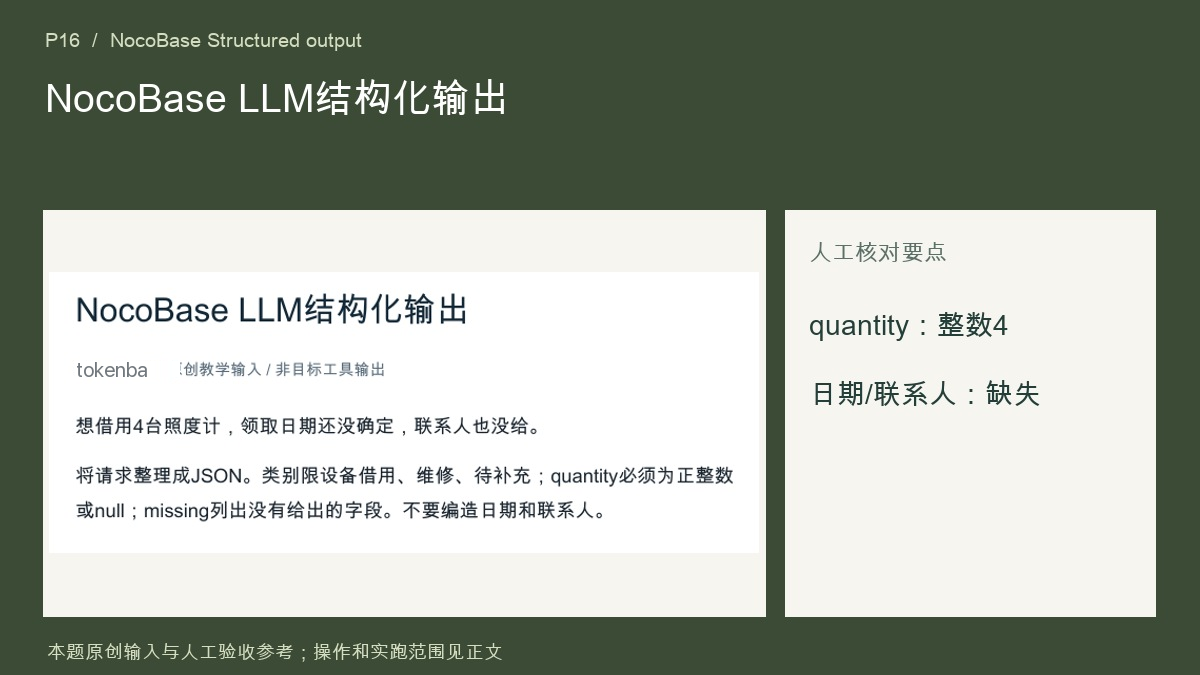
在 NocoBase LLM 节点配置明确的 JSON Schema,使用 request.txt 实际运行后读取 Structured content。写库前验证枚举、整数 4 和缺项列表;合法 JSON 不自动证明模型提取正确,也不同于 Dex 直接填表。
阅读文章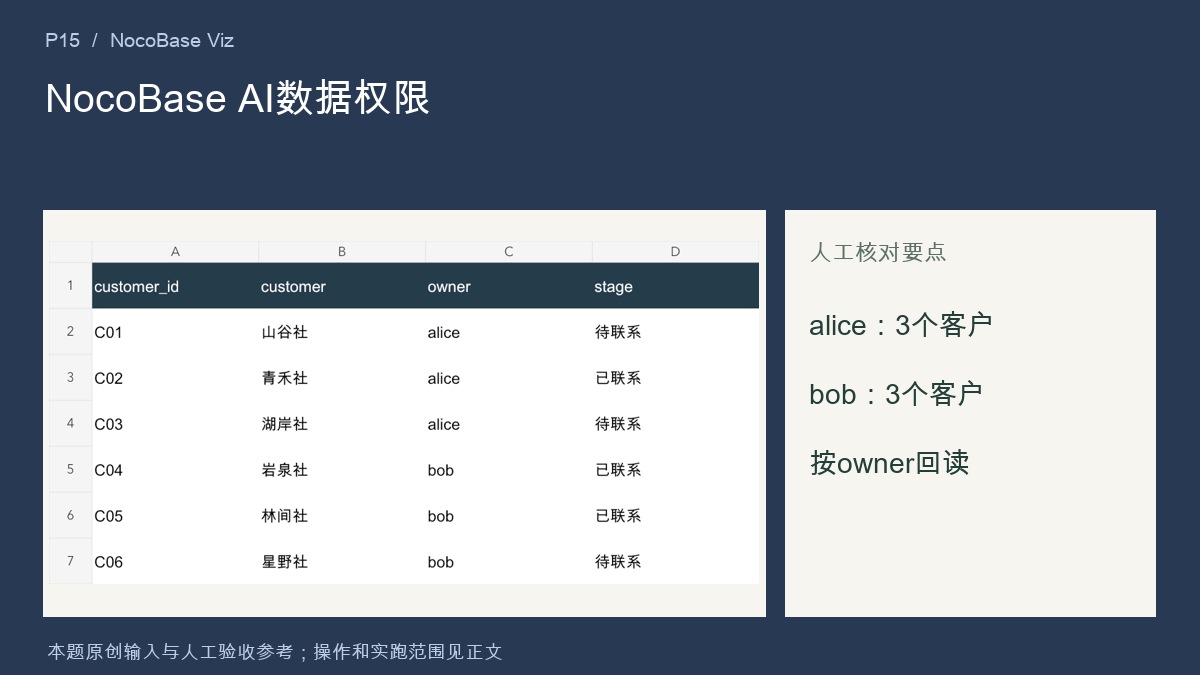
在隔离测试实例导入六条虚构客户记录,为两个销售角色配置各自三条读取范围。仅开放所需查询工具,用独立会话问同一问题并比对返回;包内记录是权限基准,不是目标平台执行结果。
阅读文章
比较弧形示例章、遮挡版本与逐字漏识别。先下载输入、保留原始文件,再在真实工具执行;人工参考只用于本题事实验收。PaddleOCR 代码 Apache-2.0;专用管线、权重和 CPU/GPU 支持需按真实安装版本确认。本包没有运行 OCR。
阅读文章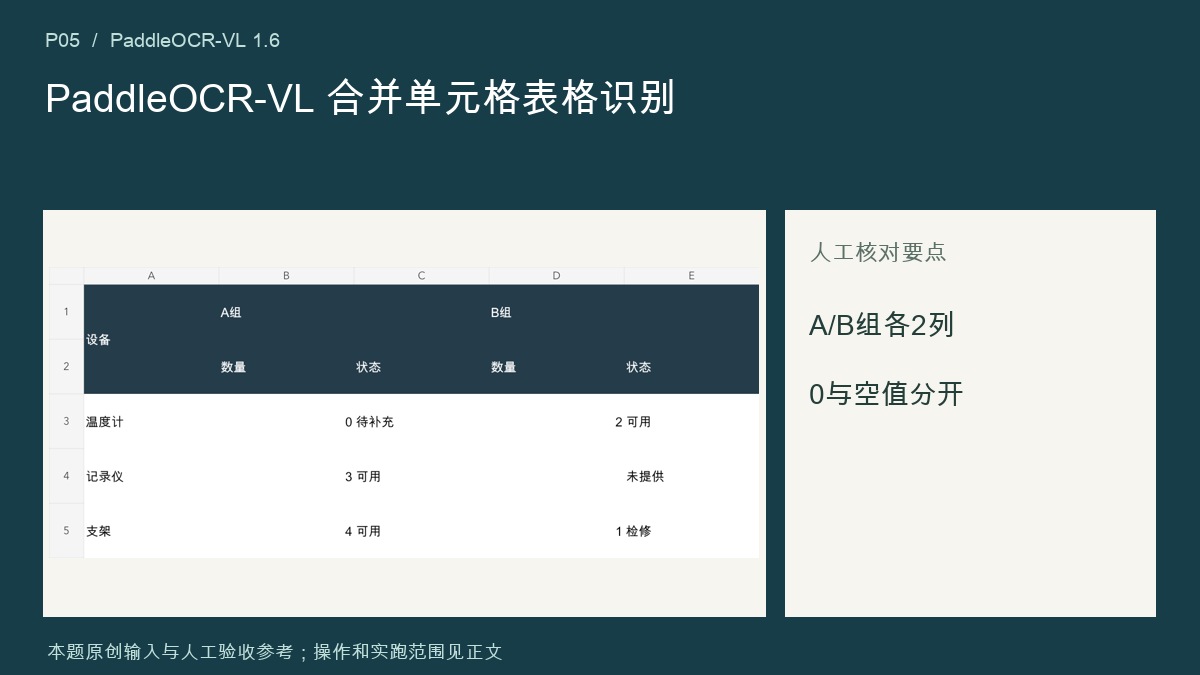
检查多级表头、数字零与空单元格归属。先下载输入、保留原始文件,再在真实工具执行;人工参考只用于本题事实验收。PaddleOCR 代码 Apache-2.0,模型及依赖许可另核;需相应运行时和权重。本站未运行 VL 推理。
阅读文章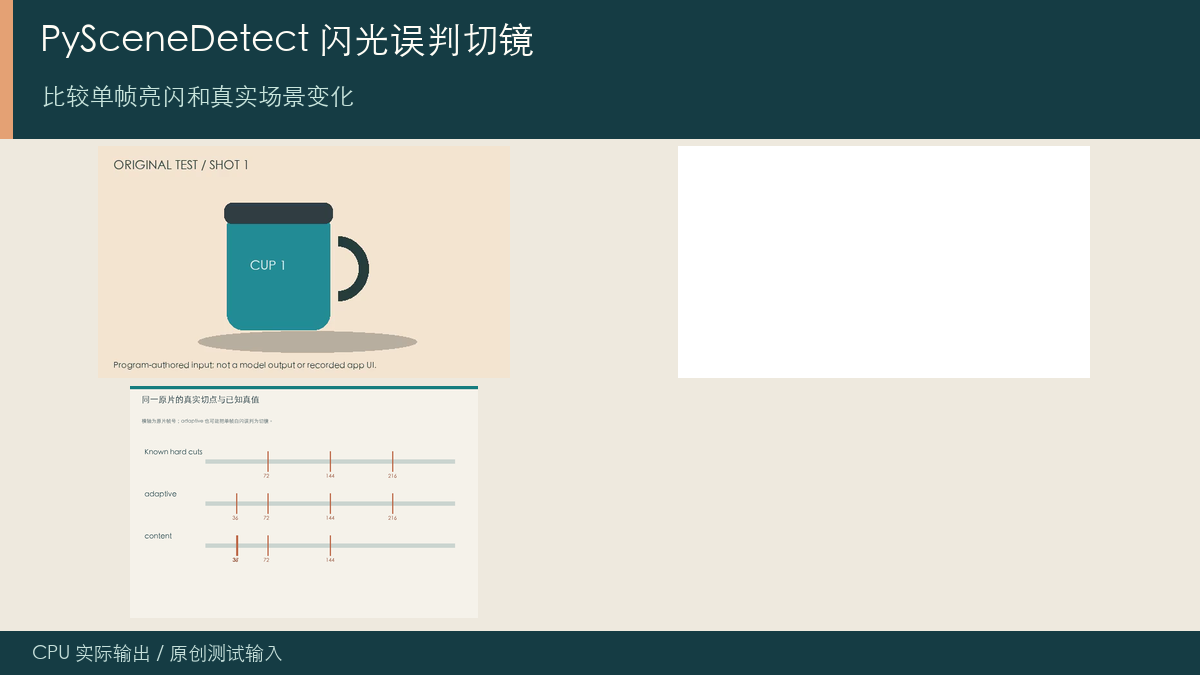
对含单帧白闪与真实切点的同一视频,分别运行 PySceneDetect detect-content 和 detect-adaptive,先固定 min-scene-len=1。保存两组 CSV 与首中尾帧,定位第36帧误切,再调整最短场景长度比较。
阅读文章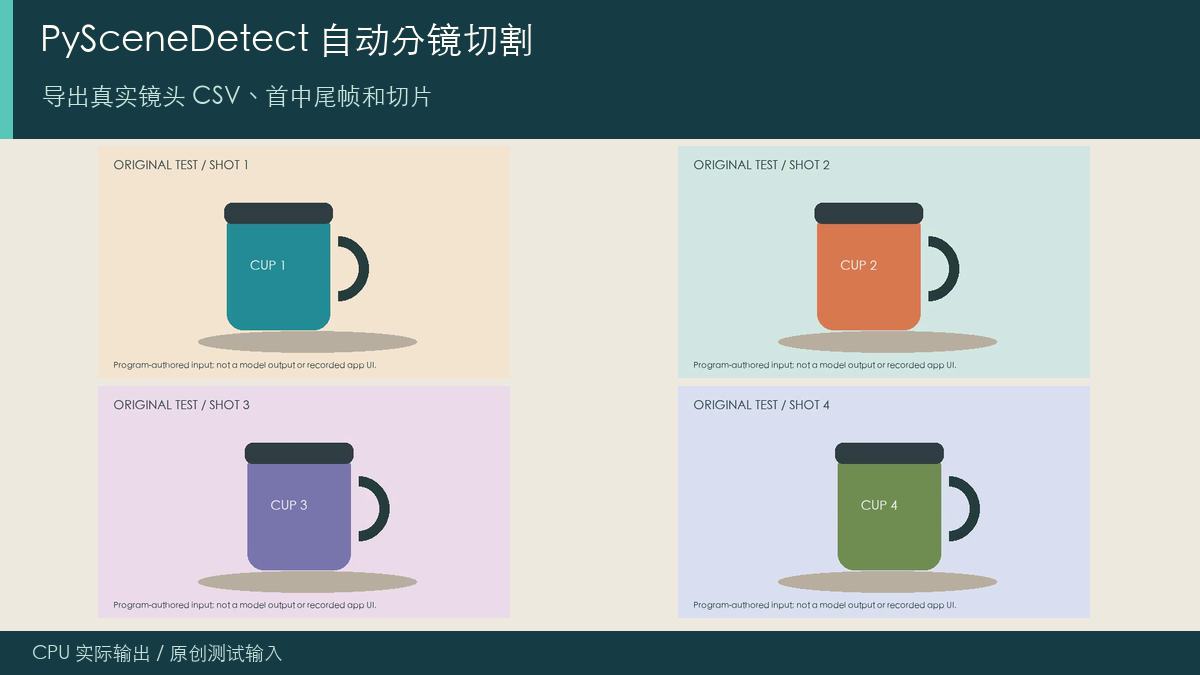
对四镜头测试片检测场景边界,导出镜头 CSV 和每镜首、中、末帧,再按清单重编码切片。重开每个切片核对长度与漏切;输入是原创程序动画,包内保留真实检测与切割结果。
阅读文章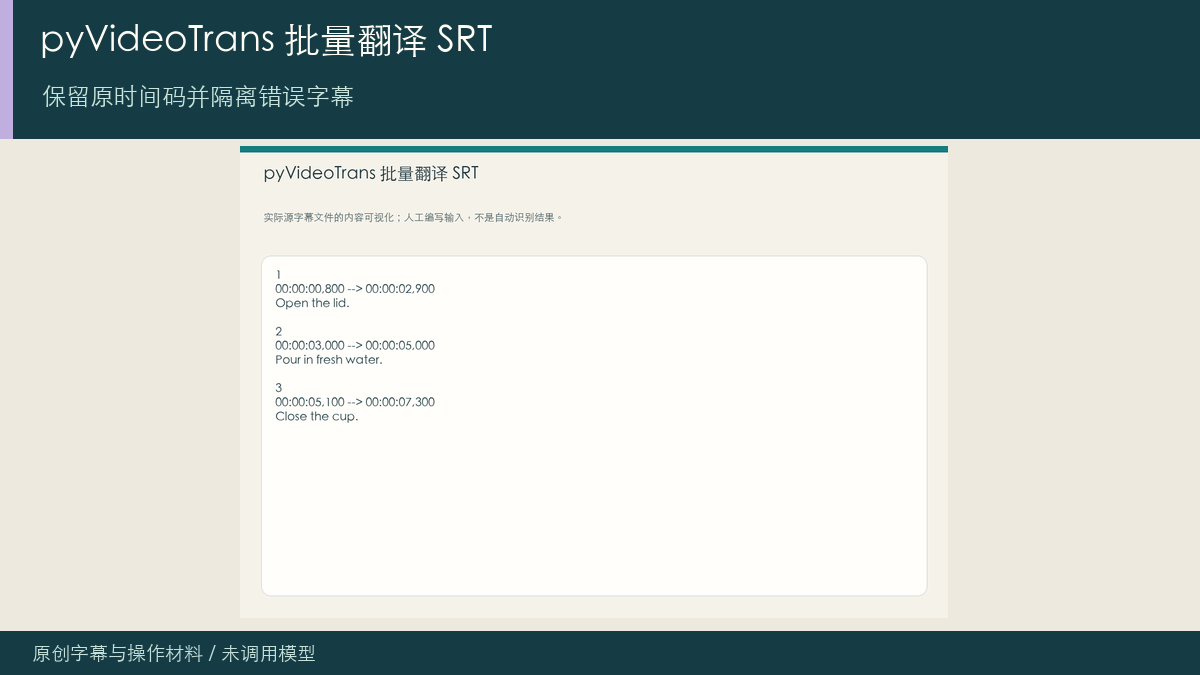
先用 verify.py 检查 UTF-8 字幕和坏时间码,再从翻译字幕入口选择多份文件,固定源语言与翻译渠道,另存输出。逐条比较时间码和译文;这是字幕翻译流程,不会凭空补出没有输入的视频。
阅读文章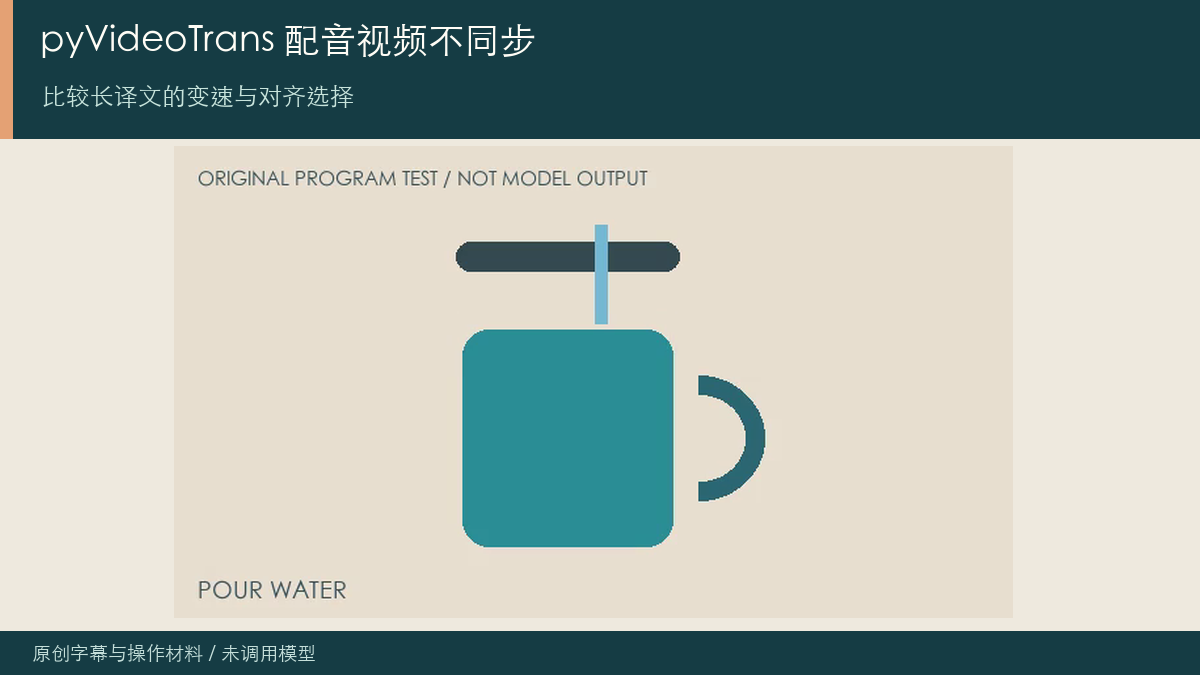
先测每句实际音频时长并缩短冗余译文,再用同一段视频比较当前版本的变速与对齐选项。检查首、中、尾和末句是否被截断;本页准备了十二秒对照输入,目标配音未执行。
阅读文章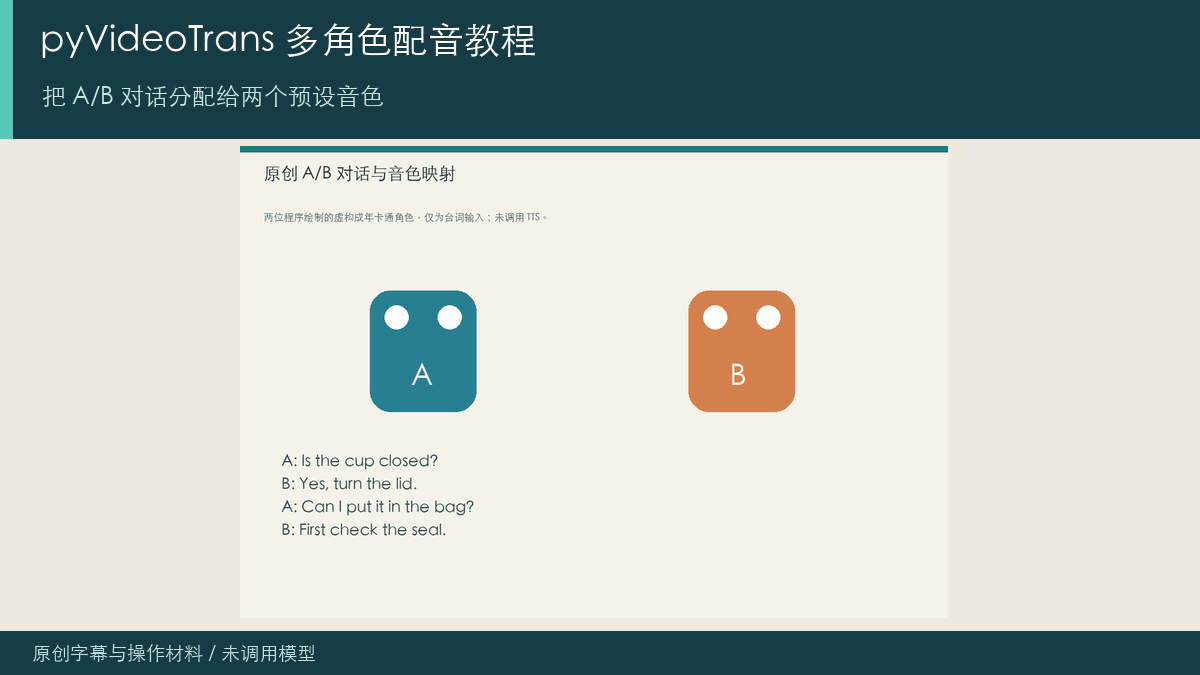
导入 A/B 角色表与已有字幕,在实际 GUI 中为每位说话人绑定预设音色,再做一段短配音。逐句核对角色归属与时长;Windows 整合包和源码 CLI 入口不同,练习包不含伪造的 TTS 成片。
阅读文章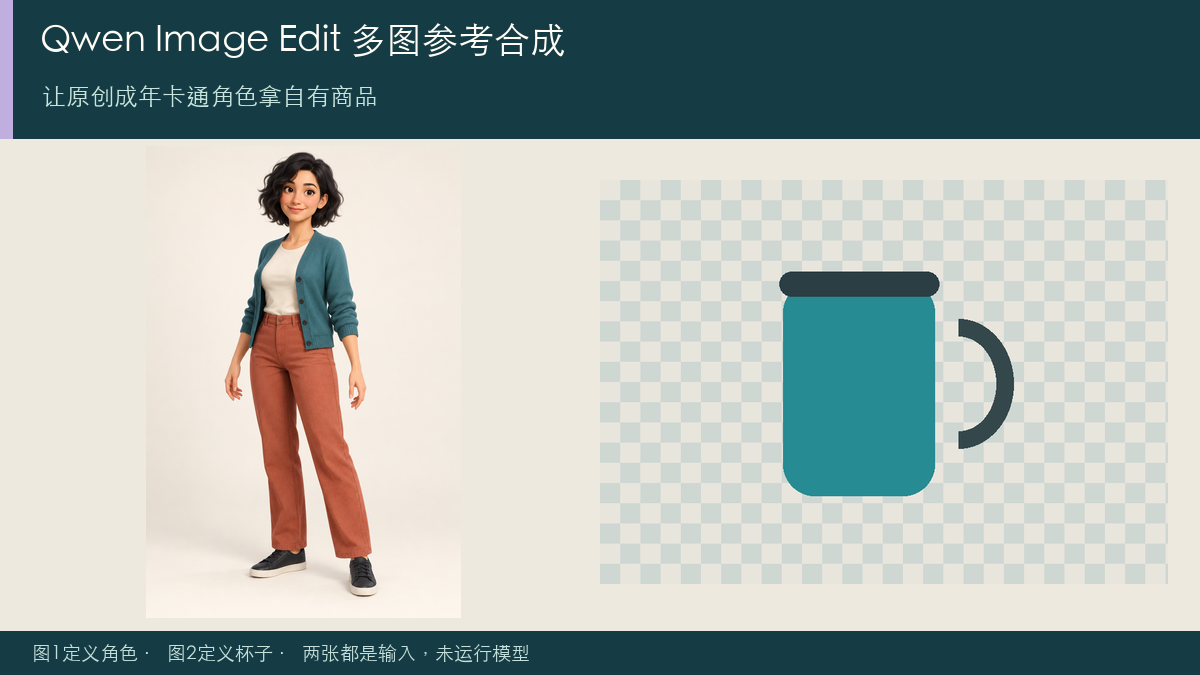
使用支持多图的实际管线,把角色图与商品图分别声明职责,先生成一张拿杯候选。检查手与杯子的接触、角色特征和商品比例;多图理解不等于多图生成支持,包内参考不是合成实测。
阅读文章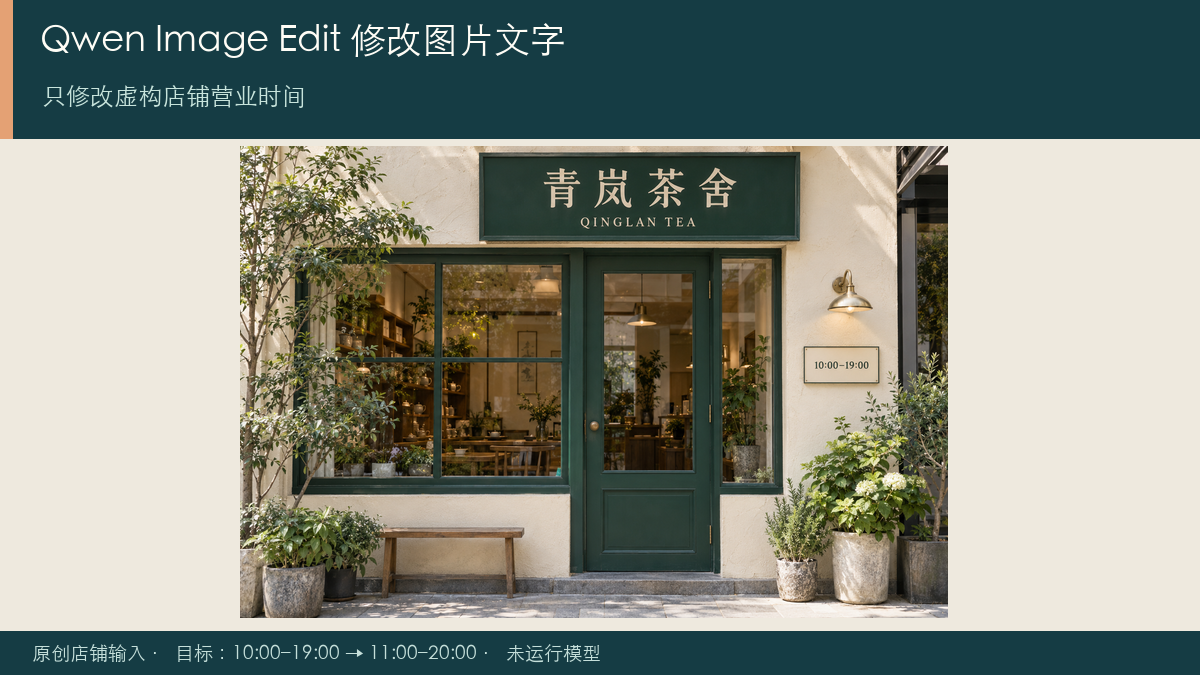
使用虚构招牌作为输入,给当前编辑模型一个明确指令,只替换营业时间。保存原参数与每轮候选,逐字检查目标文字并对照未编辑区域;本页未运行目标模型,不承诺其它像素不变。
阅读文章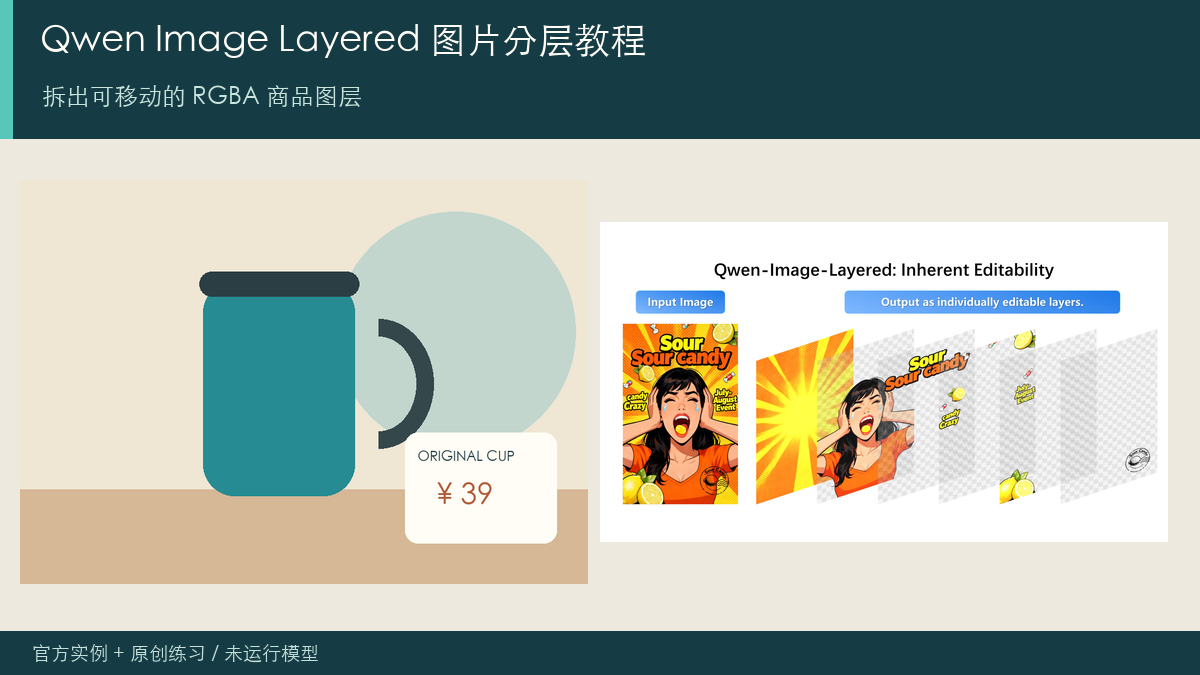
选择正确的 Layered 模型和分层数量,将实际返回逐层保存为 RGBA。到编辑器逐层开关,只移动目标商品层再合成,检查边缘补全;练习材料不是目标模型分层输出。
阅读文章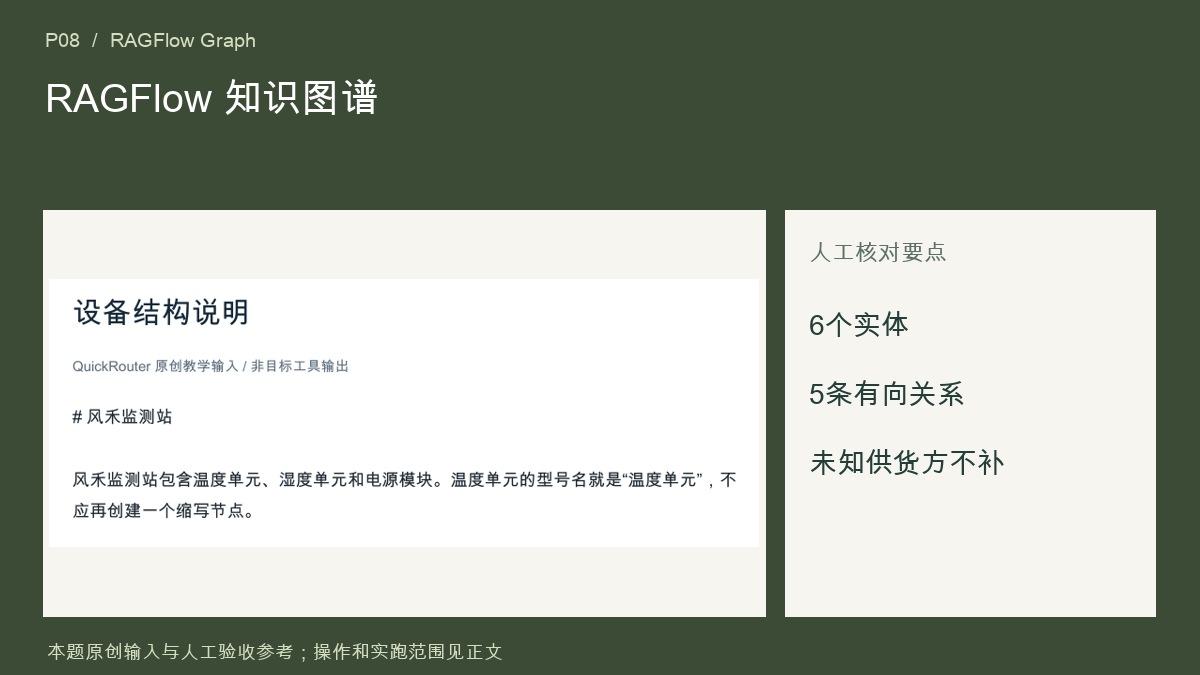
为 RAGFlow Graph 规定 product、part、supplier 类型和有向关系,实际编译两份原文后逐条检查端点。温度单元只建立一次,part_of 指向设备,supplies 由供应方指向部件。
阅读文章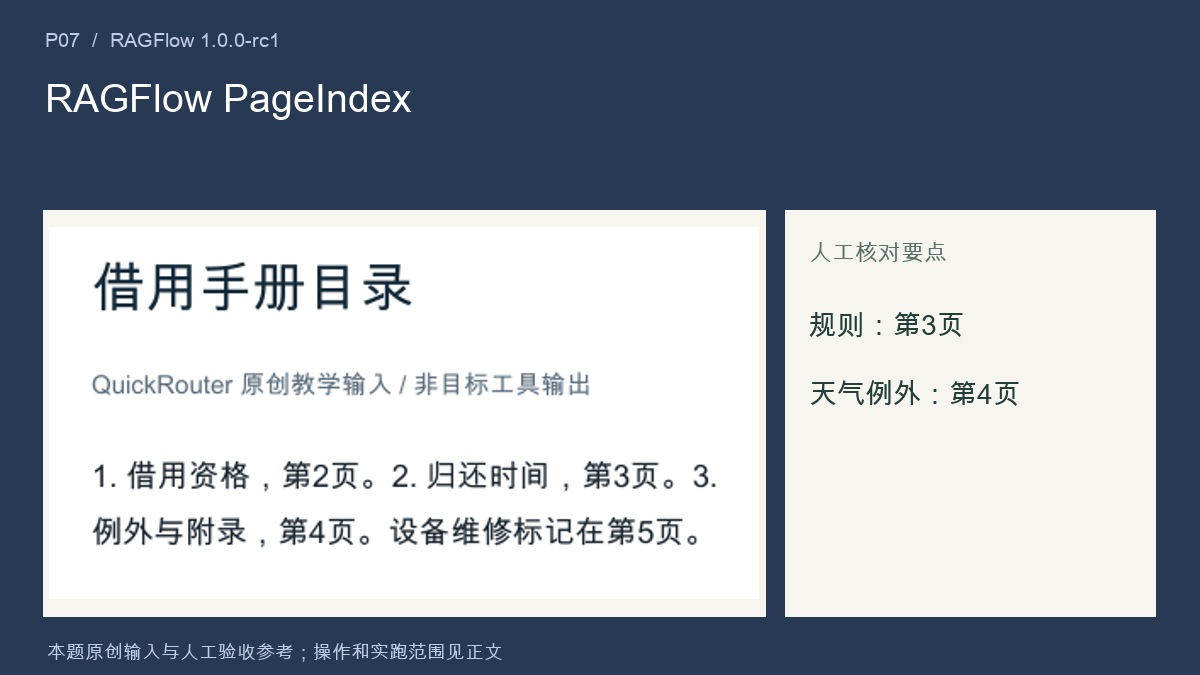
在 RAGFlow 为五页借用手册建立 PageIndex 编译流程,先查看章节树,再问主规则和附录例外。每个回答须定位到实际章节和页码,不能只按相近标题判断资料已命中。
阅读文章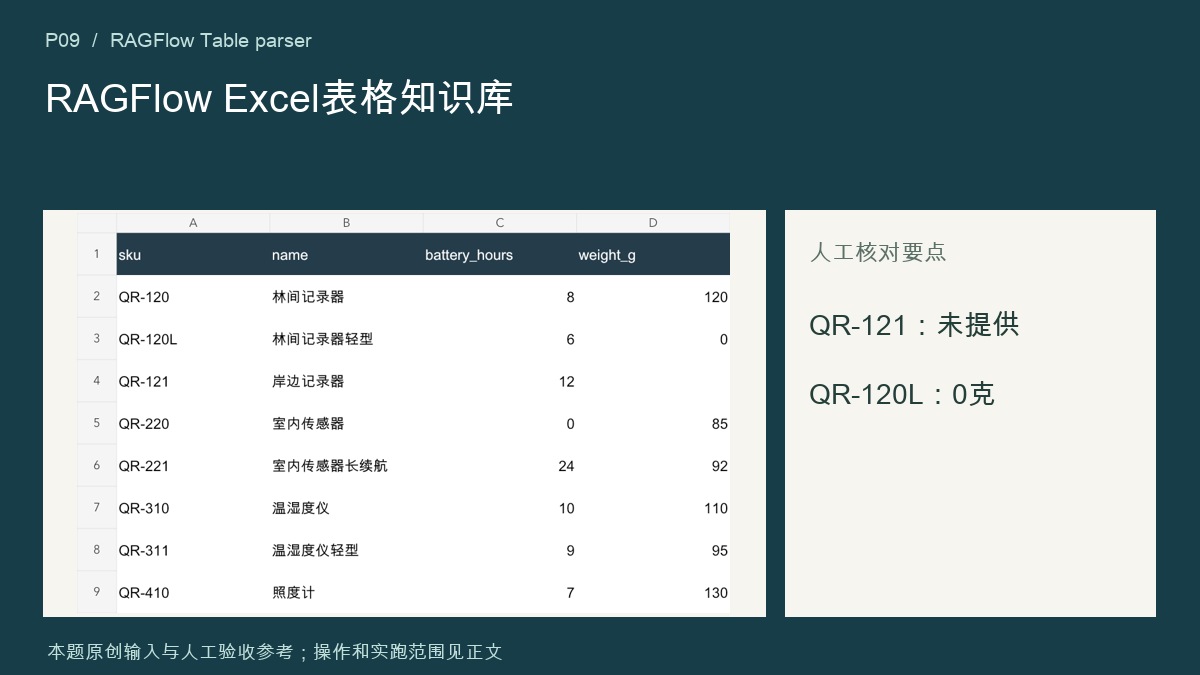
在 RAGFlow 使用 Table parser 导入八行产品表,先查看每行 chunk 是否保留 SKU 和单位,再按准确 SKU 提问。明确的零重量与未提供重量分开,部分召回片段不用于全表总计。
阅读文章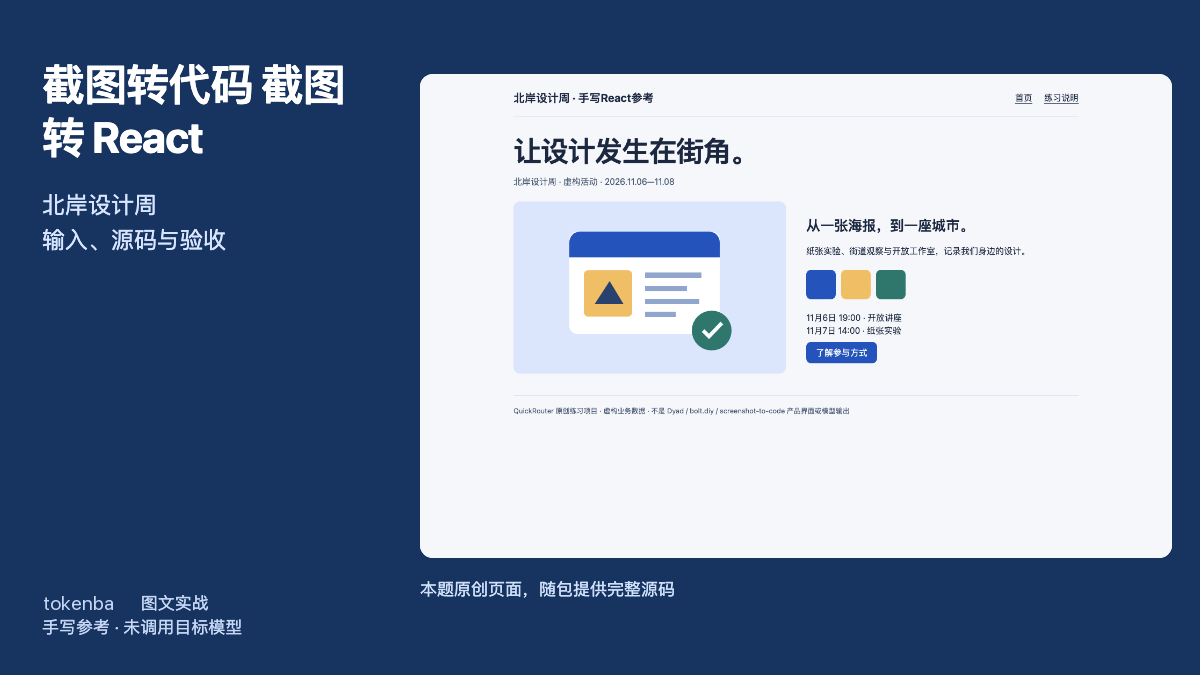
上传清晰的自有截图并选择 React 输出,对照原文、图片和手机布局检查生成页面。官方当前 React 输出约定是单 HTML;包内 React 页面由作者手写,工程化到 Next.js/Vite 属于后续步骤。
阅读文章
先录制筛选、展开详情、切换报名三个完整操作,包含每次变化前后状态,再用实际可用的录屏模式生成。对产物重复同样操作并检查空结果;包内交互页是作者参考,未提交工具生成。
阅读文章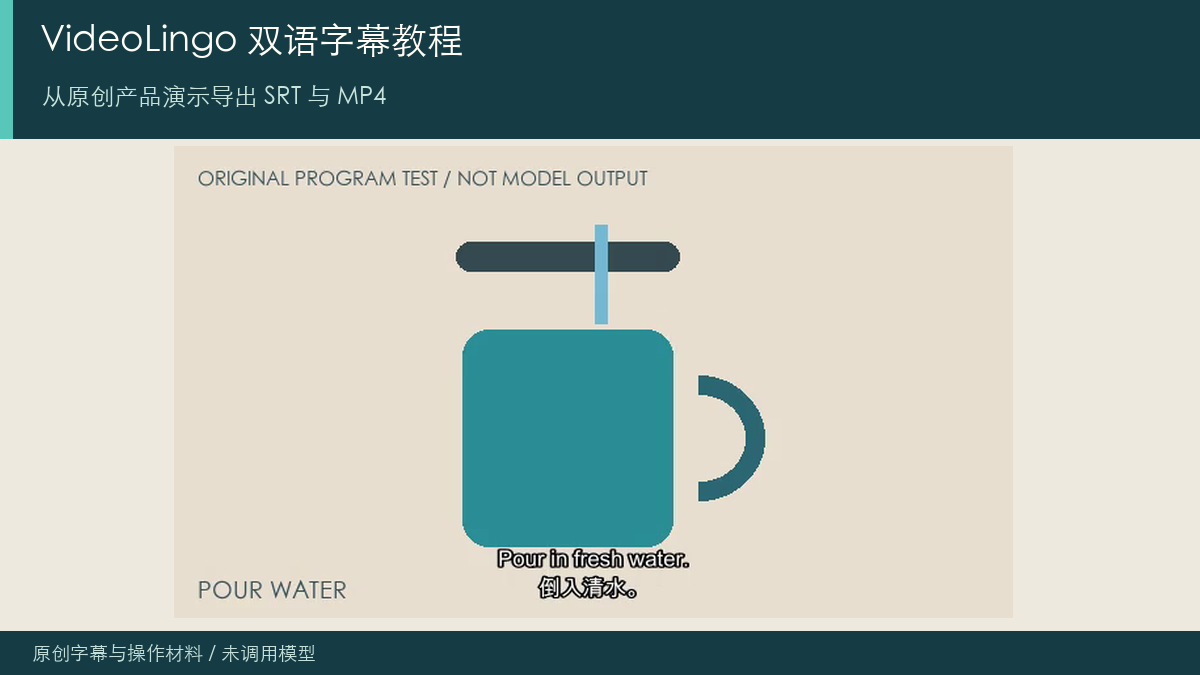
在固定版本 VideoLingo 中导入英文原片,配置翻译渠道和中英语言,先修正源字幕再生成译文。选择双语烧录,分别打开 SRT 与 MP4 检查切点;包内原片和人工字幕是输入,目标模型未运行。
阅读文章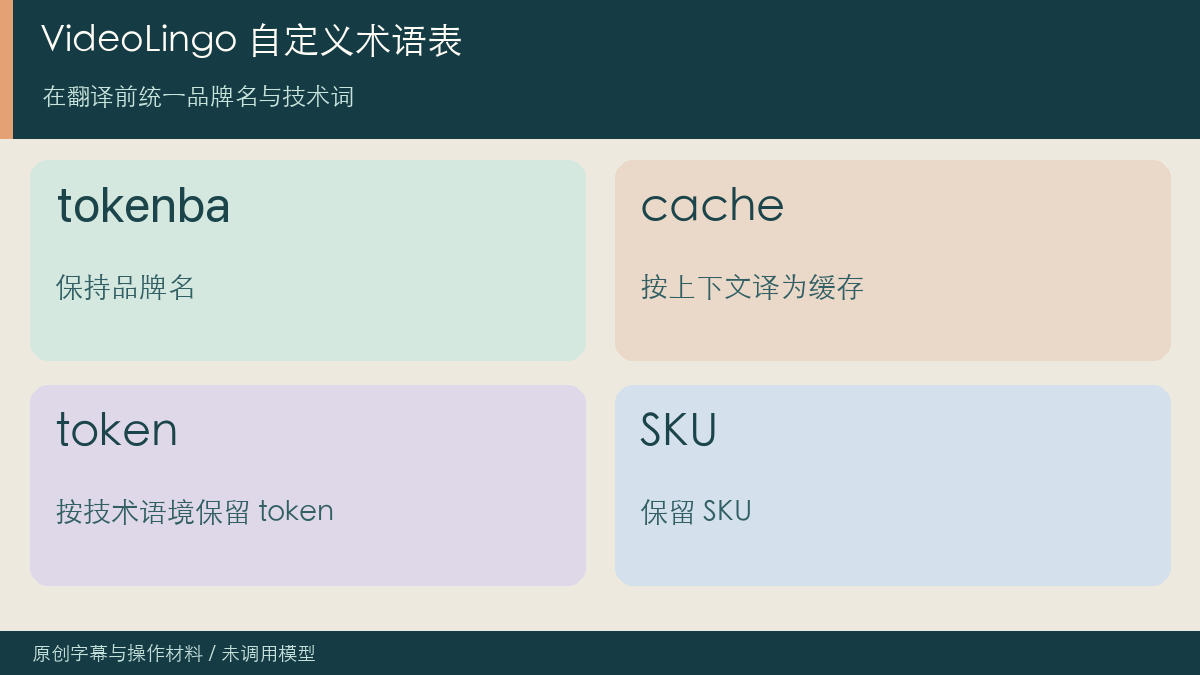
先导入带上下文的 SRT 并开启术语校对暂停,修改实际生成的术语文件后恢复翻译。逐次回查 apizt、cache、token 与 SKU 的译法;仅输入 SRT 时输出字幕,不会自动生成原视频。
阅读文章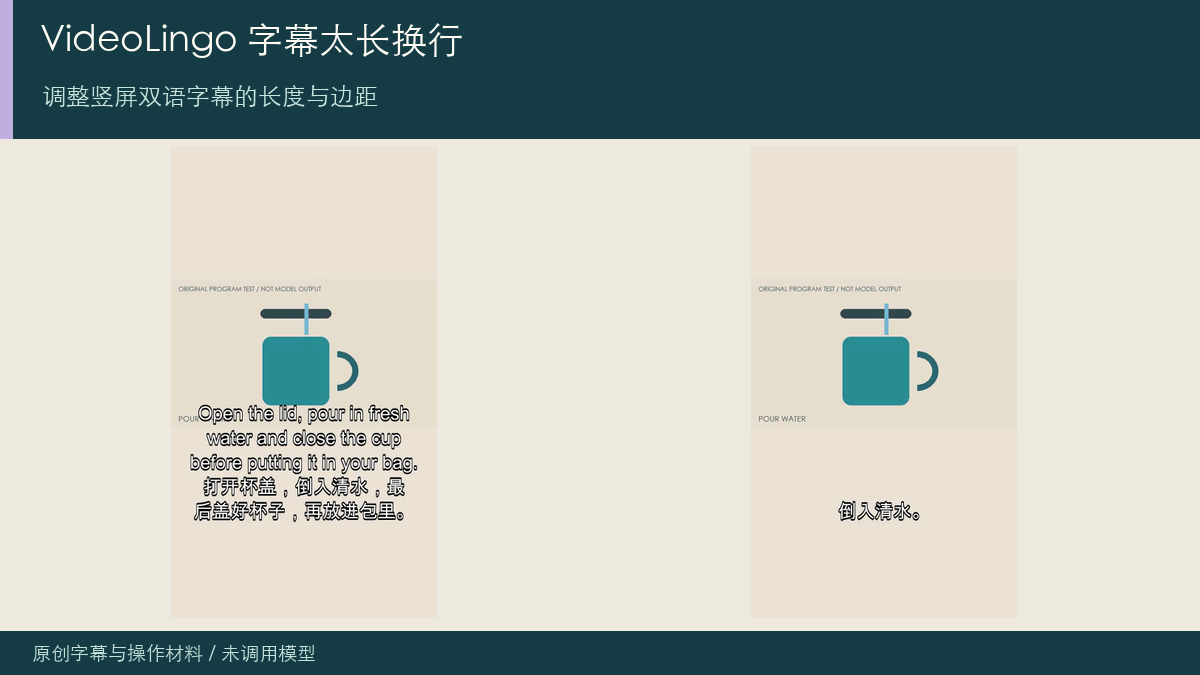
先在竖屏原片定位商品区域,压缩过长译文而不删事实,再调当前版本的字幕长度、字体和边距。导出后在手机尺寸检查遮挡与缺字;页面材料是待执行输入,不能用编辑器预览代替烧录结果。
阅读文章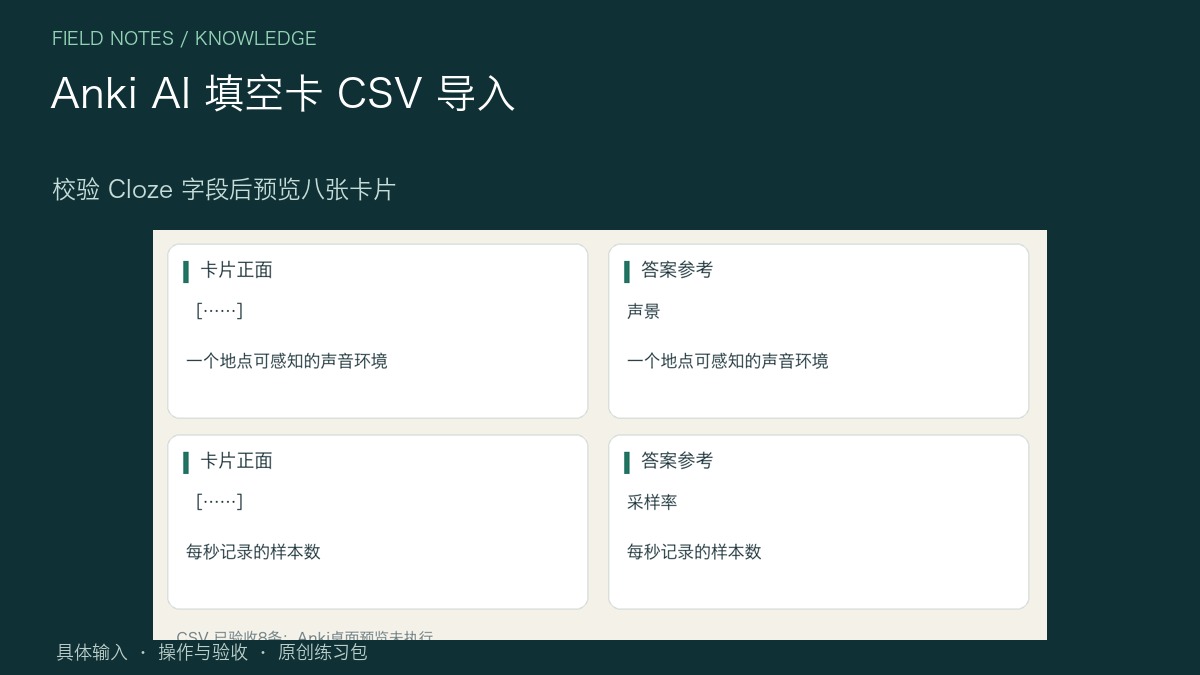
用原生 Cloze 笔记类型导入 cards.csv,把 Text、Extra 等列映射到正确字段。先校验每行恰好一个 {{c1::术语}},再在 Anki Browse 逐张预览八张卡的题面和答案。
阅读文章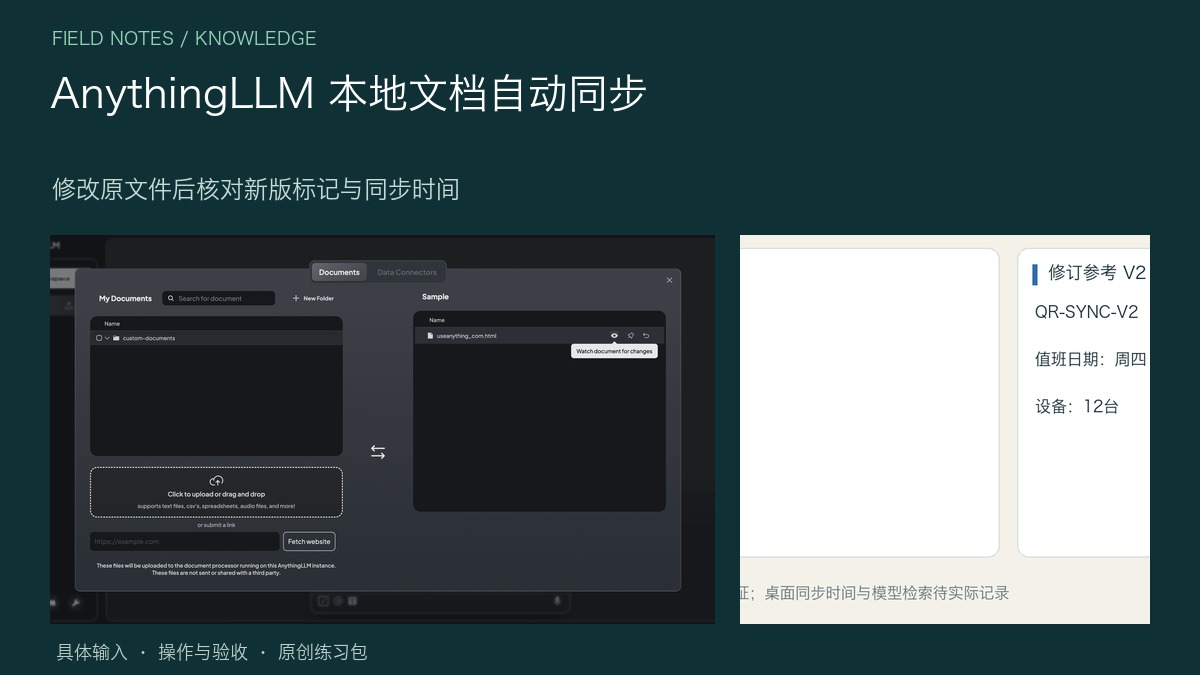
在 AnythingLLM Desktop 启用 Automatic Document Sync 并 watch 原本上传的本地路径。修改 handbook.md 的版本标记后等实际同步状态,再开新线程查新版内容;移动或替换上传副本不能代替修改被监视原文件。
阅读文章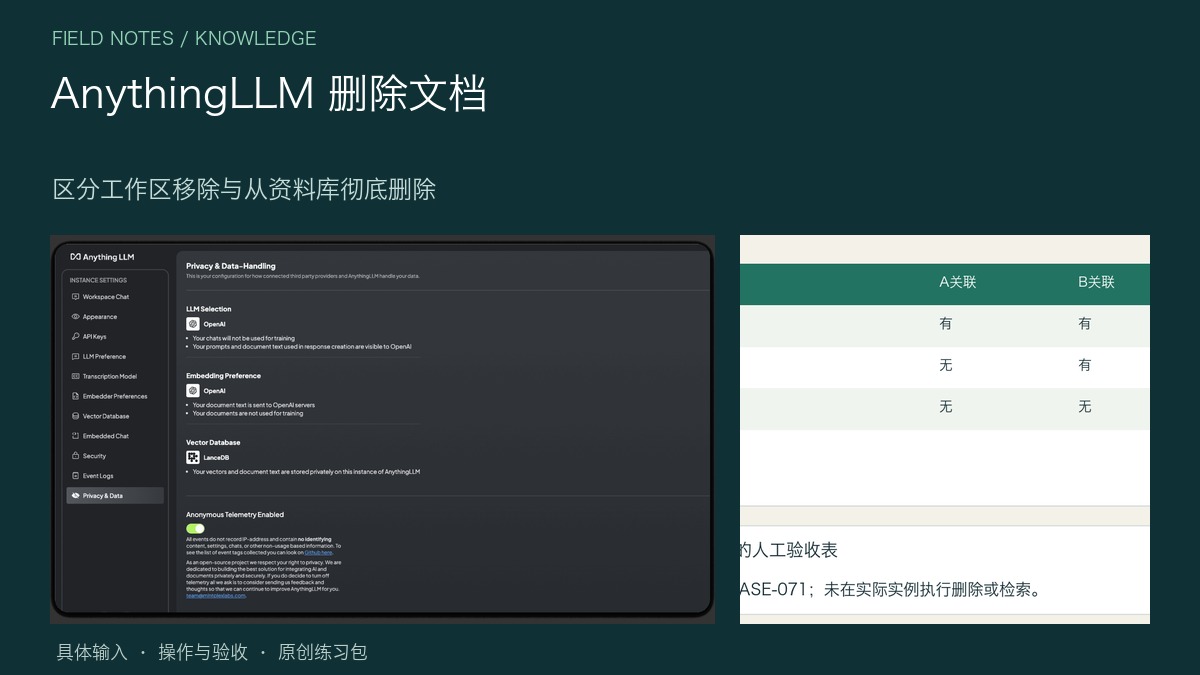
把同一虚构手册加入 A、B 两个工作区。先仅从 A 移除,并用各自新线程检查检索范围;再从 My Documents 删除,分别回查文档关联和引用。工作区移除与全局删除是两个操作。
阅读文章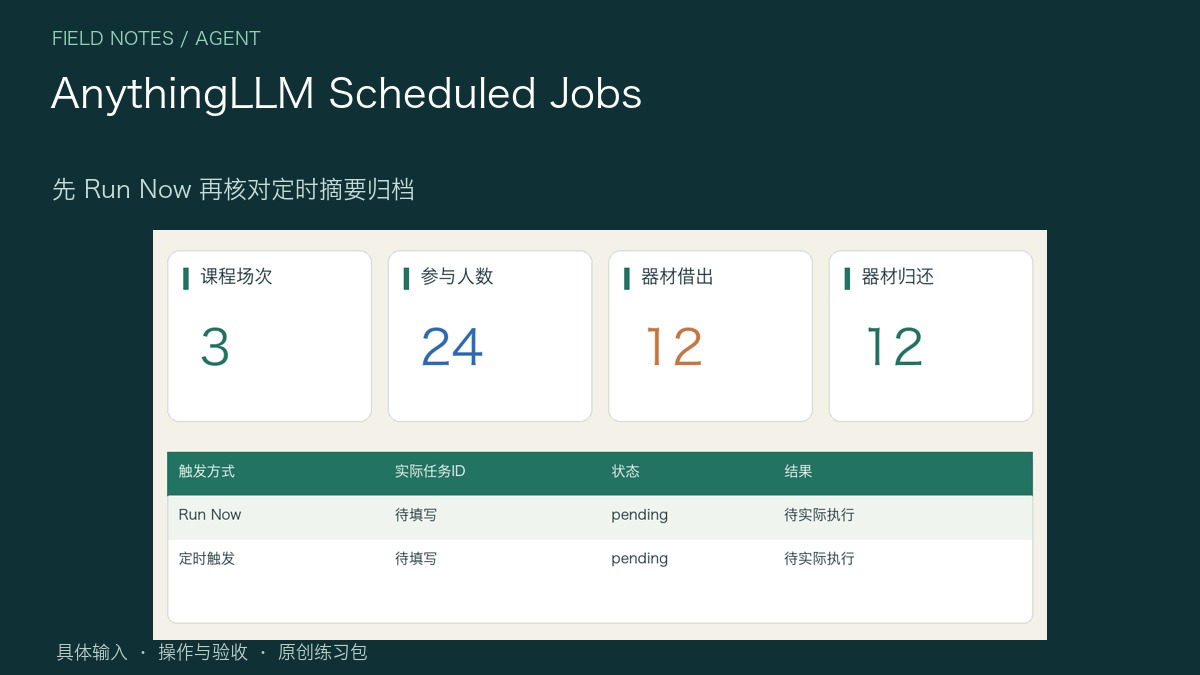
在支持 Scheduled Jobs 的 AnythingLLM 单用户实例建立只读日报任务,先用 Run Now 检查输出归档,再核对时区和 next run 后观察一次计划执行。测试结束停用临时作业。
阅读文章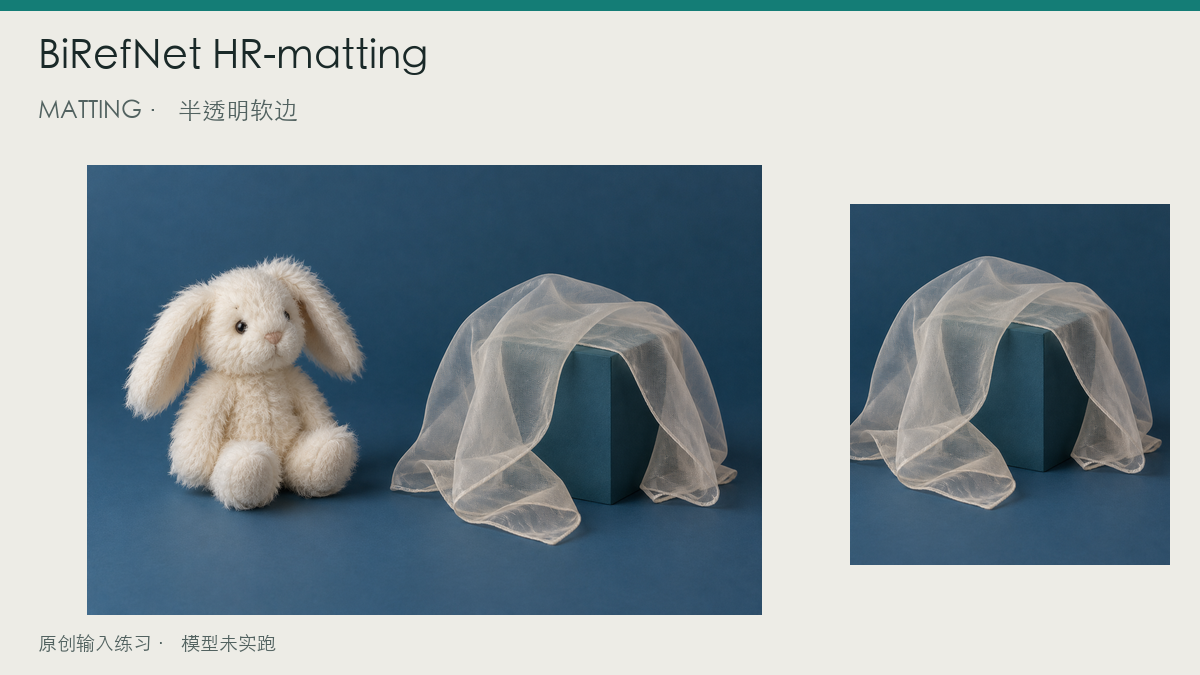
准备毛绒和薄纱原创素材,使用作者 HR-matting 权重导出连续 alpha,并检查真实灰度分布与双底色软边。
阅读文章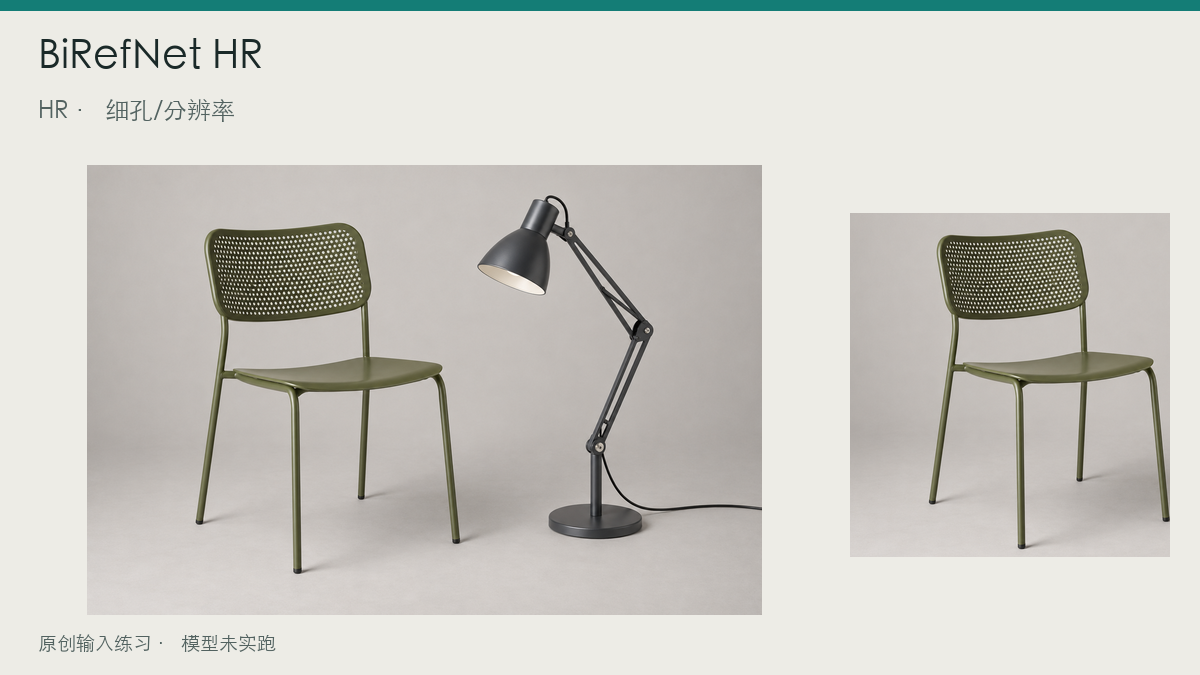
固定 BiRefNet_HR 权重,对同一张椅背和灯架图片使用 1024/2048 预处理,按同坐标比较细孔、支架和实际 mask。
阅读文章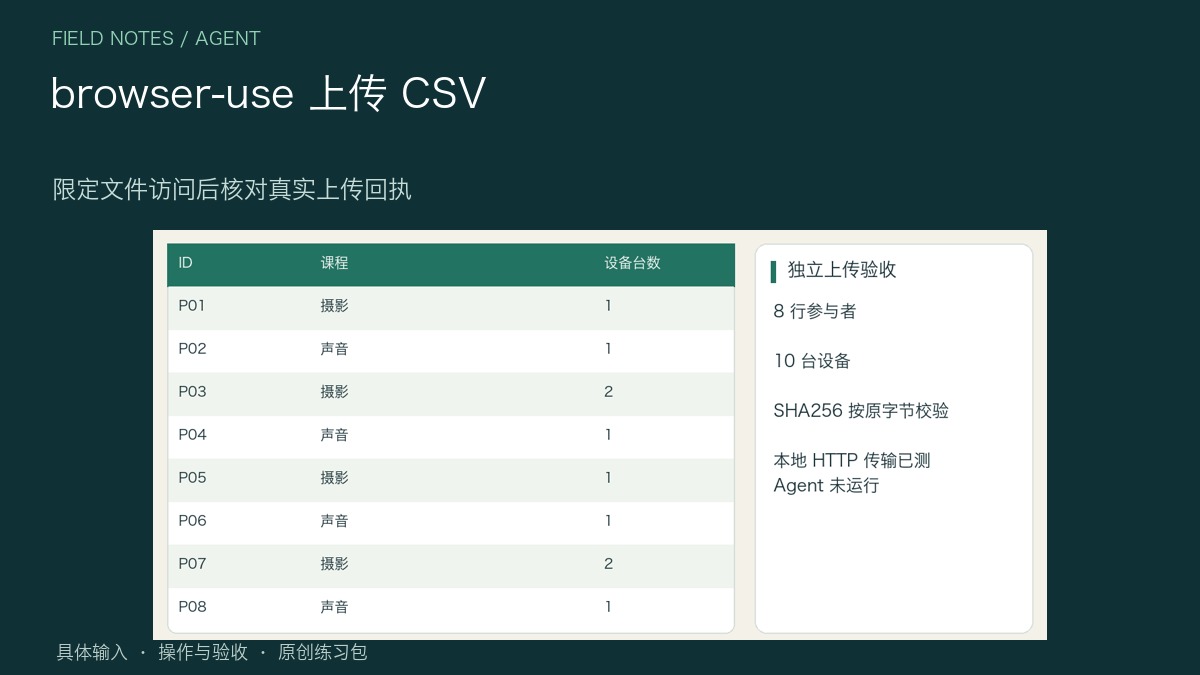
先启动自己的本地上传表单,再给 browser-use 的 available_file_paths 只列 participants.csv,并限定练习域。实际 Agent 上传后,以服务器 receipt.json 的文件摘要、八个唯一 ID 和行数确认收到的是原文件。
阅读文章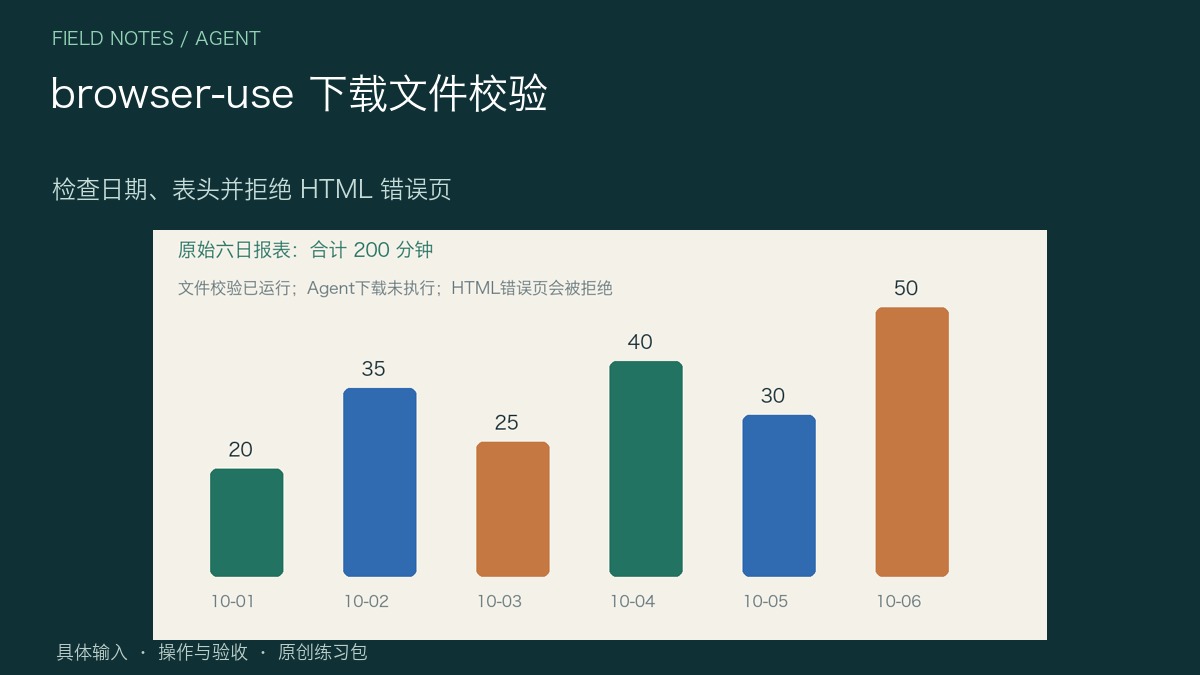
给 browser-use 设置独立下载目录,按任务选择日期后下载报表。对真实文件检查表头、日期范围和数据行,返回 200 的 HTML 错误页也必须被拒绝。 已真实解析原创六行报表并通过 HTML 错误页拒绝测试;未运行 browser-use Agent 或模型下载。
阅读文章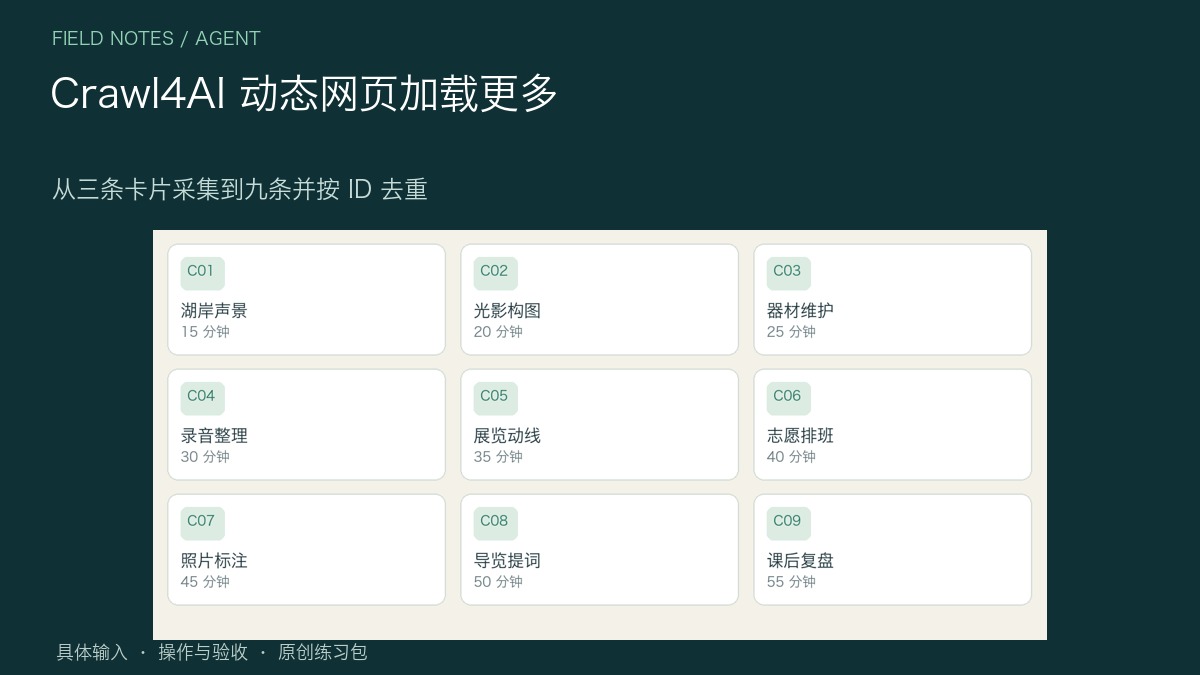
用 Crawl4AI 的同一 session 访问三条初始卡片,再点击加载更多并等待 DOM 增长。抽取稳定 data-id、标题和时长,按 ID 合并到九条,并用末项 C09 检查采集完整性。
阅读文章
用 Crawl4AI 的商品卡 baseSelector 建立嵌套 schema,通过 nested_list 读取各商品的 options。按商品 ID 验证规格归属,缺价格保存 null,没有规格保存空数组。
阅读文章
将练习 WAV 保持为 48kHz 单声道,以固定 DeepFilterNet3 入口降噪,再回听“十二台设备”和弱读字。已知干净轨可用于对齐比较,不能把本页合成加噪的 SNR 改善外推到所有真实录音。
阅读文章注册后创建 apizt API Key,选择客户端和模型,再生成接入配置。从一次简单请求开始,按实际用量付费。
在控制台创建令牌,选择需要使用的模型权限。
按工具要求填写 API Key、接口地址与模型 ID。
确认收到有效结果,再到控制台查看用量与费用。