
展开本页目录
开始前准备什么
- 将练习包解压到独立目录,不覆盖已有项目或真实业务资料。
- 先运行本包校验并查看实测范围,再按官方文档使用自己的软件、账号与准确版本。
- 需要真实模型的步骤只使用自己的 Key,截图与下载包不包含凭据。
- 阅读四张商品卡
- 定义商品容器
- 用 nested_list 提取规格
- 以无 LLM 路线实际抓取
- 规范缺失值与空数组
- 按 ID 检查规格归属
- 给下游模型保留原字段
原创输入、运行脚本、字段校验、负例和执行范围;不含可用密钥。
已真实运行 Crawl4AI 0.9.5 与本机 Chrome 对原创网页进行无 LLM 抽取,结果和缺项/不完整负例通过;没有模型调用。
对应正文的具体资料,保持输入可追溯。
验证字段与负例;不能代替未执行的软件或模型。
明确区分材料验证、框架执行和模型调用。
1. 阅读四张商品卡
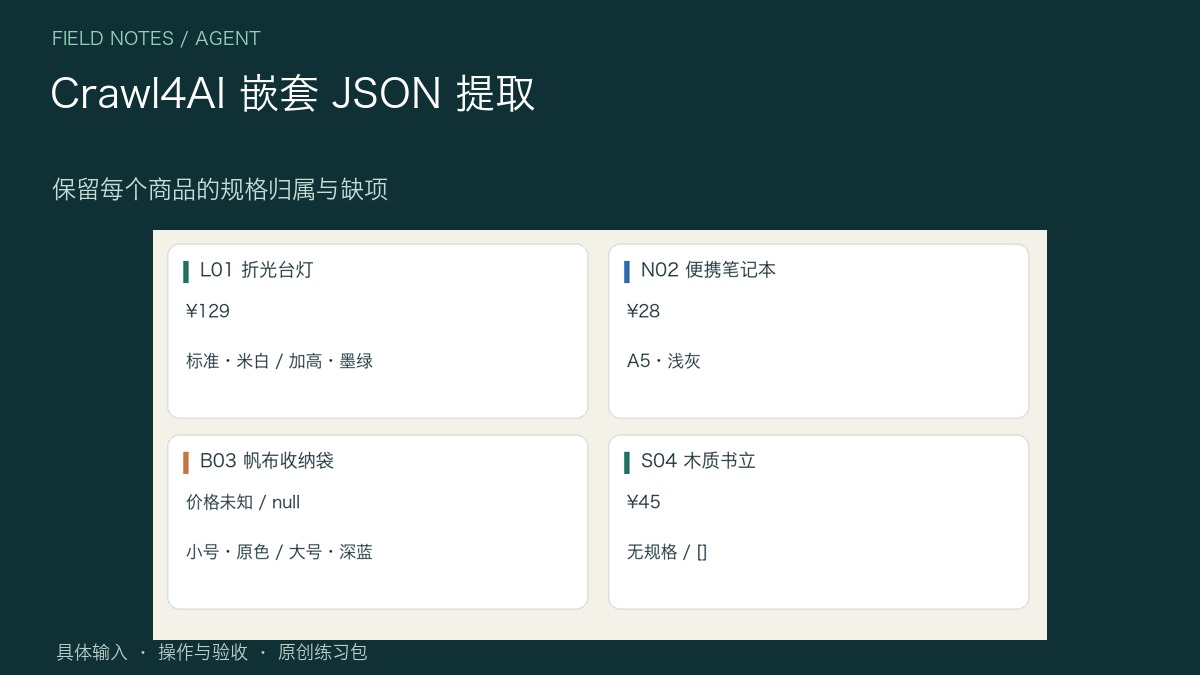
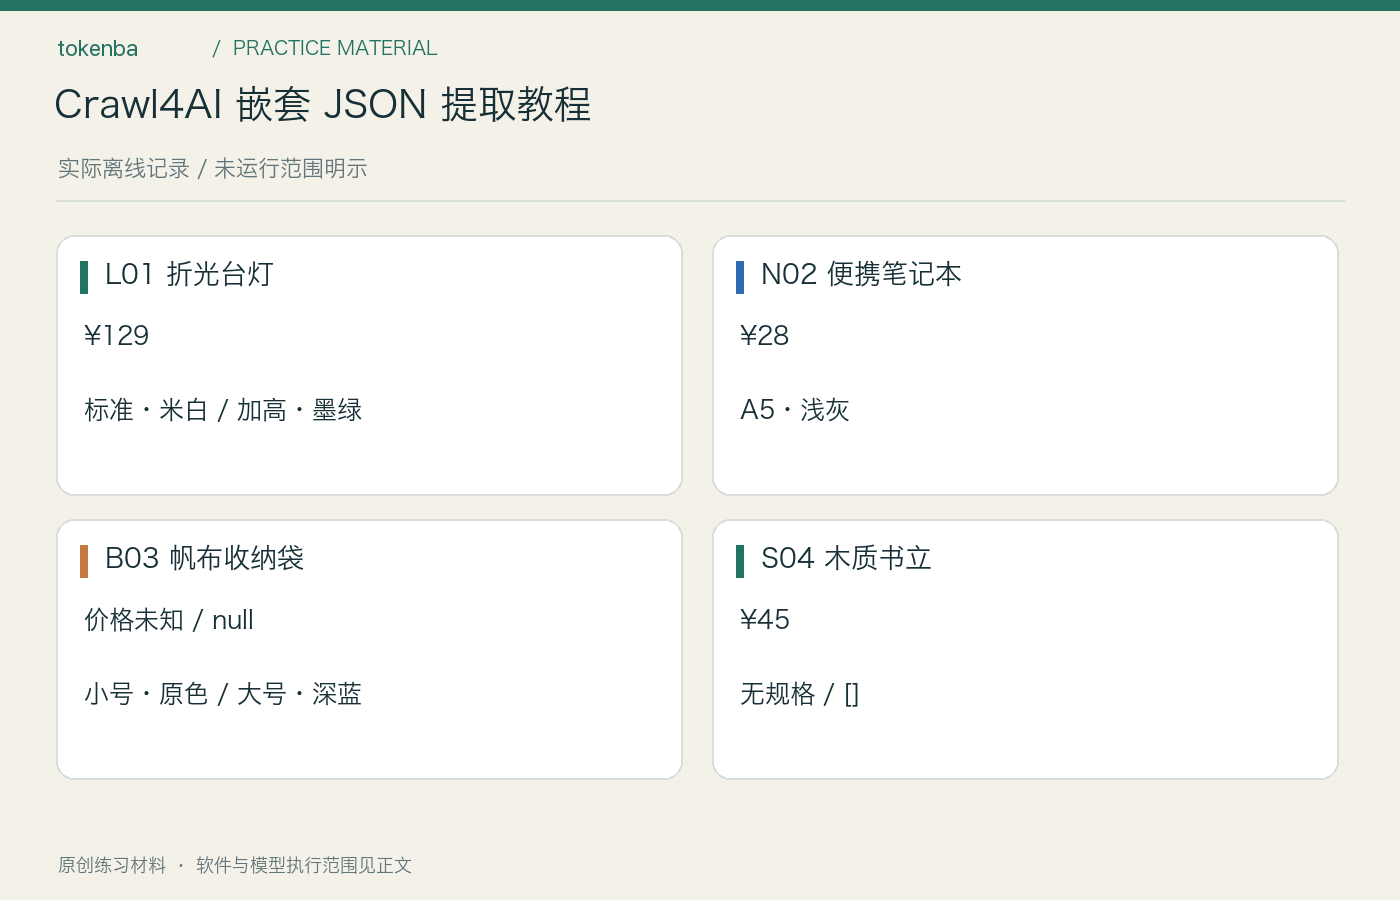
打开 products.html,逐张看商品 ID、价格和嵌套选项:台灯 2 个、笔记本 1 个、收纳袋 2 个、书立 0 个。价格缺失是未知,不写成 0 元。
bash
python3 verify.py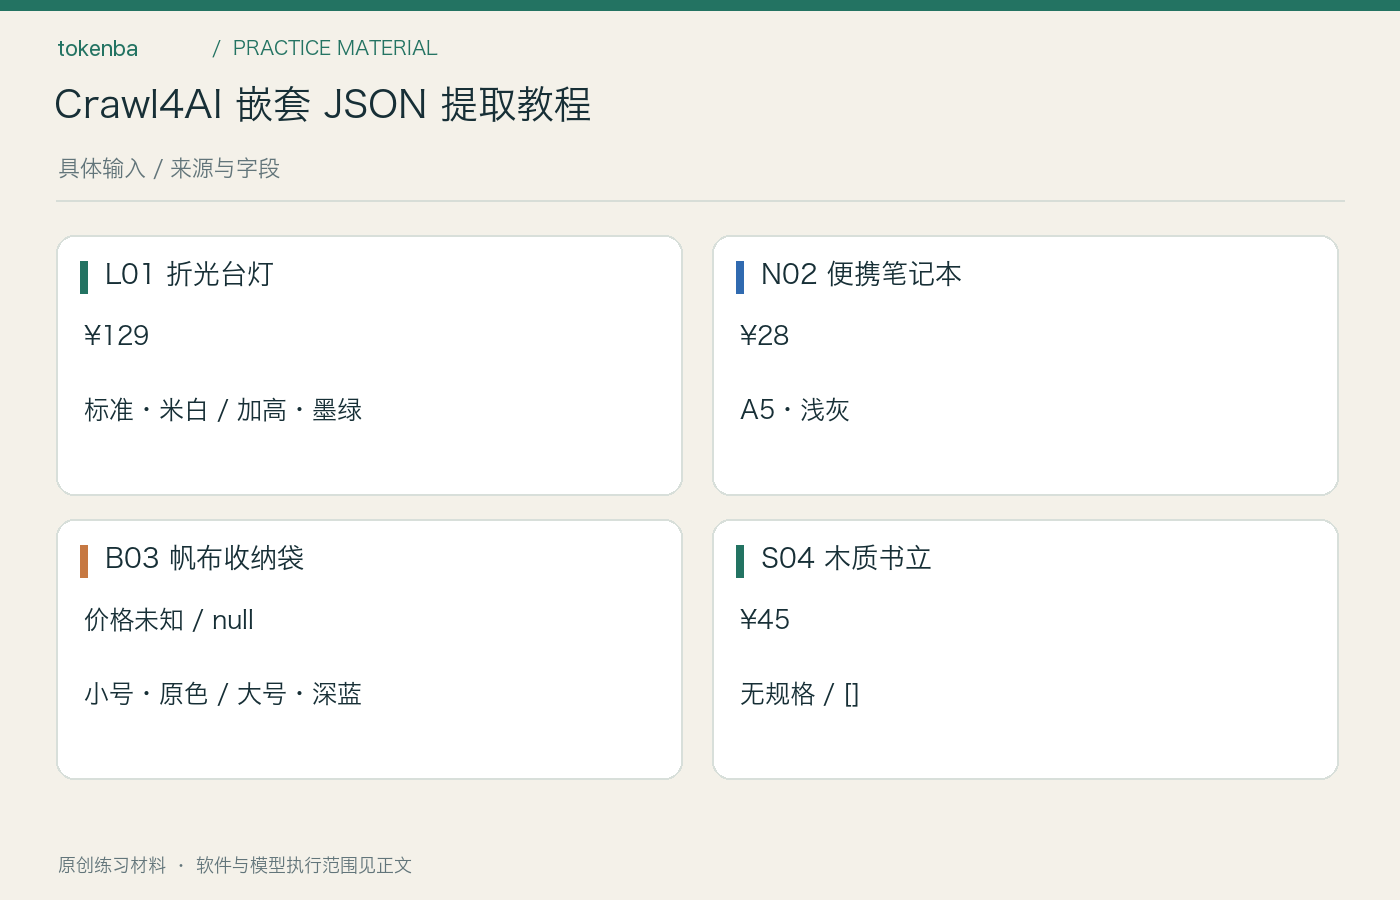
2. 定义商品容器
schema.json 的 baseSelector 设为 .product,避免全页选择所有 .option 后丢失商品归属。字段从当前容器内部取值。
3. 用 nested_list 提取规格
为 options 设置 nested_list 与 .option,里面再读 size、color。保留每张商品卡自己的选项数组,不按总数量扁平拼接。
4. 以无 LLM 路线实际抓取
运行 run.py,AsyncWebCrawler 访问本地临时服务并应用 JsonCssExtractionStrategy。模型 schema 生成功能并未使用,也没有模型费用。
bash
python3 run.py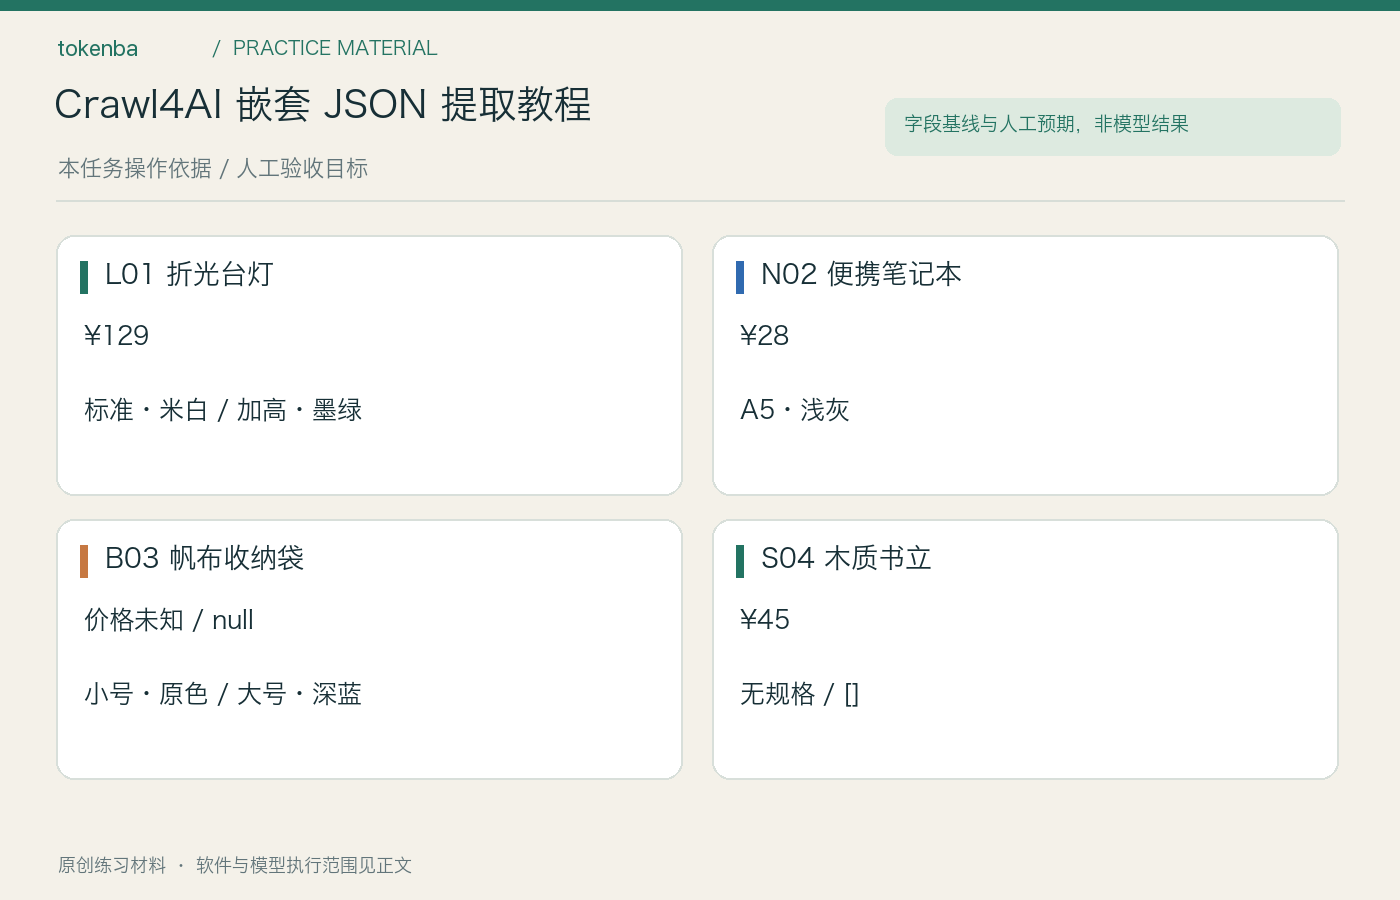
5. 规范缺失值与空数组
对缺 price 的收纳袋保留 null,对书立保留 []。清洗后记录 normalize 规则,不为了通过验证凭空补一个规格或价格。
6. 按 ID 检查规格归属
verify.py 对照原始 products.json,检查每个 ID 的选项顺序与数量。negative.json 故意把台灯规格移给书立,必须被拒绝。
bash
python3 verify.py --actual result.json7. 给下游模型保留原字段
需要 AI 双语描述时提交完整结构与未知标记,要求不补价格。保留原 JSON,不让文案生成覆盖采集结果;本包未调用下游模型。
怎样确认已经完成
- verify.py 对照原始 products.json,检查每个 ID 的选项顺序与数量。negative.json 故意把台灯规格移给书立,必须被拒绝。
- 需要 AI 双语描述时提交完整结构与未知标记,要求不补价格。保留原 JSON,不让文案生成覆盖采集结果;本包未调用下游模型。
- 已真实运行 Crawl4AI 0.9.5 与本机 Chrome 对原创网页进行无 LLM 抽取,结果和缺项/不完整负例通过;没有模型调用。
常见问题
Crawl4AI no LLM 能做嵌套数组吗?
官方 JsonCssExtractionStrategy 支持嵌套结构;关键是以商品容器作用域提取,随后逐个 ID 校验归属。
缺价格可以统一写 0 吗?
不可以。未知不等于免费,本例保留 null;模型下游也不能补写没有来源的价格。