
展开本页目录
开始前准备什么
- 将练习包解压到独立目录,不覆盖已有项目或真实业务资料。
- 先运行本包校验并查看实测范围,再按官方文档使用自己的软件、账号与准确版本。
- 需要真实模型的步骤只使用自己的 Key,截图与下载包不包含凭据。
- 先看三条初始卡片
- 安装并固定运行环境
- 建立可复用 session
- 先触发加载再等待增长
- 抽取稳定 ID 与标题
- 核对最后一张和负例
- 保留原页与实际抓取结果
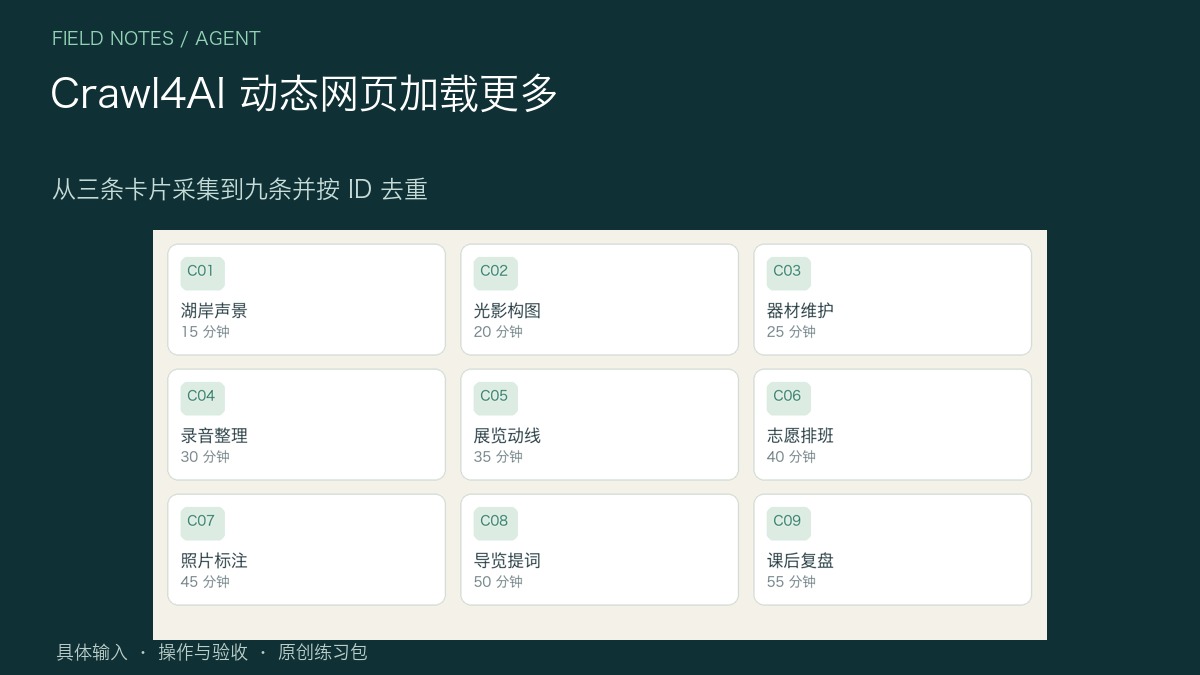
原创输入、运行脚本、字段校验、负例和执行范围;不含可用密钥。
已真实运行 Crawl4AI 0.9.5 与本机 Chrome 对原创网页进行无 LLM 抽取,结果和缺项/不完整负例通过;没有模型调用。
对应正文的具体资料,保持输入可追溯。
验证字段与负例;不能代替未执行的软件或模型。
明确区分材料验证、框架执行和模型调用。
1. 先看三条初始卡片
运行 server.py 打开动态列表,页面最初只显示 C01–C03。后六条需要点击两次 Load More;原始 HTML 只有壳,抓取器不能在按钮点击前就交付三条结果。
bash
python3 server.py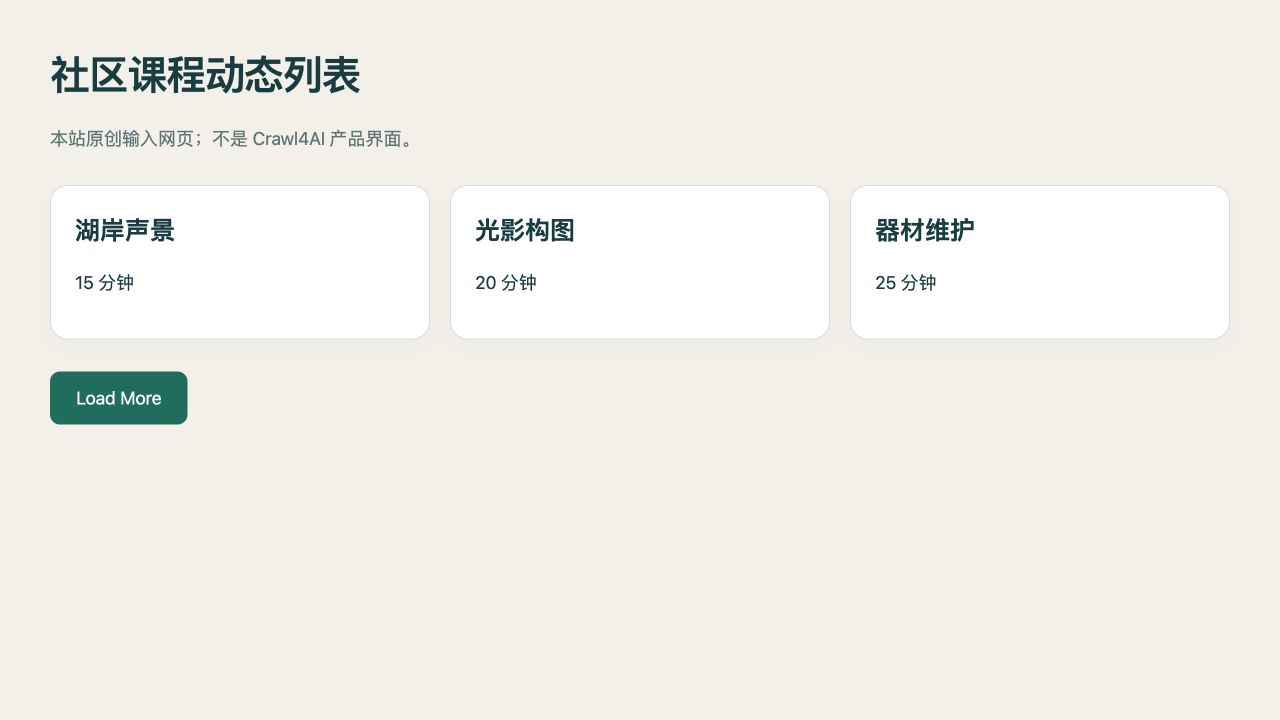
2. 安装并固定运行环境
run.py 使用 Crawl4AI 的 AsyncWebCrawler 和 JsonCssExtractionStrategy,不调用 LLM。按 requirements.txt 安装并使用官方 crawl4ai-setup 准备浏览器,已有受支持 Chromium 可通过环境指定。
3. 建立可复用 session
首轮带 session_id 和 cache bypass,等待三条卡片出现。后续调用使用同一 session_id 与 js_only=True,避免重新导航回到第一批。
4. 先触发加载再等待增长
点击写入 js_code_before_wait,wait_for 检查卡片数确实增长到 6、9。当前文档的 js_code 在 wait_for 之后,放错顺序会一直等未触发的数据。
5. 抽取稳定 ID 与标题
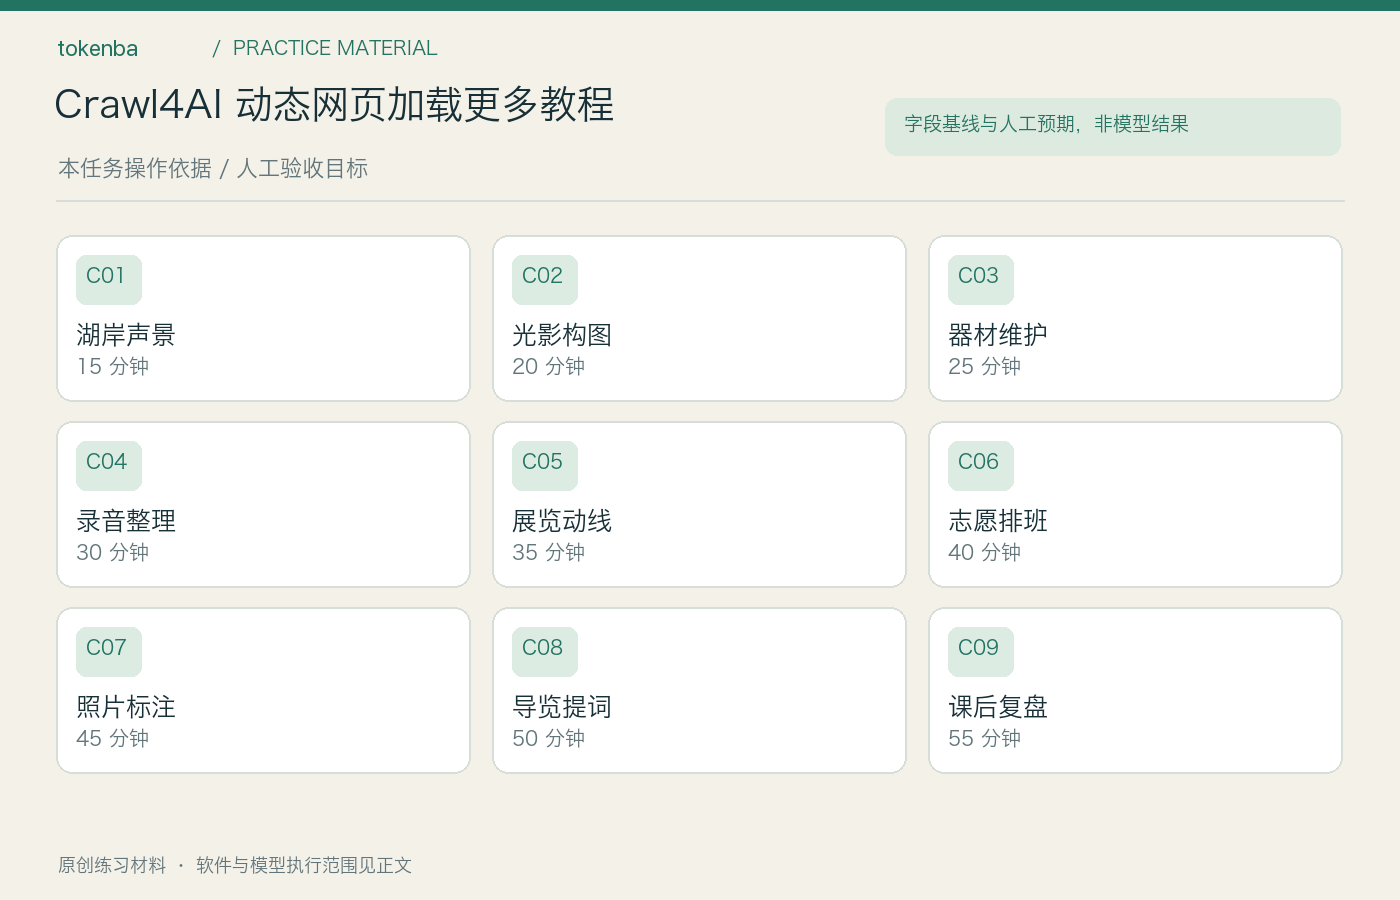
每批只提取 data-id、标题和 minutes,合并时按稳定 ID 去重,不以标题去重。重复卡片不是新的课程,输出必须恰好 9 个 ID。
bash
python3 run.py6. 核对最后一张和负例
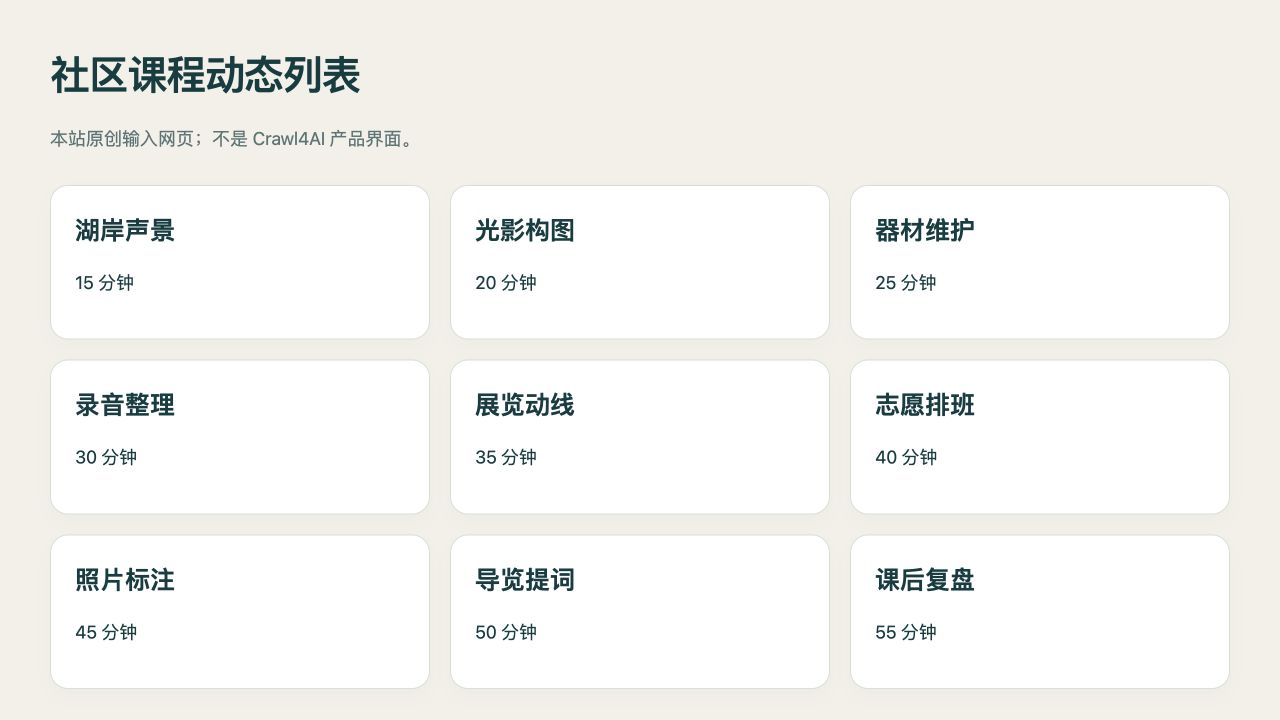
验证结果含 C09“课后复盘”,再用只含前三条的 negative.json 检查验证器拒绝不完整输出。HTTP 成功不等于动态内容已齐。
bash
python3 verify.py --actual result.json7. 保留原页与实际抓取结果
保存 original cards.json、实际 result.json、当前版本和测试结果。本题无模型,后续 AI 摘要需要单独配置服务,不把本地爬虫算成 AI 调用。
怎样确认已经完成
- 验证结果含 C09“课后复盘”,再用只含前三条的 negative.json 检查验证器拒绝不完整输出。HTTP 成功不等于动态内容已齐。
- 保存 original cards.json、实际 result.json、当前版本和测试结果。本题无模型,后续 AI 摘要需要单独配置服务,不把本地爬虫算成 AI 调用。
- 已真实运行 Crawl4AI 0.9.5 与本机 Chrome 对原创网页进行无 LLM 抽取,结果和缺项/不完整负例通过;没有模型调用。
常见问题
为什么 Crawl4AI 一直等加载更多?
触发点击应放在等待之前。当前官方支持 js_code_before_wait,而 js_code 在 wait_for 后执行;按版本核对执行顺序。
采集九条卡片需要 apizt 吗?
本题 CSS 提取不需要模型。需要对抓取结果做分类或摘要时,才使用独立的模型调用步骤。