
展开本页目录
开始前准备什么
- Python环境与本地CPU;Indra使用ONNX,不需要PyTorch或GPU,首次运行需下载约76MB默认模型,math模型另计。
- 代码Apache2.0;权重modified OpenRAIL-M,有企业规模与竞争用途限制,不能宣传无限制免费商用。
- 本课原生材料可离线免费检查;目标识别未执行,实际page.source/conf/坐标只能运行后填写。
- 准备混合原稿
- 先运行默认配置
- 启用数学识别
- 核对LaTeX表达
- 复查数字表格
- 按块选择校对版本
- 交付开关决策
1. 准备混合原稿
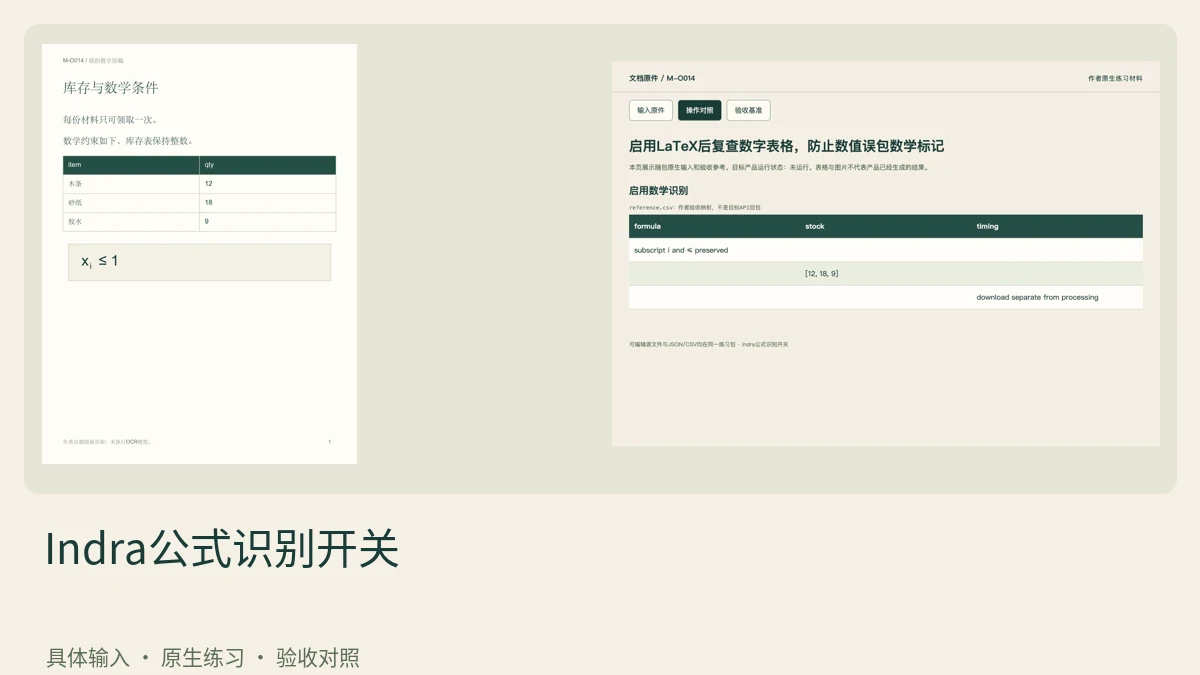
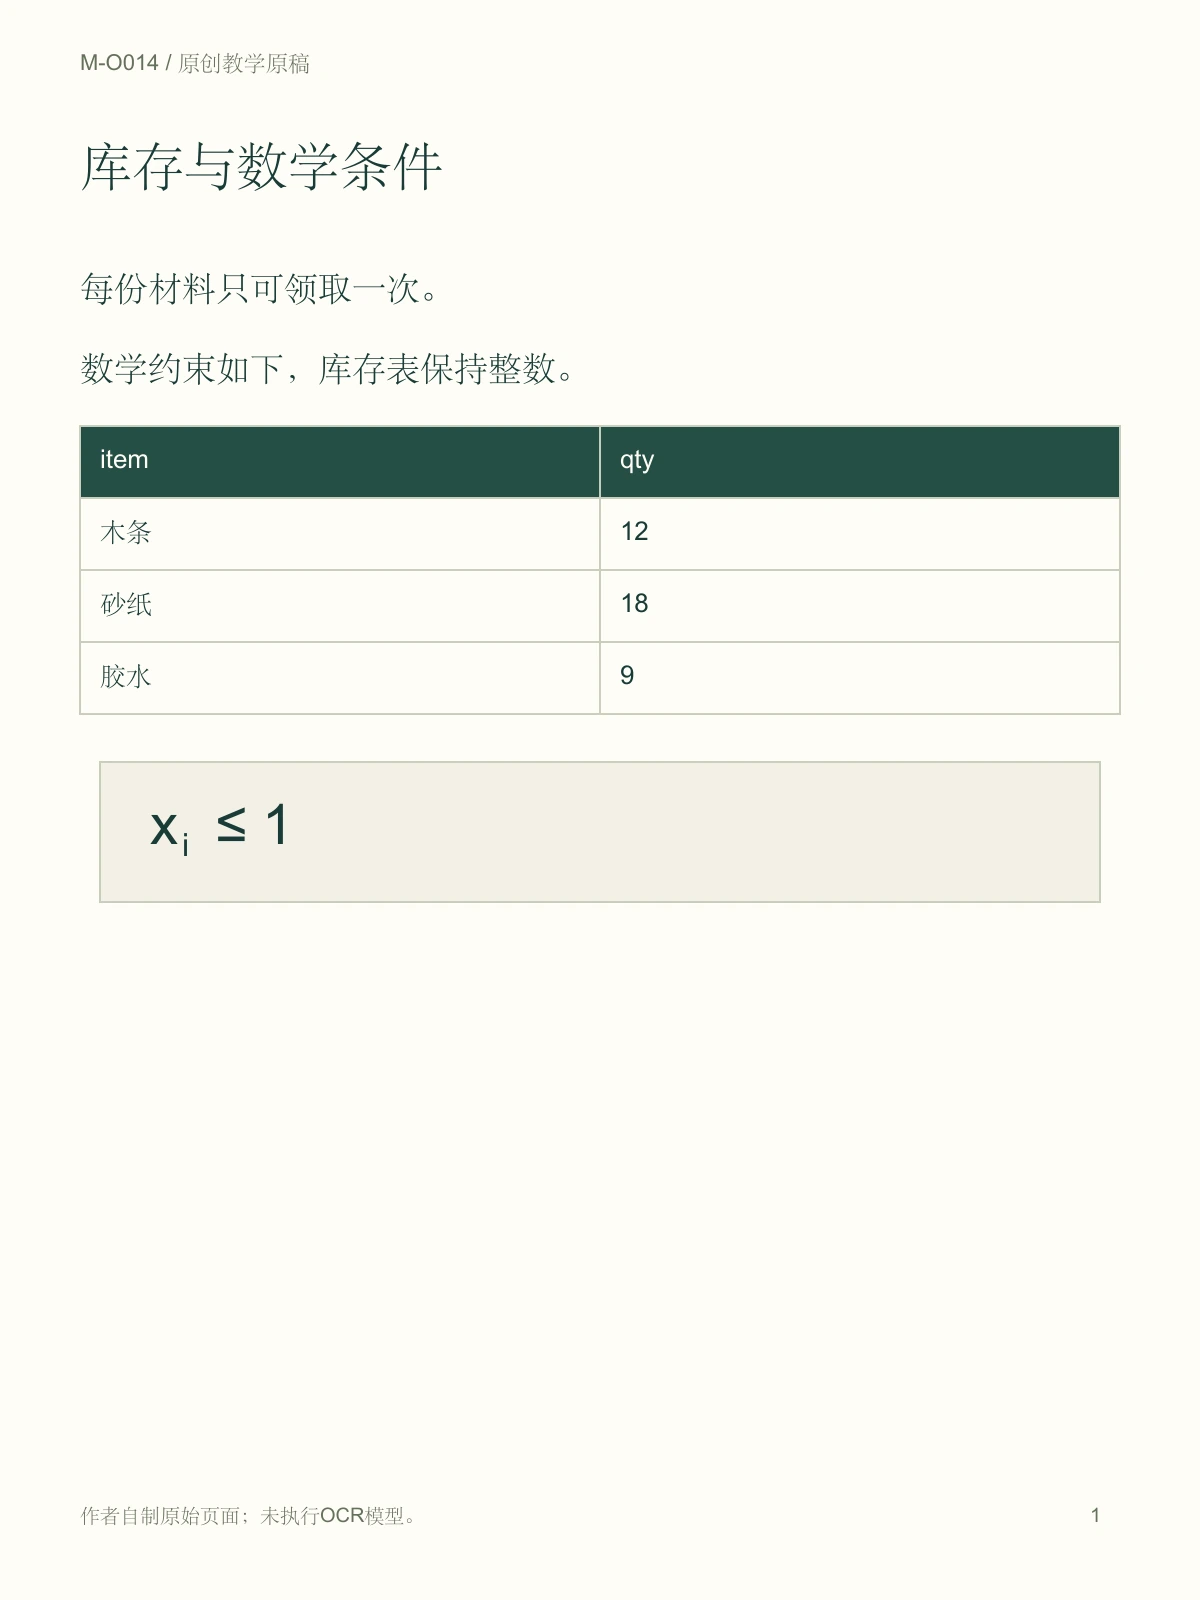
报告含x_i≤1和库存12、18、9的简单表格。
公式与库存分别有清楚标题,避免只能凭数值猜类型。
2. 先运行默认配置
保存未启用math的Markdown与JSON。
默认可能把公式当普通文字,不能声称它已输出规范LaTeX。
3. 启用数学识别
同输入使用--math,记录额外模型下载和实际时间。
首次下载耗时与推理耗时分开,不复用官方基准当本机速度。
官方界面与功能位置
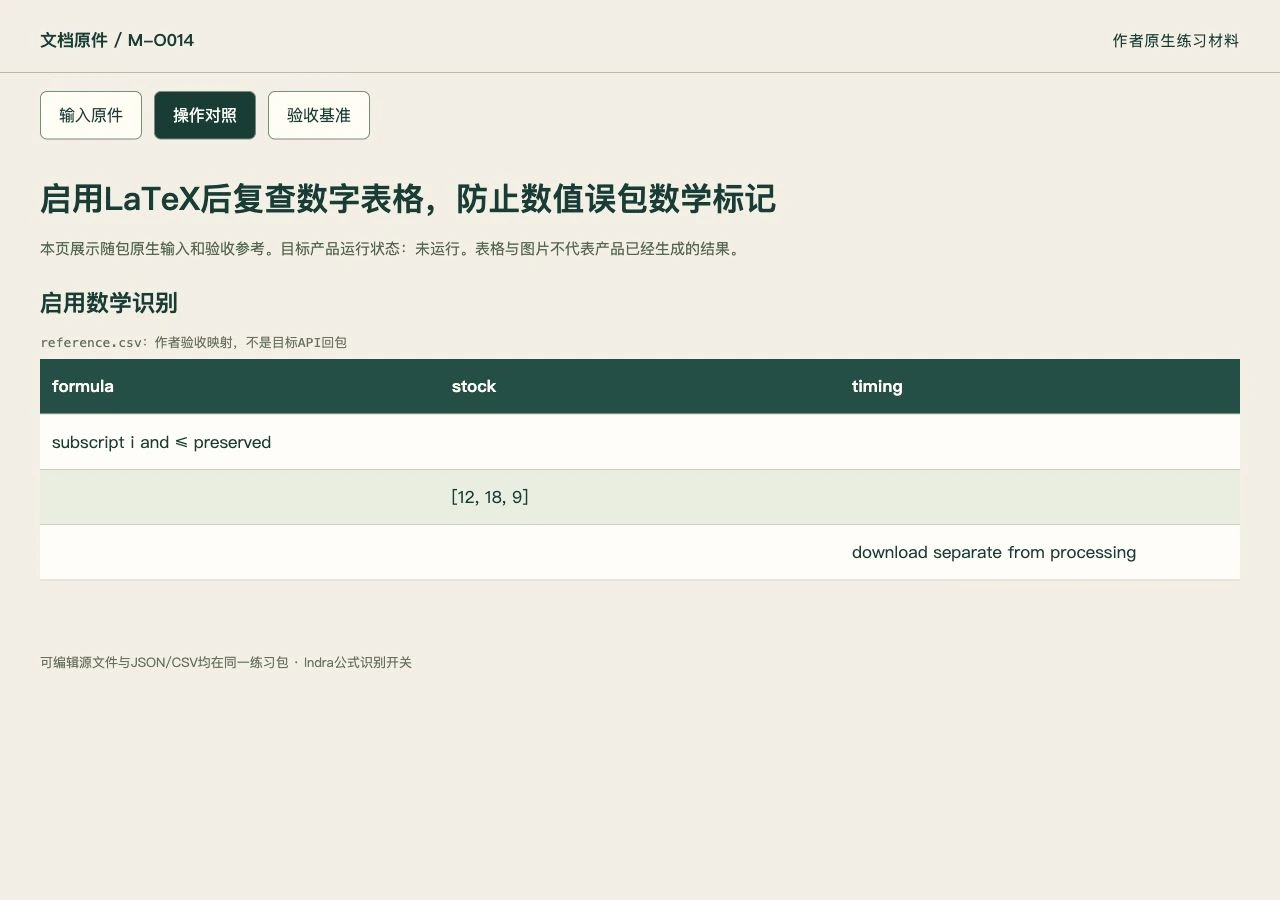
以下为官方文档配图,具体版本与账号入口以当前产品为准。本课练习输入与验收对照见相邻步骤。
4. 核对LaTeX表达
检查下标与不等号语义,原式仍是x_i≤1。
看起来像公式不够,变量和符号需要回页核对。
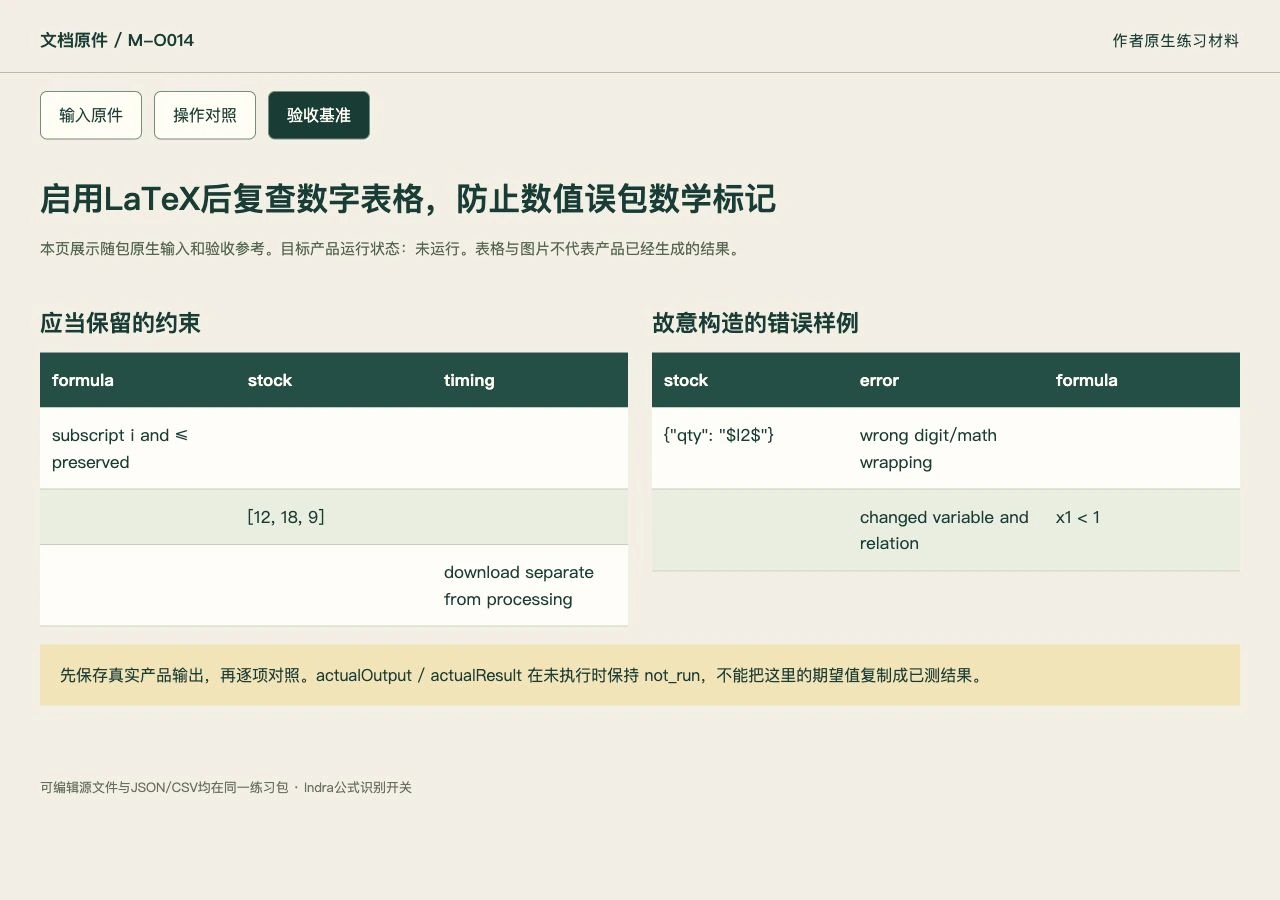
5. 复查数字表格
比较三行库存是否多出数学标记或改变数值字符串。
官方提示math可能把部分表格数字当数学识别,因此表格需另查。
6. 按块选择校对版本
保留原始两份,校对稿注明采用哪些公式/表格块。
人工拼合必须标人工修订,不覆盖原始结果。
7. 交付开关决策
保存效果、额外依赖和时间边界,说明是否适合当前材料。
未执行时不写“准确率提高”或固定速度结论。
下载本课材料并开始操作
练习包包含本课的具体输入、可编辑数据、正反样例与七步说明。index.html 可离线查看原件和验收参考,actual-results.csv 用于记录你实际操作后的结果。
怎样确认已经完成
- 公式变量/下标/关系符一致。
- 库存仍为12、18、9。
- 下载、推理和人工校对分别记录。
常见问题
Indra开math一定更准吗?
不一定适合所有内容。官方指出表格数字可能被当公式,且开关会增加处理成本;本课用公式和库存表一起比较。
公式改好了,表格变成一堆美元符怎么办?
先保留两份原始结果,再按块校对。不能全局删所有美元符,也不能只展示公式成功就忽略表格副作用。