
展开本页目录
开始前准备什么
- LightOnOCR-3采用本地或自有授权服务;4B/0.8B为Qwen3.5架构,1B架构不同,显存还受图片与上下文影响,不承诺某张卡必定够用。
- 使用官方仓库锁定的兼容依赖;当前仓库说明vLLM0.30.0与Transformers5.16.1,模型卡的旧最低版本不能替代锁文件。
- 模型Apache2.0;仅空prompt或grounding是文档支持输入,原生PDF与检查无需付费,模型识别未执行。
- 准备三种美元符用途
- 保存未经修复输出
- 取得默认客户端结果
- 定位分隔符变化
- 核对代码字符串
- 回看渲染与原文
- 交付字符级差异
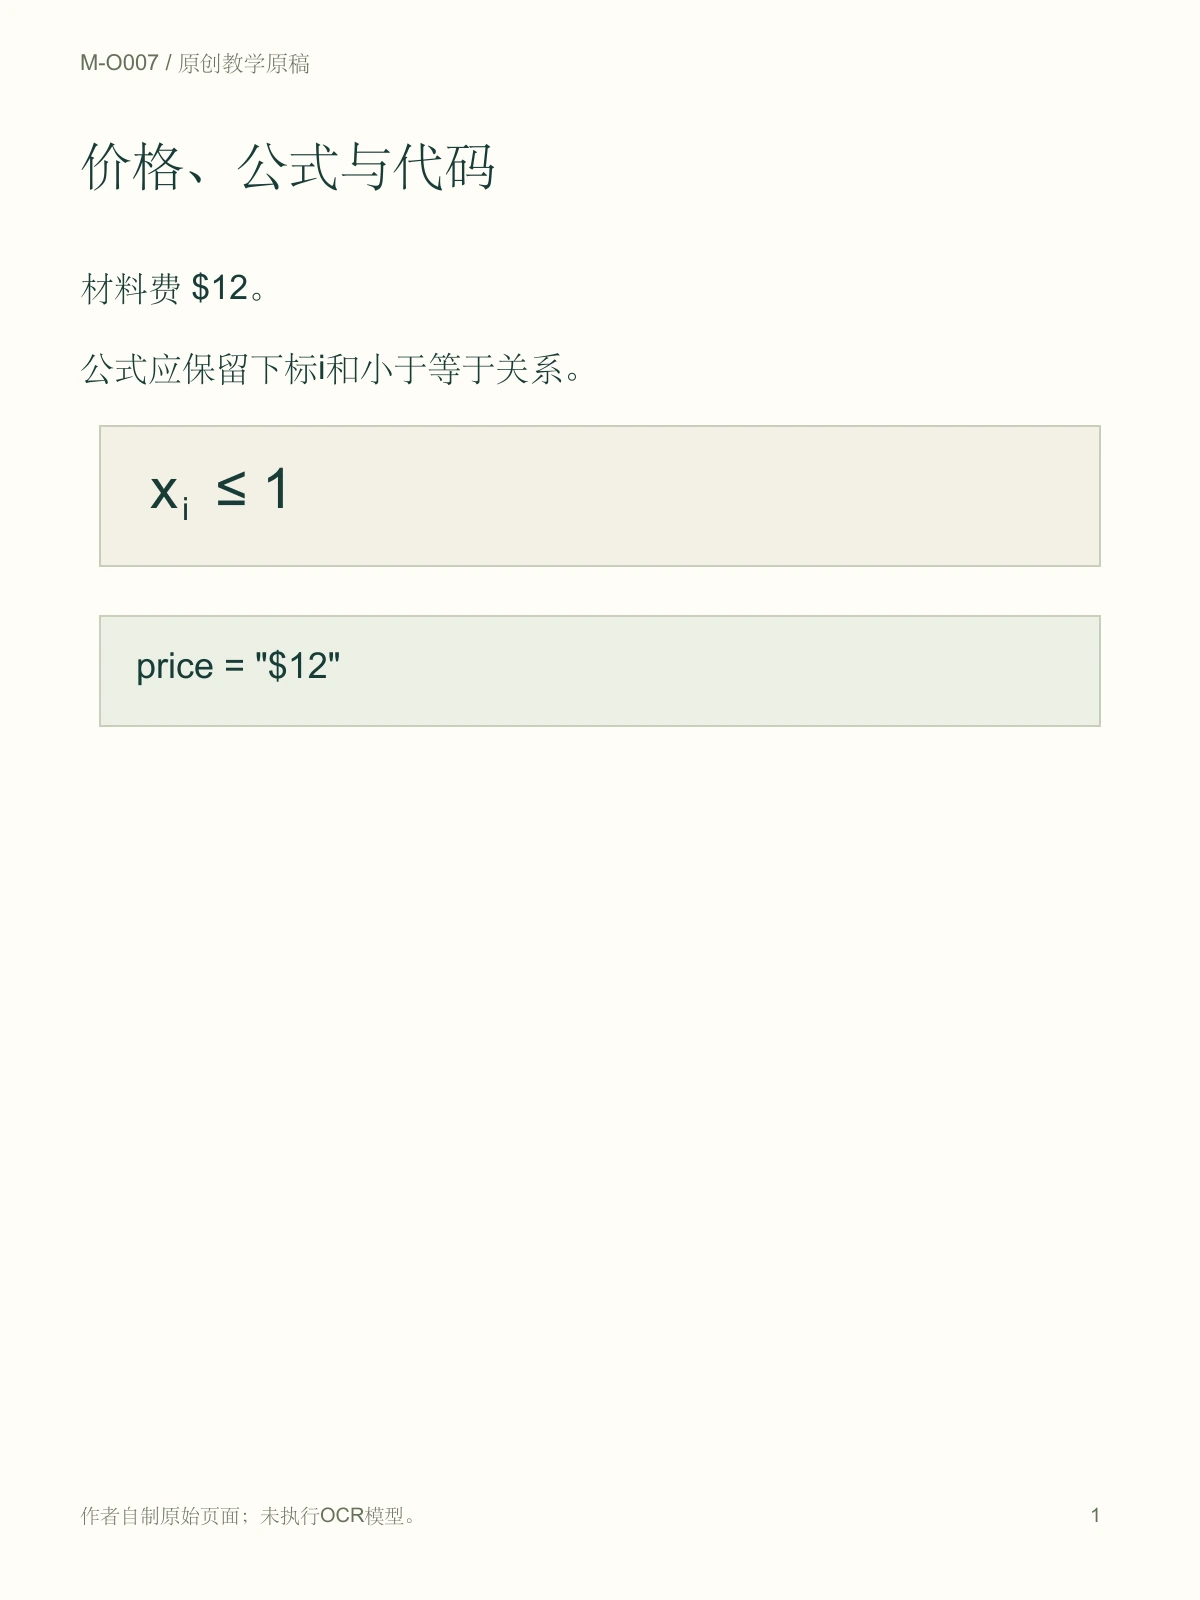
1. 准备三种美元符用途
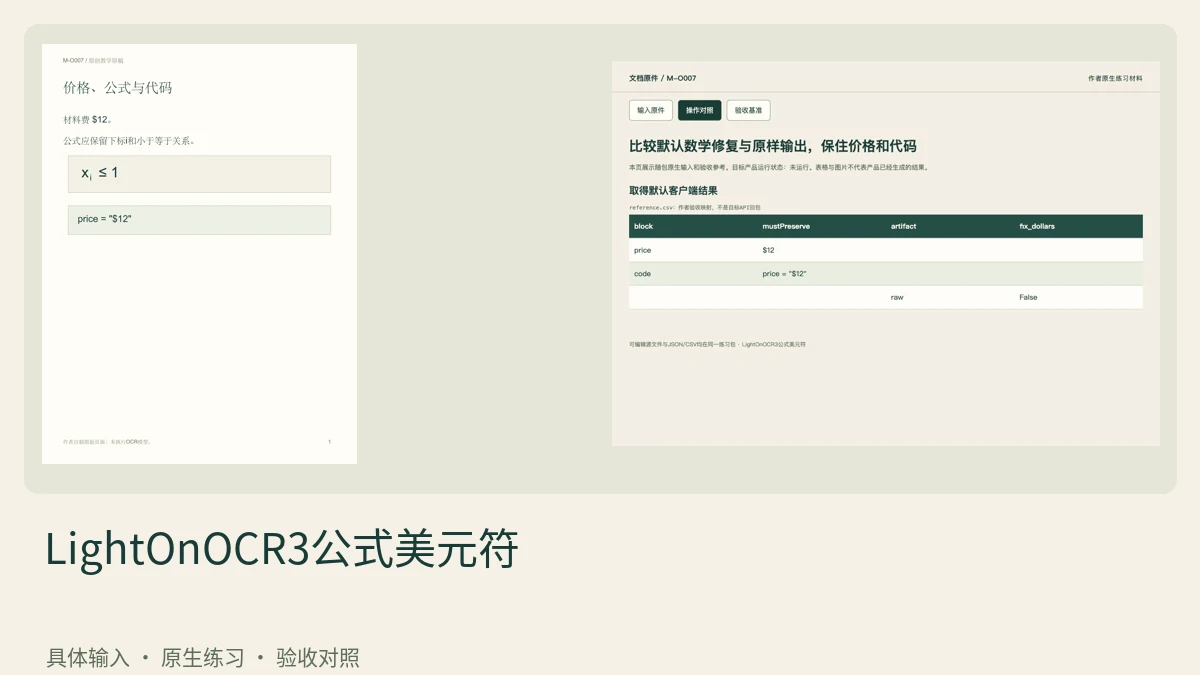
原稿包含价格$12、公式$x_i≤1$及代码price="$12"。
三类内容用明确标签分开,不让代码排版像普通公式。
2. 保存未经修复输出
按官方接口用ocr.ocr(page,fix_dollars=False)取得原样文本。
原样文本是基线,不以作者期望替代。
3. 取得默认客户端结果
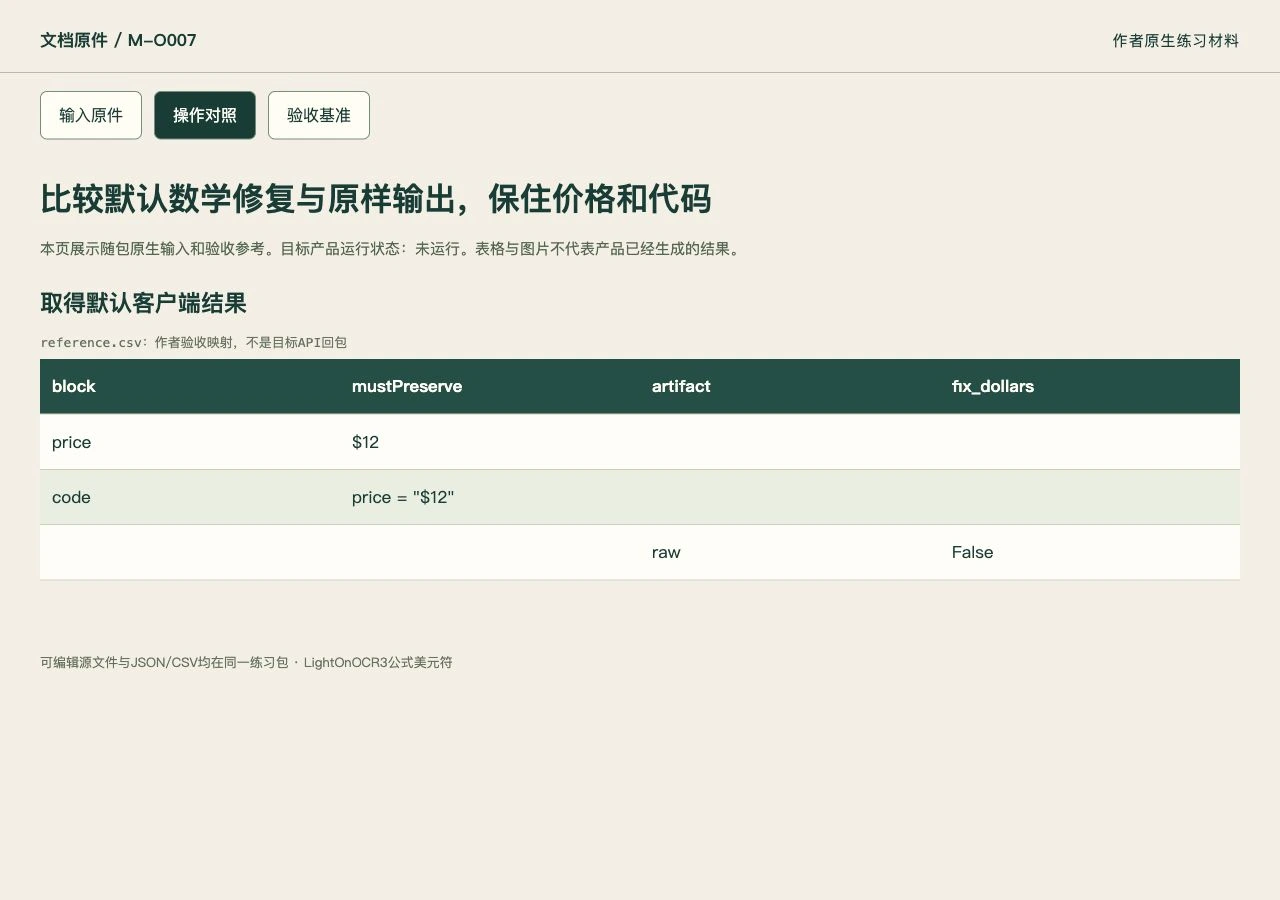
在相同输入与模型配置下读取默认修复输出。
若重复采样有差异,先记录,不能把所有变化都归因fix_dollars。
4. 定位分隔符变化
逐项查看转义数学分隔符是否被修正。
官方说明价格应保留,不能把所有美元符统一转数学环境。
5. 核对代码字符串
比较代码块中的引号、反斜线和价格字符串。
任何字符变化单列,不能因为视觉显示接近就忽略。
6. 回看渲染与原文
同时显示原样Markdown、修复Markdown和原稿。
数学渲染成功不证明原稿金额未被改动。
7. 交付字符级差异
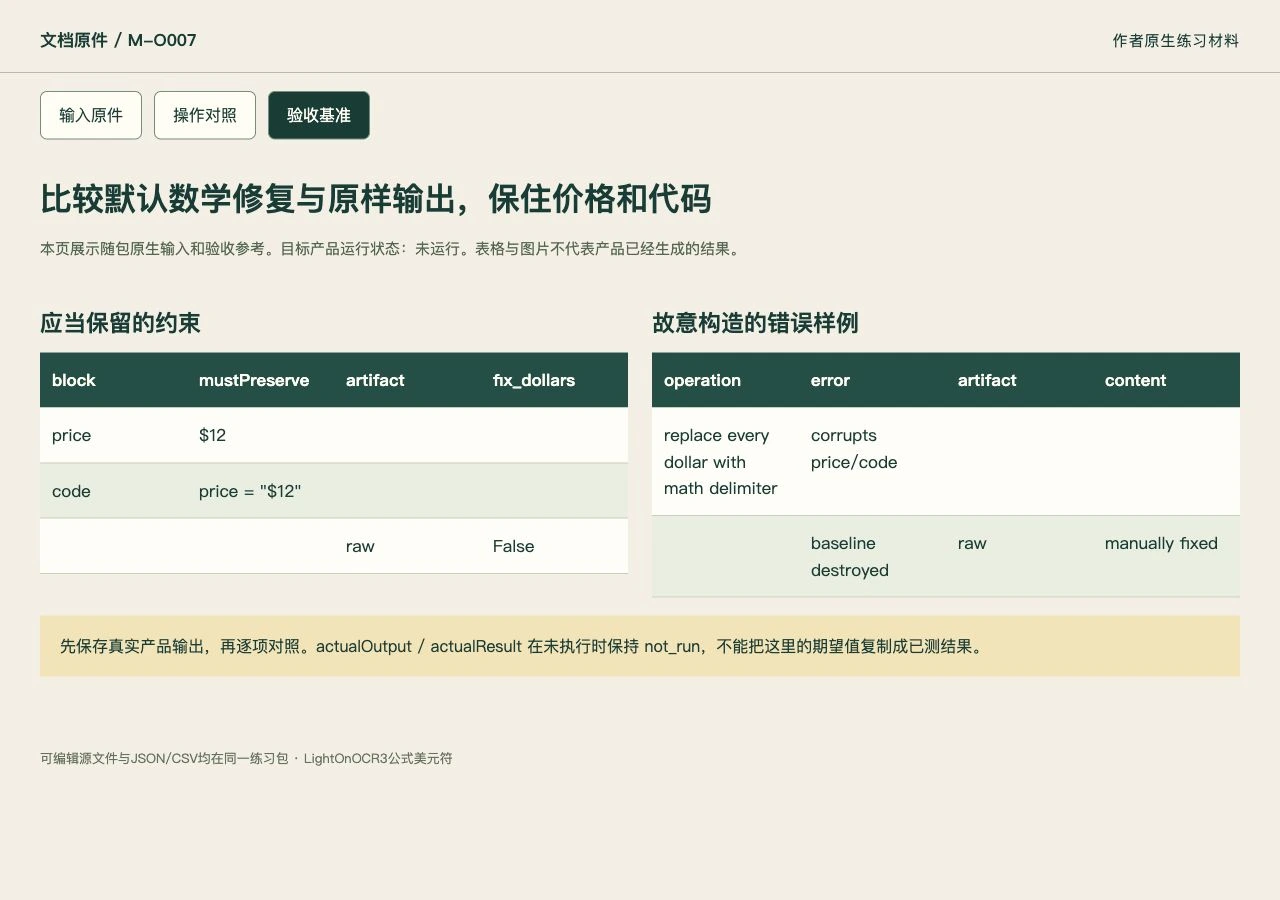
保存两份原文与差异清单,解释采用哪份。
未执行时只交混合原稿与校验样本,不声称模型自动修好了。
下载本课材料并开始操作
练习包包含本课的具体输入、可编辑数据、正反样例与七步说明。index.html 可离线查看原件和验收参考,actual-results.csv 用于记录你实际操作后的结果。
怎样确认已经完成
- raw与fixed两份文本分开。
- 价格$12和代码原字符串保留。
- 公式修复与采样差异分开归因。
常见问题
OCR里的美元符都能直接删反斜线吗?
不应全局替换。价格、代码和数学分隔符含义不同,本课先保留fix_dollars=False原文,再检查客户端修复只改变合适的数学表达。
公式看起来正常就通过了吗?
还要检查价格和代码字符。视觉渲染可能遮住转义差异,必须对比原始字符串与原页内容。