
展开本页目录
开始前准备什么
- Python环境与本地CPU;Indra使用ONNX,不需要PyTorch或GPU,首次运行需下载约76MB默认模型,math模型另计。
- 代码Apache2.0;权重modified OpenRAIL-M,有企业规模与竞争用途限制,不能宣传无限制免费商用。
- 本课原生材料可离线免费检查;目标识别未执行,实际page.source/conf/坐标只能运行后填写。
- 建立原文件页数表
- 设置每文件页限
- 执行并记录覆盖
- 核对预期数量
- 展示未处理范围
- 安排后续全量处理
- 交付带范围的结论
1. 建立原文件页数表
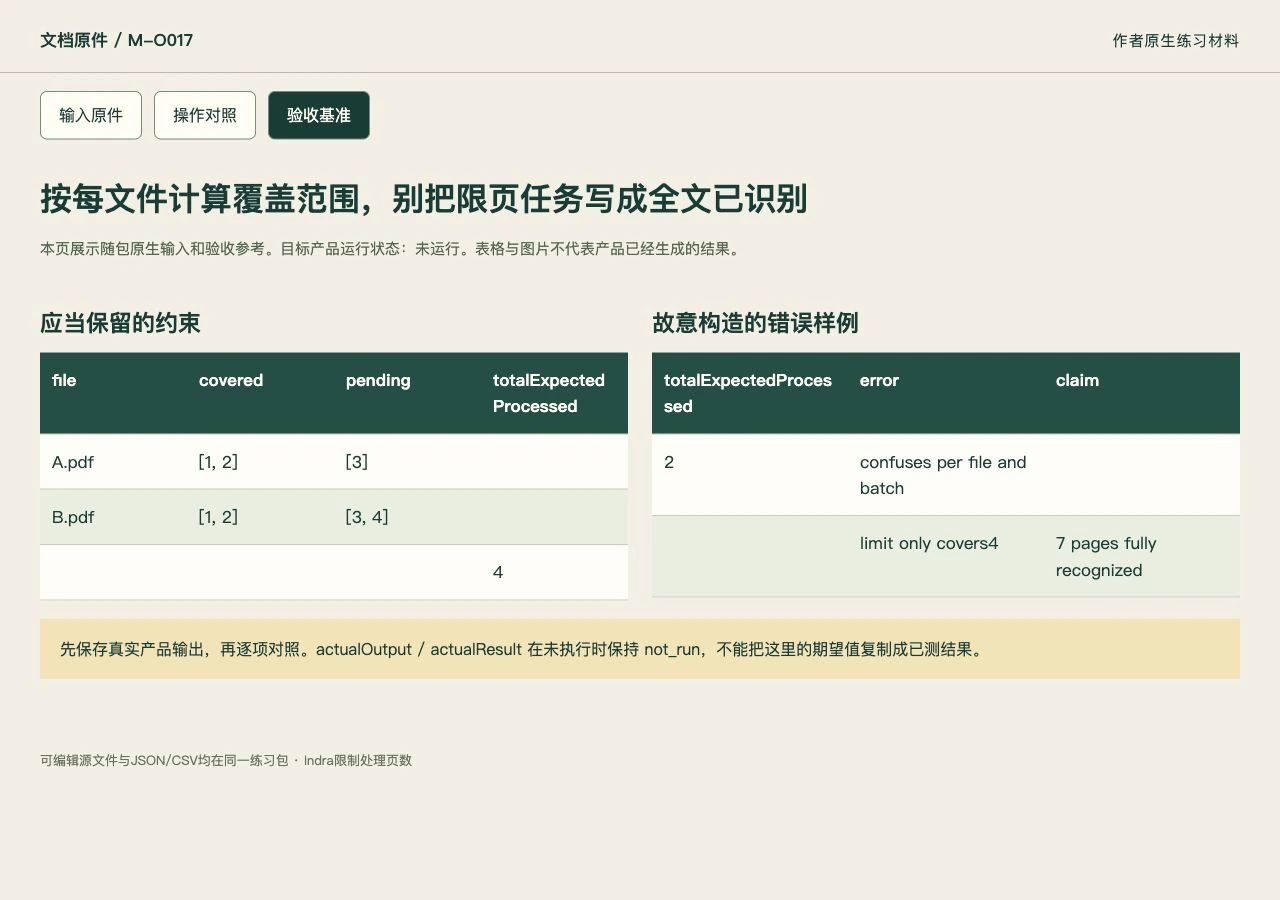
A有3页、B有4页,每页印文件ID和页码。
先独立获取页数,不让OCR输出自己证明原文有几页。
2. 设置每文件页限
使用--max-pages 2或conv.convert(max_pages=2)。
官方参数是每文件最多页数,不是整批共享总配额。
3. 执行并记录覆盖
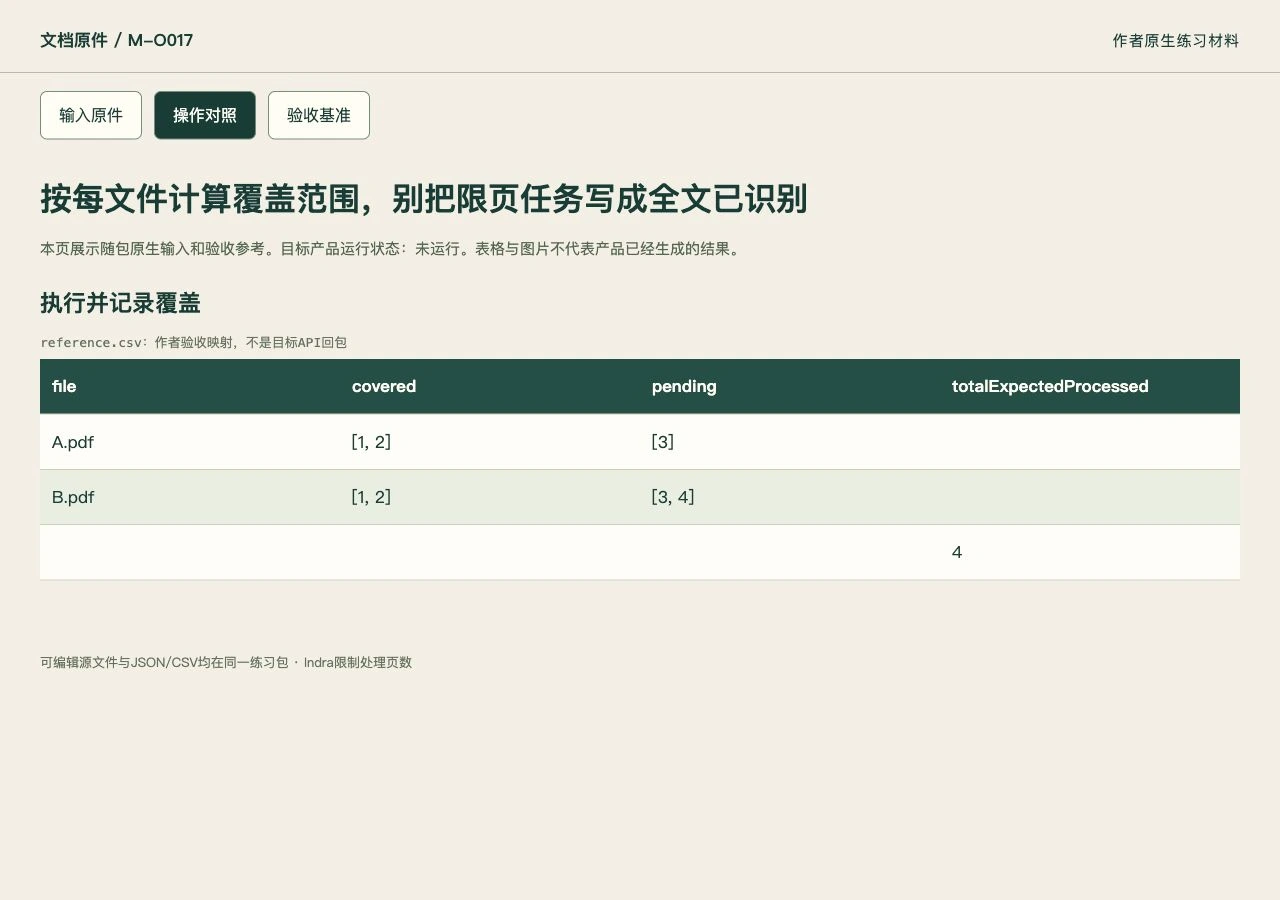
将每份文件实际读到的页序列写入manifest。
缺页或解密失败与主动限页分开记录。
官方界面与功能位置
以下为官方文档配图,具体版本与账号入口以当前产品为准。本课练习输入与验收对照见相邻步骤。
4. 核对预期数量
A预期覆盖2/3,B覆盖2/4,总计处理4页。
不要看到两文件均成功就把7页全部标完成。
5. 展示未处理范围
A第3页与B第3、4页进入未处理列表。
未处理页面不进入全文搜索或摘要的“已覆盖”承诺。
6. 安排后续全量处理
解除页限后再处理,保存新旧覆盖版本。
重跑后校验页数而非覆盖旧manifest消除历史限制。
7. 交付带范围的结论
页面明确写“每文件前2页试跑”。
没有目标执行时只展示页数算例与待填实际覆盖列。
下载本课材料并开始操作
练习包包含本课的具体输入、可编辑数据、正反样例与七步说明。index.html 可离线查看原件和验收参考,actual-results.csv 用于记录你实际操作后的结果。
怎样确认已经完成
- A=2/3、B=2/4覆盖明确。
- 总处理预期4页。
- 未处理页不被标已OCR。
常见问题
max-pages 2是两份PDF一共两页吗?
不是,官方是每文件最多N页。本课两份文件各2页,预期共4页,并保留各自原总页数。
命令成功了,能写全文已识别吗?
有页限时不能。应明确处理范围和未处理页,后续解除限制并验证全页覆盖后才能作全文结论。