
展开本页目录
开始前准备什么
- 下载完整练习包,在独立目录阅读README与已执行范围。
- 安装requirements.txt指定版本或使用文中目标工具;依赖与模型权重不要混入网站工程。
- 只有明确标为已执行的部分有本次证据;真实模型、账号或GPU步骤按自己的环境另行验证。
- 固定短文与长文两组问题
- 区分理论缓存字节和真实显存
- 核对设备和vLLM支持
- 先跑auto基线并保存答案
- 启用FP8并处理scale
- 比较长文条件是否遗漏
- 交付配置与质量对照
1. 固定短文与长文两组问题
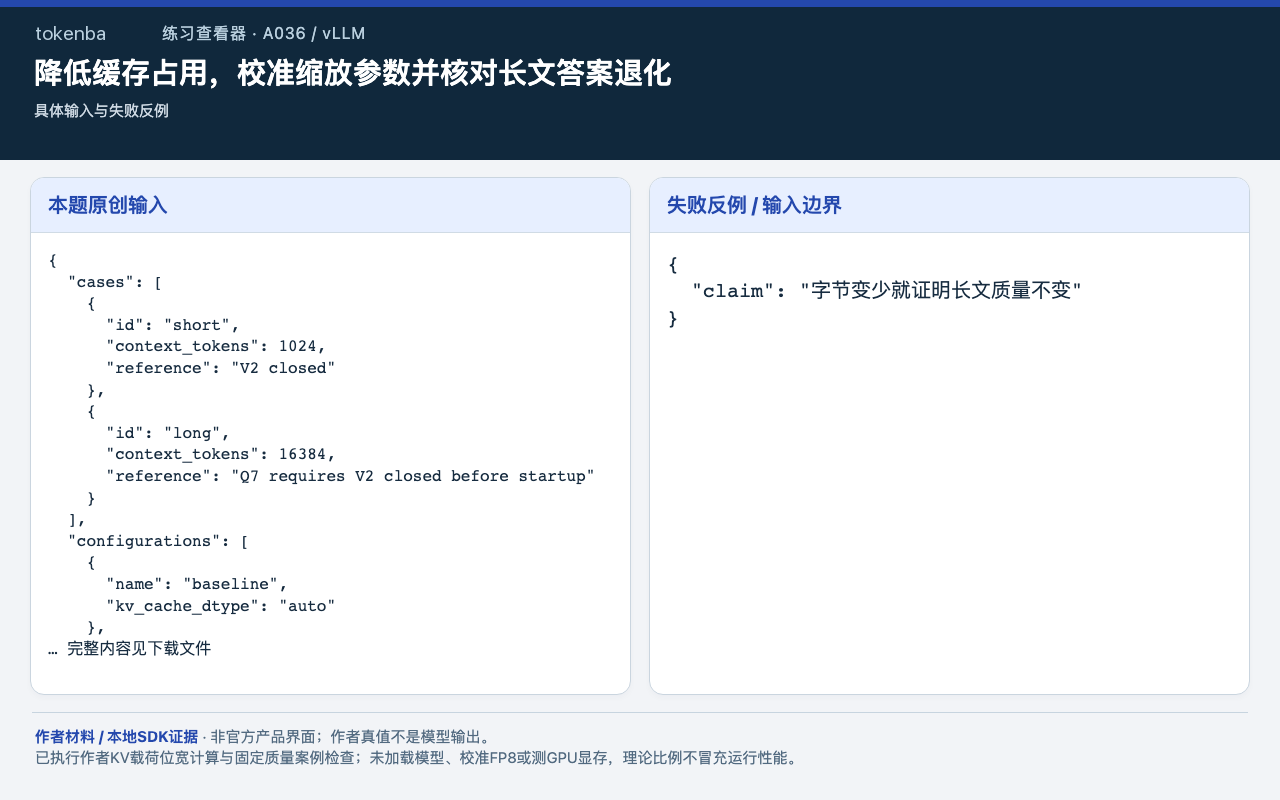
两组都要求阀门先关闭,长文将条件放在较远位置。相同原文、采样和输出预算用于baseline/FP8对照。
2. 区分理论缓存字节和真实显存
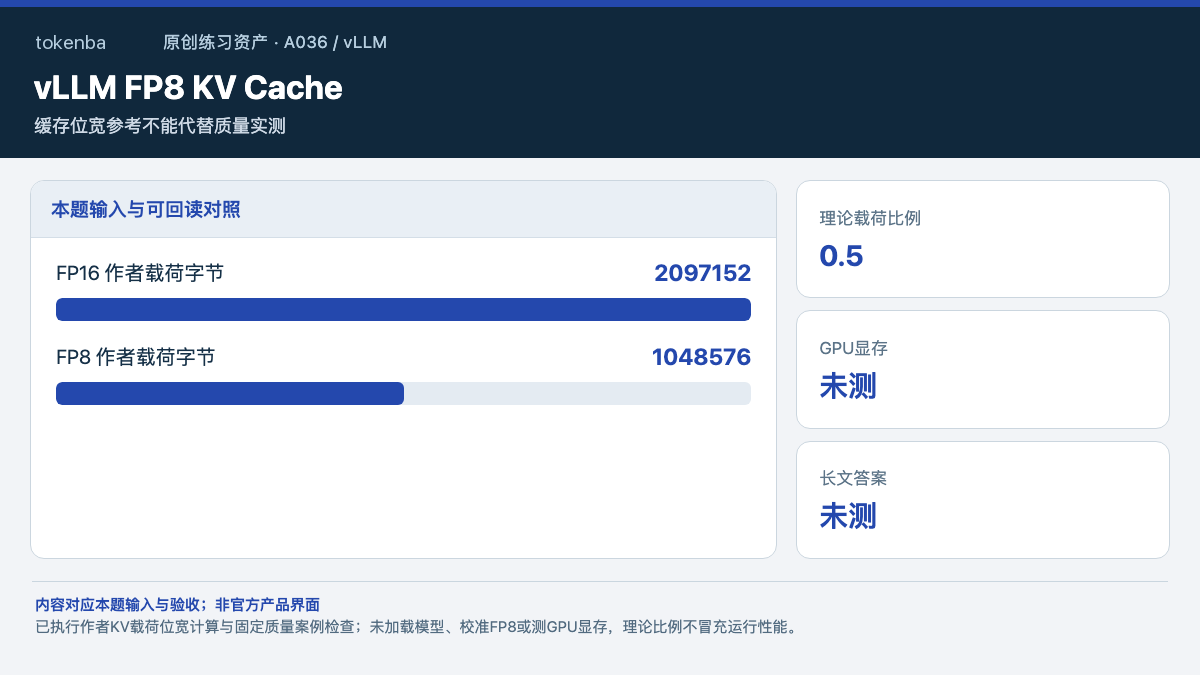
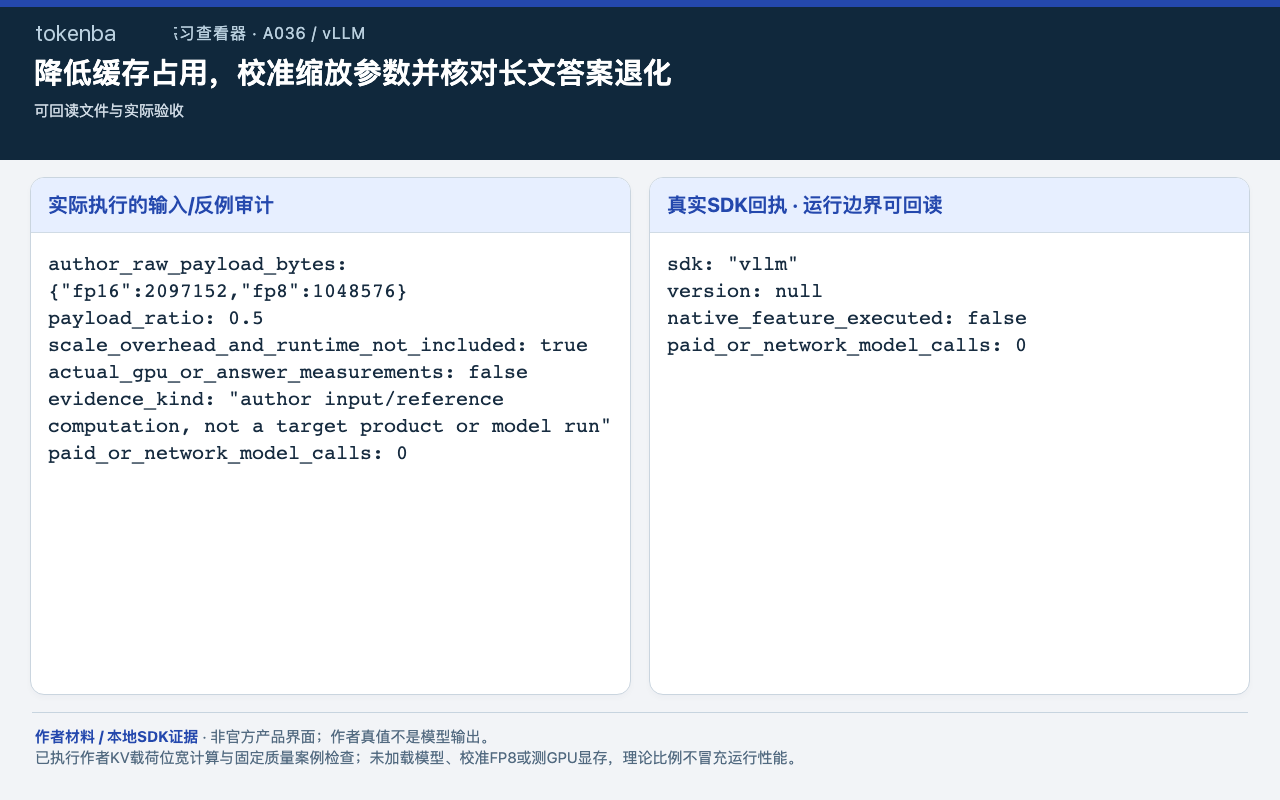
audit.py按元素位宽算0.5载荷比例,未计缩放及运行开销。它不能证明整机显存减半或答案质量不变。
本题独立目录执行
bash
python reference/audit.py3. 核对设备和vLLM支持
在目标版本检查FP8 KV cache支持的设备、dtype与缩放选项;记录GPU和模型,不能在不支持设备上忽略警告。
本题SDK或目标环境入口
bash
python reference/run_sdk.py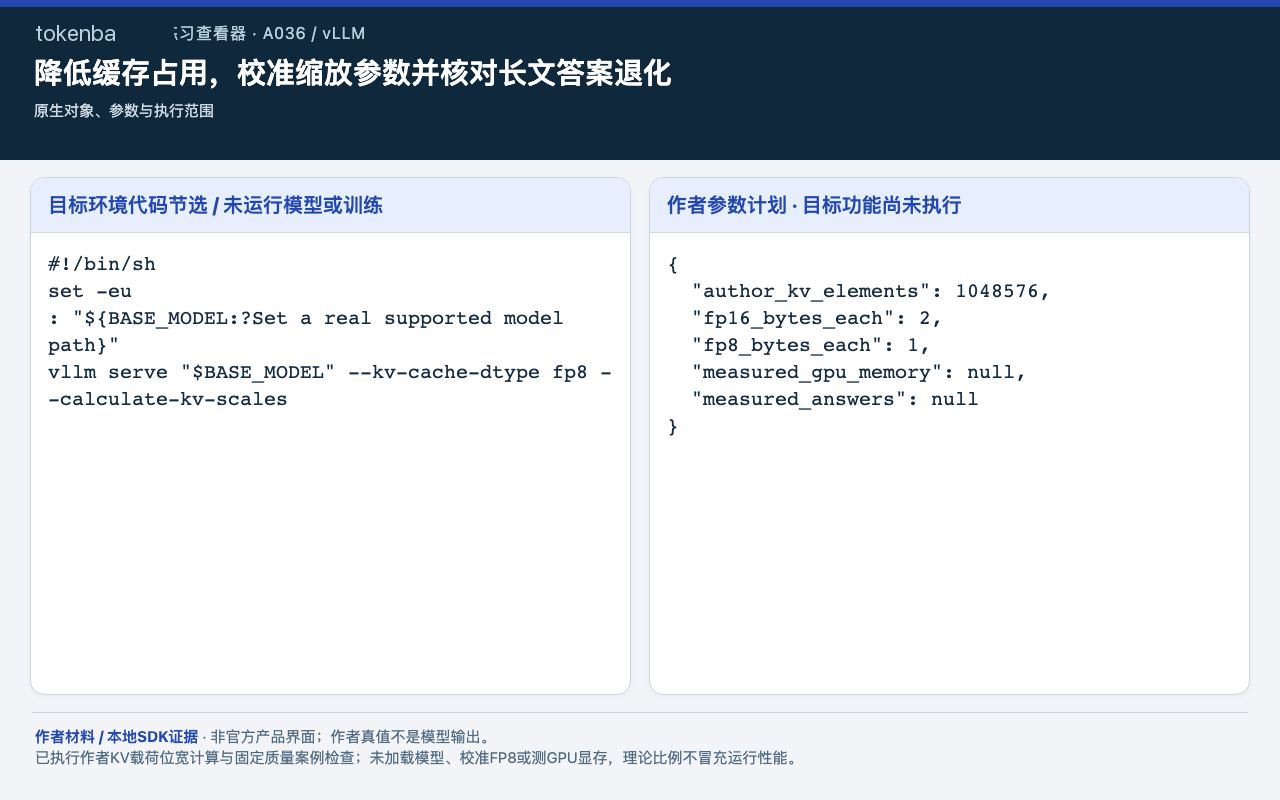
4. 先跑auto基线并保存答案
记录真实显存、上下文长度、首token延迟及答案正确性。所有测试都应使用同一个底座与提示。
5. 启用FP8并处理scale
按文档选择计算或加载校准scale,保存配置来源;默认缩放与合理校准的质量可能不同,不要删除告警。
6. 比较长文条件是否遗漏
人工核对Q7启动条件和V2顺序,列出正确率、错误及运行失败。减少缓存占用不能抵消遗漏安全前置条件的答案。
7. 交付配置与质量对照
保留baseline/FP8原始响应和资源记录。当前包只有理论载荷审计,所有GPU性能与真实答案字段均保持未测。
怎样确认已经完成
- 不把权重量化当KV量化
- 硬件dtype支持先核实
- 降显存不代表无质量损失
- 已执行作者KV载荷位宽计算与固定质量案例检查;未加载模型、校准FP8或测GPU显存,理论比例不冒充运行性能。
常见问题
vLLM怎么用FP8 KV Cache降低缓存占用?
目标设备/版本支持时设置FP8 KV dtype并按文档计算或加载scale。作者载荷0.5比例未包含运行开销,不代表整机显存减半。
启用KV缓存量化后,怎么检查长文答案有没有退化?
固定模型、采样和短/长文案例,保存auto与FP8真实答案、显存和告警,检查远端条件是否遗漏。包内未跑GPU或校准。
这篇教程哪些步骤已经真正执行?
已执行作者KV载荷位宽计算与固定质量案例检查;未加载模型、校准FP8或测GPU显存,理论比例不冒充运行性能。