
展开本页目录
开始前准备什么
- 已有本地 ComfyUI 环境;按所用模型官方说明准备硬件和权重。
- 下载本页材料,检查模型家族、目录与来源;模型权重未打包。
- 保留原文件与实际版本,UI workflow 与 API prompt 分开。
- 先保存完整错误上下文
- 建立最小单图基线
- 释放其它占用并重测
- 按当前 CLI 选择低显存模式
- 处理解码阶段压力
- 比较单变量实验记录
- 停止扩容并保留恢复点
含 UI/单独 API JSON、原输入、模型清单、校验脚本和真实负例;无权重及本次推理输出。
按官方 0.4 格式整理;仅结构核验,需在你的目标版本实际导入。
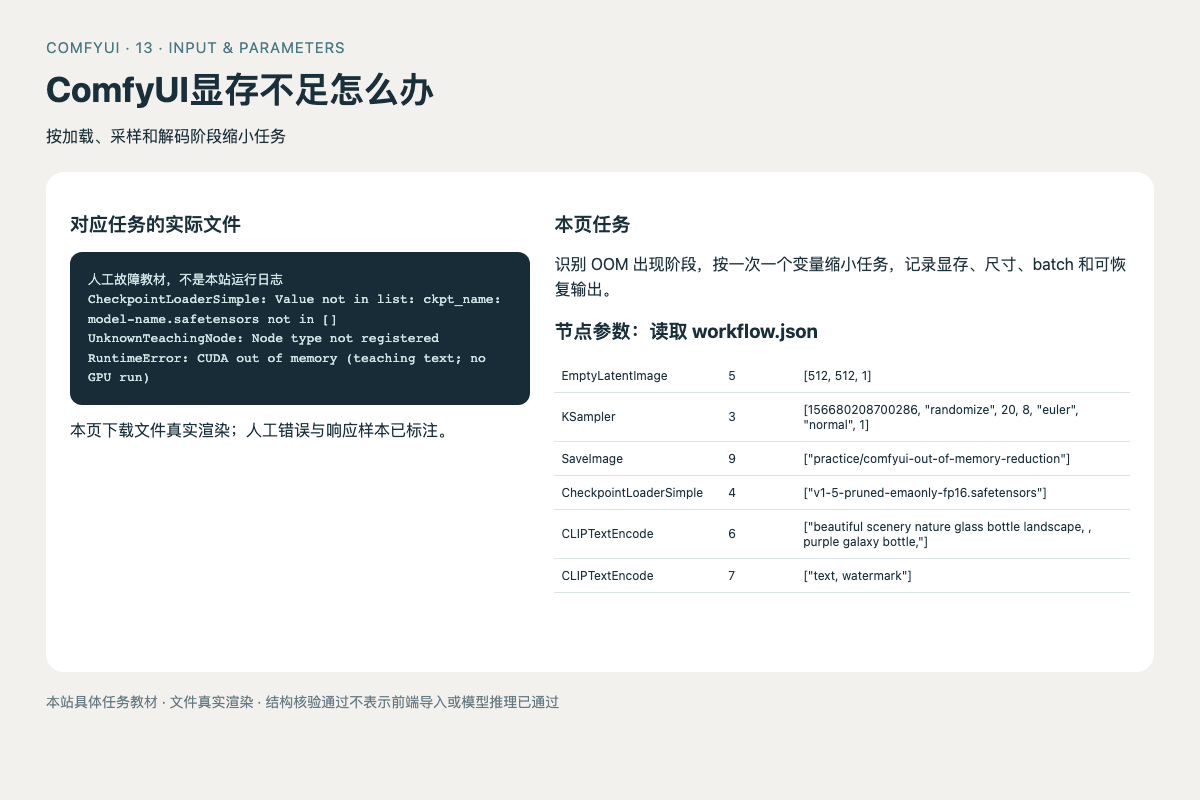
从本页工作流 Loader 字段读取;按官方来源准备兼容权重。
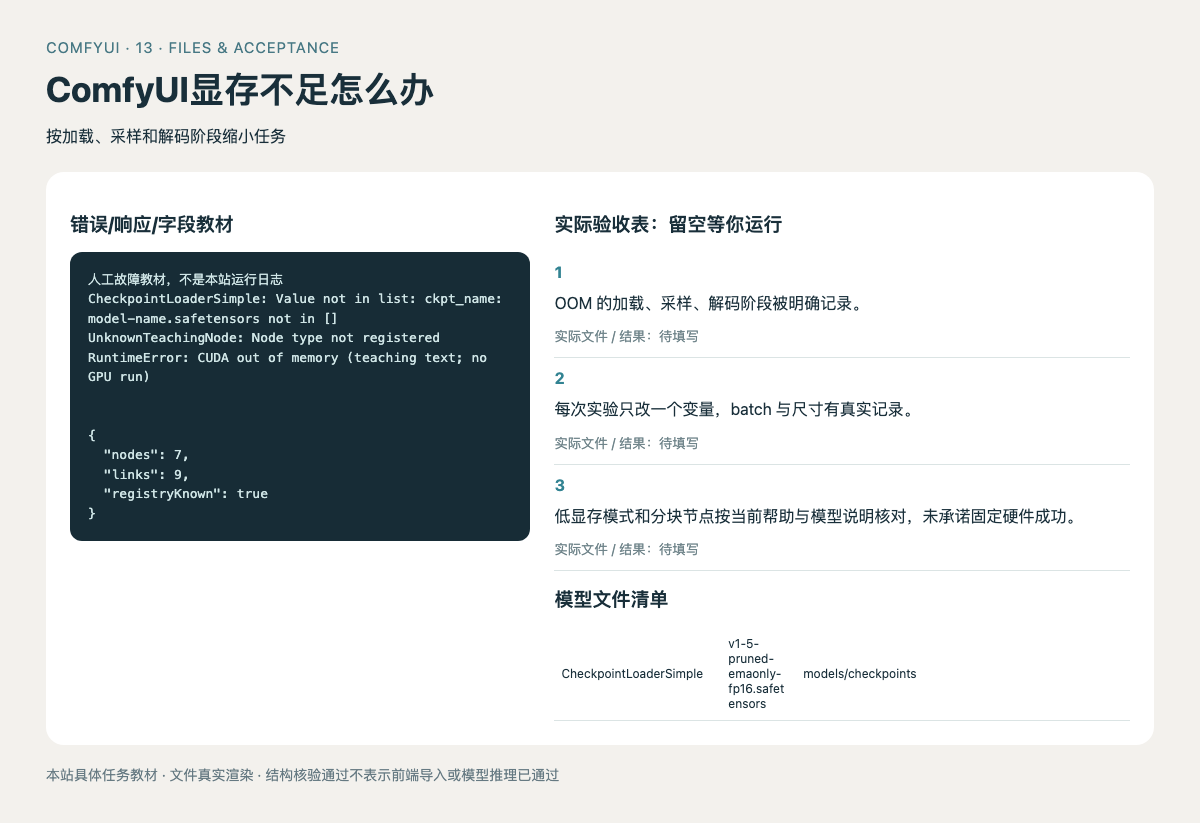
空结果栏,供你填写实际输出与故障;不预填虚构成功结果。
1. 先保存完整错误上下文
阅读 error-log.txt 中的教学 OOM 摘要,再另存自己的真实日志与模型名。记录错误发生在模型加载、KSampler 还是 VAE Decode,保存当前工作流;不要重复向未确认状态的队列提交。
2. 建立最小单图基线
复制 workflow.json 把 batch_size 降到 1、latent 尺寸降到 512×512 或模型官方支持的较小值。尺寸要求由所用模型决定,本页基础 SD1.5 数值不能直接套在所有视频模型。
3. 释放其它占用并重测
检查其它 GPU 应用与残留任务,正常关闭或结束自己确认的任务后重测。不要盲杀未知进程;有 GPU 时使用 nvidia-smi 保存快照,Apple 或 CPU 环境用各自工具记录内存。
4. 按当前 CLI 选择低显存模式
先运行 python main.py --help 核对当前支持参数,再考虑 --lowvram;它可能增加 CPU/RAM 与传输耗时。只启用一个模式并记录,不能保证固定显存容量能运行所有模型。
5. 处理解码阶段压力
若错误明确出现在 VAE Decode,按模型和当前版本确认可用的 VAEDecodeTiled,并保存迁移 JSON。分块解码不能解决此前的模型加载失败;需分别记录峰值与输出接缝。
6. 比较单变量实验记录
在 memory-trials.csv 记录原失败任务、降低 batch、缩小尺寸或模式切换,每行有真实结果和耗时。素材包只提供空验收栏,没有伪造 4GB 或 8GB 成功数值。
7. 停止扩容并保留恢复点
最小任务仍失败时确认系统 RAM、模型家族和权重需求,按官方 CPU 路径评估时间;保存已完成输出和队列状态再重启。不把 --force-fp16 当所有架构通用的无风险开关。
8. 下载工作流、输入和结构检查
完整包包含官方来源 JSON、按本页整理的 UI workflow、单独的 API prompt、真实输入 PNG、模型与参数清单、空验收表、故障负样本和离线脚本。先执行 python check.py,再在自己的 ComfyUI 安装中导入与实际运行。包内权重未下载,结构检查不能替代前端兼容与推理验收。
怎样确认已经完成
- OOM 的加载、采样、解码阶段被明确记录。
- 每次实验只改一个变量,batch 与尺寸有真实记录。
- 低显存模式和分块节点按当前帮助与模型说明核对,未承诺固定硬件成功。
常见问题
lowvram 一开就一定能跑吗?
不能保证。模型、分辨率、batch、系统内存和节点都会影响需求,需从最小任务做实际测量。
把 steps 降低就能解决爆显存吗?
未必。先查看出错阶段,空间尺寸、batch、模型加载与解码缓冲常更相关;耗时与峰值内存应分别记录。