
展开本页目录
开始前准备什么
- 在独立服务端示例项目使用彼此兼容的 ai、@ai-sdk/openai-compatible 和 @openrouter/ai-sdk-provider 版本;先核对 Provider 的 peerDependencies,不能假设它兼容原下载包锁定的 AI SDK 代际。
- 选择一个服务商,并在服务端设置该平台签发的 Key 与它支持的准确模型 ID。原 apizt 下载包不包含 OpenRouter Provider,切换分支前需要自行安装兼容版本。
- 具备可访问所选平台的服务端网络;示例会发起可能计费的模型请求。
- 创建兼容 Provider
- 运行文字样例
- 核对结果与 usage
- 接入服务端
- 增加流式能力
2026-10-23 核验材料;实际执行范围、结果与限制见下方记录。
补充:原有练习资料与下载
服务端 Provider、一次调用、usage 与输出验收。
ai 7.0.130 / Provider 3.0.65 / tsx 4.23.15。
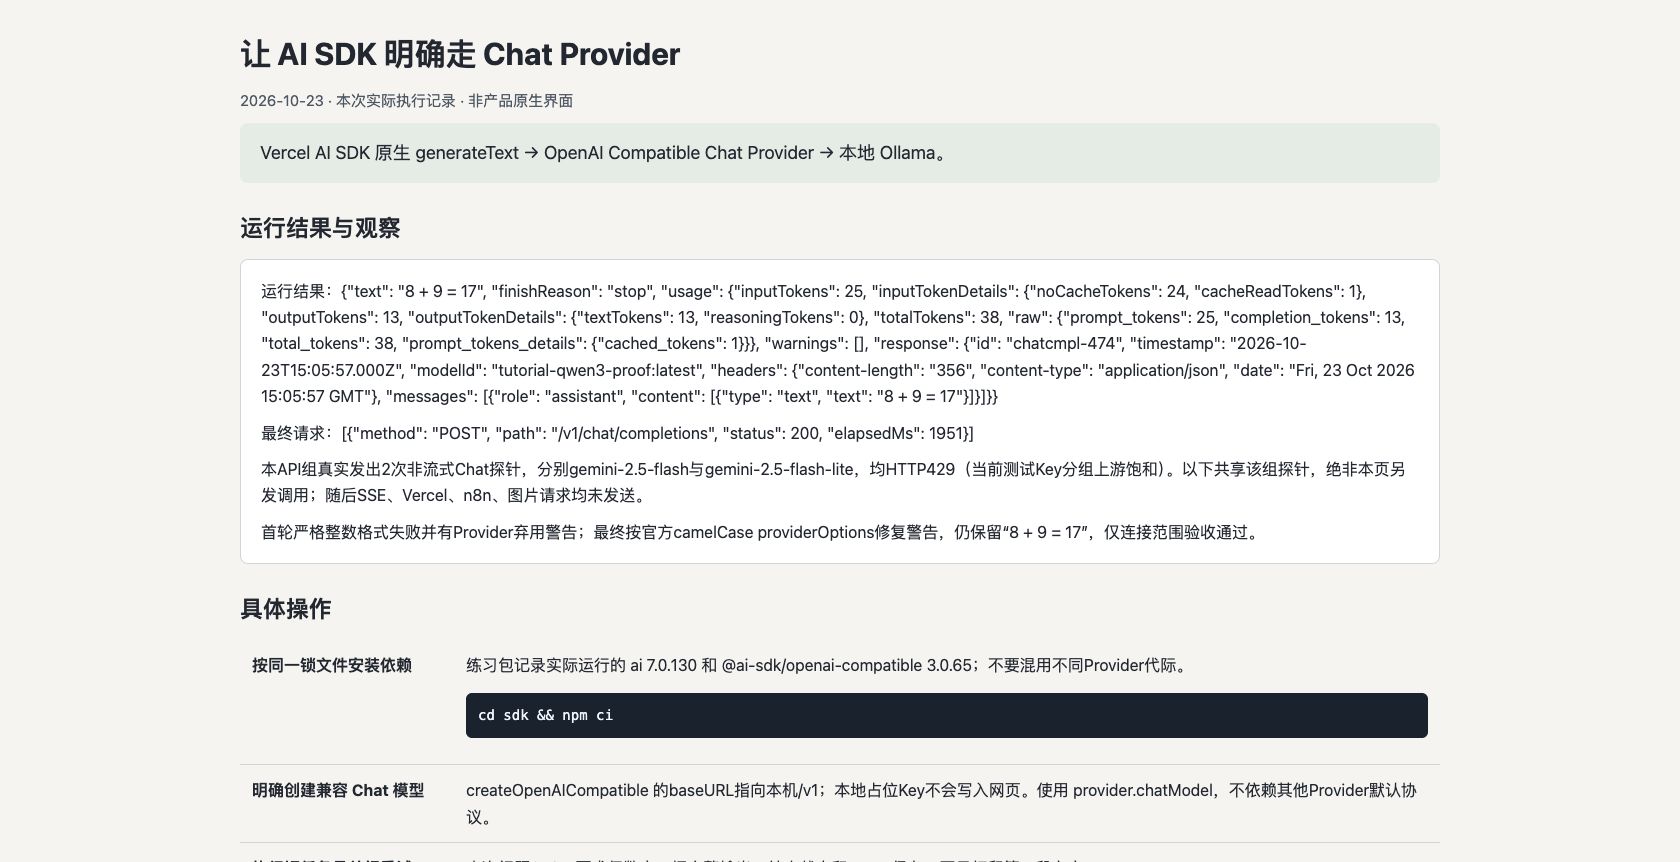
让 AI SDK 明确走 Chat Provider
锁定 ai 7.0.130 与兼容 Provider 3.0.65,在真实本地模型上执行 generateText,并保存最终请求路径、正文、结束原因和 usage。
· Vercel AI SDK 原生 generateText → OpenAI Compatible Chat Provider → 本地 Ollama。
已取得下列真实结果;仍有内容质量或功能范围需要按本页检查项复核。
- 运行环境
- node v24.14.0;ollama 0.40.9;openai 7.43.0;ai 7.0.130;@ai-sdk/openai-compatible 3.0.65
1. 按同一锁文件安装依赖
练习包记录实际运行的 ai 7.0.130 和 @ai-sdk/openai-compatible 3.0.65;不要混用不同Provider代际。
bashcd sdk && npm ci2. 明确创建兼容 Chat 模型
createOpenAICompatible 的baseURL指向本机/v1;本地占位Key不会写入网页。使用 provider.chatModel,不依赖其他Provider默认协议。
3. 执行短任务且关闭重试
本次问题8+9,要求仅数字;把完整输出、结束状态和usage保存,不只打印第一段文字。
bashnode run.mjs ai-sdk ../vercel-ai-sdk-tokenba-api/new-result.json4. 按真实结果验收
最终路径为/v1/chat/completions,真实输出“8 + 9 = 17”并完整stop;仅数字断言未通过。修复Provider弃用配置后,连接验收仅检查非空正文与完整结束,不宣称格式问题已修复。
5. 接回网关前检查本平台配置
更换为对应服务签发的Key与准确模型ID;OpenRouter专用Provider另按官方说明安装,不能把本地演练当其接入成功。
这次实际得到什么
- 运行结果:{"text": "8 + 9 = 17", "finishReason": "stop", "usage": {"inputTokens": 25, "inputTokenDetails": {"noCacheTokens": 24, "cacheReadTokens": 1}, "outputTokens": 13, "outputTokenDetails": {"textTokens": 13, "reasoningTokens": 0}, "totalTokens": 38, "raw": {"prompt_tokens": 25, "completion_tokens": 13, "total_tokens": 38, "prompt_tokens_details": {"cached_tokens": 1}}}, "warnings": [], "response": {"id": "chatcmpl-474", "timestamp": "2026-10-23T15:05:57.000Z", "modelId": "tutorial-qwen3-proof:latest", "headers": {"content-length": "356", "content-type": "application/json", "date": "Fri, 23 Oct 2026 15:05:57 GMT"}, "messages": [{"role": "assistant", "content": [{"type": "text", "text": "8 + 9 = 17"}]}]}}
- 最终请求:[{"method": "POST", "path": "/v1/chat/completions", "status": 200, "elapsedMs": 1951}]
- 本API组真实发出2次非流式Chat探针,分别gemini-2.5-flash与gemini-2.5-flash-lite,均HTTP429(当前测试Key分组上游饱和)。以下共享该组探针,绝非本页另发调用;随后SSE、Vercel、n8n、图片请求均未发送。
- 首轮严格整数格式失败并有Provider弃用警告;最终按官方camelCase providerOptions修复警告,仍保留“8 + 9 = 17”,仅连接范围验收通过。
使用这份结果时注意
- 本批获授权使用既有测试Key,OpenAI SDK两次最小探针均HTTP429:当前测试Key分组上游饱和,随后停止。不能据此声称全站不可用;本地成功不能当作apizt上游或实扣成功。
- 本次只执行generateText非流式;未验证该Provider的图片、语音、OpenRouter或浏览器前端流式部署。
两种Provider的服务端最小请求
在独立服务端项目安装彼此兼容版本的ai、@ai-sdk/openai-compatible与@openrouter/ai-sdk-provider。AI_PROVIDER=openrouter时用OpenRouter分支,否则用apizt;执行会请求模型并可能计费。
provider-check.ts
import { generateText } from "ai";
import { createOpenAICompatible } from "@ai-sdk/openai-compatible";
import { createOpenRouter } from "@openrouter/ai-sdk-provider";

const modelId = process.env.AI_MODEL;
if (!modelId) throw new Error("请填所选平台支持的准确模型ID");
const useOpenRouter = process.env.AI_PROVIDER === "openrouter";
const key = useOpenRouter
  ? process.env.OPENROUTER_API_KEY
  : process.env.tokenba_API_KEY;
if (!key) throw new Error("缺少对应平台的API Key");
const model = useOpenRouter
  ? createOpenRouter({ apiKey: key })(modelId)
  : createOpenAICompatible({
      name: "apizt", apiKey: key,
      baseURL: "https://api.apizt.com/v1",
    }).chatModel(modelId);
const result = await generateText({
  model, prompt: "只回复OK", maxRetries: 0,
  abortSignal: AbortSignal.timeout(30_000),
});
if (!result.text.trim()) throw new Error("未取得有效回答");
console.log(result.text);
使用同一代 SDK 与 Provider
下载 TypeScript 样例和 package 配置,放进独立目录,把 framework-vercel-ai-sdk-package.json 重命名为 package.json。运行 npm install 后生成的 lockfile 一起保存,避免以后无意升级依赖。
当前 ai 7 与兼容 Provider 3 要求 Node.js >=22。不要只升级其中一个包,再照抄旧版 API。tokenba_MODEL 可以覆盖默认 glm-5.3,baseURL 可用 tokenba_BASE_URL 覆盖。
terminal
cp framework-vercel-ai-sdk-package.json package.json
npm install
export tokenba_API_KEY="YOUR_tokenba_API_KEY"
npm start
完整样例:明确选择 Chat 模型
createOpenAICompatible 使用 Chat Completions 兼容格式。chatModel 明确所需的模型接口,避免把其他 OpenAI Provider 的默认 Responses 行为带进来。普通文本成功以后,再按需要单独验证 Responses 迁移或图片模型。
maxOutputTokens=1024 是短任务试跑预算。样例不把供应商 token 数或 reasoning 字段强制改写为官方能力,最终以实际返回和控制台记录验收。
framework-vercel-ai-sdk.ts
import { createOpenAICompatible } from "@ai-sdk/openai-compatible";
import { generateText } from "ai";

async function main() {
  const apiKey = process.env.tokenba_API_KEY;
  if (!apiKey) throw new Error("请设置 tokenba_API_KEY。");
  const provider = createOpenAICompatible({
    name: "apizt",
    apiKey,
    baseURL: process.env.tokenba_BASE_URL ?? "https://api.apizt.com/v1",
    includeUsage: false,
  });
  const result = await generateText({
    model: provider.chatModel(process.env.tokenba_MODEL ?? "glm-5.3"),
    prompt: "用两条要点说明怎样验证一次 API 请求是否完成。",
    maxOutputTokens: 1024,
    maxRetries: 0,
    abortSignal: AbortSignal.timeout(60_000),
  });
  console.log("answer:", result.text);
  console.log("finish_reason:", result.finishReason);
  console.log("usage:", result.usage);
  if (!result.text.trim() || result.finishReason === "length") {
    throw new Error("答案为空或被截断;先检查本次记录,再调整参数。");
  }
}

main().catch((error: unknown) => {
  console.error(error instanceof Error ? error.message : "调用失败。");
  process.exitCode = 1;
});
本站绘制的内容说明图:本页固定兼容 Chat 路径;示例超时终止客户端等待,不保证上游已取消执行或扣费。
把 Key 留在服务端
Next.js 等框架的服务器路由配置与网关 API 配置是两层。前端接到 200 也可能只是流开始,应继续检查结束状态和有效答案。
- Provider 初始化文件只在服务器使用,页面组件调用你自己的服务端路由。
- 生产环境用服务端环境变量保存 Key,不能加 NEXT_PUBLIC_ 或把它写进浏览器 bundle。
- 路由先验证应用用户、限制输入大小与频率,再调用模型;API Key 不能代替你应用的用户鉴权。
- 只记录必要的状态、请求 ID、usage 和耗时。提示词可能含业务资料,避免直接打出完整请求和响应。
- 本页的配置适用于 Node.js 样例;放入其他运行时前,检查 AbortSignal、流式转发与当前 SDK 支持。
接流式时使用完整事件流处理错误
AI SDK 的 textStream 只提供文字片段,不能独自承担错误处理。需要观察错误与结束事件,并收集最终使用量。当前 ai 7 提供 stream 事件流;旧版本示例中的 fullStream 等接口应按你安装的版本核对。
includeUsage 控制是否请求流式 usage,本页基础请求保留 False。开启流式前,先用 SSE 检查工具确认当前通道支持最终 usage;缺失使用量继续标记未知。
streamText · 在已有 provider 后使用
import { streamText } from "ai";

const result = streamText({
  model: provider.chatModel("glm-5.3"),
  prompt: "用两条要点解释请求完成的验收。",
  maxOutputTokens: 1024,
  maxRetries: 0,
  abortSignal: AbortSignal.timeout(60_000),
});
let answer = "";
for await (const part of result.stream) {
  if (part.type === "text-delta") {
    answer += part.text;
    process.stdout.write(part.text);
  }
  if (part.type === "error") throw part.error;
}
const finishReason = await result.finishReason;
console.log("\nfinish_reason:", finishReason);
console.log("usage:", await result.totalUsage);
if (!answer.trim() || finishReason === "length") {
  throw new Error("输出为空或被截断,先核对本次记录。");
}
按任务选择接口,不只替换模型名
| 任务 | AI SDK 接入点 | 还要核对 |
|---|---|---|
| 文字对话 | provider.chatModel + generateText / streamText | 消息与输出字段、流结束状态、usage。 |
| 图片生成或编辑 | provider.imageModel + generateImage | /images/generations 或 /images/edits、参数与文件输入。 |
| 向量 Embedding | provider.embeddingModel + embed | 维度、批量限制、模型权限与索引兼容。 |
| Responses 或内置工具 | 另外选择支持该协议的 Provider 路径 | 网关 /responses、状态保存和工具能力,逐项测试。 |
- 任务
- 文字对话
- AI SDK 接入点
- provider.chatModel + generateText / streamText
- 还要核对
- 消息与输出字段、流结束状态、usage。
- 任务
- 图片生成或编辑
- AI SDK 接入点
- provider.imageModel + generateImage
- 还要核对
- /images/generations 或 /images/edits、参数与文件输入。
- 任务
- 向量 Embedding
- AI SDK 接入点
- provider.embeddingModel + embed
- 还要核对
- 维度、批量限制、模型权限与索引兼容。
- 任务
- Responses 或内置工具
- AI SDK 接入点
- 另外选择支持该协议的 Provider 路径
- 还要核对
- 网关 /responses、状态保存和工具能力,逐项测试。
用版本、实际请求与完整事件定位
| 现象 | 检查项 | 处理方式 |
|---|---|---|
| No such export / 类型不匹配 | ai 与 Provider 是否同代、实际安装版本 | 使用固定 package 文件安装,保存 lockfile。 |
| 401 / 404 | 服务端环境变量、前缀与精确型号 | 核对 URL 与权限,不把 Key 传回浏览器。 |
| 参数不支持 | 当前型号是否接受 max_tokens、温度或其他字段 | 保留最小请求,按错误逐项调整。 |
| 界面只有部分文字 | 是否只读 textStream、是否忽略 error / finish | 检查完整事件流,结束后再标记成功。 |
| 费用出现多条记录 | SDK 重试、应用重试、用户重复点击 | 先关闭重试,加入任务状态与按钮执行锁。 |
| usage 为 undefined | 通道未返回使用量或流式字段未启用 | 保留未知值,对照控制台,不推断零费用。 |
- 现象
- No such export / 类型不匹配
- 检查项
- ai 与 Provider 是否同代、实际安装版本
- 处理方式
- 使用固定 package 文件安装,保存 lockfile。
- 现象
- 401 / 404
- 检查项
- 服务端环境变量、前缀与精确型号
- 处理方式
- 核对 URL 与权限,不把 Key 传回浏览器。
- 现象
- 参数不支持
- 检查项
- 当前型号是否接受 max_tokens、温度或其他字段
- 处理方式
- 保留最小请求,按错误逐项调整。
- 现象
- 界面只有部分文字
- 检查项
- 是否只读 textStream、是否忽略 error / finish
- 处理方式
- 检查完整事件流,结束后再标记成功。
- 现象
- 费用出现多条记录
- 检查项
- SDK 重试、应用重试、用户重复点击
- 处理方式
- 先关闭重试,加入任务状态与按钮执行锁。
- 现象
- usage 为 undefined
- 检查项
- 通道未返回使用量或流式字段未启用
- 处理方式
- 保留未知值,对照控制台,不推断零费用。
本站绘制的内容说明图:对应此页 SDK 的版本、请求、流结束和 usage 四类问题;连接成功与完成一次可用输出分别验收。
本次补测:先完成搜索要解决的问题,再进入下一步
正文两个 Provider 分支与下载包不是同一依赖集合;流式文字与最终 usage 也要分别验收。
新增记录为 apizt Chat SSE 原始流及 Python 消费结果,不证明 AI SDK 的全部 Provider 或流事件已经通过。
- 按下载包固定依赖保存 lockfile;OpenRouter 分支是独立示意,不要直接套到原包。
- 第一轮关闭重试,保留 finishReason 与原始 usage;200不等于完整输出。
- 使用当前安装版本的事件流接口读到结束;usage 缺失时保存 null,并核对控制台。
新增补测结果;与原有原生工具记录分别保存
{
  "live_text": "你好",
  "live_usage": {
    "completion_tokens": 6,
    "completion_tokens_details": {
      "accepted_prediction_tokens": 0,
      "audio_tokens": 0,
      "reasoning_tokens": 0,
      "rejected_prediction_tokens": 0
    },
    "prompt_tokens": 69,
    "prompt_tokens_details": {
      "audio_tokens": 0,
      "cached_tokens": 0
    },
    "total_tokens": 75
  },
  "fixture_usage": null,
  "fixture_usage_status": "unknown"
}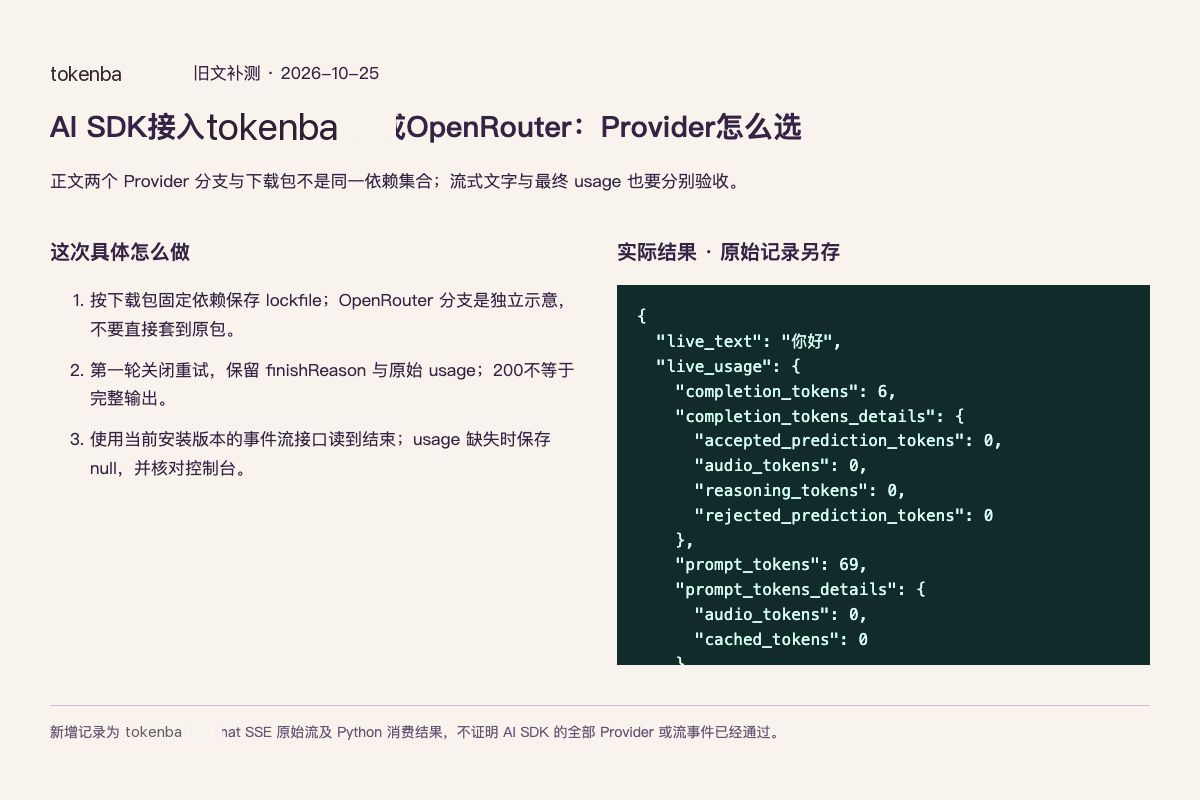
本次实际数据的浏览器执行报告截图,非第三方软件界面;原有配图和缩略图保留。
怎样确认已经完成
- 运行时与固定包版本匹配,样例不暴露 Key。
- 实际调用使用 Chat 端点,输出非空且没有 length 截断。
- UI 只在完整结束且验收通过后显示成功。
- usage 缺失显示未知;模型请求次数与控制台实扣可核对。
常见问题
openrouter ai sdk应该装哪个包?
OpenRouter官方文档使用@openrouter/ai-sdk-provider创建Provider,再传给AI SDK的generateText或streamText。使用OpenRouter签发的Key及它支持的准确模型ID。
apizt可以照搬OpenRouter模型ID吗?
不能假定一致。apizt示例使用兼容Provider和/v1地址,模型ID、权限与端点支持按当前令牌分组核对。
为什么开始流式但最后没有完整答案?
不要只看HTTP 200或第一段文本。按已安装SDK版本处理错误与结束事件,核对最终text和usage;先让非流式最小请求通过。
必须部署到 Vercel 才能用 AI SDK 吗?
不需要。本文是 Node.js TypeScript 示例,AI SDK 可以用于满足其运行时要求的应用。部署平台、服务器网络和流式超时仍要分别检查。
为什么使用 @ai-sdk/openai-compatible?
本页目标是明确的 Chat Completions 兼容请求。官方 OpenAI Provider 的默认协议和供应商专属能力可能不同;选择 Provider 时按真实端点核对,而不是只换 baseURL。
能通过相同的 chatModel 生成图片吗?
不要把文本调用直接交给图片型号。图片使用 imageModel 与图片接口,并单独核对当前通道的尺寸、质量、编辑输入和计费方式。