
展开本页目录
开始前准备什么
- Node.js 20+,服务端环境持有 Key
- 确认模型支持所用协议的 stream 参数
- 先用本地样本验证解析,再发真实请求
- 解析原始事件
- 识别协议内容
- 判定完整或断流
- 记录 usage
支持文件模式与一次真实调用;中文分片、空行边界与终态检查。
先分清网络块、SSE 事件与模型增量
网络一次读取的 chunk 可能包含半个中文字符、半行 JSON,或多个 SSE 事件。chunk 不是一个 JSON 对象,更不是一个 token。先持续 UTF-8 解码,再读取行,最后用空行分隔事件。
SSE 的 data 可以跨多行;注释行以冒号开头,通常作为心跳。代理缓冲也可能让多个增量一起到达,前端应追加文本,而不是把整份回答反复覆盖。
Chat 与 Responses 使用不同完成信号
| 检查点 | Chat Completions | Responses |
|---|---|---|
| 文本增量 | choices[].delta.content | response.output_text.delta |
| 完成判断 | finish_reason 后再检查流结束标记 | response.completed 且 response.status=completed |
| 异常终态 | error、length、缺失结束标记 | error、response.failed、response.incomplete |
| 用量 | include_usage 支持时通常在额外 chunk | 完成事件中的 response.usage |
- 检查点
- 文本增量
- Chat Completions
- choices[].delta.content
- Responses
- response.output_text.delta
- 检查点
- 完成判断
- Chat Completions
- finish_reason 后再检查流结束标记
- Responses
- response.completed 且 response.status=completed
- 检查点
- 异常终态
- Chat Completions
- error、length、缺失结束标记
- Responses
- error、response.failed、response.incomplete
- 检查点
- 用量
- Chat Completions
- include_usage 支持时通常在额外 chunk
- Responses
- 完成事件中的 response.usage
本站绘制的内容说明图:本页协议表比较 Chat 与 Responses;两者文本事件与终止字段不同,不能收到首段就宣布完成。
在服务端运行,无需把 Key 放进网页
下载解析器后,tokenba_PROTOCOL 选 chat 或 responses。文件模式只读本地事件,不访问网络;真实模式发送一次请求,不自动重试。Chat 示例请求 include_usage,若当前渠道拒绝此字段,先核实能力,再明确降级为用量未知。
bash
tokenba_PROTOCOL=chat node developer-sse-reader.mjs --file chat-stream.txt
# 真实调用前,在服务端环境设置 Key 和模型 ID
tokenba_PROTOCOL=responses node developer-sse-reader.mjs
一个能手工核对的 Chat 样本
把下面内容保存为 chat-stream.txt,最后保留空行。正确结果是“你好”,finish_reason=stop,然后收到 [DONE]。删除 [DONE] 后,应报告没有成功终态,不把“你好”当完整答案。
chat-stream.txt
data: {"choices":[{"delta":{"content":"你"},"finish_reason":null}]}

data: {"choices":[{"delta":{"content":"好"},"finish_reason":null}]}

data: {"choices":[{"delta":{},"finish_reason":"stop"}]}

data: [DONE]
本站绘制的内容说明图:本页下载的离线 SSE fixture 只演示“你好”;删去 [DONE] 后,即使文字已出现也不能判定正常结束。
最小消费逻辑:追加文本与区分状态
完整下载版包含跨块 UTF-8 解码、CR/LF 行终止、多行 data、心跳及结尾未完成检测。下面展示应用层处理方式;不要用 response.text() 等待全文来伪装流式。
javascript
for await (const event of parseSse(response.body)) {
  if (event.data === "[DONE]") { terminal = true; continue; }
  const item = JSON.parse(event.data);
  if (item.type === "response.output_text.delta") {
    process.stdout.write(item.delta);
  }
  if (item.type === "response.completed") {
    terminal = item.response.status === "completed";
  }
  if (["error", "response.failed", "response.incomplete"].includes(item.type)) {
    throw new Error("未完成,请保留部分输出并核对请求记录");
  }
}
if (!terminal) throw new Error("流中断,不能标记成功");
用户取消、代理缓冲与断流恢复
用户取消时用 AbortController 结束本地读取,但取消不保证上游立即停止或不计费。保留 attempt ID、已收文本与取消时间,控制台记录用于对账。
若一直等到最后才出现文字,检查自己的应用代理是否缓冲以及是否发送 text/event-stream。若中途断开,先查请求记录;SSE 的 id 或 Last-Event-ID 也不自动意味着模型接口能继续原任务。
把容易漏掉的边界一次测完
- 将中文 UTF-8 字节逐个输入,输出仍应是完整中文。
- 同一网络块里放两个事件,两个都被消费;一条事件跨多个块也能合并。
- 混用 CRLF、LF,含心跳和多行 data,解析结果稳定。
- finish_reason=length、Responses incomplete、非法 JSON、缺终态都进入失败状态。
- usage 缺失显示未知,用控制台补证,不写成 0。
本次补测:先完成搜索要解决的问题,再进入下一步
原合成SSE需要真实完整流与缺usage负例对照,避免把第一段文字当完成。
真实流与本地缺usage反例分开保存;不同协议终态仍按其原生合同核对。
- 先用原文解析器核对网络块与SSE事件边界。
- 保存本次真实 stream-frames 与完整读取后的文字、model、usage。
- 再用明确标注的缺usage样例检查未知分支;取消读取的用量不能补成0。
新增补测结果;与原有原生工具记录分别保存
{
  "live_text": "你好",
  "live_usage": {
    "completion_tokens": 6,
    "completion_tokens_details": {
      "accepted_prediction_tokens": 0,
      "audio_tokens": 0,
      "reasoning_tokens": 0,
      "rejected_prediction_tokens": 0
    },
    "prompt_tokens": 69,
    "prompt_tokens_details": {
      "audio_tokens": 0,
      "cached_tokens": 0
    },
    "total_tokens": 75
  },
  "fixture_usage": null,
  "fixture_usage_status": "unknown"
}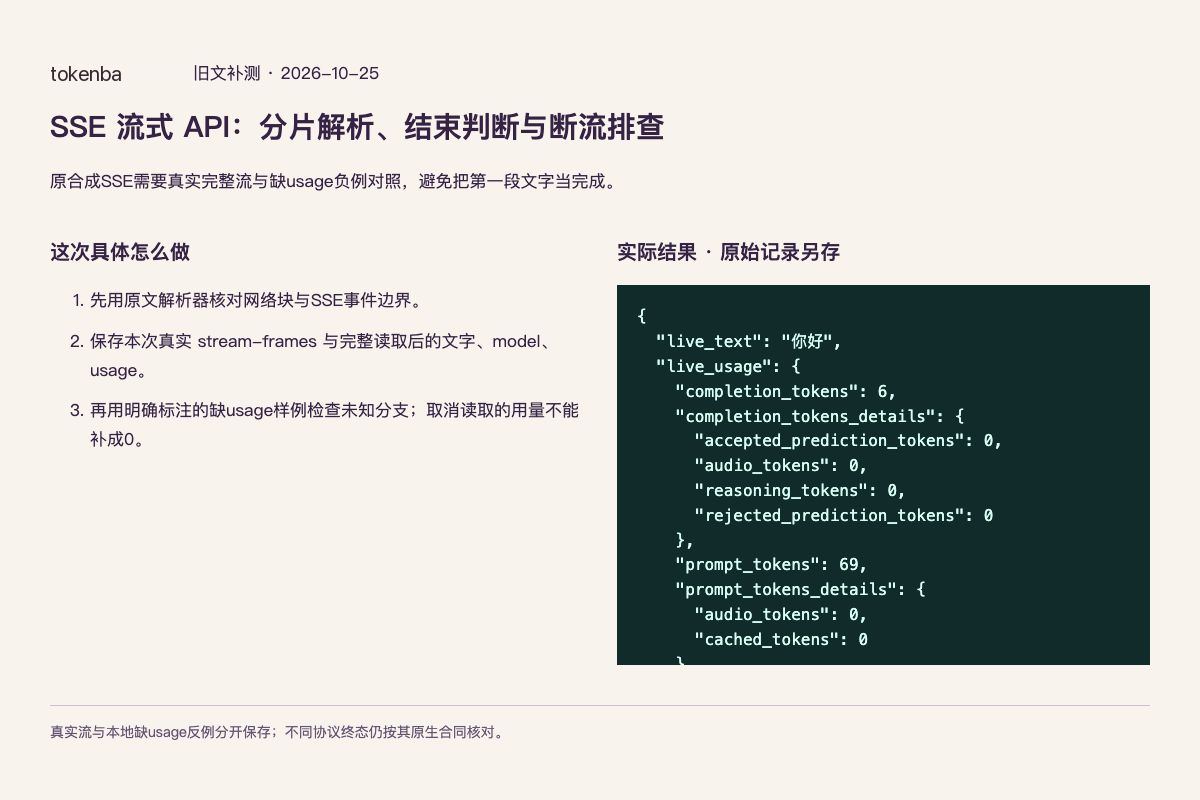
本次实际数据的浏览器执行报告截图,非第三方软件界面;原有配图和缩略图保留。
怎样确认已经完成
- 中文按字节分片仍能正确解码
- 本地样本完整输出你好,删终态后失败
- HTTP 非 2xx 或非 SSE Content-Type 拒绝解析
- 断流不会自动重新发起付费请求
常见问题
流式为什么还是一整段出现?
可能是应用或反向代理缓冲,也可能是读取全文后才更新界面。先检查每个事件的到达时间及代理配置。
SSE id 能直接用于续传吗?
不能由协议字段推断模型服务支持续传。具体接口必须明确提供任务恢复方式,否则先查账再决定重发。