
展开本页目录
开始前准备什么
- 下载完整练习包,在独立目录阅读README与已执行范围。
- 安装requirements.txt指定版本或使用文中目标工具;依赖与模型权重不要混入网站工程。
- 只有明确标为已执行的部分有本次证据;真实模型、账号或GPU步骤按自己的环境另行验证。
- 准备两个不同长前缀
- 划分冷启动、复用和重启三阶段
- 确认HiCache和文件层配置
- 记录冷启动实际计数
- 同进程重复同一前缀
- 重启后验证文件回读
- 交付逐层观测与边界
1. 准备两个不同长前缀
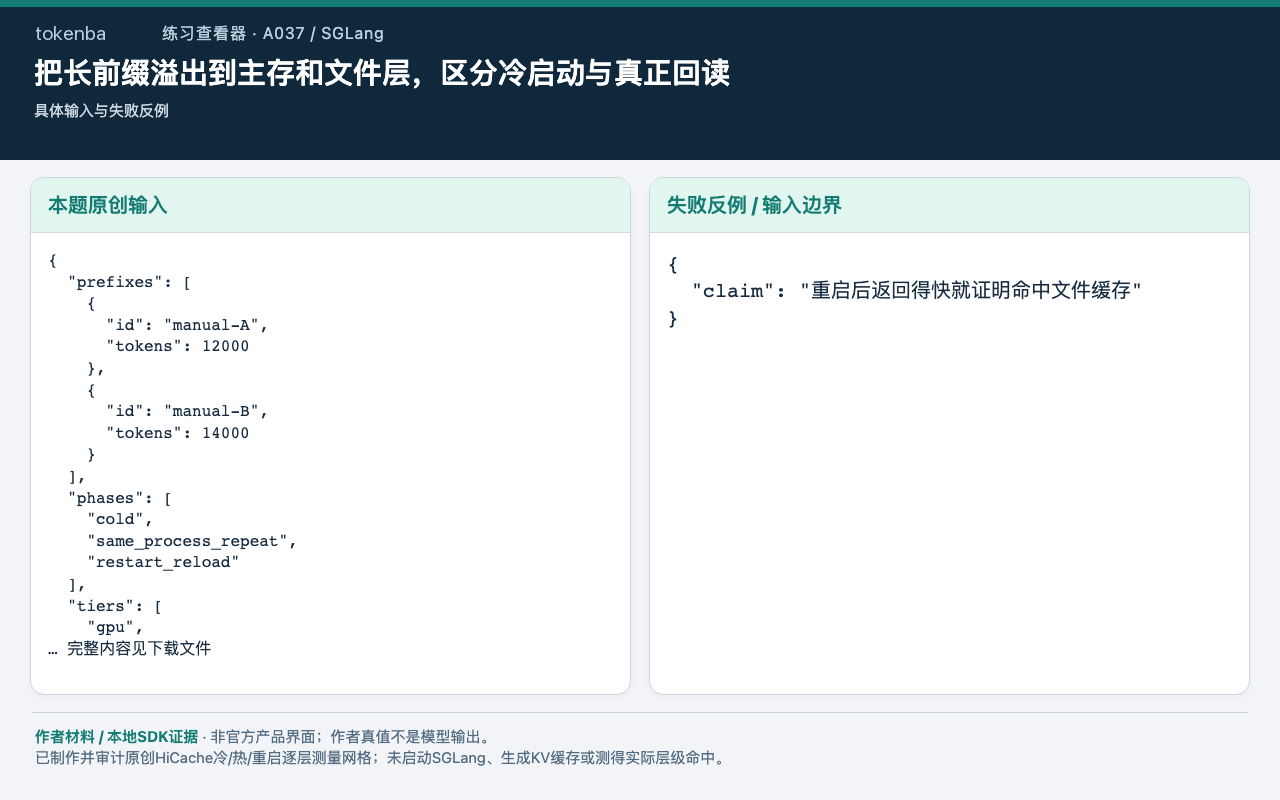
manual-A与B的token长度不同,正文与tokenizer版本固定。不要拿一个短问题声称测到了多层缓存回读。
2. 划分冷启动、复用和重启三阶段
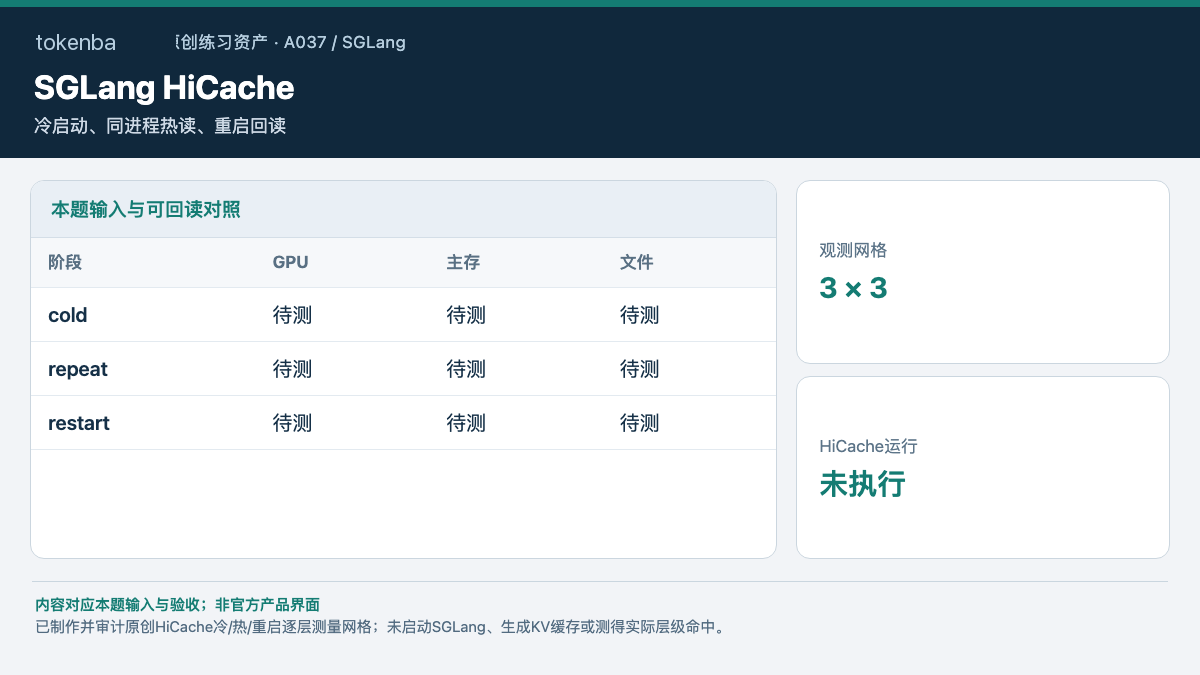
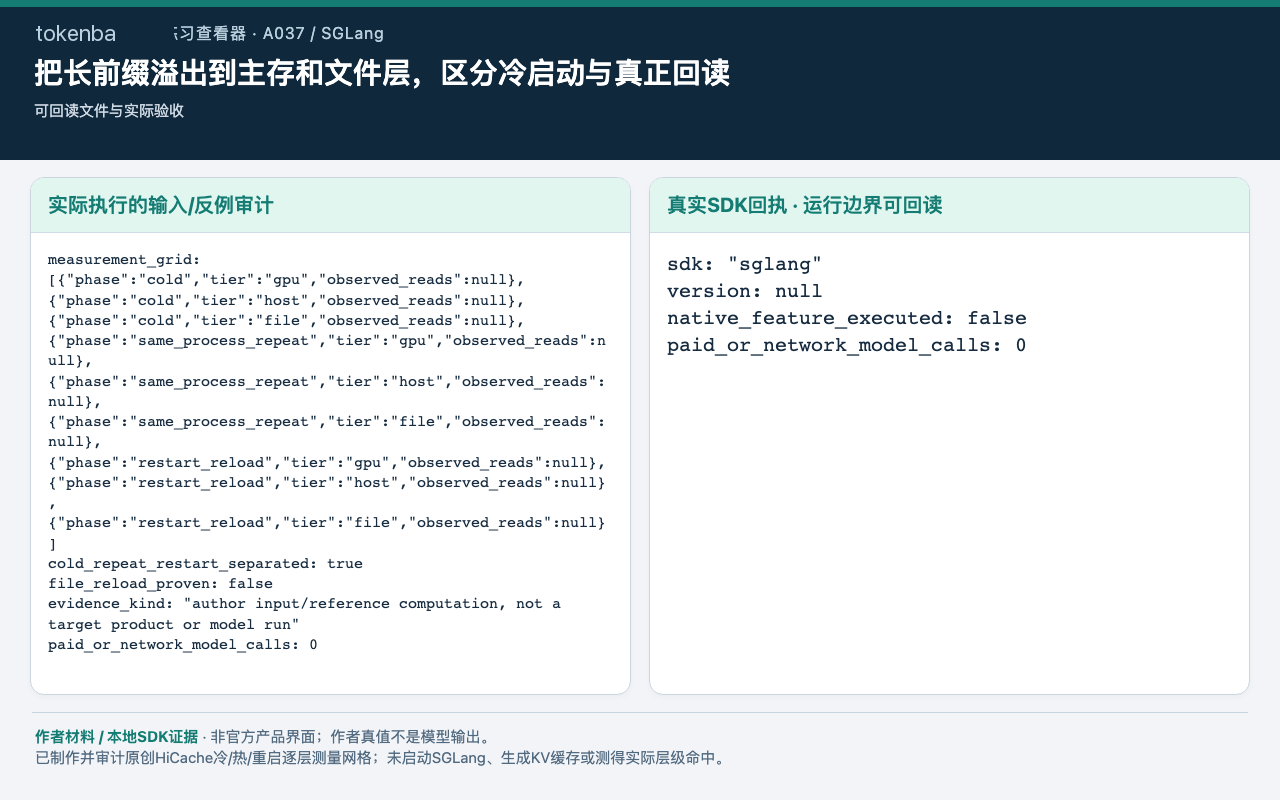
包内生成九格观测表,全部真实读次数为null。作者测量计划没有模拟HiCache命中结果。
本题独立目录执行
bash
python reference/audit.py3. 确认HiCache和文件层配置
在目标SGLang版本检查host容量、存储backend与目录权限;将缓存放专用测试目录,不清理共享线上缓存。
本题SDK或目标环境入口
bash
python reference/run_sdk.py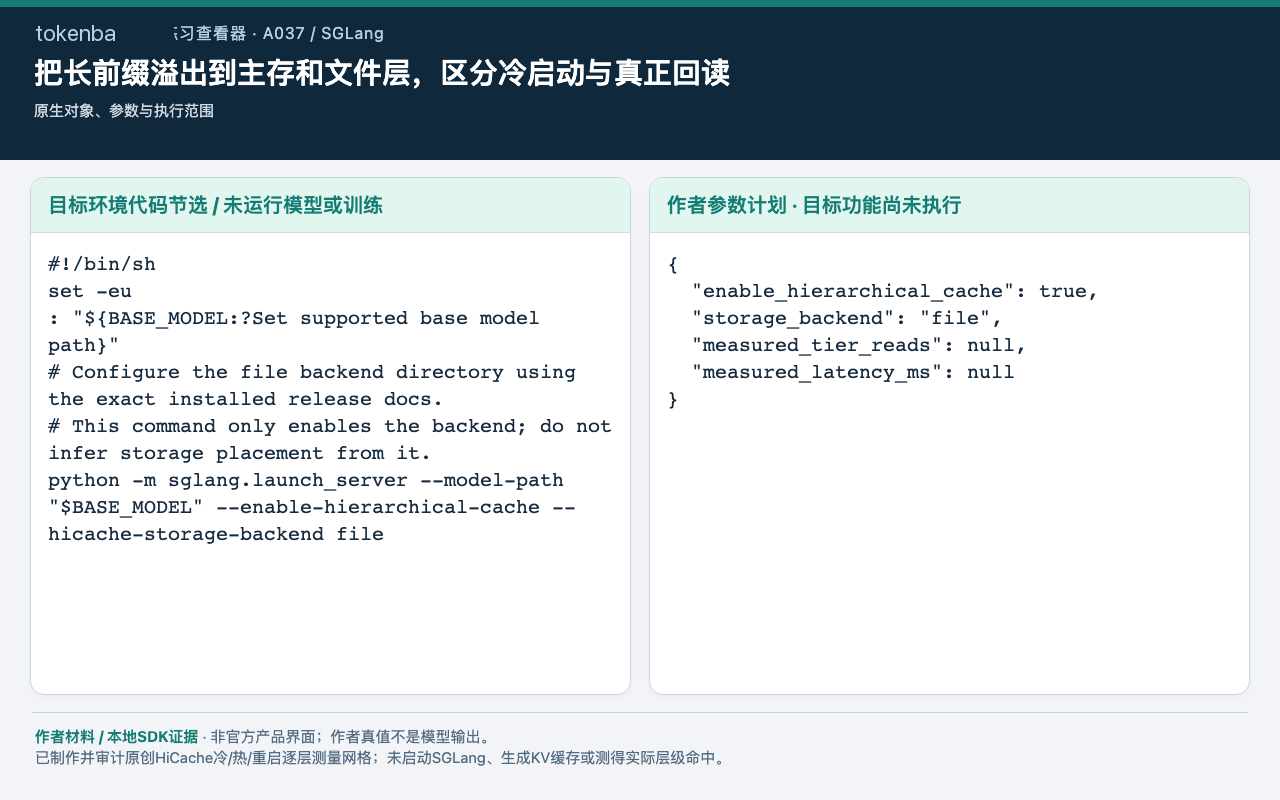
4. 记录冷启动实际计数
先获取各层读写计数与端到端延迟,记录缓存初始状态。GPU内存不足或文件权限错误要保留原始日志。
5. 同进程重复同一前缀
核对哪一层真正命中,不只比较速度;同时记录不同前缀B,避免把全局吞吐波动当成A复用效果。
6. 重启后验证文件回读
按官方流程重启测试服务,检查file→host/GPU实际读计数及配置兼容性。重启后快不能单独证明落盘缓存生效。
7. 交付逐层观测与边界
保留配置、冷/热/重启指标与失败日志。当前包只审计测量网格,没有运行SGLang服务或生成缓存文件。
怎样确认已经完成
- 必须真实触发各层
- 冷暖请求顺序可复现
- 不能套论文加速比
- 已制作并审计原创HiCache冷/热/重启逐层测量网格;未启动SGLang、生成KV缓存或测得实际层级命中。
常见问题
SGLang HiCache怎么把KV缓存放到主存和文件层?
启用目标版本HiCache并分别配置host容量与文件backend/专用目录,先看实际版本支持。包内只提供目标命令与测量网格。
长前缀重发后,怎么判断是GPU命中还是从存储回读?
分别记录cold、同进程repeat和restart的GPU/host/file读写计数,不能仅靠延迟猜来源。本包各层观测均未测。
这篇教程哪些步骤已经真正执行?
已制作并审计原创HiCache冷/热/重启逐层测量网格;未启动SGLang、生成KV缓存或测得实际层级命中。