
展开本页目录
开始前准备什么
- 下载完整练习包,在独立目录阅读README与已执行范围。
- 安装requirements.txt指定版本或使用文中目标工具;依赖与模型权重不要混入网站工程。
- 只有明确标为已执行的部分有本次证据;真实模型、账号或GPU步骤按自己的环境另行验证。
- 把共同问题单独保存
- 审计正负回答与模板一致
- 用同一真实tokenizer套模板
- 构建DPO数据集与配置
- 检查截断与空回答
- 在目标环境训练并留pair级证据
- 交付配对、模板与失败清单
1. 把共同问题单独保存
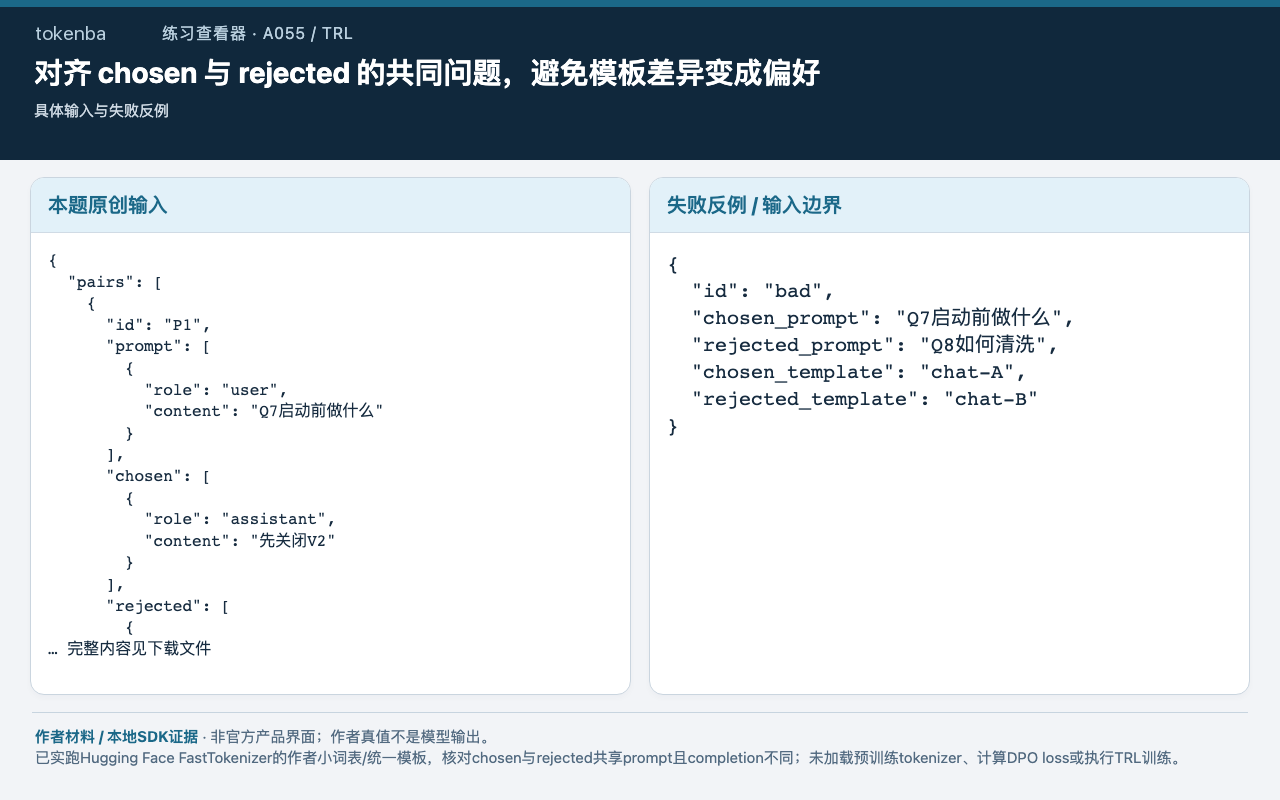
每个pair只存一份prompt,chosen/rejected只放助手回答。这样不会把两个不同问题误组成偏好样本。
2. 审计正负回答与模板一致
audit.py检查角色及共同prompt,负例故意Q7/Q8问题不同且模板不同。作者合同通过不代表tokenize后长度和前缀仍正确。
本题独立目录执行
python reference/audit.py3. 用同一真实tokenizer套模板
对两边使用同一chat_template和特殊token配置,保存token IDs与共享前缀长度。不要把模板差异学成“更喜欢哪种格式”。
本题SDK或目标环境入口
python reference/run_sdk.py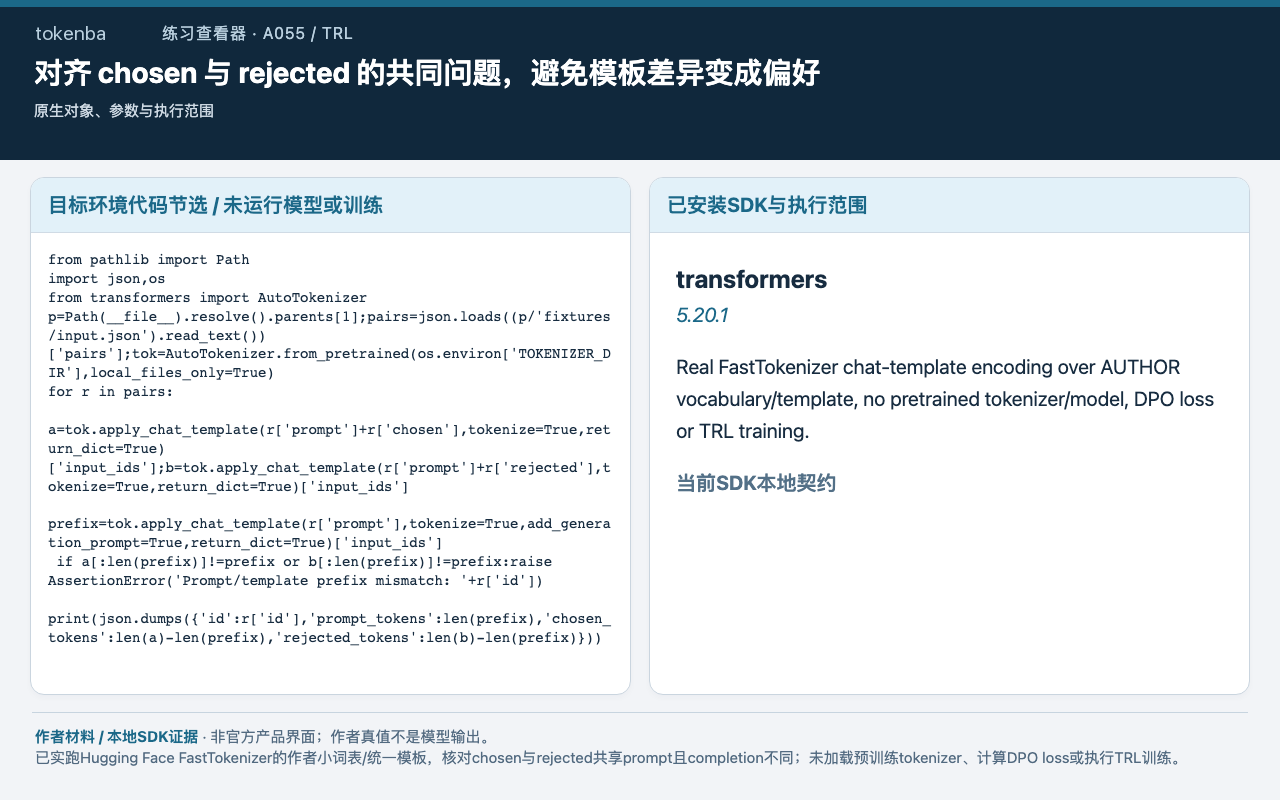
4. 构建DPO数据集与配置
按当前TRL支持的显式prompt/偏好格式导入,固定模型与参考模型设置。不要提前把chosen/rejected拼成无法分辨的单文本。
5. 检查截断与空回答
确认max_length/max_prompt_length等配置未把两边不同内容截没,也没有把共同问题混入completion loss。版本参数变更要读安装版签名。
6. 在目标环境训练并留pair级证据
记录真实loss、chosen/rejected logps和任务质量;作者认为chosen更好并不保证训练后模型学到事实。
7. 交付配对、模板与失败清单
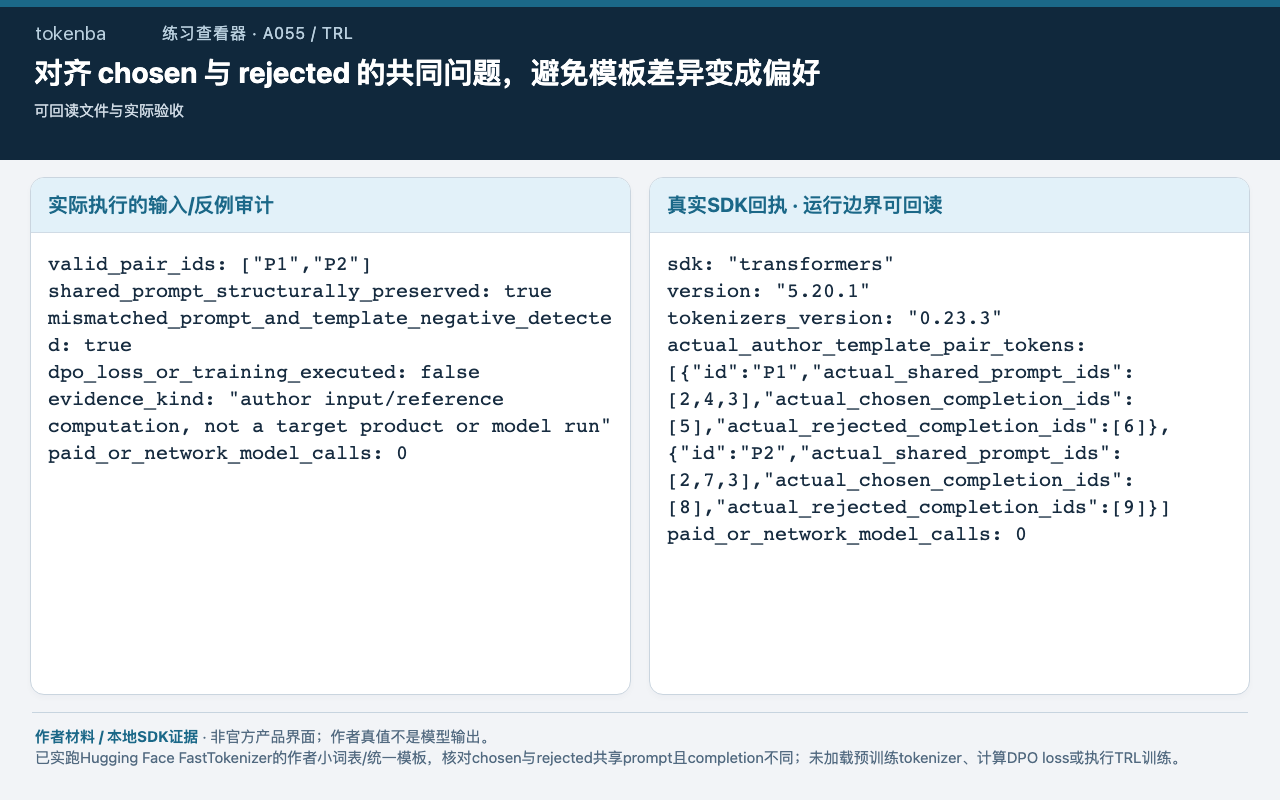
本包包含可直接审计JSONL及错配反例,没有TRL训练或伪造DPO损失;目标环境的tokenized pair与模型结果需另附。
怎样确认已经完成
- 拒绝项不能含不同问题
- 不把loss下降等同质量提升
- 保留独立留出题
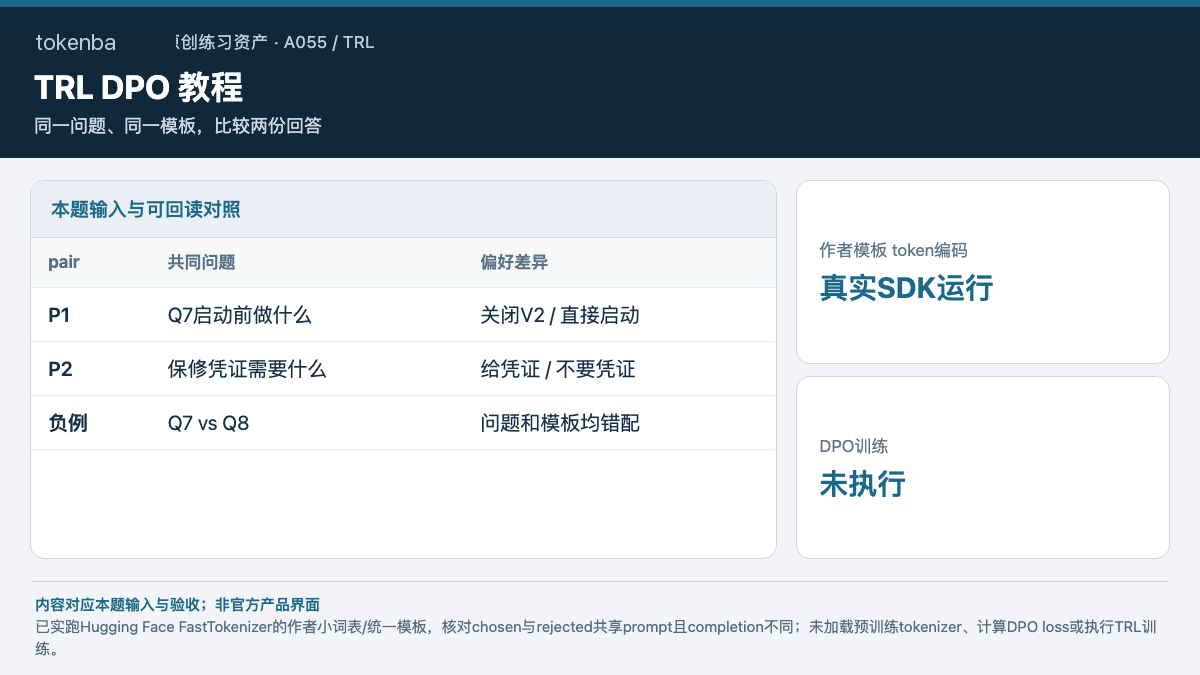
- 已实跑Hugging Face FastTokenizer的作者小词表/统一模板,核对chosen与rejected共享prompt且completion不同;未加载预训练tokenizer、计算DPO loss或执行TRL训练。
常见问题
TRL DPO的chosen和rejected数据怎么对齐?
显式共享一份prompt,chosen/rejected只放助手回答,同模板编码后检查两边前缀一致、completion不同。真实作者FastTokenizer编码已运行。
偏好训练怎么避免聊天模板不同变成虚假偏好?
固定tokenizer、chat_template和特殊token,比较实际token前缀及截断;模板差异不能当回答偏好。本文没加载预训练tokenizer或训练DPO。
这篇教程哪些步骤已经真正执行?
已实跑Hugging Face FastTokenizer的作者小词表/统一模板,核对chosen与rejected共享prompt且completion不同;未加载预训练tokenizer、计算DPO loss或执行TRL训练。