
展开本页目录
开始前准备什么
- 下载到独立练习目录,先运行材料校验,再连接自己的翻译服务。
- 准备 Python 与对应工具的隔离环境;PDF 检查使用 Poppler,翻译版本分别记录。
- 原文均为原创练习材料;密钥只填在本机,不写入下载文件或截图。
- 比较两份相同内容的 PDF
- 核对主仓库而非 Next
- 从功能提交安装对应 extra
- 先跑一页原生文字
- 记录普通路径与快路径
- 解释计时而非重复相加
- 保存版面与取舍
原创 PDF/CSV/EPUB/HTML、逐步说明、校验脚本与真实离线记录;不含模型译文。
对应本页操作、工具边界与验收范围。
本页截图使用的原始文档。
读取真实材料与文件结构;不请求模型、不读取凭证。
当前材料与脚本的实际运行结果。
本页专用练习材料;运行范围见 README。
本页专用练习材料;运行范围见 README。
1. 比较两份相同内容的 PDF
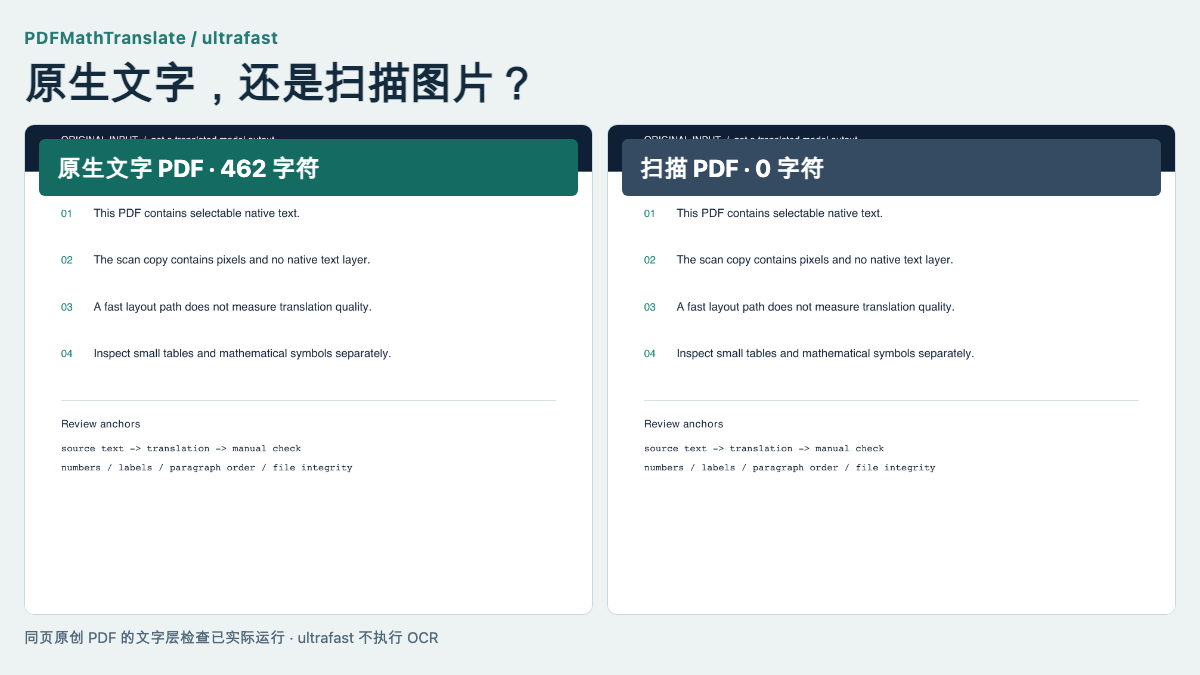
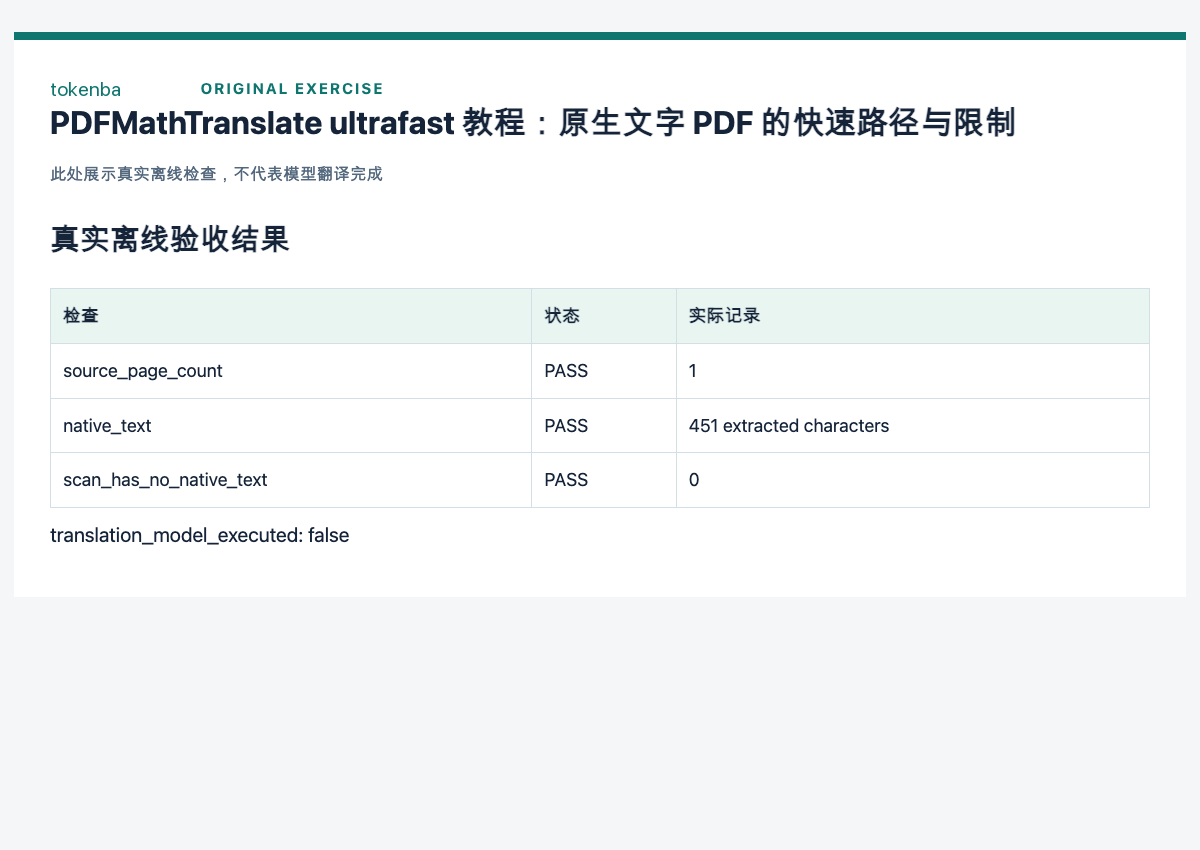
练习包 source.pdf 有文字层,scan.pdf 是由该页栅格化后制作的图片 PDF。逐页提取文本,再决定能否用 ultrafast;不是只凭文件扩展名。
bash
pdftotext source.pdf native.txt
pdftotext scan.pdf scan.txt
python3 verify.py
2. 核对主仓库而非 Next
ultrafast 是 PDFMathTranslate 主仓库 2026-10-02 记录的新路径。2026-10-14 查询 PyPI 的 pdf2zh 仍为 1.9.11,不能由版本号推断已包含 main 的新功能;本页改为固定官方提交 7b57f11ac04409aaac1aba141d0882619cb689b3。该提交源码已核对,但本机未安装该翻译环境。
bash
pdf2zh --version
pdf2zh --help
3. 从功能提交安装对应 extra
官方指定 pdf-inspector>=1.25.2,<2。以下在独立 Python 3.12 环境从固定 Git 提交安装 ultrafast extra;不是承诺 PyPI 1.9.11 含此功能。安装需要 Git 与网络,本教材只核对源码,没有执行依赖安装或模型调用。
bash
python3.12 -m venv .venv
.venv/bin/python -m pip install "pdf2zh[ultrafast] @ git+https://github.com/PDFMathTranslate/PDFMathTranslate.git@7b57f11ac04409aaac1aba141d0882619cb689b3"
.venv/bin/pdf2zh --version
.venv/bin/pdf2zh --help
4. 先跑一页原生文字
选已有可用翻译服务,只对 source.pdf 运行。该路径跳过 ONNX 和 OCR,不能与 --mode precise、--babeldoc、GUI、server 或 --onnx 混用。
bash
mkdir -p output-fast
.venv/bin/pdf2zh source.pdf --ultrafast -li en -lo zh -t 2 -o output-fast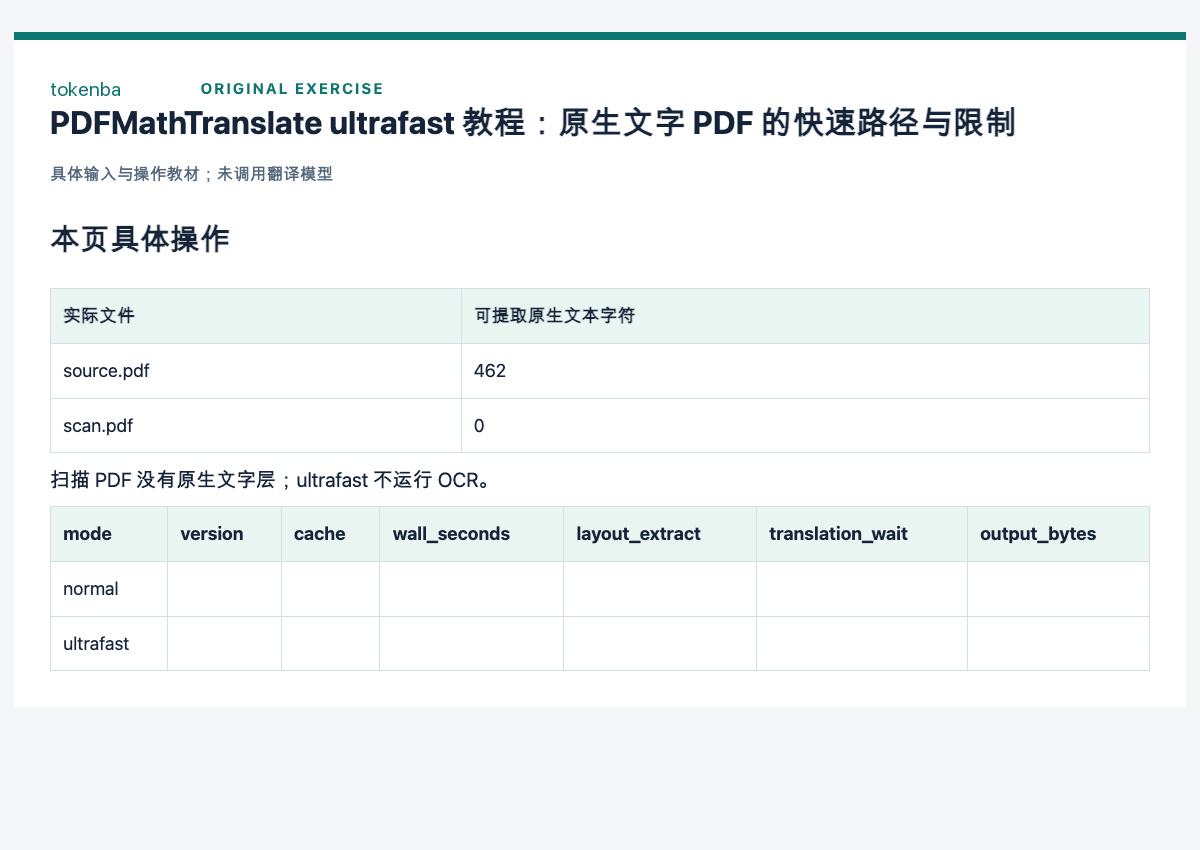
5. 记录普通路径与快路径
以同一输入、服务、并发和缓存条件运行普通模式。两次 API/模型运行均需自行执行;time-template.csv 只有待填写列,教材未给出编造的速度倍数。
bash
mkdir -p output-normal
.venv/bin/pdf2zh source.pdf -li en -lo zh -t 2 -o output-normal
6. 解释计时而非重复相加
记录官方 [ultrafast perf] 日志的 layout_extract、page_scan 和 translation;嵌套的 page_processing 含子阶段,不重复求和。比较整体墙钟、缓存状态、API 重试和页面差异。
7. 保存版面与取舍
对齐两个输出的同一页,检查细表格、公式、空格和字体。ultrafast 不做字体子集化,文件可能更大;扫描页会保留,不能由“命令成功”推断已 OCR。
怎样确认已经完成
- source.pdf 有原生文本而 scan.pdf 无文字层,离线脚本确实区分两者。
- 安装版本提供 --ultrafast,命令没有和 GUI/precise/BabelDOC 选项混用。
- 性能表由实际两次运行填写;不存在预设加速比例或假计时。
常见问题
ultrafast 能给扫描件补文字吗?
不能。官方说明该路径跳过 OCR;没有原生文字的页会保留。扫描件应走正常模式的实验 OCR 或单独 OCR 后复查。
为什么文件变大了?
该模式自动跳过字体子集化,输出体积可能增大。应同时记录文件大小和可读性,不只比较速度。