
展开本页目录
开始前准备什么
- 下载到独立练习目录,保留原始输入副本。
- 模型步骤使用自己的已验证配置;离线检查不需要 API Key。
- 先阅读 README 中的运行范围;练习数据均为原创。
- 准备有层级的说明书
- 按官方参数准备独立环境
- 先解析再分块
- 检查标题与文档引用
- 检查全文覆盖
- 读取文件检查而非只看截图
- 保存来源与错误样本
原创输入、可运行脚本、预期对照、截图原始 HTML 与验证记录。
对应本页任务与验证范围。
与原始 HTML 对应的带文字层 PDF。
章节、段落或表格验收条件。
关闭 OCR,但版面模型仍需环境准备。
读取输出文件检查顺序、空值与原文覆盖。
本次真实转换,保留原文项目与来源坐标。
与人工 expected.json 分开;可能有版面误判。
真实 HierarchicalChunker 输出,未人工改动。
CPU、无 OCR、Heron、Fast 设置及输入 SHA。
按 PDF 修正 headings;保留原 self_ref 和页码。
明确展示原 PDF 核对后的 ref→章节映射。
原始失败与审核后检查分开记录。
1. 准备有层级的说明书
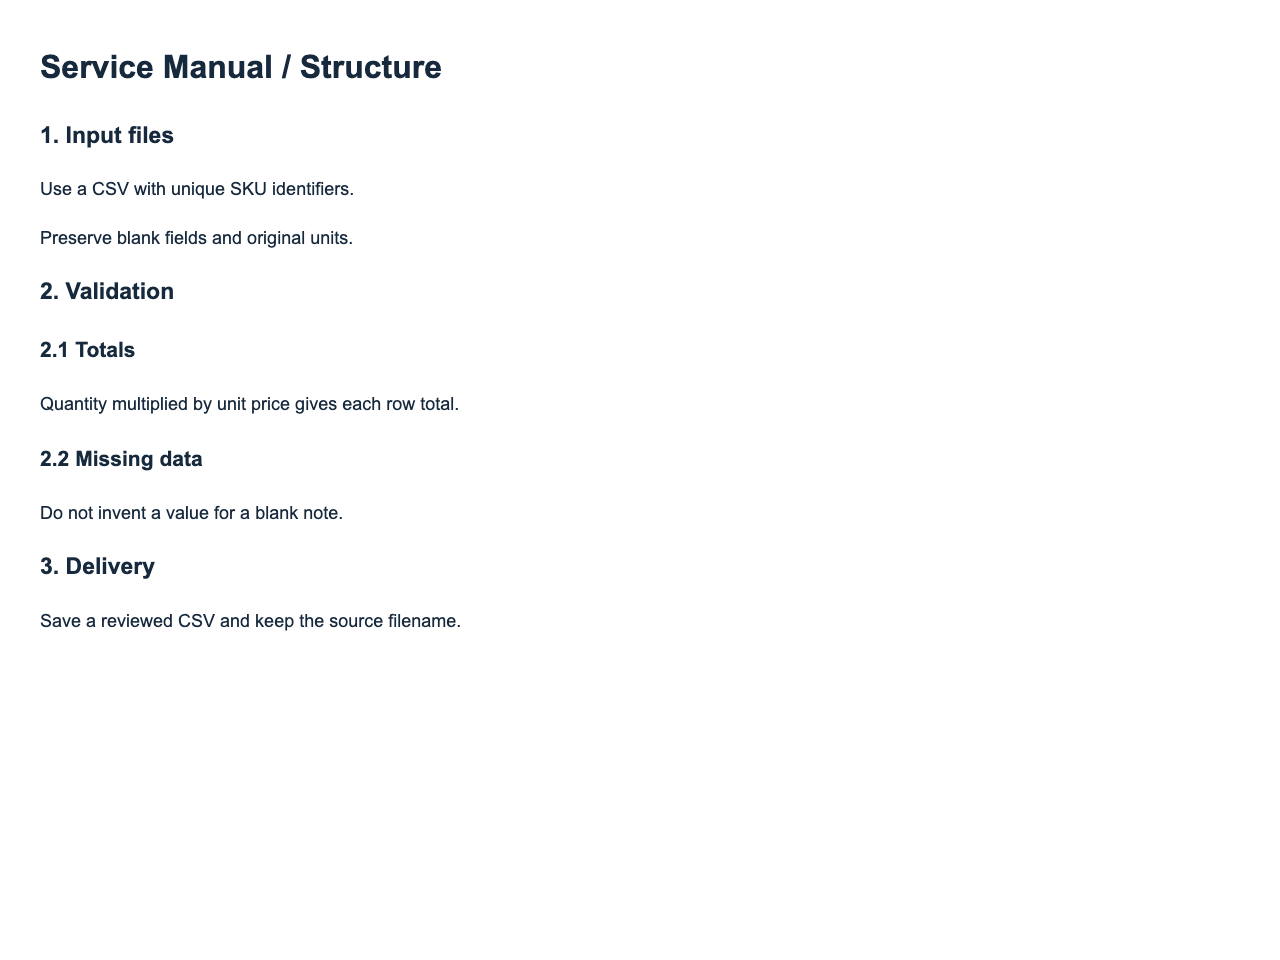
source.pdf 包含三个一级任务与 Validation 下两个子项;expected.json 固定五段正文与标题。
2. 按官方参数准备独立环境
转换并运行 HierarchicalChunker 后保留 document.json、result.md 与 chunks.json。本次实际把 Totals 和 Delivery 判成 list_item;结构分块会沿用这种错误分类,正文完整不代表章节正确。
3. 先解析再分块
run-docling.py 先生成 document.json,然后对该文档运行 HierarchicalChunker,保存 chunks.json。
bash
# 与本页保存的 Fast 实测一致
python3 run-docling.py --fast
4. 检查标题与文档引用
比较实际 chunks 的 headings 与 PDF 章节。原始 Delivery 正文错误归在 2.2 Missing data 下;review-chunks.py 用人工核对的 self_ref→章节映射另存 reviewed-chunks.json,不改模型原始文档。
5. 检查全文覆盖
审核脚本保留原文本、文档 self_ref 和页码。check-output.py 读取 document.json 逐一解引用,检查五段正文与全部章节;原始 chunks 缺少章节会失败,审核版通过。
6. 读取文件检查而非只看截图
同时保留原始失败与人工审核成功记录。章节误判需对照原文处理,不能根据模型猜新标题或仅靠全文关键词验收。Docling 实际解析正文完整,但 2.1 Totals 与 3. Delivery 被标为 list_item,原始 chunks 缺少对应 headings。已按原 PDF 人工补核章节上下文,审核版通过;原始模型结构未改动。
bash
python3 check-output.py chunks.json
python3 review-chunks.py
python3 check-output.py reviewed-chunks.json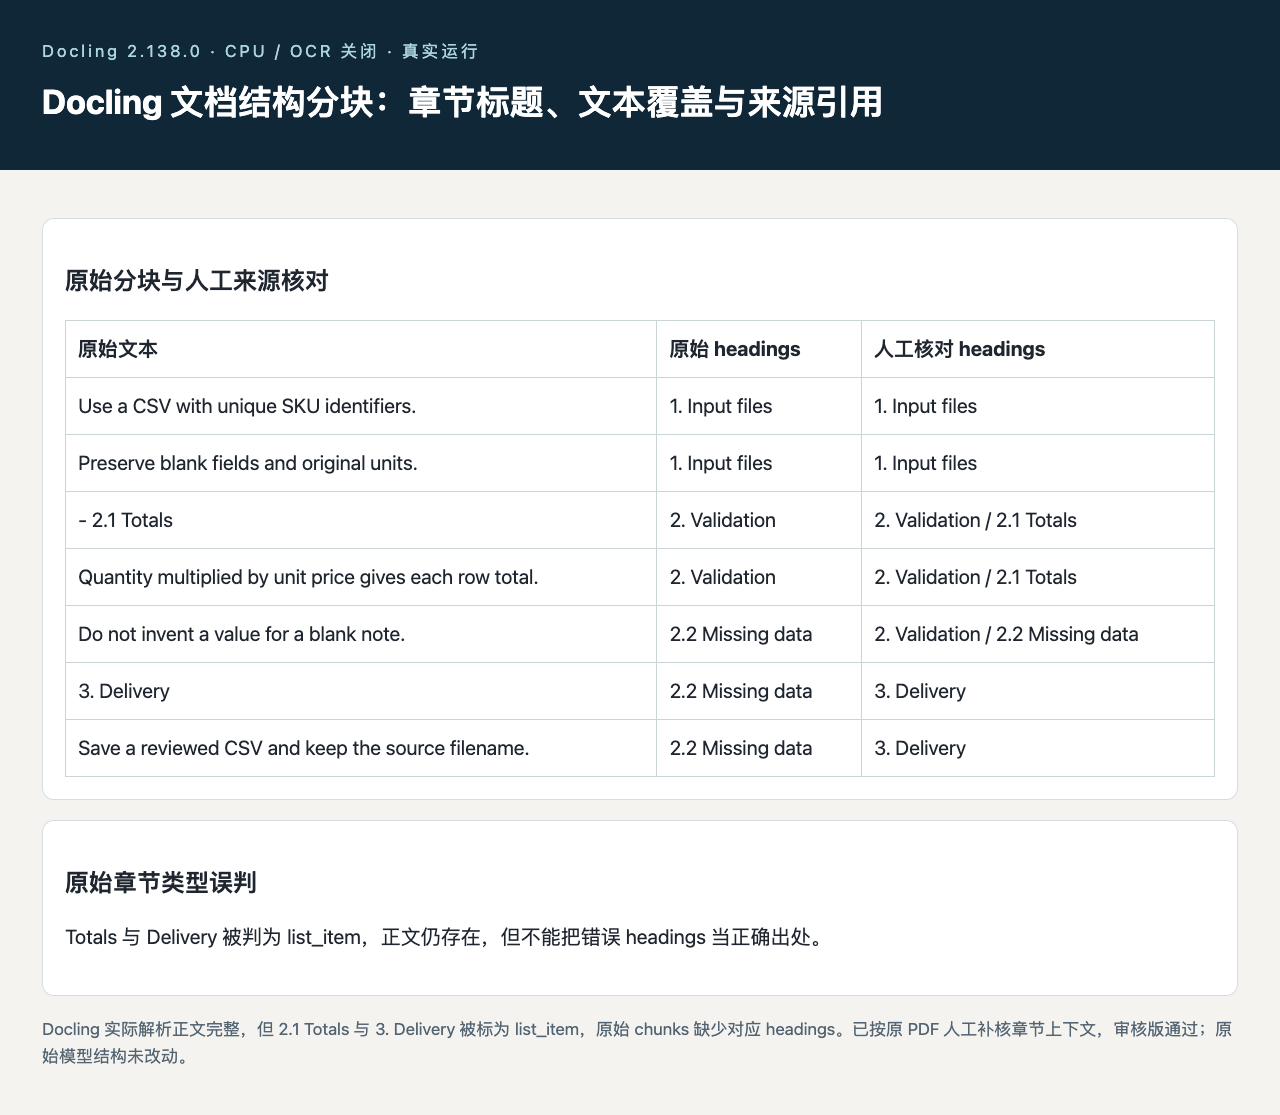
7. 保存来源与错误样本
保留 source.pdf/source.png、原始 JSON、软件版本和人工核对记录。自动结构检查只验证本教材约定,仍需检查布局与语义。
怎样确认已经完成
- 文字、数字与原输入逐项对应,人工预期和实际运行输出分开。
- 输出来源可以回查原图/PDF;漏行、错序、空格位移不能忽略。
- Docling 实际解析正文完整,但 2.1 Totals 与 3. Delivery 被标为 list_item,原始 chunks 缺少对应 headings。已按原 PDF 人工补核章节上下文,审核版通过;原始模型结构未改动。
常见问题
可以把人工预期当识别结果下载吗?
不可以。expected.json 是核对基准;只有实际工具运行得到的 output/document.json 才是本次推理输出,必须分别保存。
结构检查通过代表所有内容正确吗?
不代表。脚本只验证约定的文字、顺序、字段与来源,真实文档中的版面、标点、表格合并格和其他语义仍要对照原文。