
展开本页目录
开始前准备什么
- 下载到独立练习目录,先运行材料校验,再连接自己的翻译服务。
- 准备 Python 与对应工具的隔离环境;PDF 检查使用 Poppler,翻译版本分别记录。
- 原文均为原创练习材料;密钥只填在本机,不写入下载文件或截图。
- 先确认确实没有文字层
- 核对实验 OCR 支持
- 从对应提交安装 OCR extra
- 真实复现本地识别练习
- 运行 pdf2zh 正常 fast 路径
- 把识别错误与译文错误分开
- 只重做有问题的页
原创 PDF/CSV/EPUB/HTML、逐步说明、校验脚本与真实离线记录;不含模型译文。
对应本页操作、工具边界与验收范围。
本页截图使用的原始文档。
读取真实材料与文件结构;不请求模型、不读取凭证。
当前材料与脚本的实际运行结果。
本页专用练习材料;运行范围见 README。
本页专用练习材料;运行范围见 README。
本页专用练习材料;运行范围见 README。
1. 先确认确实没有文字层
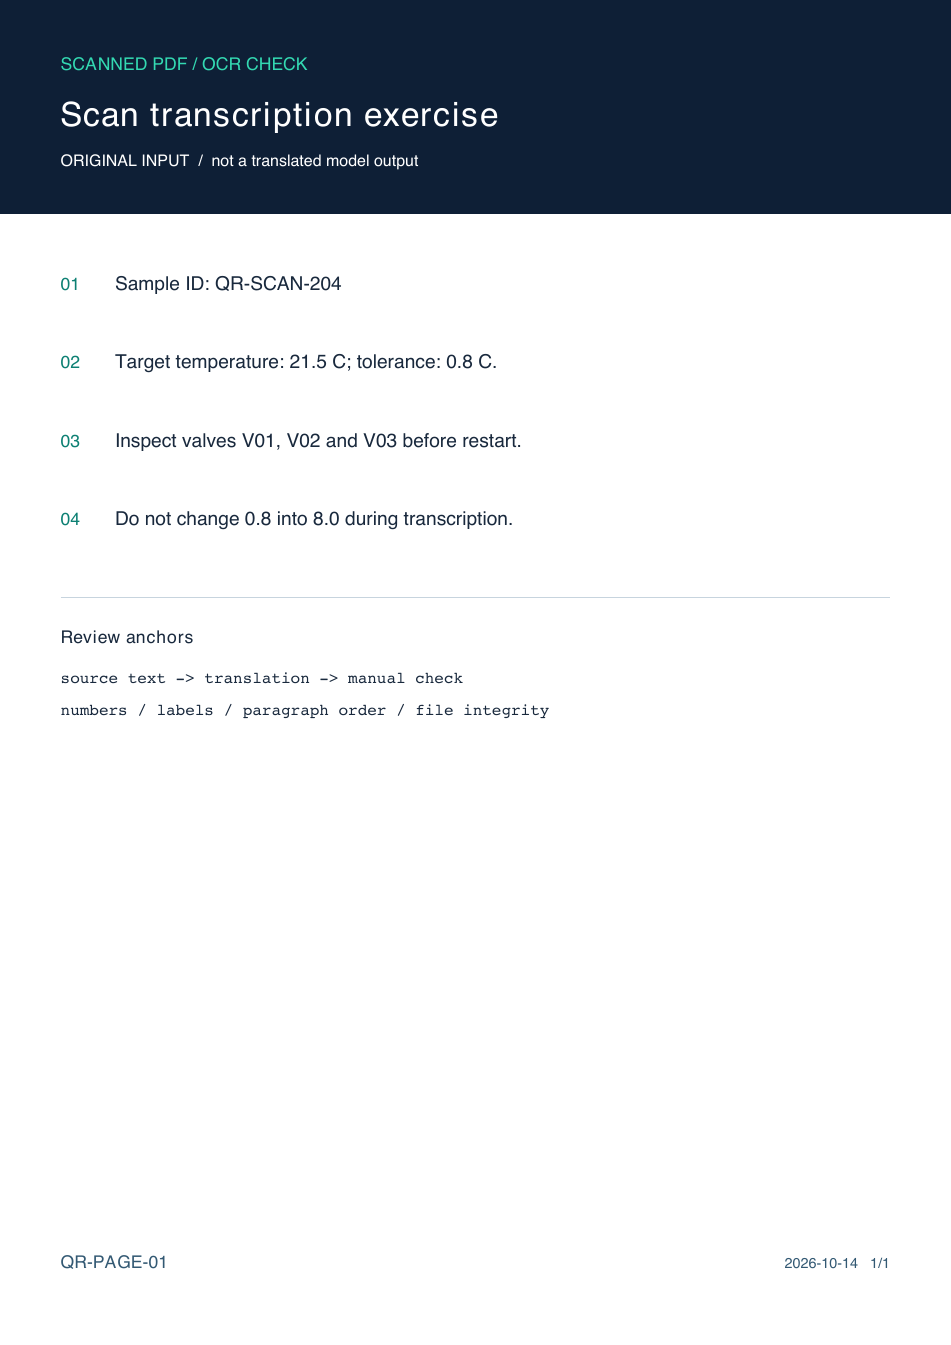
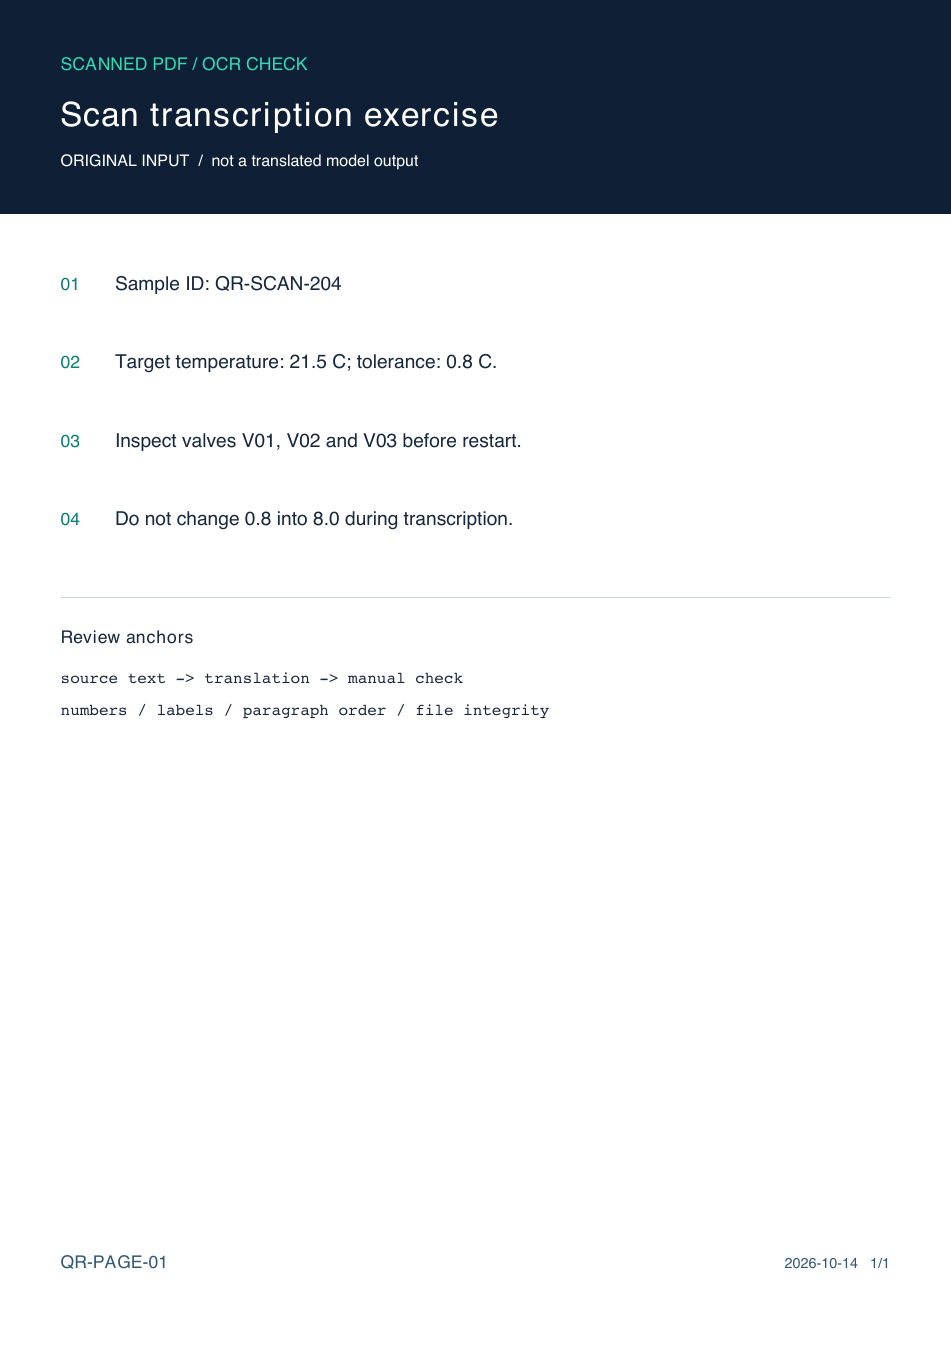
在 scan.pdf 里尝试选择文字,再用 pdftotext 检查。练习包同时给出源数字 PDF,便于判断是 OCR 错字还是翻译变化。
bash
pdftotext scan.pdf scan-layer.txt
python3 verify.py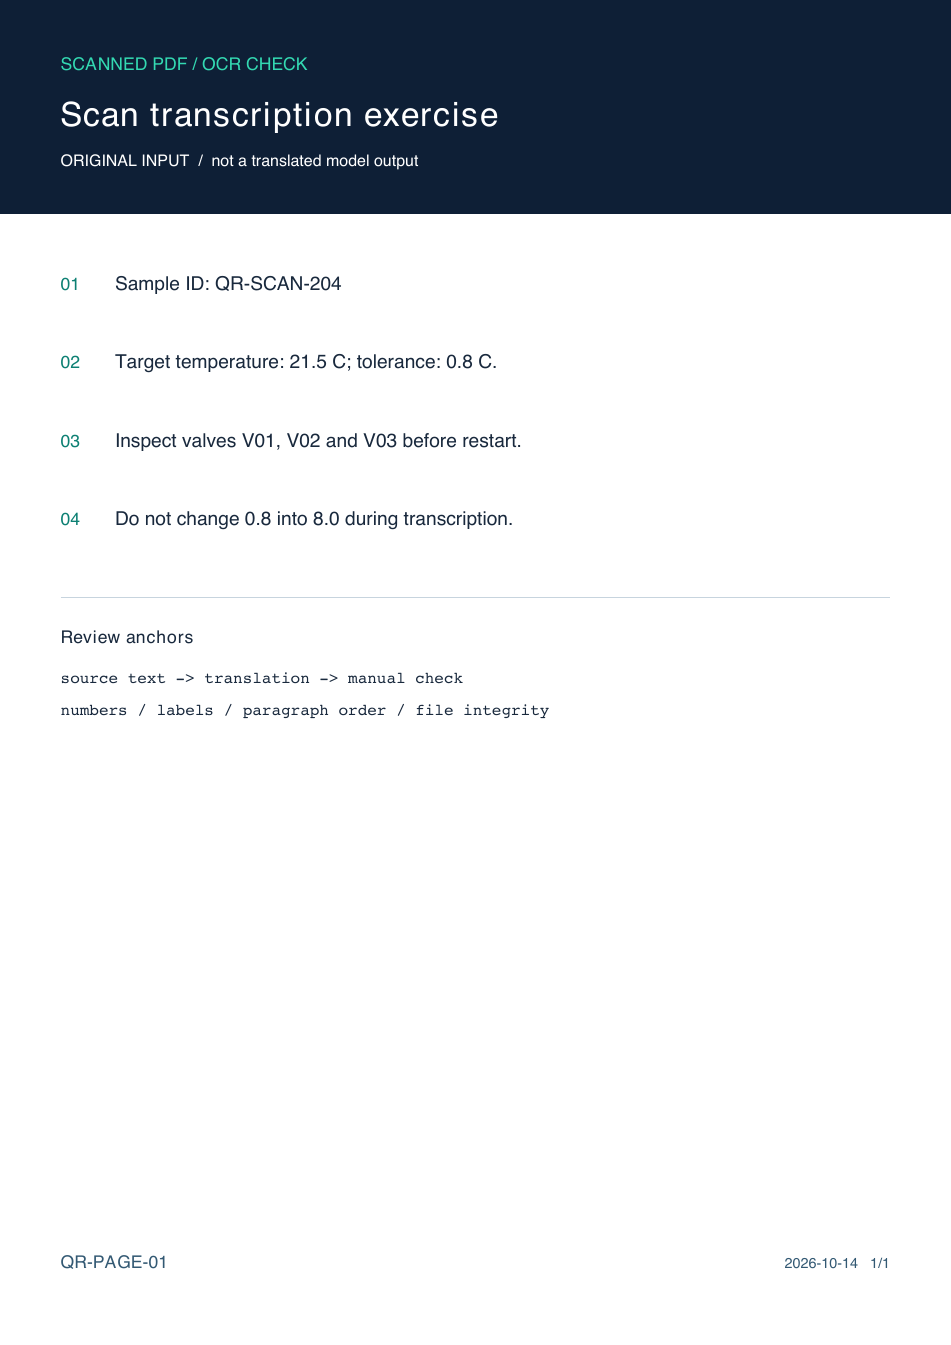
2. 核对实验 OCR 支持
主仓库把 2026-09-08 的 OCR 标为 experimental;其主要目标是白底扫描页。本文固定官方提交 7b57f11ac04409aaac1aba141d0882619cb689b3,不假设 PyPI 1.9.11 已发布该 extra。已有文字页、混合扫描页、手写和行内公式需另查;不要用 ultrafast。
3. 从对应提交安装 OCR extra
遵循主仓库 Python 3.11–3.12 要求,在独立环境从固定功能提交安装 ocr extra。项目通过 PyMuPDF 调用 OCR,首次可能下载 tessdata_fast;本页的 tesseract 命令是独立离线识别演练,不冒充 pdf2zh 内部运行。该环境安装与模型翻译未在本机执行。
bash
python3.12 -m venv .venv
.venv/bin/python -m pip install "pdf2zh[ocr] @ git+https://github.com/PDFMathTranslate/PDFMathTranslate.git@7b57f11ac04409aaac1aba141d0882619cb689b3"
4. 真实复现本地识别练习
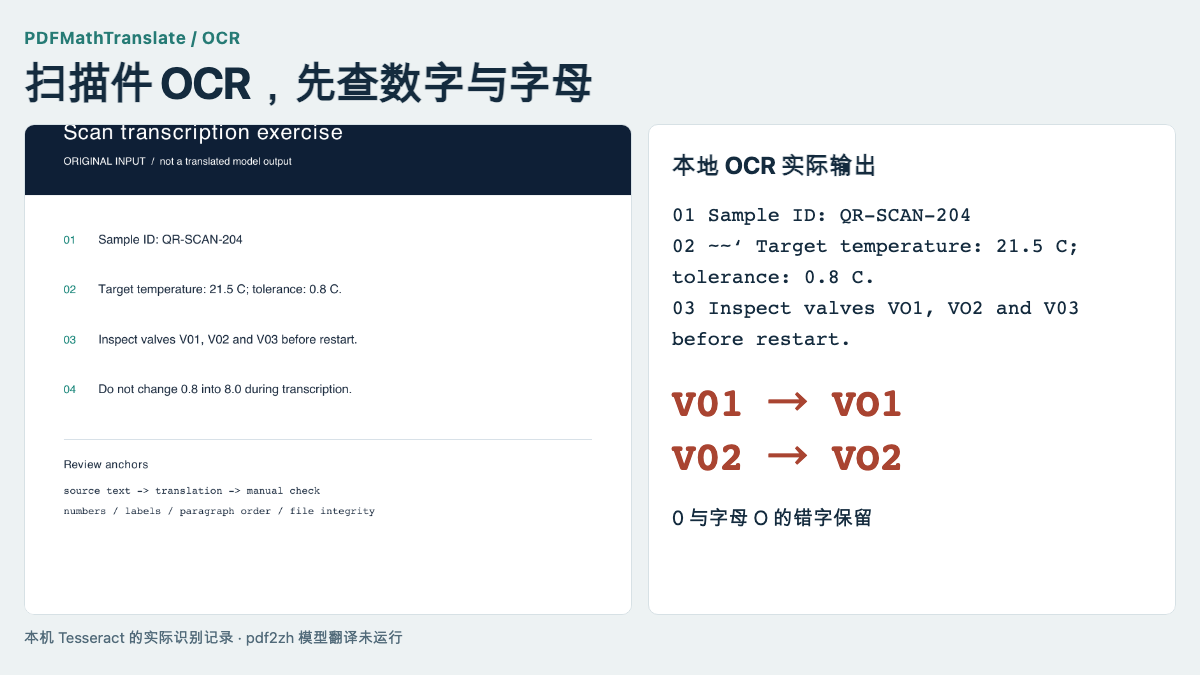
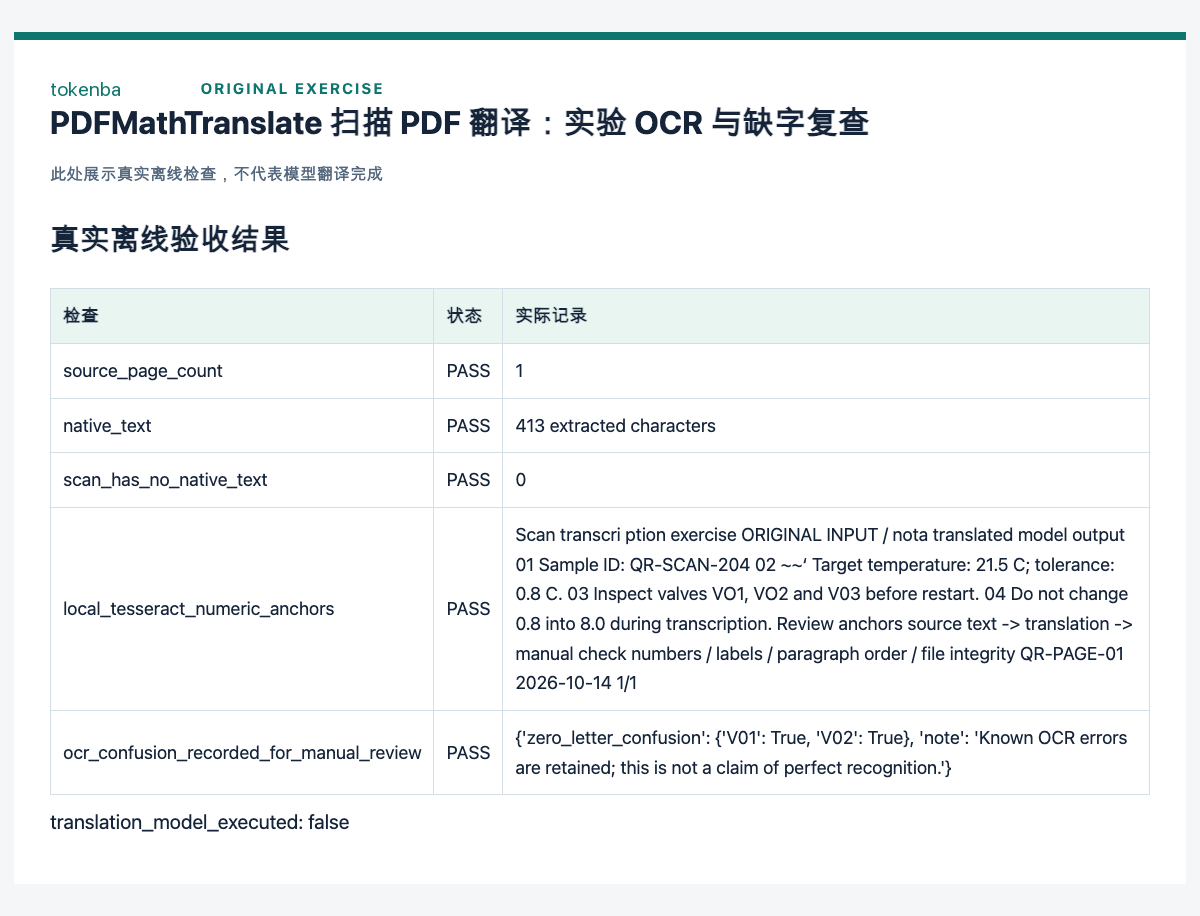
包内 scan.png 是实际扫描输入,ocr.txt 是本机 Tesseract 的真实输出。安装本地 Tesseract 后执行相同命令;对照 21.5、0.8 与 V01,保留识别错误。
bash
tesseract scan.png ocr -l eng --psm 6
python3 verify.py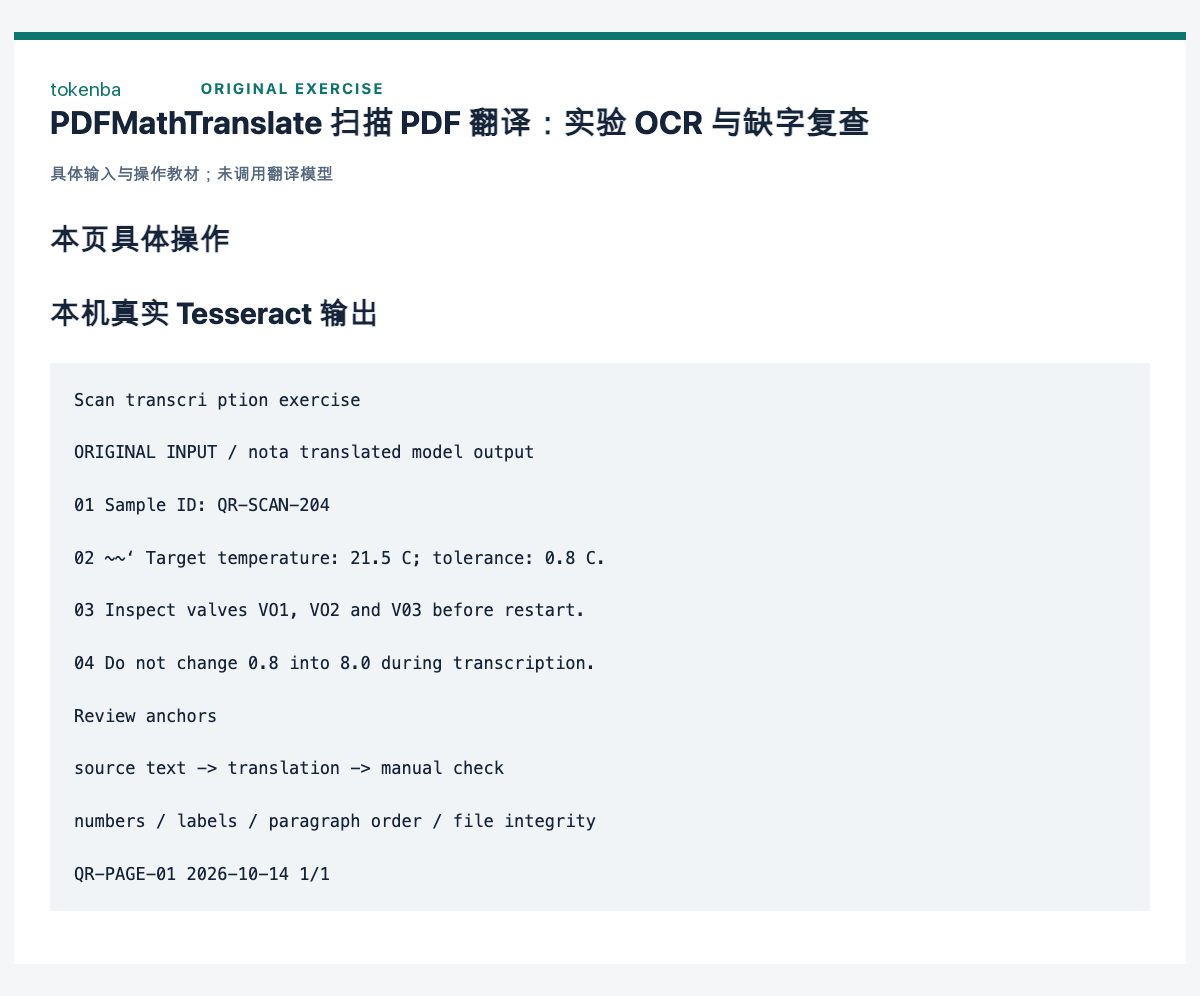
5. 运行 pdf2zh 正常 fast 路径
按官方说明指定输入语言,必要时用 PDF2ZH_OCR_LANGUAGE 覆盖 Tesseract 语言代码;目标译文语言与 OCR 源语言是两件事。此步骤会调用你选择的翻译后端,本教材未运行。
bash
PDF2ZH_OCR_LANGUAGE=eng .venv/bin/pdf2zh scan.pdf -li en -lo zh -t 1 -o output6. 把识别错误与译文错误分开
先对照 source.pdf 与 ocr.txt 修正识别核对表,再在实际译文找对应数字。公式与表格可能保持为图片;原文保留不等于这些区域已被译出。
7. 只重做有问题的页
将问题页号、原字、识别字、译文和处理方式记录到 checklist.csv。保留原 PDF;不要用手工填好的中文覆盖实际模型结果后宣称 OCR 自动完成。
怎样确认已经完成
- scan.pdf 无文字层,scan.png、ocr.txt 与 source.pdf 可以逐字对照。
- 21.5、0.8、V01/V02/V03 与文档编号均单独复核。
- 已运行的是本地 Tesseract 练习;pdf2zh OCR 与模型翻译需自己另行执行。
常见问题
为什么主仓库说不必安装 tesseract,本页又用它?
项目内部通过 PyMuPDF 提供 OCR;本页另用系统 Tesseract 做可复现的识别练习,便于观察错字。两条路径没有声称完全相同。
同一页一半文字一半扫描能自动识别吗?
不能保证。官方说明现有文字页会被跳过,混合页、手写与行内公式仍需单独复查。