
展开本页目录
开始前准备什么
- 能创建工作流和凭据的 n8n 账户;自托管实例的服务端网络可访问 API。
- 自己的 apizt API Key、可用余额与模型权限。
- 先用一个短输入验收,尚未连接邮件发送、数据库写入等外部副作用。
- 导入模板
- 绑定凭据
- 执行一次
- 核对结果
- 扩展自动化
2026-10-23 核验材料;实际执行范围、结果与限制见下方记录。
补充:原有练习资料与下载
四个节点;不含密钥,导入后绑定 Header Auth。
包含凭据设置、超时范围和执行核对。
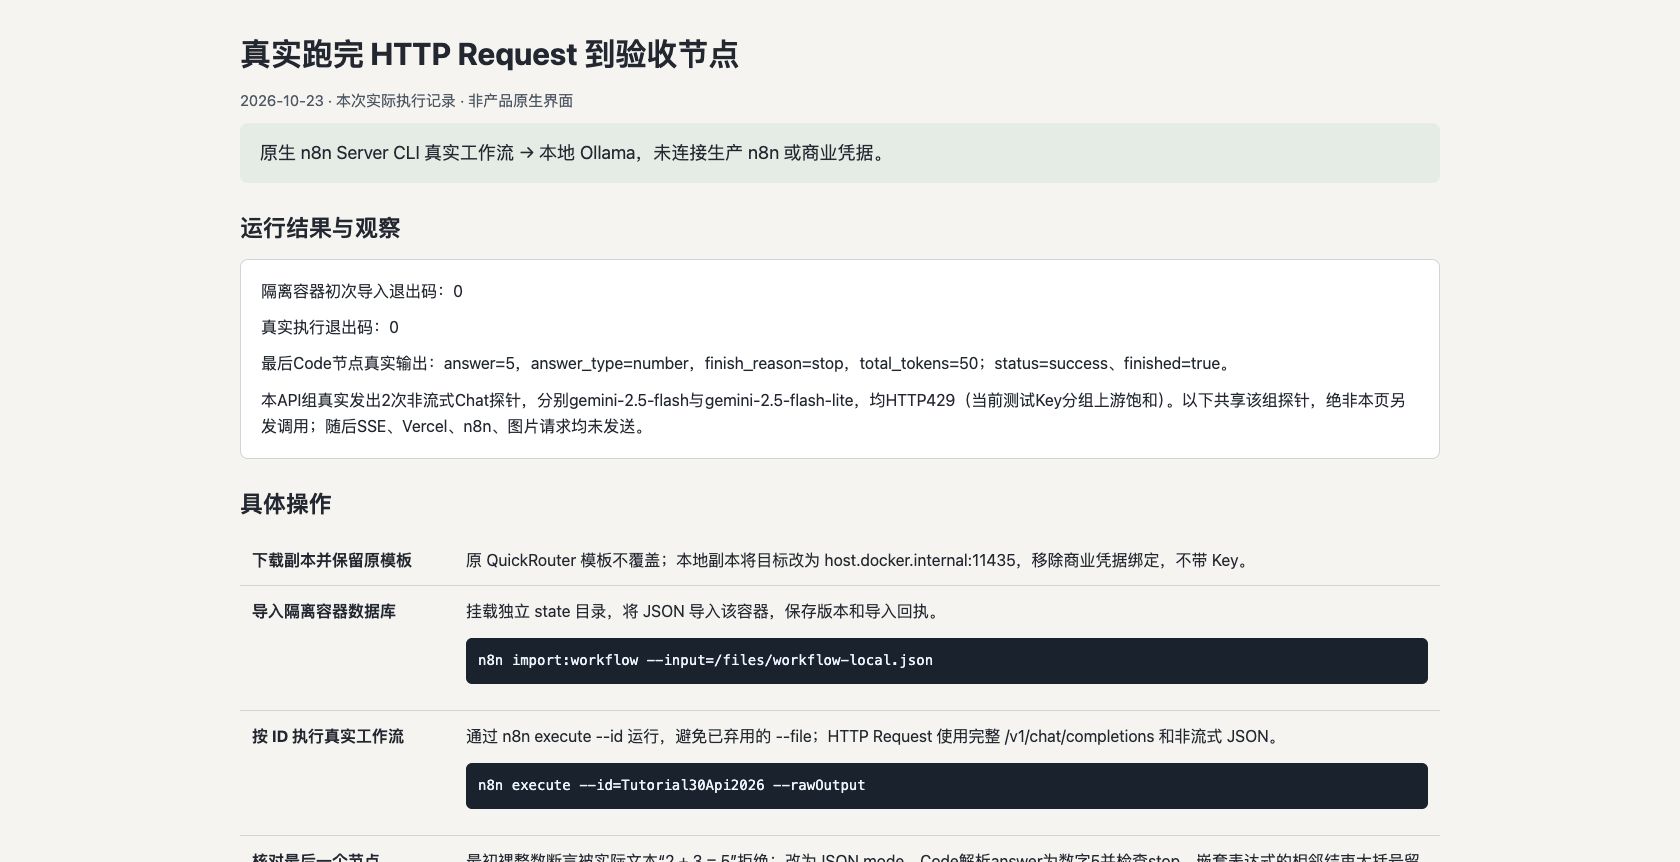
真实跑完 HTTP Request 到验收节点
使用 n8n 2.16.0 隔离容器导入并执行四节点工作流,HTTP Request 请求本机模型,最后的 Code 节点检查答案与完整结束状态。
· 原生 n8n Server CLI 真实工作流 → 本地 Ollama,未连接生产 n8n 或商业凭据。
已取得下列真实结果;仍有内容质量或功能范围需要按本页检查项复核。
- 运行环境
- node v24.14.0;ollama 0.40.9;n8n 2.16.0;openai 7.43.0;ai 7.0.130;@ai-sdk/openai-compatible 3.0.65
1. 下载副本并保留原模板
原 apizt 模板不覆盖;本地副本将目标改为 host.docker.internal:11435,移除商业凭据绑定,不带 Key。
2. 导入隔离容器数据库
挂载独立 state 目录,将 JSON 导入该容器,保存版本和导入回执。
bashn8n import:workflow --input=/files/workflow-local.json3. 按 ID 执行真实工作流
通过 n8n execute --id 运行,避免已弃用的 --file;HTTP Request 使用完整 /v1/chat/completions 和非流式 JSON。
bashn8n execute --id=Tutorial30Api2026 --rawOutput4. 核对最后一个节点
最初裸整数断言被实际文本“2 + 3 = 5”拒绝;改为JSON mode,Code解析answer为数字5并检查stop。嵌套表达式的相邻结束大括号留空格,防止被误判为n8n表达式结束。
5. 接回实际网关时绑定自己的凭据
实际部署使用网关完整端点与 Header Auth,先禁用自动重试,检查服务器网络、一次执行ID与实际账单;本次只跑本地。
这次实际得到什么
- 隔离容器初次导入退出码:0
- 真实执行退出码:0
- 最后Code节点真实输出:answer=5,answer_type=number,finish_reason=stop,total_tokens=50;status=success、finished=true。
- 本API组真实发出2次非流式Chat探针,分别gemini-2.5-flash与gemini-2.5-flash-lite,均HTTP429(当前测试Key分组上游饱和)。以下共享该组探针,绝非本页另发调用;随后SSE、Vercel、n8n、图片请求均未发送。
使用这份结果时注意
- 本批获授权使用既有测试Key,OpenAI SDK两次最小探针均HTTP429:当前测试Key分组上游饱和,随后停止。不能据此声称全站不可用;本地成功不能当作apizt上游或实扣成功。
- 这是 Server CLI 执行记录,不是 n8n 编辑器截图;本地数据库和配置与用户生产实例隔离。
- Code 节点校验真实返回,不产生外部邮件、表格写入或其他副作用。
导入这条可检查的工作流
下载 JSON 后在 n8n 工作流菜单选择 Import from File。导入的是四个节点:手动开始 → 准备输入 → 请求 apizt → 核对答案。模板不包含 Key,也没有绑定你实例里的凭据。
节点使用 Manual Trigger 1、Set 3.4、HTTP Request 4.2 和 Code 2 的导出结构。若实例提示升级,先检查字段,再保存副本。本文核验了官方节点字段,不能替代在你自己的 n8n 中运行。
| 节点 | 作用 | 需要修改 |
|---|---|---|
| 手动开始 | 只在点击执行时运行 | 无需开启定时触发。 |
| 准备输入 | 提供 model 与 prompt | 替换为控制台可用的精确调用 ID。 |
| 请求 apizt | 一次非流式 Chat 请求 | 选择自己的 Header Auth 凭据。 |
| 核对答案 | 检查空输出与截断,保留 usage | 按业务需求扩展验收,先保留原始字段。 |
- 节点
- 手动开始
- 作用
- 只在点击执行时运行
- 需要修改
- 无需开启定时触发。
- 节点
- 准备输入
- 作用
- 提供 model 与 prompt
- 需要修改
- 替换为控制台可用的精确调用 ID。
- 节点
- 请求 apizt
- 作用
- 一次非流式 Chat 请求
- 需要修改
- 选择自己的 Header Auth 凭据。
- 节点
- 核对答案
- 作用
- 检查空输出与截断,保留 usage
- 需要修改
- 按业务需求扩展验收,先保留原始字段。
Key 放进凭据,地址填写完整端点
在「请求 apizt」节点选择 Generic Credential Type → Header Auth。创建凭据,Name 填 Authorization,Value 填 Bearer YOUR_tokenba_API_KEY,替换占位值并保留 Bearer 后的一个空格。
HTTP Request 的 URL 是完整端点,和 SDK 的 Base URL 字段不同。这里填写 /v1/chat/completions;不要只有 /v1,也不要出现 /v1/v1。
| 参数 | 值 |
|---|---|
| Method | POST |
| URL | https://api.apizt.com/v1/chat/completions |
| Authentication | Generic Credential Type → Header Auth |
| Send Body | 开启 |
| Body Content Type / Specify Body | JSON / Using JSON |
| Response Format | JSON |
| Retry On Fail | 关闭 |
| Timeout | 60000 ms;等待响应开始的限制 |
- 参数
- Method
- 值
- POST
- 参数
- URL
- 值
- https://api.apizt.com/v1/chat/completions
- 参数
- Authentication
- 值
- Generic Credential Type → Header Auth
- 参数
- Send Body
- 值
- 开启
- 参数
- Body Content Type / Specify Body
- 值
- JSON / Using JSON
- 参数
- Response Format
- 值
- JSON
- 参数
- Retry On Fail
- 值
- 关闭
- 参数
- Timeout
- 值
- 60000 ms;等待响应开始的限制
本站绘制的内容说明图:此页采用 HTTP Request 节点,地址必须是完整端点;它与 OpenAI Chat Model 的 /v1 前缀配置不同。
从上游字段构造 JSON
在「准备输入」中设置 model=glm-5.3 和短 prompt。请求体用 JSON.stringify 生成,避免输入中的引号或换行破坏 JSON。下方是可以粘贴到 JSON Body 字段的 n8n 表达式。
本例的 max_tokens=1024 是试跑输出预算。更换型号时重新核对参数;不要把文本 payload 直接给图片或异步视频端点。
n8n · JSON Body expression
={{ JSON.stringify({model: $json.model, messages: [{role: "user", content: $json.prompt}], stream: false, max_tokens: 1024}) }}结果节点保留答案与使用量
最后的 Code 节点校验文字是否为空、finish_reason 是否为 length,然后输出 answer、model、response_id、finish_reason 和 usage。usage 缺失时保留 null,不推断零 token 或零费用。
正常验收应是有效回答和完整结束状态,不预设模型必须返回某句固定话。保存 n8n execution ID,并按时间、型号与请求 ID 对照控制台记录。
n8n · Code node
const response = $input.first().json;
const choice = response.choices?.[0];
const answer = choice?.message?.content;
if (typeof answer !== "string" || !answer.trim()) {
  throw new Error("没有收到文字答案;检查模型、接口与执行记录。");
}
if (choice.finish_reason === "length") {
  throw new Error("输出被截断;先核对本次调用,再调整输出预算。");
}
return [{ json: {
  answer,
  model: response.model,
  response_id: response.id,
  finish_reason: choice.finish_reason,
  usage: response.usage ?? null,
} }];
本站绘制的内容说明图:字段对应本页 Code 节点的响应整理;usage 缺失保留 null,不把估算或 HTTP 200 当实际费用与完整结果。
把错误交给明确的恢复分支
| 错误 | 检查什么 | 处理方式 |
|---|---|---|
| 401 | Header Auth 是否绑定、Key 是否有效 | 修改凭据后重新做短样本验收。 |
| 404 / model not found | 完整 URL 与模型 ID | 核对模型目录和端点,不盲目补 /v1。 |
| 429 | 速率或配额限制、并发批次 | 降低并发,按服务端提示安排有限重试。 |
| JSON body invalid | 是否使用 JSON.stringify、输入字段是否存在 | 查看准备输入节点输出,保持字符串字段。 |
| 超时 / 断开 | 本次请求是否已经受理、控制台是否有记录 | 标记未知状态,确认后再决定是否重发。 |
| 最后节点报输出截断 | finish_reason 与 output budget | 保留本次结果及费用,调整后作为新请求执行。 |
- 错误
- 401
- 检查什么
- Header Auth 是否绑定、Key 是否有效
- 处理方式
- 修改凭据后重新做短样本验收。
- 错误
- 404 / model not found
- 检查什么
- 完整 URL 与模型 ID
- 处理方式
- 核对模型目录和端点,不盲目补 /v1。
- 错误
- 429
- 检查什么
- 速率或配额限制、并发批次
- 处理方式
- 降低并发,按服务端提示安排有限重试。
- 错误
- JSON body invalid
- 检查什么
- 是否使用 JSON.stringify、输入字段是否存在
- 处理方式
- 查看准备输入节点输出,保持字符串字段。
- 错误
- 超时 / 断开
- 检查什么
- 本次请求是否已经受理、控制台是否有记录
- 处理方式
- 标记未知状态,确认后再决定是否重发。
- 错误
- 最后节点报输出截断
- 检查什么
- finish_reason 与 output budget
- 处理方式
- 保留本次结果及费用,调整后作为新请求执行。
上线前加任务账本与输出验收
需要 AI Agent 时,另行核对模型子节点的自定义地址、工具调用以及参数支持。本页不依赖 OpenAI 凭据界面里存在 Base URL 字段;HTTP Request 路径的目标地址是明确可见的。
- 批量任务带 row_id 或 job_id,让输入、答案和失败状态能对应。
- 先保存执行状态,再把结果写入目标系统;对外部写入单独做幂等控制。
- 限制工作流并发与总执行时间。模板 executionTimeout=120 秒,实例或 Cloud 限制可能覆盖它;节点 Timeout 不等同于整条流总时限。
- 重跑工作流可能再次调用模型。自动重试、手动重跑和分支恢复都应计入请求次数与费用。
- 仅保存必要的执行数据;工作流共享前清除业务输入和真实响应,凭据不进入下载文件。
本次补测:先完成搜索要解决的问题,再进入下一步
四节点小样只能证明一次请求路径,批量运行还需要在调用模型前去重。
本次用 Python 执行去重与真实 API 请求,不声称已在 n8n 实例导入或运行新增节点。
- 导入原有四节点模板,在凭据内设置 Authorization。
- Webhook 场景先按事件ID和内容哈希去重;同ID不同内容进入冲突待处理。
- 只将去重后的有效输入发送给模型,保留 acceptedIds、duplicateIds 与原始回执。
新增补测结果;与原有原生工具记录分别保存
{
  "api_output": {
    "events": [
      {
        "id": "e1",
        "category": "missing_item",
        "summary": "蓝杯缺一个"
      }
    ]
  },
  "duplicate": 1,
  "conflict": 1,
  "request_count": 1
}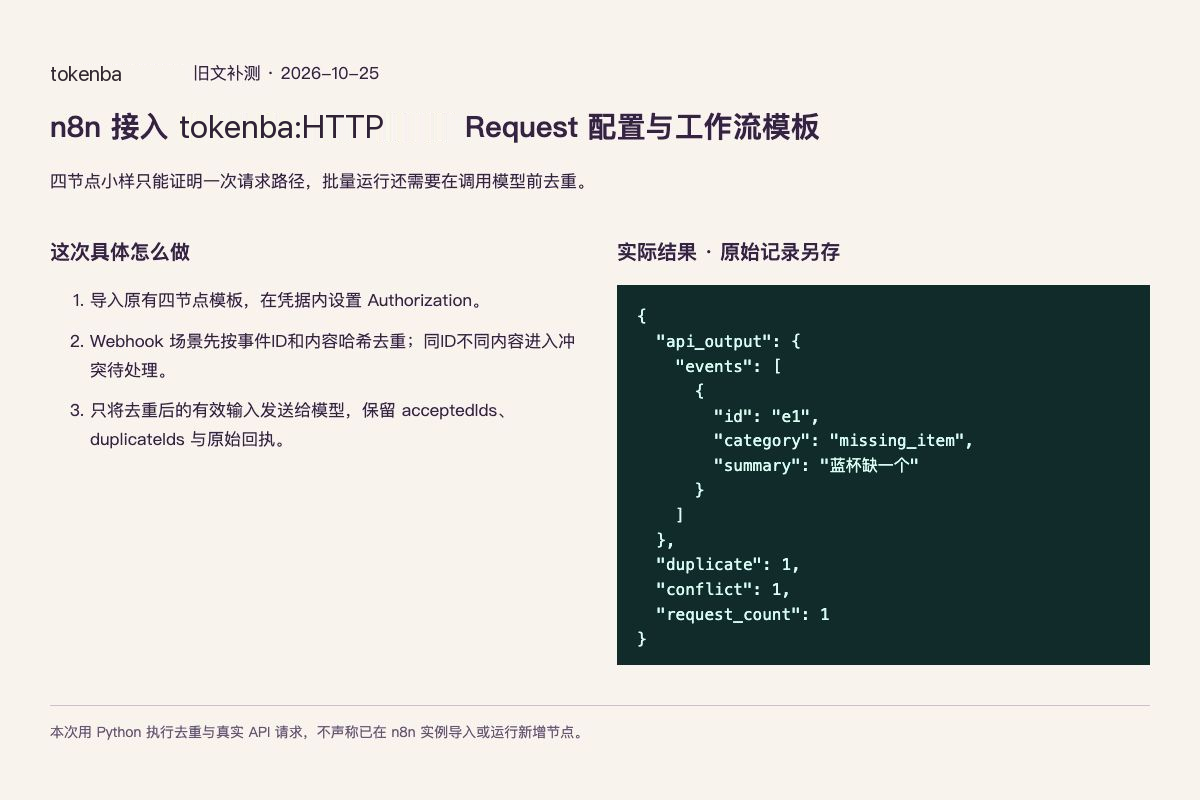
本次实际数据的浏览器执行报告截图,非第三方软件界面;原有配图和缩略图保留。
怎样确认已经完成
- 已绑定自己的 Header Auth 凭据,下载与共享 JSON 中没有 Key。
- 最后节点输出可读 answer,usage 缺失显示 null,截断会失败。
- 实际请求为 /v1/chat/completions,model 与准备输入保持一致。
- 保存 n8n execution ID,核对一次执行的全部 API 记录与实扣。
常见问题
为什么不用直接把 apizt Key 填进 OpenAI 凭据?
不同 n8n 节点和版本对地址的配置方式不同,不能假设 OpenAI 凭据有 Base URL。本页用 HTTP Request 指定完整端点;如果选择 AI Chat Model 节点,先核对它的 Options 与接口支持。
HTTP Request 适合接流式输出吗?
这个工作流采用非流式 JSON,适合需要完整结果再向后传的自动化。浏览器实时显示需要另外处理 SSE 与完整结束信号,不能把部分文字直接当最终结果。
模板可以直接跑批量分类吗?
先用单条模板验证凭据与协议,再使用批量案例的 row_id、失败记录和恢复流程。不要仅把单次节点循环运行就认为已经具备可靠的续跑机制。