
展开本页目录
开始前准备什么
- 保存原始 usage、原生协议名与 SDK / 网关版本。
- 合成算例用于检查计算,不是任何型号的真实用量。
- 费用仍需控制台核对;同样的用户文本不会产生相同 Token 数。
- 保留原始字段
- 识别协议口径
- 合并总量
- 检查缺失与子项
- 另核对实际费用
20个虚构任务、参考答案、可信测试与空记录模板。没有新模型成绩,不会调用API。
20 个虚构用例。expected 是验收参考,不是模型结果。
60 行未运行占位;未知耗时、通过与实际扣费保留 null。
不要先抹平字段,再猜总量
兼容接口还可能把原生字段映射成 Chat 形状,甚至不保留部分细项。因此要保存 protocol 和原字段,不根据模型品牌猜接口口径。
| 协议 | 输入口径 | 输出口径 |
|---|---|---|
| OpenAI Responses | input_tokens 是总输入;缓存读写在 details | output_tokens 是总生成量;reasoning 是细项 |
| Anthropic Messages | input_tokens + cache_read_input_tokens + cache_creation_input_tokens;按实际字段是否报告处理 | output_tokens 与其细项按当前响应合同 |
| Gemini 原生 / Interactions | 分别保留原生 usageMetadata 或 Interactions 字段 | candidates/thoughts 与 total_output/total_thought 不能硬套同一口径 |
- 协议
- OpenAI Responses
- 输入口径
- input_tokens 是总输入;缓存读写在 details
- 输出口径
- output_tokens 是总生成量;reasoning 是细项
- 协议
- Anthropic Messages
- 输入口径
- input_tokens + cache_read_input_tokens + cache_creation_input_tokens;按实际字段是否报告处理
- 输出口径
- output_tokens 与其细项按当前响应合同
- 协议
- Gemini 原生 / Interactions
- 输入口径
- 分别保留原生 usageMetadata 或 Interactions 字段
- 输出口径
- candidates/thoughts 与 total_output/total_thought 不能硬套同一口径
Responses 算例:缓存已经属于总输入
这个例子的总输入为 100,总输出为 80,总量为 180。不能计算 100 + 40 + 10 得到 150 输入,也不能把 20 reasoning 再加到 80 输出。新字段能否出现,取决于当前接口响应。
作者合成字段,不是真实响应
{
  "input_tokens": 100,
  "input_tokens_details": {
    "cached_tokens": 40,
    "cache_write_tokens": 10
  },
  "output_tokens": 80,
  "output_tokens_details": {
    "reasoning_tokens": 20
  },
  "total_tokens": 180
}
本站绘制的内容说明图:此页合成 Responses 算例,不是真实响应;缓存与推理子项已在总项中,不能重复求和。
Messages 算例:输入三项合并,但缺失不猜零
三项都已报告时,这份例子的总输入为 110,输出为 80。若某个缓存字段未返回,按已确认的协议或适配合同判断;没有依据时保留未知,不把缺字段自动补成 0。不要把这个合并规则再套到 Responses。
作者合成 Messages 字段
{
  "input_tokens": 60,
  "cache_read_input_tokens": 40,
  "cache_creation_input_tokens": 10,
  "output_tokens": 80
}
本站绘制的内容说明图:此页合成 Messages 示例的规则不能套到 Responses;缺失缓存字段不凭空补零。
Gemini 区分原生代际与兼容映射
本页不提供一个覆盖所有 Gemini 接口的强制总量公式。先根据当前协议文档确定子项关系,再计算;如果某项关系或字段未确认,保留原值和不确定说明。
| 字段形态 | 要保留 | 避免 |
|---|---|---|
| 传统 usageMetadata | promptTokenCount、cachedContentTokenCount、candidatesTokenCount、thoughtsTokenCount、totalTokenCount 等实际字段 | 把缓存当额外输入重复加 |
| Interactions | total_input_tokens、total_output_tokens、total_thought_tokens 等返回字段及 API 版本 | 照旧字段猜 total_output 是否含 thought |
| Chat 兼容 | prompt_tokens / completion_tokens 与 details 的实际返回 | 把 missing reasoning 当 0 或推断没有思考 |
- 字段形态
- 传统 usageMetadata
- 要保留
- promptTokenCount、cachedContentTokenCount、candidatesTokenCount、thoughtsTokenCount、totalTokenCount 等实际字段
- 避免
- 把缓存当额外输入重复加
- 字段形态
- Interactions
- 要保留
- total_input_tokens、total_output_tokens、total_thought_tokens 等返回字段及 API 版本
- 避免
- 照旧字段猜 total_output 是否含 thought
- 字段形态
- Chat 兼容
- 要保留
- prompt_tokens / completion_tokens 与 details 的实际返回
- 避免
- 把 missing reasoning 当 0 或推断没有思考
用最小检查表阻止重复计数
| 检查 | 通过条件 | 错误例子 |
|---|---|---|
| 协议 | 原始 usage 与 protocol 同时存在 | 只有归一化后的两个数字 |
| 包含关系 | 总量和子项不重复相加 | 缓存或 reasoning 加两遍 |
| 缺失 | 未知与明确 0 分开 | 没返回字段填 0 |
| 总量校验 | 能解释 total 与输入输出差额 | 忽略工具输入、适配差异 |
| 计费 | 使用实际价格规则并核对实扣 | 总 Token 数直接乘一个单价 |
- 检查
- 协议
- 通过条件
- 原始 usage 与 protocol 同时存在
- 错误例子
- 只有归一化后的两个数字
- 检查
- 包含关系
- 通过条件
- 总量和子项不重复相加
- 错误例子
- 缓存或 reasoning 加两遍
- 检查
- 缺失
- 通过条件
- 未知与明确 0 分开
- 错误例子
- 没返回字段填 0
- 检查
- 总量校验
- 通过条件
- 能解释 total 与输入输出差额
- 错误例子
- 忽略工具输入、适配差异
- 检查
- 计费
- 通过条件
- 使用实际价格规则并核对实扣
- 错误例子
- 总 Token 数直接乘一个单价
同样 prompt,不保证相同 usage
不同 tokenizer、工具定义、系统前缀、缓存和网关附加上下文都可能改变输入用量。已有同档报告已经保留实际 usage;用户输入相同并不能证明上游身份或缓存条件完全一致。
使用本批虚构事实 prompt 测量时,把原始用户文本、请求配置和响应 usage 分开保存。这里没有新增测量;不要把作者算例放进结果模板。
供实际试验复用的相同输入
[S11] 2026年5月6日,周楠递交了橙湾阅读角方案。本轮预算为0元,不申请新增经费。
[S12] 会议已批准该方案;上线日期尚未确定。本次补测:先完成搜索要解决的问题,再进入下一步
token归一化和金额换算容易混写,且估算可能被误认为真实控制台实扣。
补测货币台账使用明确虚构账单;真实响应 usage 与合成金额分栏,不编造总费用。
- 先保留协议原始usage,缓存和推理明细不重复加到总量。
- 金额表另列原币、汇率日期、估算和实际字段,用Decimal换算。
- 缺usage保持未知;本地货币算例0.17元不是本次API真实费用。
新增补测结果;与原有原生工具记录分别保存
{
  "fictional_billing": true,
  "cny_total": "0.1700",
  "estimates_cny": {
    "a": "0.05600"
  },
  "explanation": {
    "summary": "This ledger contains two entries with financial amounts in different currencies. The 'actual' value represents the confirmed transaction amount, while the 'estimated' value is a preliminary or projected amount that may be subject to change. The 'fx_date' field indicates the date of the foreign exchange rate applied and should be retained for accurate historical reference.",
    "details": [
      {
        "id": "a",
        "currency": "USD",
        "actual": "0.01",
        "estimated": "0.008",
        "fx_cny": "7.00",
        "fx_date": "2026-10-23",
        "notes": "Actual amount is the confirmed USD value; estimated is a preliminary figure. The fx_date is important for exchange rate context."
      },
      {
        "id": "b",
        "currency": "CNY",
        "actual": "0.10",
        "estimated": null,
        "notes": "Only actual amount is provided; no estimate available."
      }
    ],
    "disclaimer": "This data is fictional and for demonstration purposes only; it does not represent any real account or transaction."
  }
}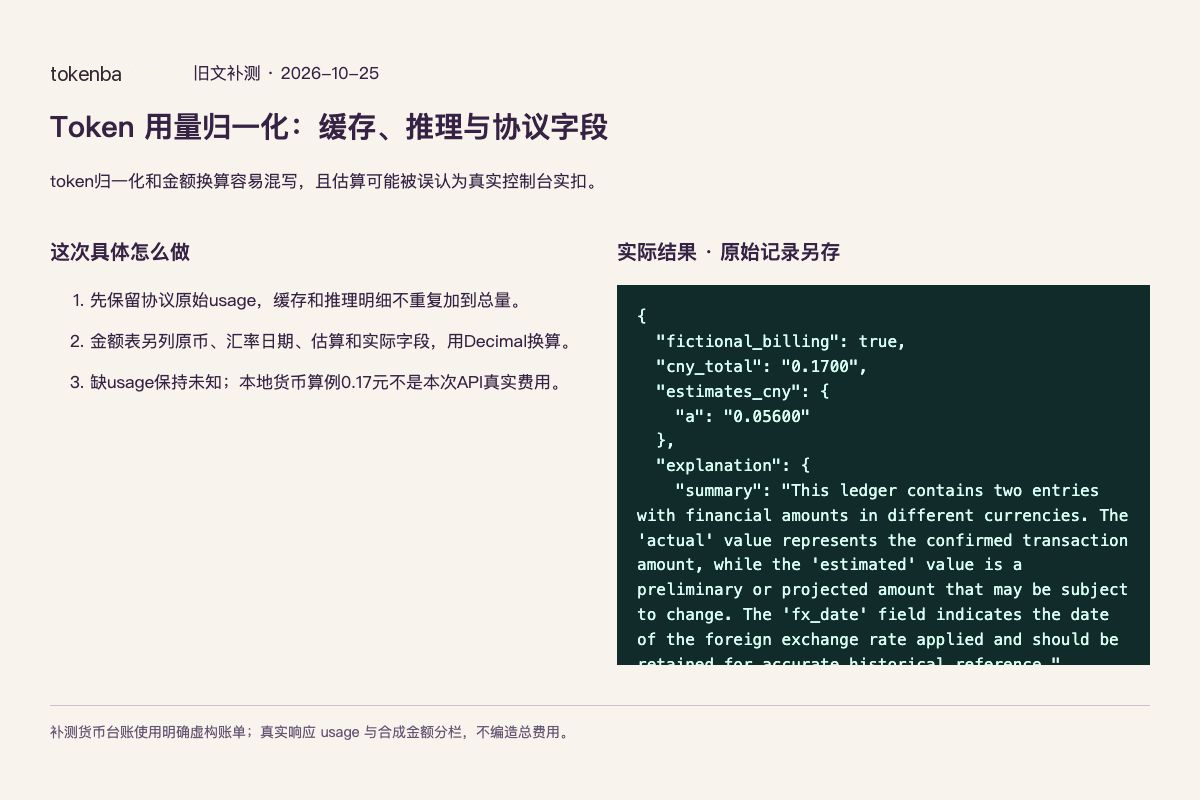
本次实际数据的浏览器执行报告截图,非第三方软件界面;原有配图和缩略图保留。
怎样确认已经完成
- 原始 usage、协议与版本保留。
- 缓存与推理子项没有重复相加。
- 缺失项没有自动填成零。
- 归一化用量与实际扣费明确分开。
常见问题
缓存 Token 可以再加到 input_tokens 吗?
要看协议。Responses 的缓存细项属于 input_tokens,不再加。Messages 的普通输入、缓存读取与创建是分开字段,需要按当前返回合同合并。
没返回 reasoning_tokens,代表模型没有思考吗?
不代表。可能接口没提供、适配时丢失或字段版本不同,应保留未知。
Gemini 为什么不统一一个公式?
原生接口、Interactions 与兼容接口字段形态不同,包含关系需要按实际协议确认。硬套公式可能重复或漏算。