
展开本页目录
开始前准备什么
- 本题公开输入为原创或虚构教学材料,不需要登录第三方平台。
- API步骤需要自己的apizt Key;在模型广场核对当前权限和费用,Key只留在本机。
- 本地处理步骤需要文中注明的Python、FFmpeg或对应工具;本地执行与云API计费分别判断。
- 明确角色与逐句时间
- 显式生成有声视频
- 独立转写与嘴部复核
2026-10-24 核验材料;实际执行范围、结果与限制见下方记录。
补充:原有练习资料与下载
包含任务请求、原始模型结果、检查记录和复跑脚本。
真实操作、成品与核验记录
通过apizt实际生成8秒双角色有声视频,固定左侧眼镜角色问“车票买好了吗?”,右侧橙衣角色回答“买好了,明早出发”。ASR把回答识别为疑似错词,需回听并逐帧查看说话者嘴部,不能将有音轨等同于口型已合格。
· 按下列具体任务验收API或本地执行;产品原生功能、文件成功与内容质检分别说明。
已取得下列真实结果;仍有内容质量或功能范围需要按本页检查项复核。
- 运行环境
- apizt API;具体型号与参数见每个请求回执;macOS;公开报告不包含凭据
1. 明确角色与逐句时间
同一画面只保留两名原创成年角色,A左B右;前半A提问、后半B回答,听话者闭嘴。
2. 显式生成有声视频
Seedance mini使用原双角色图、duration=8、generate_audio=true;不把后期配音冒称原生有声生成。
3. 独立转写与嘴部复核
下载实际MP4,ffprobe核对音轨,Whisper独立转写;识别疑点、人物开闭嘴和无抢话分别记录,必要时重做该句。
这次实际得到什么
- 真实有声视频与ASR已保存;提问识别正确,回答出现“明好明早出发”的疑点。
使用这份结果时注意
- 卡通嘴部细节有限,ASR并非人工听写真值;本例不能声称严格逐音素口型通过。
这篇解决什么问题
分开验收台词、说话人、画面左右和嘴部动作。有音轨不代表台词准确,ASR疑点也不是人工听写真值。先保留原片和独立转写,再决定是否只重做出错的一句或一个镜头。
- 卡通嘴部细节有限,ASR并非人工听写真值;本例不能声称严格逐音素口型通过。
按实测步骤复跑
- 明确角色与逐句时间:同一画面只保留两名原创成年角色,A左B右;前半A提问、后半B回答,听话者闭嘴。
- 显式生成有声视频:Seedance mini使用原双角色图、duration=8、generate_audio=true;不把后期配音冒称原生有声生成。
- 独立转写与嘴部复核:下载实际MP4,ffprobe核对音轨,Whisper独立转写;识别疑点、人物开闭嘴和无抢话分别记录,必要时重做该句。
核对实际输出与失败条件
- 真实有声视频与ASR已保存;提问识别正确,回答出现“明好明早出发”的疑点。
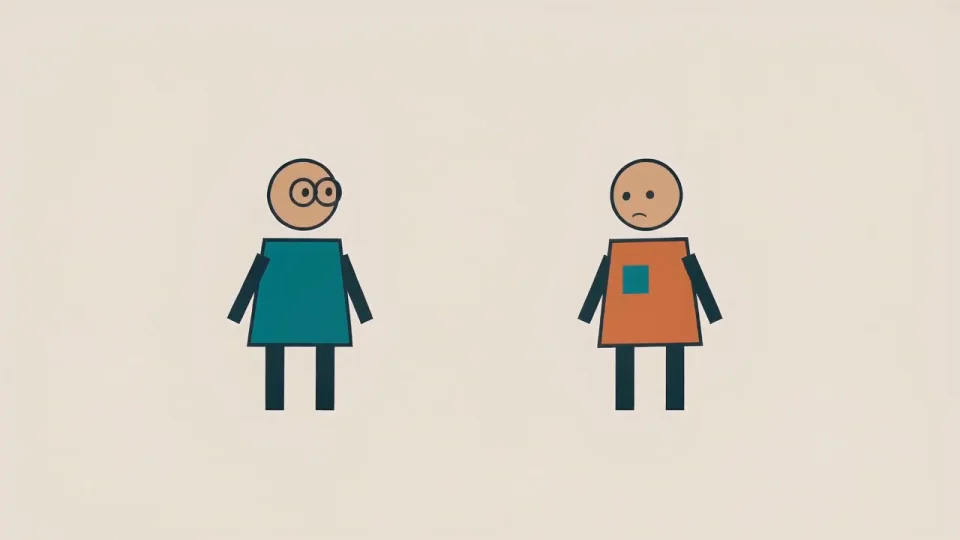
来自本题实际视频帧或回写报告;不是产品官方界面。
下载输入、结果与可恢复脚本
公开包包含原始请求、输入哈希、实际输出和回执。先使用一份小样,已知异步任务只按同一task_id查询;超时且未知是否创建时,先在控制台对账。MCP示例通过环境指定私有凭据文件,普通API脚本读取tokenba_API_KEY,均不会把Key写进公开JSON。
怎样确认已经完成
- 真实有声视频与ASR已保存;提问识别正确,回答出现“明好明早出发”的疑点。
- 卡通嘴部细节有限,ASR并非人工听写真值;本例不能声称严格逐音素口型通过。
常见问题
即梦多人对口型这次真实做到了什么?
通过apizt实际生成8秒双角色有声视频,固定左侧眼镜角色问“车票买好了吗?”,右侧橙衣角色回答“买好了,明早出发”。ASR把回答识别为疑似错词,需回听并逐帧查看说话者嘴部,不能将有音轨等同于口型已合格。
是否需要登录第三方平台?
本页主流程按上方实测中的apizt API或本地工具执行。卡通嘴部细节有限,ASR并非人工听写真值;本例不能声称严格逐音素口型通过。