
展开本页目录
开始前准备什么
- 本题公开输入为原创或虚构教学材料,不需要登录第三方平台。
- API步骤需要自己的apizt Key;在模型广场核对当前权限和费用,Key只留在本机。
- 本地处理步骤需要文中注明的Python、FFmpeg或对应工具;本地执行与云API计费分别判断。
- 先做单条
- 建立任务表
- 逐条创建
- 恢复查询下载
- 逐条验收核账
2026-10-24 核验材料;实际执行范围、结果与限制见下方记录。
补充:原有练习资料与下载
两条未提交的虚构任务,可导入本地记录工具;费用未知,不含 Key 或实际任务 ID。
输入与任务 ID 对应尺寸、时长、音轨、主体和最终人工判断。
已有 Python 客户端:创建一次、保存状态文件,再按同一 task_id 查询;创建可能计费。
真实操作、成品与核验记录
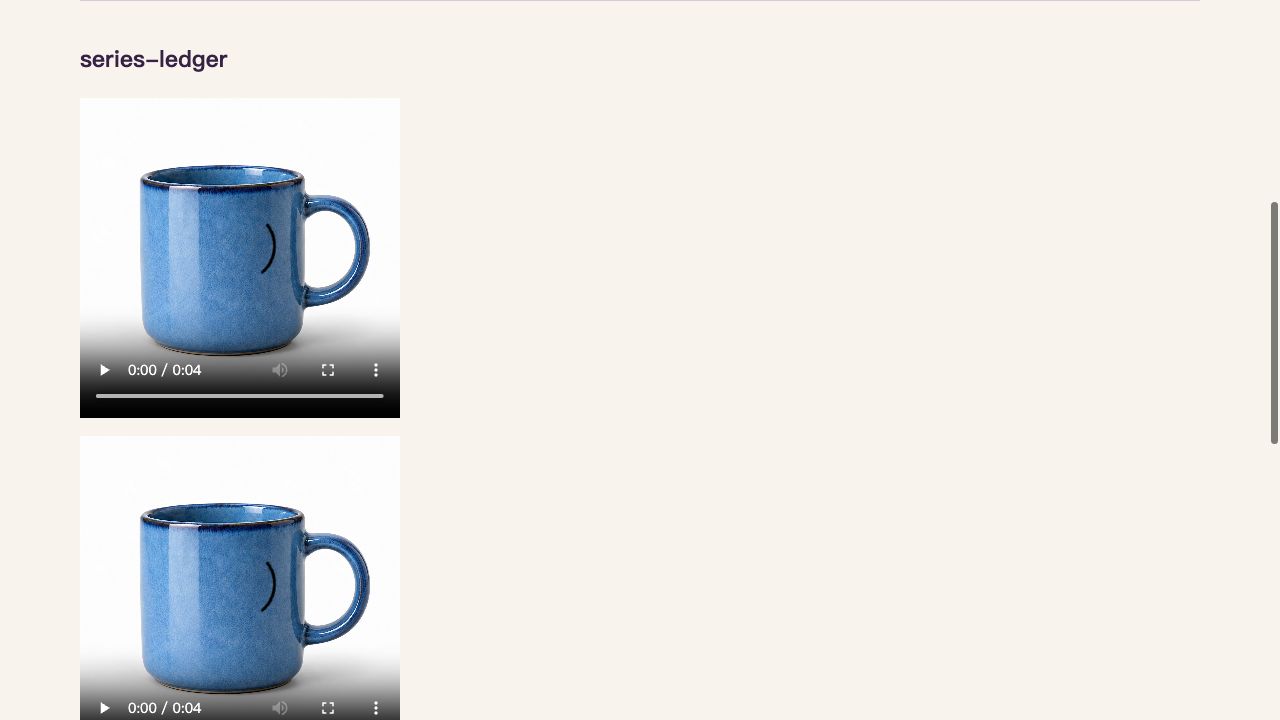
合并本批重复的Content Factory系列选题,沿用现有URL。把两条蓝釉杯镜头放入同一任务清单,按真实task_id查询、下载、校验SHA;恢复检查只读取已有任务,不重复提交付费生成。
· 按下列具体任务验收API或本地执行;产品原生功能、文件成功与内容质检分别说明。
- 运行环境
- apizt API;具体型号与参数见每个请求回执;macOS;公开报告不包含凭据
1. 固定两行任务清单
两行分别为宽景静态和近景推镜,同一商品参考;每行保留输入SHA、prompt与task_id。
2. 分离提交与恢复
已知task_id只查询GET,不把下载失败当成重新生成依据;unknown提交转人工对账。
3. 逐片核验
核对两个不同输出、时长、画面、下载SHA;重复恢复不增加提交数量,不能拿一个MP4当两条任务。
这次实际得到什么
- 清单引用本批两条真实商品镜头,不额外宣称又生成了两次;复查下载与去重通过。
使用这份结果时注意
- 本例为Python/API批处理替代,不是Higgsfield Content Factory原生队列;两条样片不证明大并发能力。
一条输入对应一份任务记录
先下载任务 CSV,给每个素材版本独立 input_id。提示词或首帧变化就建新版本;已有 task_id 不能分配给另一个输入。检查重复 ID 和缺失素材后,再安排创建。
本地记录工具的 7 个字段不含 Key、素材签名 URL 或接口请求。它只帮助整理记录,不会提交、查询或判断实际账单;生产自动化仍需要自己的持久化存储和访问权限。
| 字段 | 用途 | 示例 |
|---|---|---|
| input_id / task_id | 关联需求与远端任务 | DEMO-PRODUCT-01 / 取得后填写 |
| status | 生成阶段 | draft、submitted、processing、succeeded、failed、unknown |
| download_status / acceptance_status | 区分拿到文件和可用 | no / pending;yes / pass |
| billed_usd | 已核实美元实扣 | unknown 或非负实际金额 |
- 字段
- input_id / task_id
- 用途
- 关联需求与远端任务
- 示例
- DEMO-PRODUCT-01 / 取得后填写
- 字段
- status
- 用途
- 生成阶段
- 示例
- draft、submitted、processing、succeeded、failed、unknown
- 字段
- download_status / acceptance_status
- 用途
- 区分拿到文件和可用
- 示例
- no / pending;yes / pass
- 字段
- billed_usd
- 用途
- 已核实美元实扣
- 示例
- unknown 或非负实际金额
本站绘制的内容说明图:本页账本只整理已有记录,不提交、查询或判断实际费用;任务 ID 不能改绑另一份输入。
创建限速,查询单独调度
先一条一条提交,按当前通道限制设置创建间隔和并发上限,不套用固定的每秒数量。提交前记录 input_id、请求版本与提交意图,成功后保存 task_id;未知结果从创建队列暂停,转人工核查。
视频生成可能持续一段时间,不让创建节点等待整批完成。已有 ID 交给查询队列;查询使用间隔、截止时间与退避,失败终态转记录,超时保留原 ID 等待恢复。
text
已审核输入 → 创建队列(先持久化提交意图)
  → 返回 task_id:保存并加入查询队列
  → 提交结果 unknown:暂停该行,查历史,不自动重提

查询队列 → queued/running:等待后查询原 ID
  → succeeded:下载队列 → 技术检查 → 人工验收
  → failed/expired/cancelled:保留终态与费用
  → 查询到期/响应未知:保留 ID,之后恢复 GET
断开后按阶段恢复,不重新跑整批
已有 task_id 而没有终态,恢复 GET;succeeded 但没下载,先恢复下载;已下载但未验收,继续检查本地文件。对明确失败且已批准重做的输入创建新版本,保留旧任务的费用和原因。
重复执行前先读记录,不能仅凭脚本退出码决定重新生成。原有单任务客户端提供同一状态文件的查询命令;将它接到自己的任务队列时,每条任务使用独立文件和显式状态。
bash
python3 seedance-task.py query --state task-DEMO-PRODUCT-01.json --timeout 600 --interval 5 > result-DEMO-PRODUCT-01.json
本站绘制的内容说明图:这张图仅针对账本阶段,查询、下载和验收不回到整批创建,避免重复生成。
下载可重试,成片不能直接自动发布
结果链接可能有有效期,完成后及时保存到自己的存储。下载器不向素材地址发送 API Key;验证 HTTPS、实际容器、文件大小和解码,把下载成功单独写入 download_status。
相同文件重复下载不等于重新生成。使用任务 ID 和文件 SHA-256 关联结果,再完整播放;只有人工通过的版本进入剪辑或发布系统,不能把 succeeded 自动映射为可发布。
保留未知行,才能知道这一批的真实成本
报价用于选择任务,实扣用于核账。费用字段未知时填 unknown;零费用需要账单证明。失败、返工和重复任务仍属于本批记录,不能只统计通过的那几条请求。
本地工具导出的费用合计仅覆盖已填写的实扣。存在 unknown 时说明金额尚不完整;计算每条合格视频成本前,先补齐账单并确定人工通过数量。
怎样确认已经完成
- 全部 input_id 唯一,task_id 无重复分配。
- 提交意图和返回 ID 在创建阶段持久化,unknown 行暂停核查。
- 查询有总时限,恢复时继续 GET 原任务。
- 下载、技术检查、人工通过与实扣分别记录;没有自动发布。
常见问题
批量视频生成这次真实做到了什么?
合并本批重复的Content Factory系列选题,沿用现有URL。把两条蓝釉杯镜头放入同一任务清单,按真实task_id查询、下载、校验SHA;恢复检查只读取已有任务,不重复提交付费生成。
是否需要登录第三方平台?
本页主流程按上方实测中的apizt API或本地工具执行。本例为Python/API批处理替代,不是Higgsfield Content Factory原生队列;两条样片不证明大并发能力。