
展开本页目录
开始前准备什么
- 下载练习包,先阅读 README 中的依赖和运行范围。
- 使用独立练习目录;starter 是待完成任务,reference 是作者参考实现。
- 账号型功能须在自己的授权环境执行;本题不要求提供真实凭据。
- 定义同源关系
- 打开原生流
- 使用稳定分组键
- 写入两个分片
- 检查泄漏交集
- 运行错误对照
- 交付分组证据
1. 定义同源关系
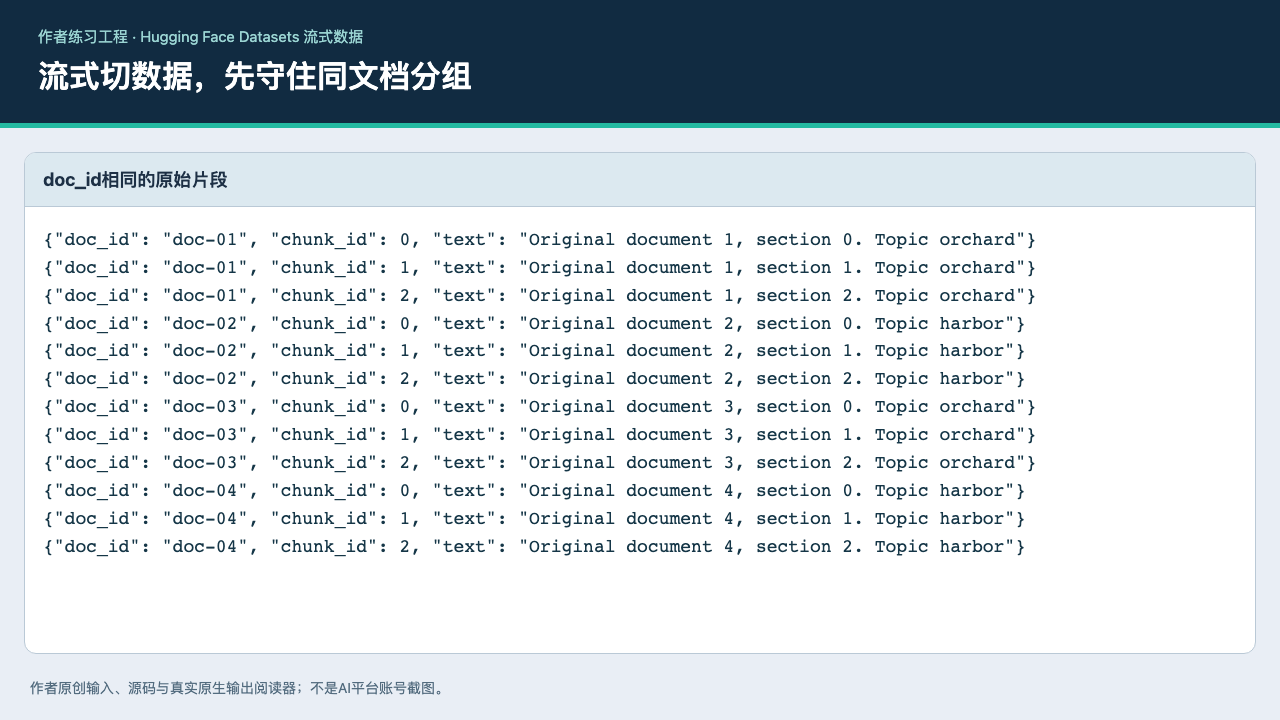
原创12份文档各拆3段,共36行,doc_id表示同源。先明确同源文档不能横跨训练和验证,再考虑行数比例。
2. 打开原生流
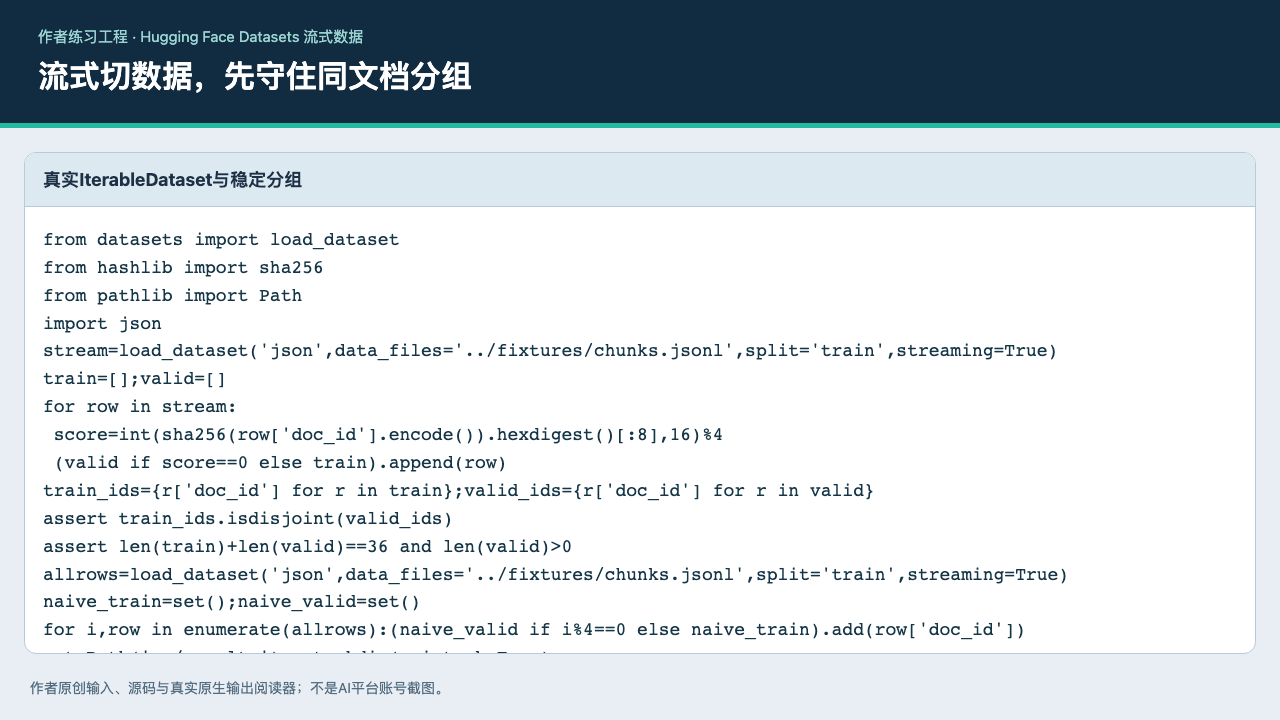
用load_dataset json streaming=True读取本地JSONL,真实对象是IterableDataset,不先整体转换成普通列表再声称流式。
本题本地命令
bash
python split.py3. 使用稳定分组键
对doc_id做SHA稳定分配,所有chunk_id沿用同一文档归属。不要使用跨进程随机化的Python hash作为永久划分合同。
4. 写入两个分片
边迭代边将文档归属的行写入训练或验证,保留doc_id/chunk_id。验证集合必须非空,丢行与重复行都应报错。
5. 检查泄漏交集
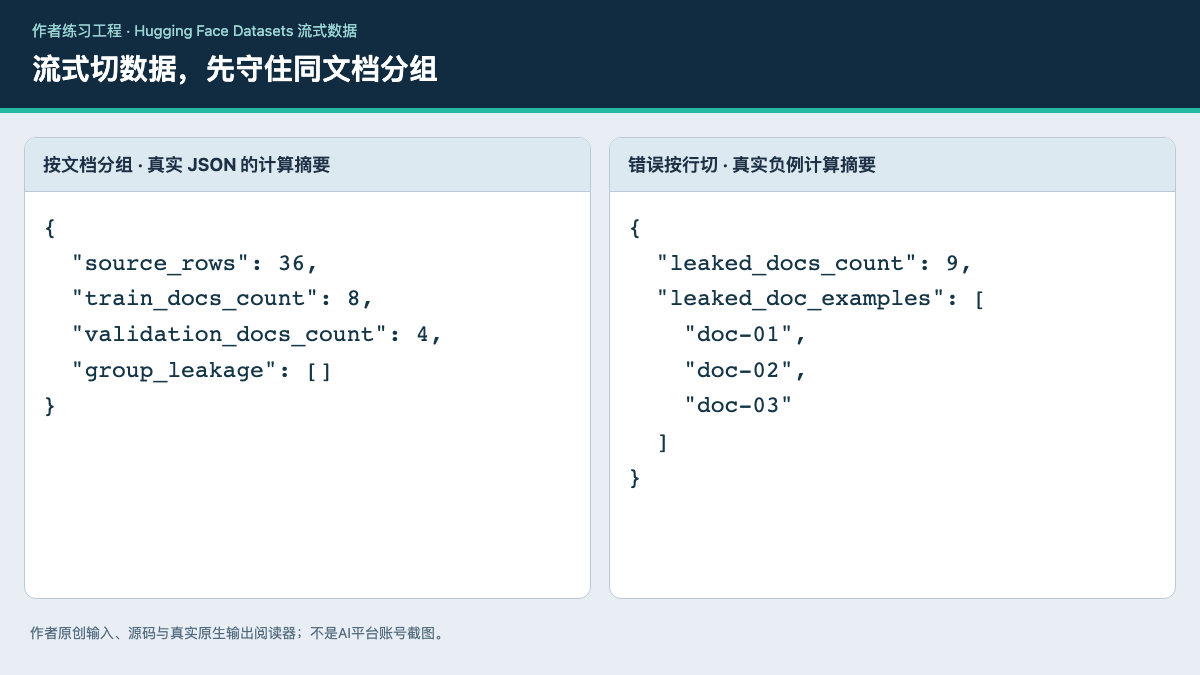
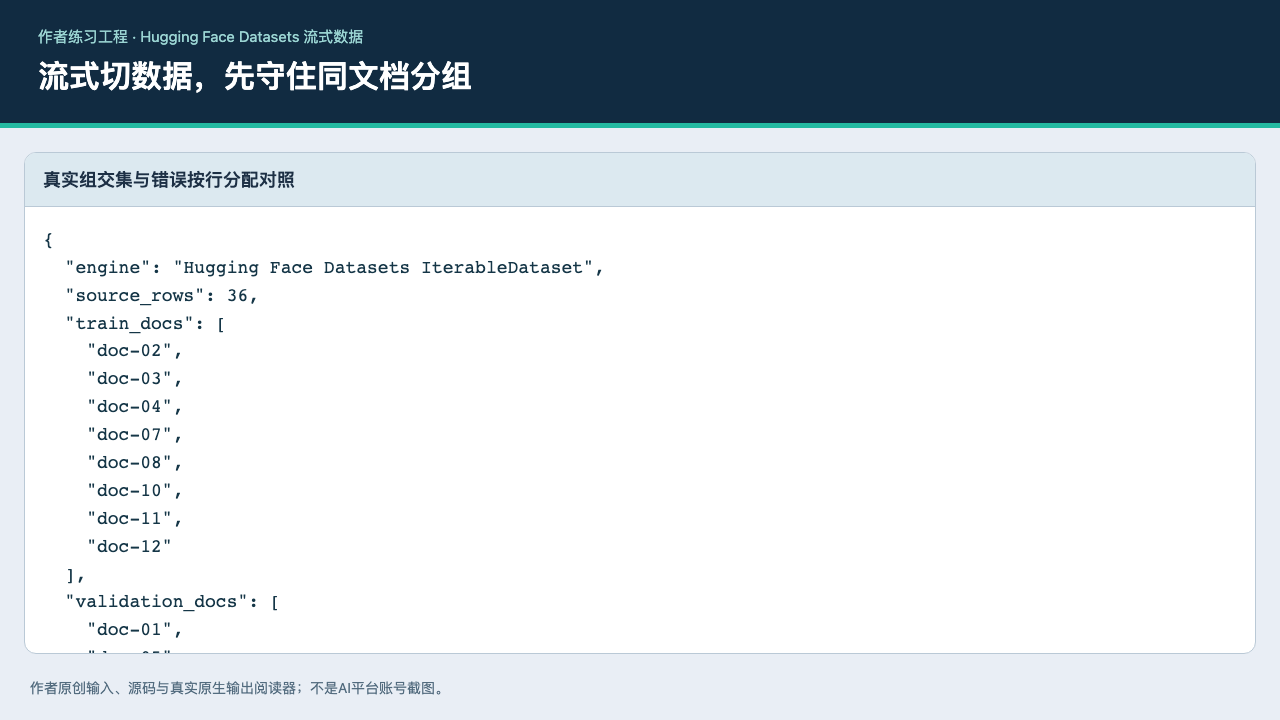
计算训练doc_id与验证doc_id交集,本题为空;总行数仍为36。没有交集只是本题分组边界,不证明所有语义近似都无泄漏。
6. 运行错误对照
按行号轮流切分时,多份文档同时进入两边。真实报告列出这些同源ID,让“随机切行也没问题”的误区可见。
7. 交付分组证据
保存train/validation JSONL与split-report,换进程重跑归属应一致。模型训练或远程下载均不在本题执行范围。
怎样确认已经完成
- 不按行随机切导致同文档泄漏
- 文档ID交集为空
- 未下载模型权重
- 已运行Hugging Face Datasets真实IterableDataset,36片段按12文档稳定分组且训练/验证无同源交集;未下载远端数据集或训练模型。
常见问题
流式数据怎么切训练集才不会把同一文档拆到两边?
先给同源片段同一个doc_id,再按doc_id稳定分配到某一侧;不能直接随机切行。本文真实流式迭代后两边文档ID交集为空。
Hugging Face Datasets 不完整下载也能复现分片吗?
不一定。同源片段可能分散在两边让验证偏乐观;应检查组交集、重复项、时间边界与数据覆盖,而不只看行数比例。
哪些功能已经实际执行?
已运行Hugging Face Datasets真实IterableDataset,36片段按12文档稳定分组且训练/验证无同源交集;未下载远端数据集或训练模型。