
展开本页目录
开始前准备什么
- 下载练习包,先阅读 README 中的依赖和运行范围。
- 使用独立练习目录;starter 是待完成任务,reference 是作者参考实现。
- 账号型功能须在自己的授权环境执行;本题不要求提供真实凭据。
- 定义命名输入
- 实现加载上下文
- 保存签名与样例
- 移交模型目录
- 新进程回读预测
- 拒绝错误列
- 封存依赖边界
1. 定义命名输入
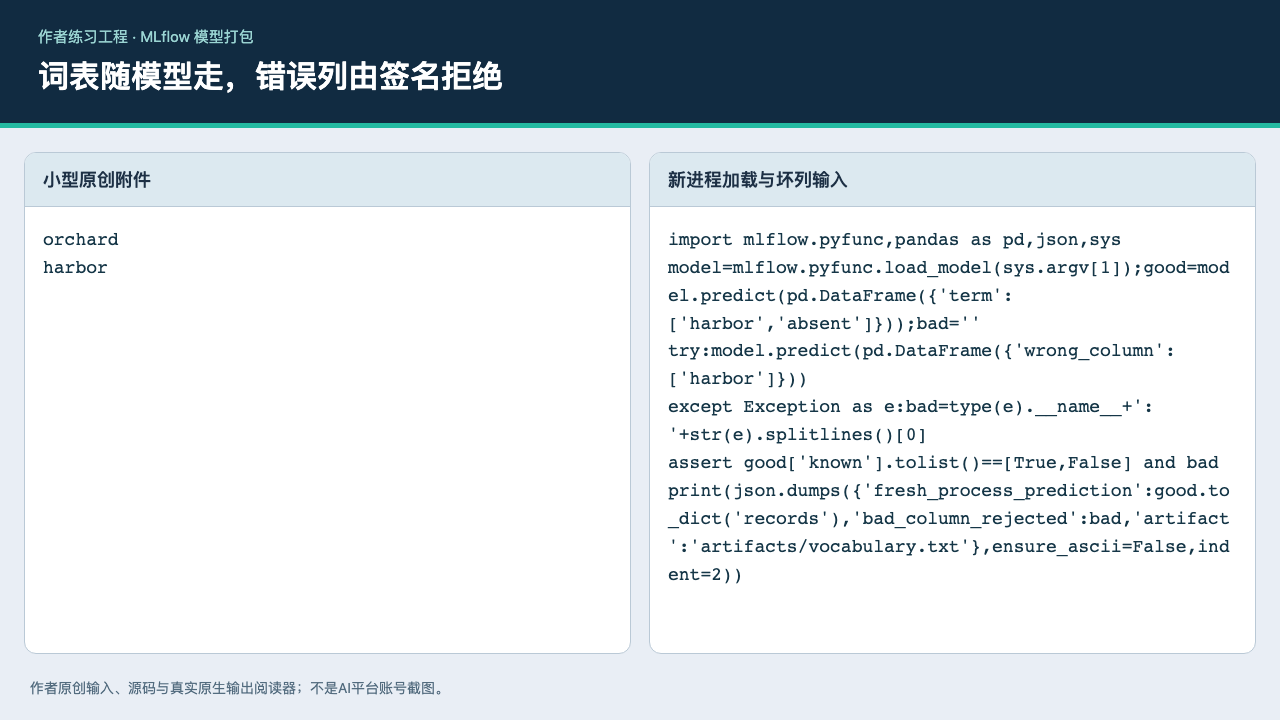
原创模型输入term列,输出known布尔列。词表是独立附件,不把作者机器目录硬编码进predict。
2. 实现加载上下文
PythonModel.load_context从context.artifacts读取词表。真实预测依赖打包后的附件,而非运行目录恰好有同名文件。
本题本地命令
bash
python package_model.py3. 保存签名与样例
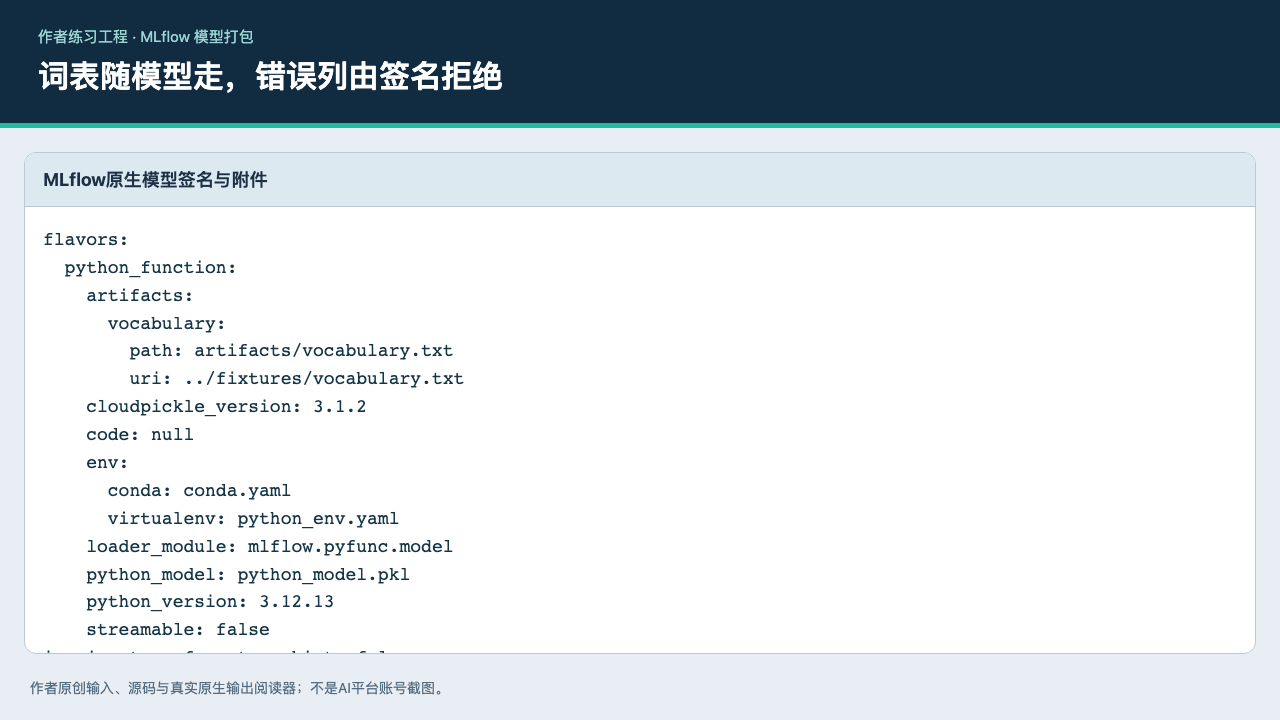
用infer_signature建立term到known合同,附input_example并保存模型。签名和样例用途不同,不能仅存演示JSON。
4. 移交模型目录
把MLmodel、序列化模型与artifacts一同移到独立results/model。相对附件路径须仍可解析。
5. 新进程回读预测
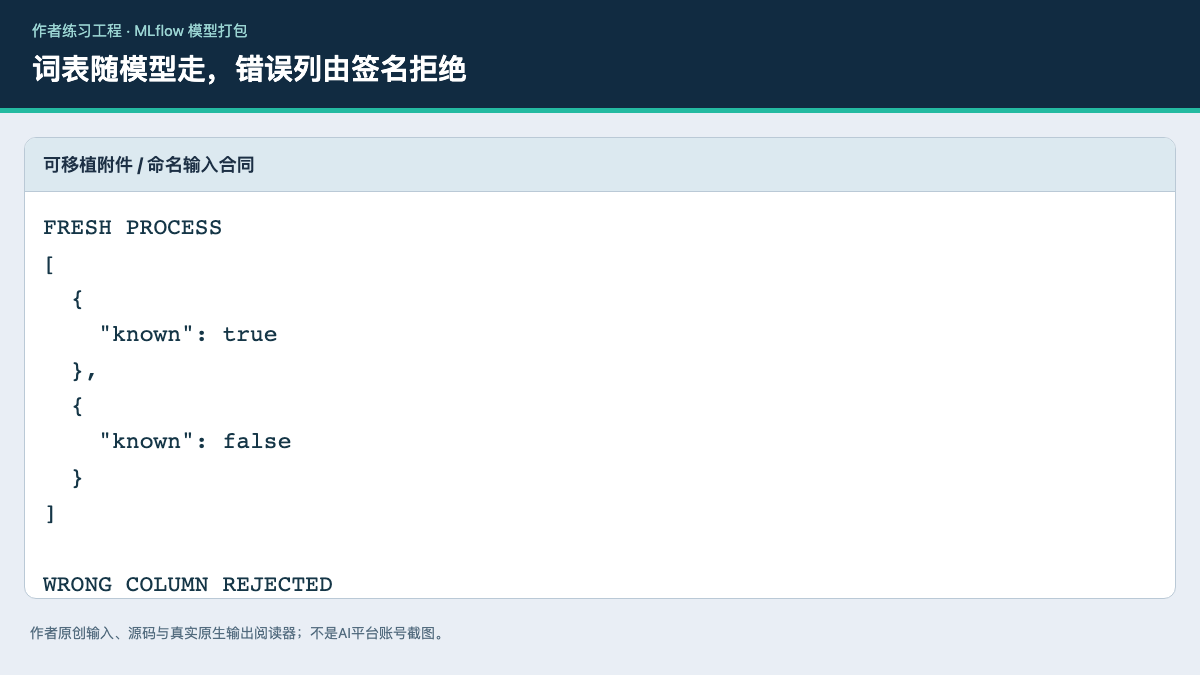
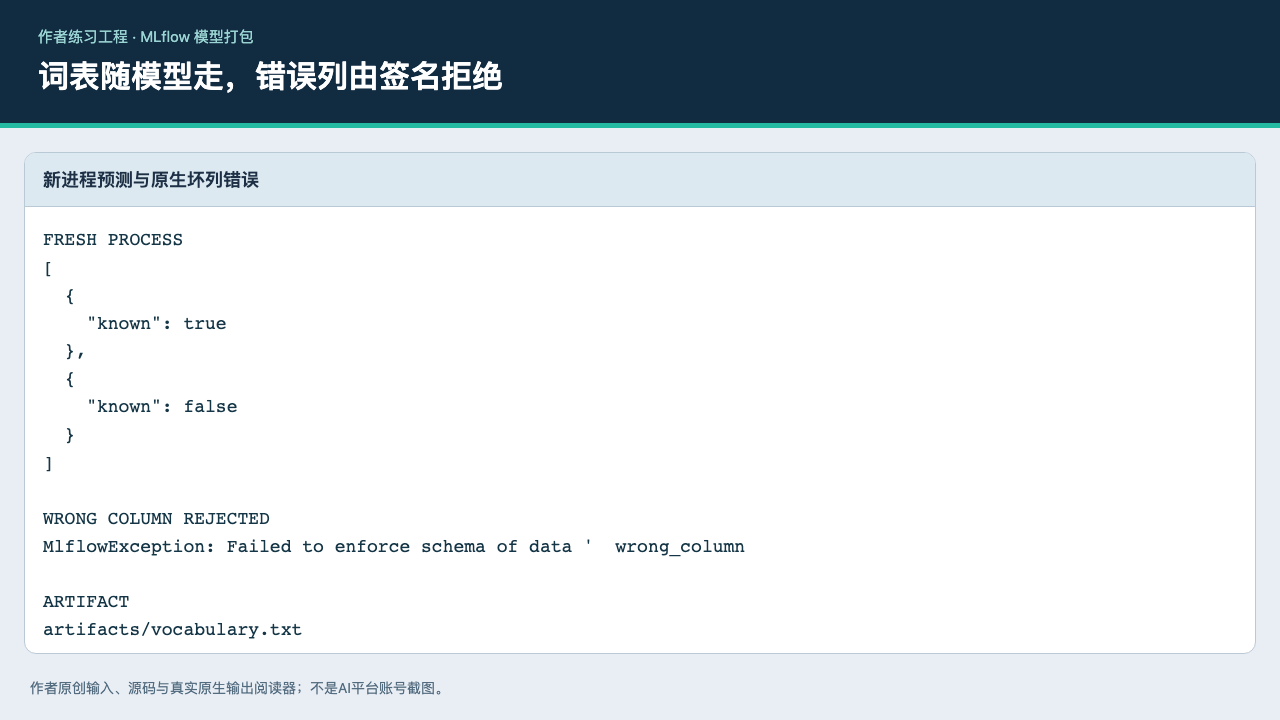
另起Python进程调用mlflow.pyfunc.load_model,用harbor与absent得到True/False。不能只在训练进程里复用内存对象。
6. 拒绝错误列
把term换成wrong_column,实际原生签名校验拒绝。多列或不同dtype的合同还需按自己的模型补充测试。
7. 封存依赖边界
交付小模型目录、输入样例和新进程结果。只加载可信模型文件,本文未执行远端注册、推理服务或大型权重。
怎样确认已经完成
- 正确输入可回读
- 错误列在推理前拒绝
- 附件路径相对
- 不做模型质量泛化结论
- 已运行MLflow pyfunc保存签名/词表附件,并在新Python进程加载预测;错误命名列被原生拒绝。模型为作者小型词表分类器,未训练或调用LLM。
常见问题
AI 模型打包后怎么避免换环境就找不到附件?
把输入签名、input example、PythonModel与附件一起保存,再换新进程加载验证。仅复制pickle不保证词表等外部文件仍可用。
MLflow 能在模型运行前发现传错列吗?
用签名明确命名列,再实际传wrong_column验证。本文正确term可预测,错误列被MLflow原生校验拒绝,而不是作者手写模拟报错。
哪些功能已经实际执行?
已运行MLflow pyfunc保存签名/词表附件,并在新Python进程加载预测;错误命名列被原生拒绝。模型为作者小型词表分类器,未训练或调用LLM。