
展开本页目录
开始前准备什么
- 下载练习包,先阅读 README 中的依赖和运行范围。
- 使用独立练习目录;starter 是待完成任务,reference 是作者参考实现。
- 账号型功能须在自己的授权环境执行;本题不要求提供真实凭据。
- 保留多页结构
- 逐页核对页码
- 声明续写合同
- 调用原生多页
- 检查跨页条目
- 排查重复和遗漏
- 移交原文与对照
1. 保留多页结构
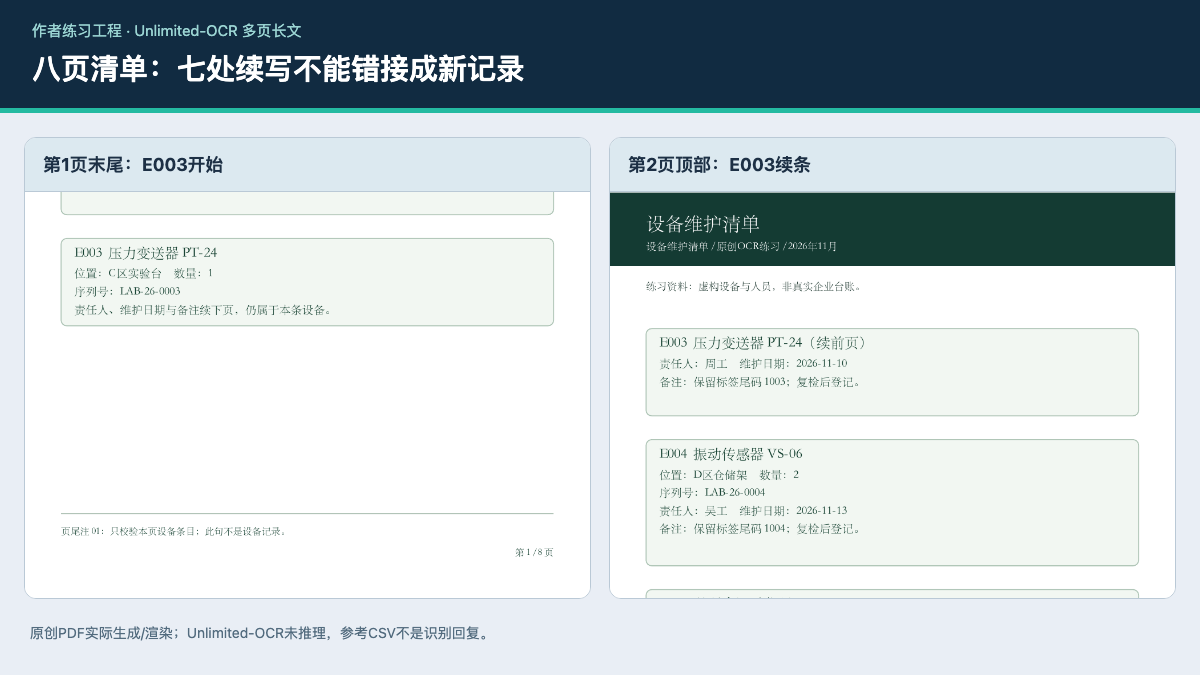
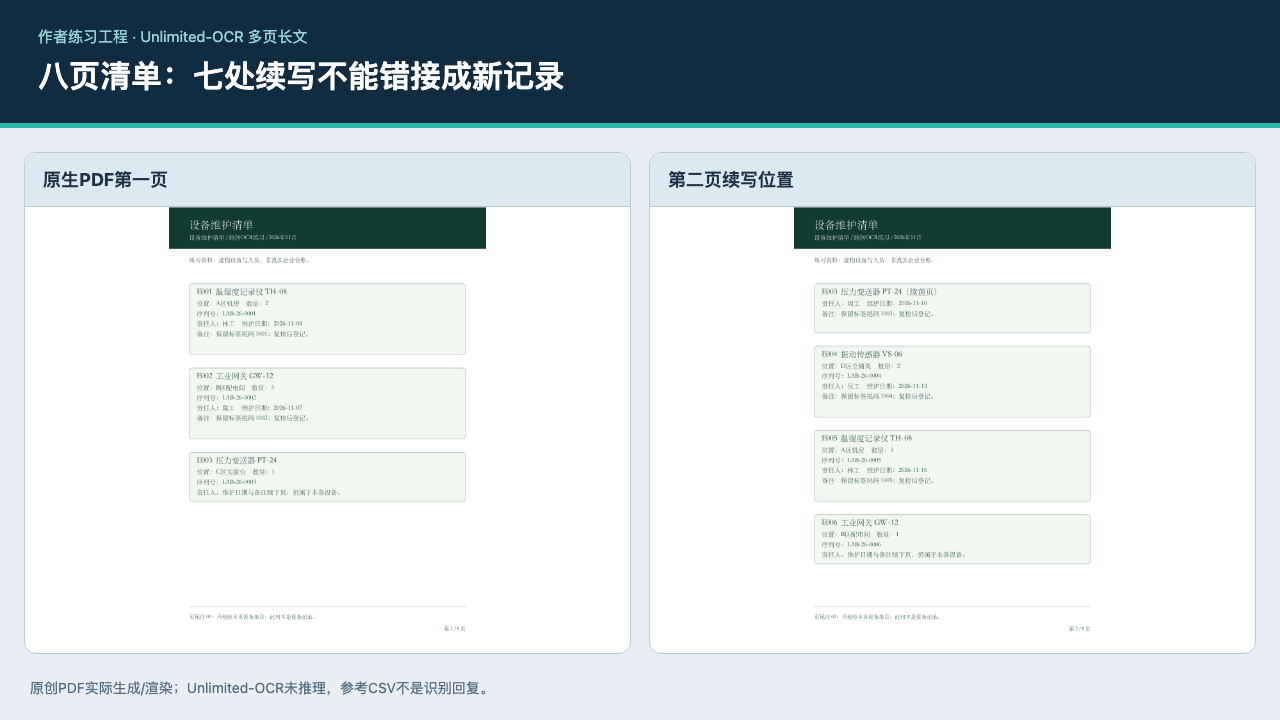
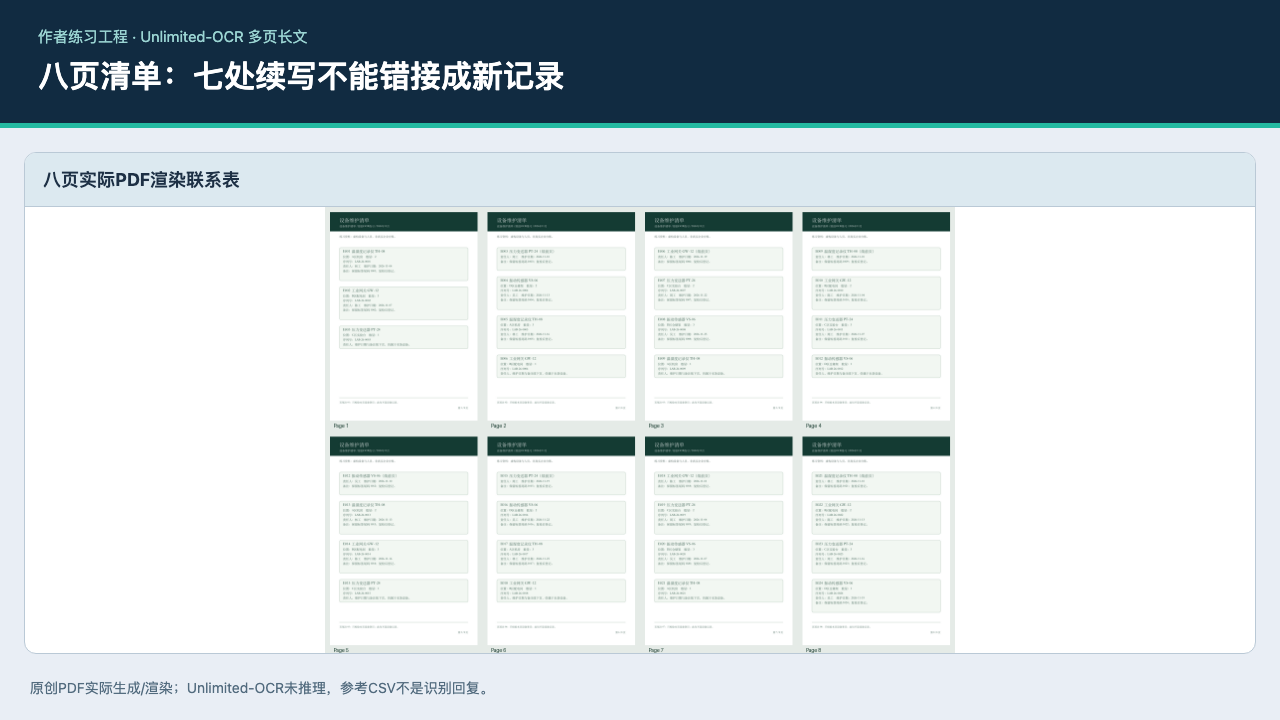
原始设备清单8页、24条记录,7个条目跨页续写。不要先把作者真值输入模型,否则无法评估是否真的读取页面。
2. 逐页核对页码
查看PDF与page-1到page-8原生渲染,确认输入文件顺序。文件名字母排序或漏一页都会影响上下文续接。
本题本地命令
bash
对照 fixtures/page-1.png … page-8.png
# 自有Unlimited-OCR环境按页序输入后另存真实结果
3. 声明续写合同
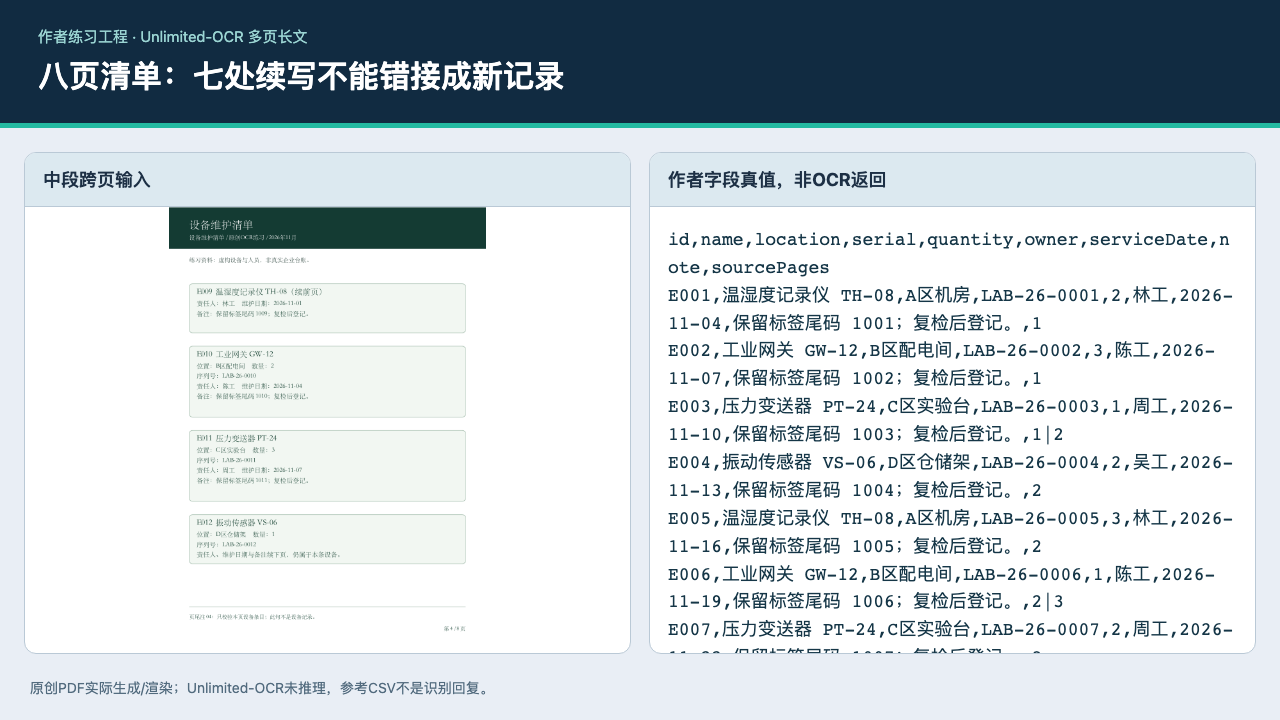
要求记录保留id、名称、序号、数量、负责人和sourcePages。续页文本属于上一条时应合并,不能另建无id新条目。
4. 调用原生多页
在自己的Unlimited-OCR环境按官方多页示例送入有序图像,保留真实返回。本文不运行权重或云推理,results不放伪造识别回复。
5. 检查跨页条目
重点对照E003/E006等七个跨页ID,回看前页末尾与后页开头。数量相同不能证明备注、日期和位置已经配对正确。
6. 排查重复和遗漏
比较24条id集合、字段与sourcePages,区别缺记录、重复记录和字段错归。识别不清写待核,不用作者真值悄悄补齐后报告满分。
7. 移交原文与对照
分发8页PDF/PNG及明确作者参考CSV/JSON。真实OCR结果由读者另存,再做逐字段差异,避免把规则校验冒充模型识别。
怎样确认已经完成
- 多页不能套单图gundam配置
- 原输出完整保留
- 不删重复文本来假装修正模型
- 已生成并实际渲染8页原创PDF、24条作者真值与7处跨页续写;Unlimited-OCR未下载或推理,reference不是OCR结果,不伪造识别准确率。
常见问题
Unlimited-OCR 能一次读完有续页条目的长清单吗?
原生多页输入需要保持顺序和条目ID,让续页内容合回上一条。本题有7处真实跨页续写可检查,模型推理尚未执行。
多页 OCR 怎么检查跨页条目是不是漏了或重复了?
不能。还要核对ID集合、每个字段、重复项和sourcePages;24行也可能把一条漏掉又重复另一条,不能只比较总数。
哪些功能已经实际执行?
已生成并实际渲染8页原创PDF、24条作者真值与7处跨页续写;Unlimited-OCR未下载或推理,reference不是OCR结果,不伪造识别准确率。