
展开本页目录
开始前准备什么
- Firefly网页Voice to sound effects入口、可用账户/地区/额度和麦克风或音频上传。录制上限为30秒或视频长度较短者;声音只引导时间/能量,不生成语音歌词。
- 解压本页独立练习包,先读README中的素材身份与执行范围;保留原文件并另存实际结果。
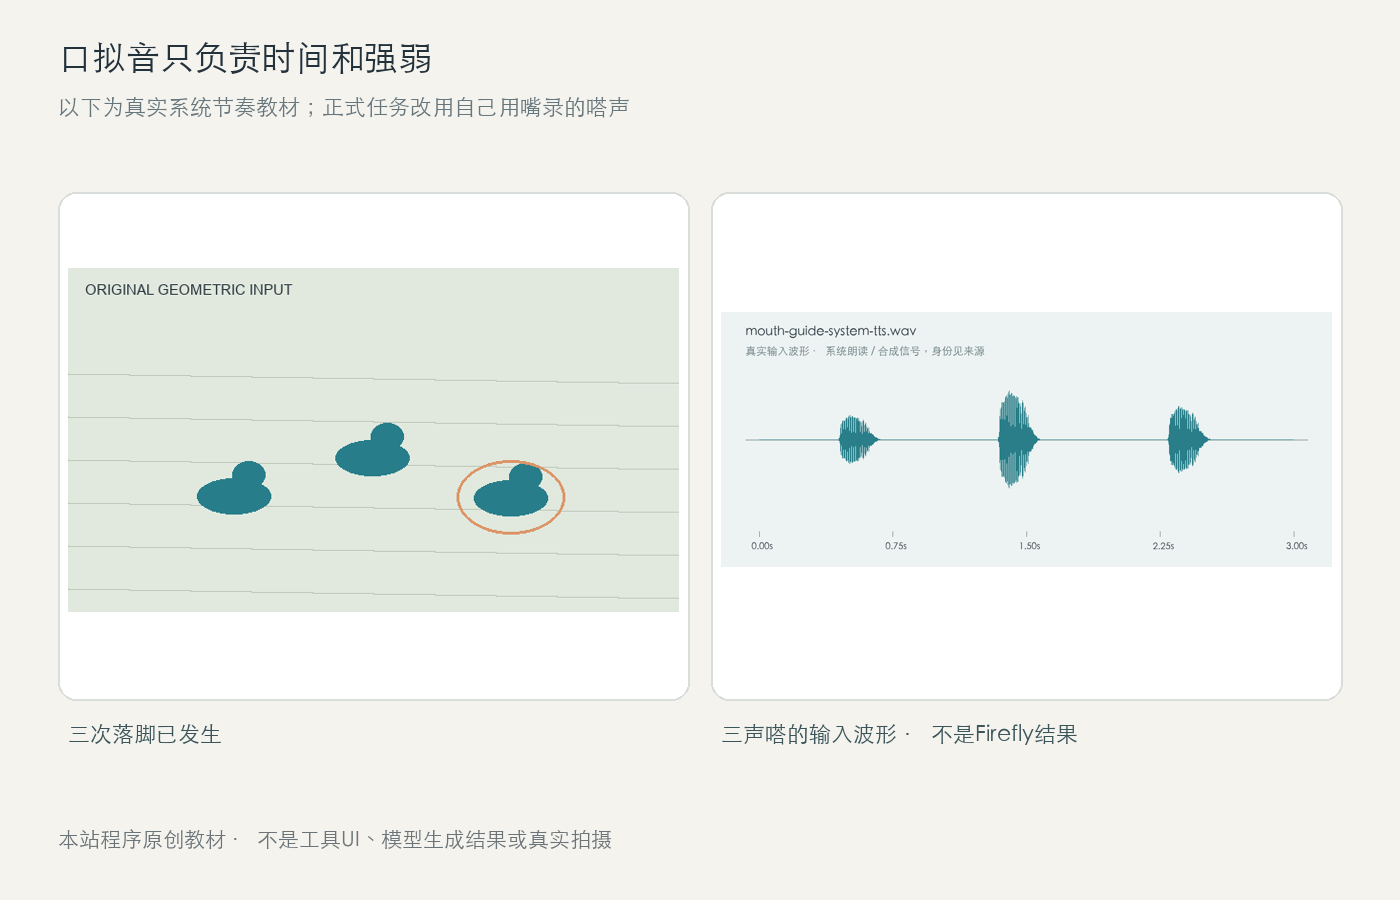
- 先看三次脚落地的位置
- 打开Voice to sound effects
- 对着画面用嘴模仿三次嗒声
- 试听口拟音并定位播放头
- 加材质描述再生成变体
- 选变体后逐次回听落脚
- 导出并保留引导与生成轨
原创输入、提示/参数、7步README、来源与检查表;无模型权重或账号。
分清真实输入、程序参考与待运行的模型输出。
用实际输出填写每一项,不把本地文件检查当效果验收。
教学记录格式,软件原生导入能力另行确认。
1. 先看三次脚落地的位置
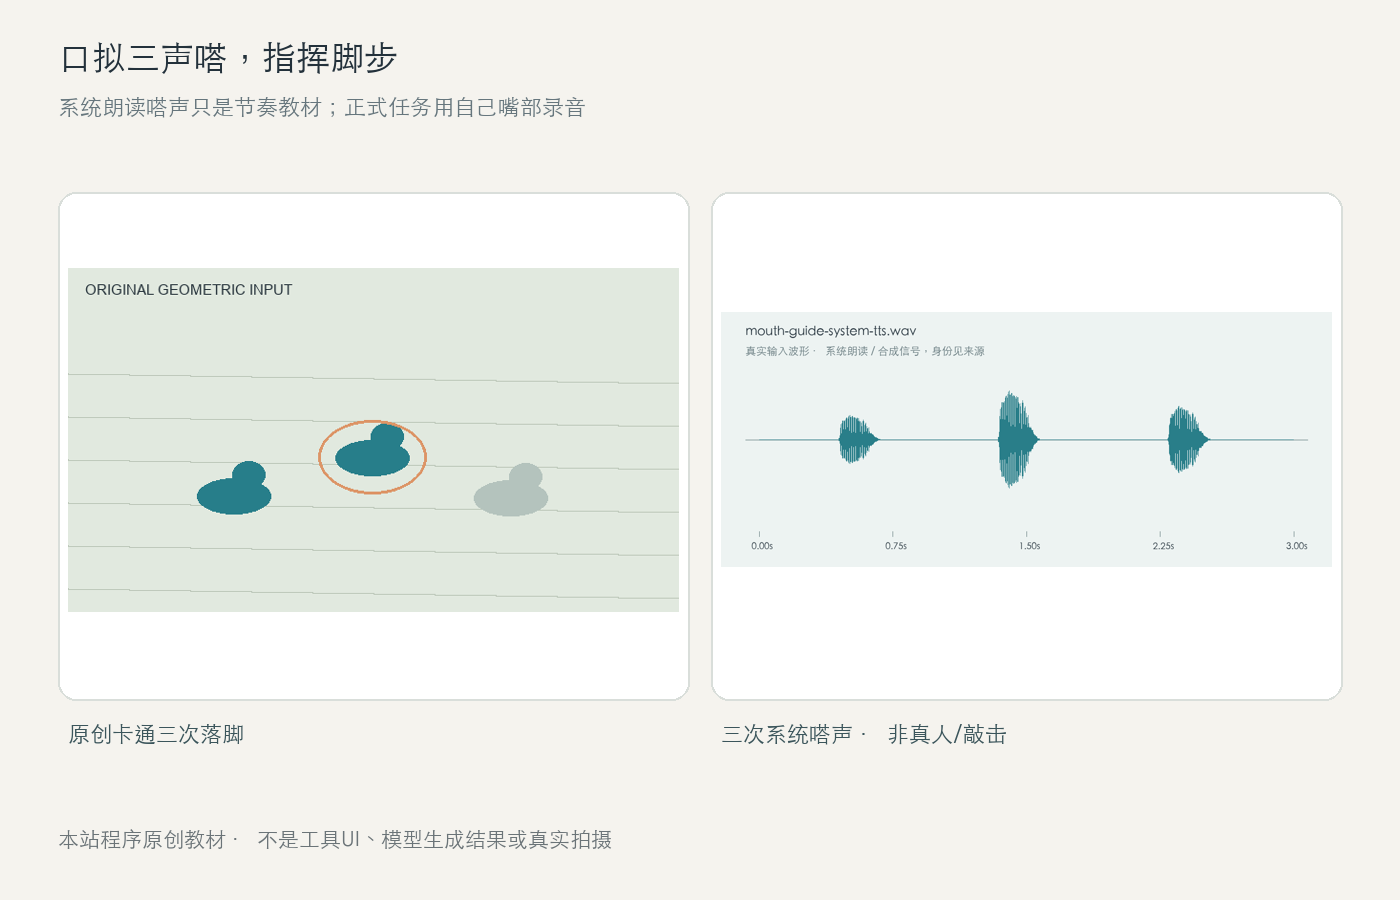
播放input.mp4并核对footsteps.csv。mouth-guide-system-tts.wav是系统朗读“嗒”的节奏教材,只展示三次强弱与时间;不是实际敲击录音,也没有冒称真人口拟音。
2. 打开Voice to sound effects
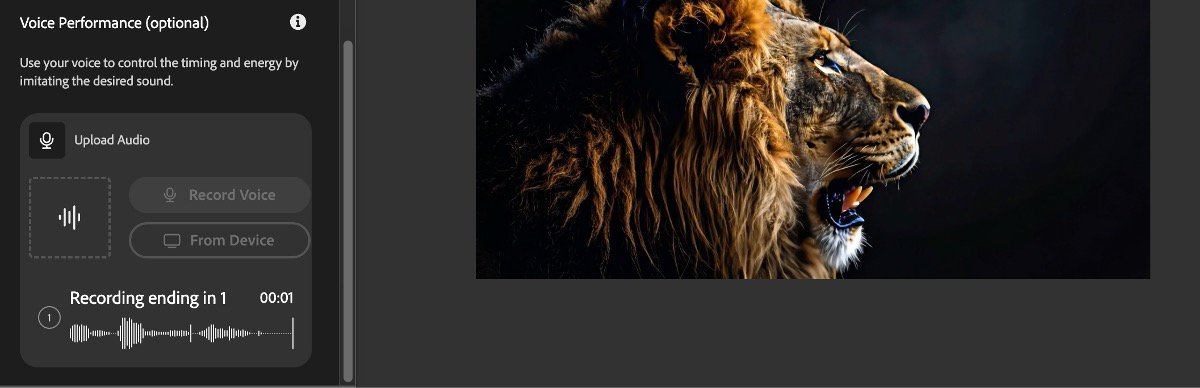
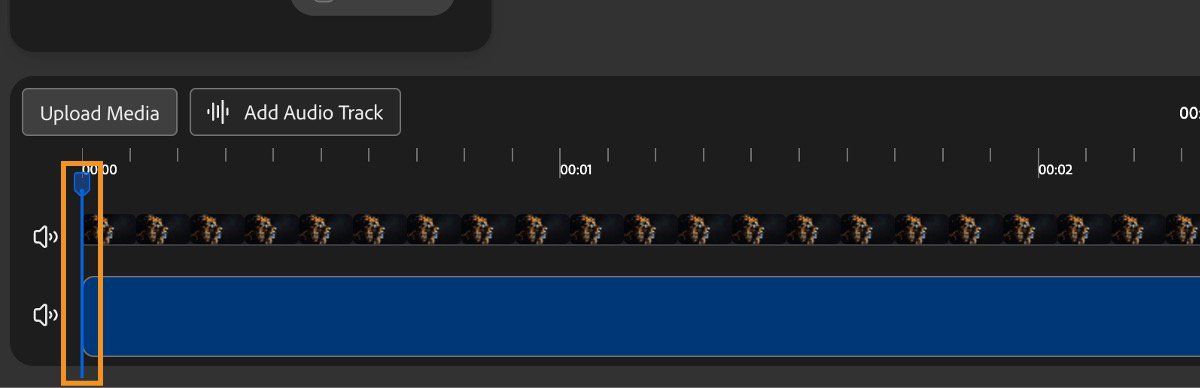
在Firefly网页的Audio区域进入Voice to sound effects,上传原创静音片。官方操作图用于辨认Voice performance和播放头,不代表本站已登录、上传或获得额度。
3. 对着画面用嘴模仿三次嗒声
正式任务选择Record voice,按画面落脚时刻用嘴发三次“嗒”,用轻重表达预期力度。也可上传自己录制的口拟音;本题不把真实敲桌声称作“人声”。
4. 试听口拟音并定位播放头
录完先回放,确认三声与画面对应,再把playhead放在音效应开始的位置。不要把整条引导音偏移后只靠提示词补救,时间和强弱应由录音先表达。
prompt.txt
Three soft cartoon footsteps on a wooden floor, guided by the uploaded vocal performance timing and intensity, no speech, no music.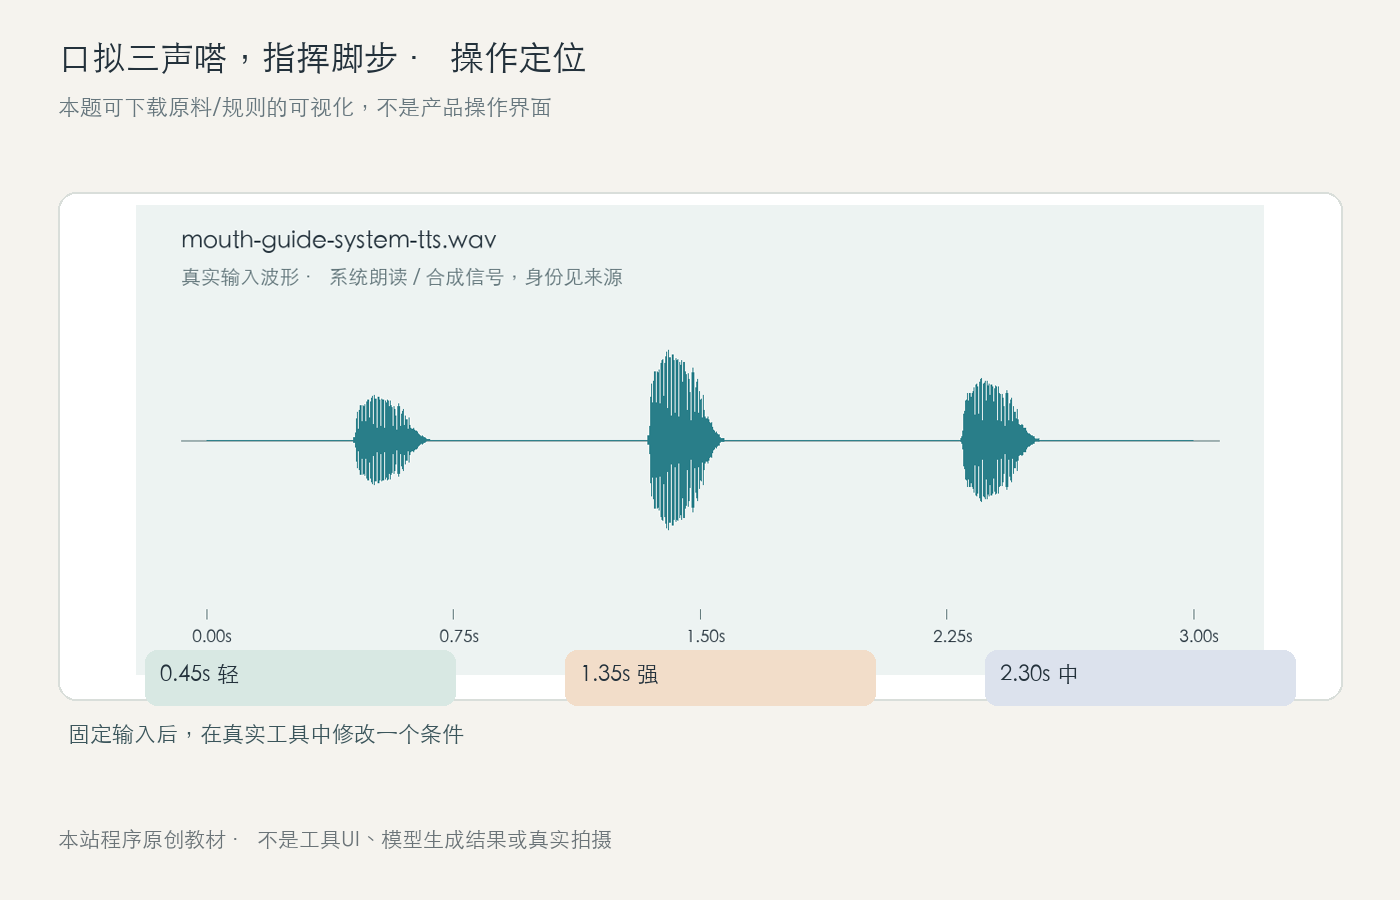
5. 加材质描述再生成变体
使用prompt.txt中的soft cartoon footsteps说明想变成的声音,保留已附加的voice performance。不是请求朗读“嗒嗒嗒”,也不是生成歌曲;只提交短样并查看真实额度提示。
6. 选变体后逐次回听落脚
把选中真实音效放入时间线,逐个检查三次落脚的时刻与强弱,确认原始口拟人声没有作为最终轨漏入。官方图里的狮吼只是原作者示例,不是脚步结果。
7. 导出并保留引导与生成轨
保留自己的口拟音、生成音效、成片和选择记录。网页Voice performance能力不等于API有同等字段,本篇不把apizt聊天接口当Firefly音效入口。
怎样确认已经完成
- 正式引导来自自己口拟三声嗒,系统节奏教材不冒称真人录音。
- 三次落脚与音效时间/强弱对应,原始口拟音不泄漏到最终轨。
- 引导音、Firefly真实输出与官方截图分开归档。
常见问题
用嘴模仿脚步让AI生成音效,这篇从哪里开始?
先用第1步的具体输入,再按照Firefly Voice to Sound Effects原生入口操作。录完先回放,确认三声与画面对应,再把playhead放在音效应开始的位置。不要把整条引导音偏移后只靠提示词补救,时间和强弱应由录音先表达。
AI音效怎么跟动作对齐,怎么确认结果真的完成?
正式引导来自自己口拟三声嗒,系统节奏教材不冒称真人录音。 三次落脚与音效时间/强弱对应,原始口拟音不泄漏到最终轨。 结构回读不代替播放、试听或逐处检查。
Firefly 人声转音效是否需要apizt API?
本题主要使用工具原生本地或官方网页能力,不要求apizt Key。Firefly网页Voice to sound effects入口、可用账户/地区/额度和麦克风或音频上传。录制上限为30秒或视频长度较短者;声音只引导时间/能量,不生成语音歌词。
Firefly Voice to Sound Effects的英文资料应该搜什么?
可用“Adobe Firefly voice to sound effects timing energy performance”查找对应能力;先确认官方来源中的模型/工作流,再核对本文输入和实际输出,不套用同名第三方服务参数。