
展开本页目录
开始前准备什么
- Python≥3.11,官方推荐CUDA;sam-audio-small/base/large需申请Hugging Face权重访问并认证,采用自定义SAM License。重排/跨度预测会增加时间和内存。
- 解压本页独立练习包,先读README中的素材身份与执行范围;保留原文件并另存实际结果。
- 先试听混音与已知目标
- 申请并下载正确模型
- 用短语只描述一个声音
- 先用最小分离配置
- 同时保存target与residual
- 逐次铃响核对漏提和串音
- 固定描述后再测试真实素材
原创输入、提示/参数、7步README、来源与检查表;无模型权重或账号。
分清真实输入、程序参考与待运行的模型输出。
用实际输出填写每一项,不把本地文件检查当效果验收。
教学记录格式,软件原生导入能力另行确认。
1. 先试听混音与已知目标
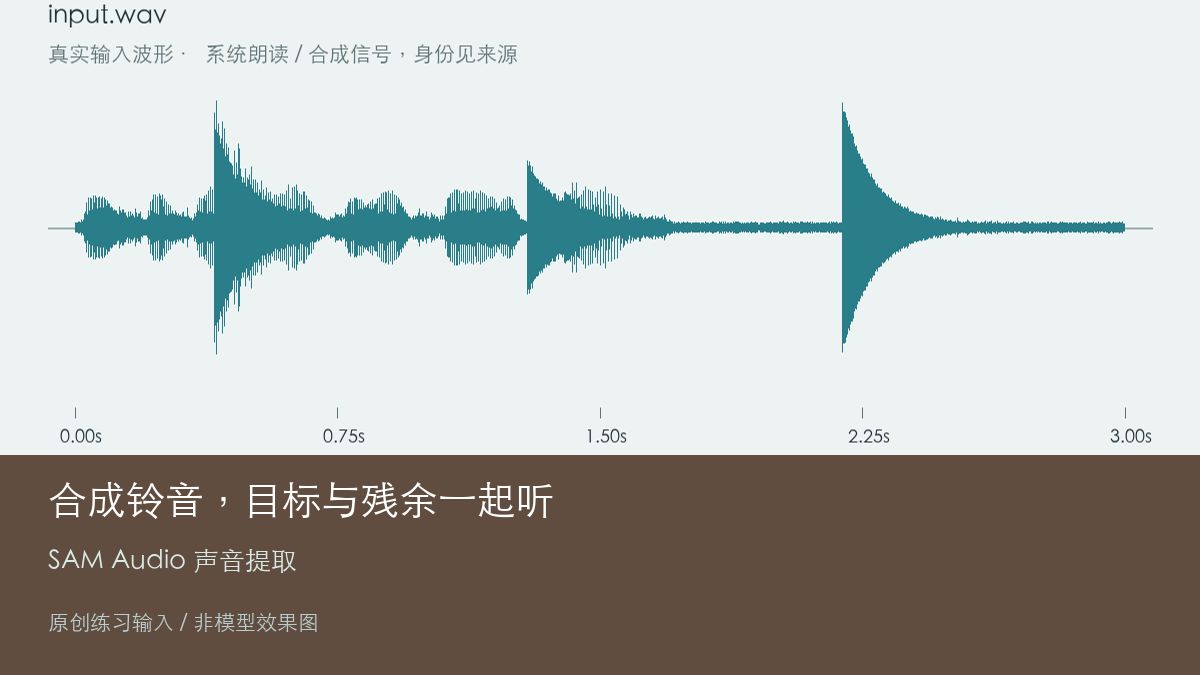
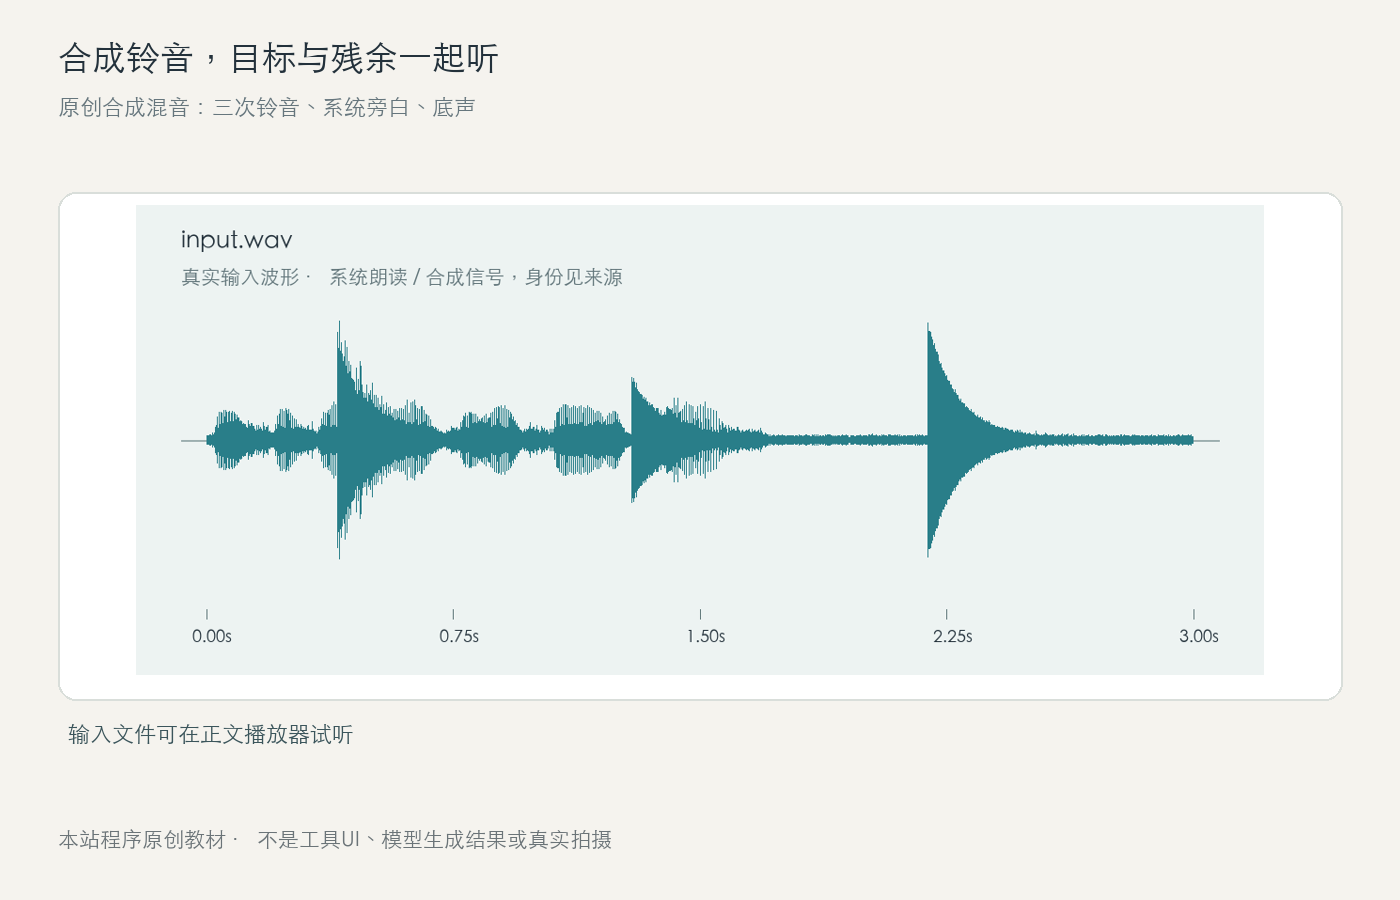
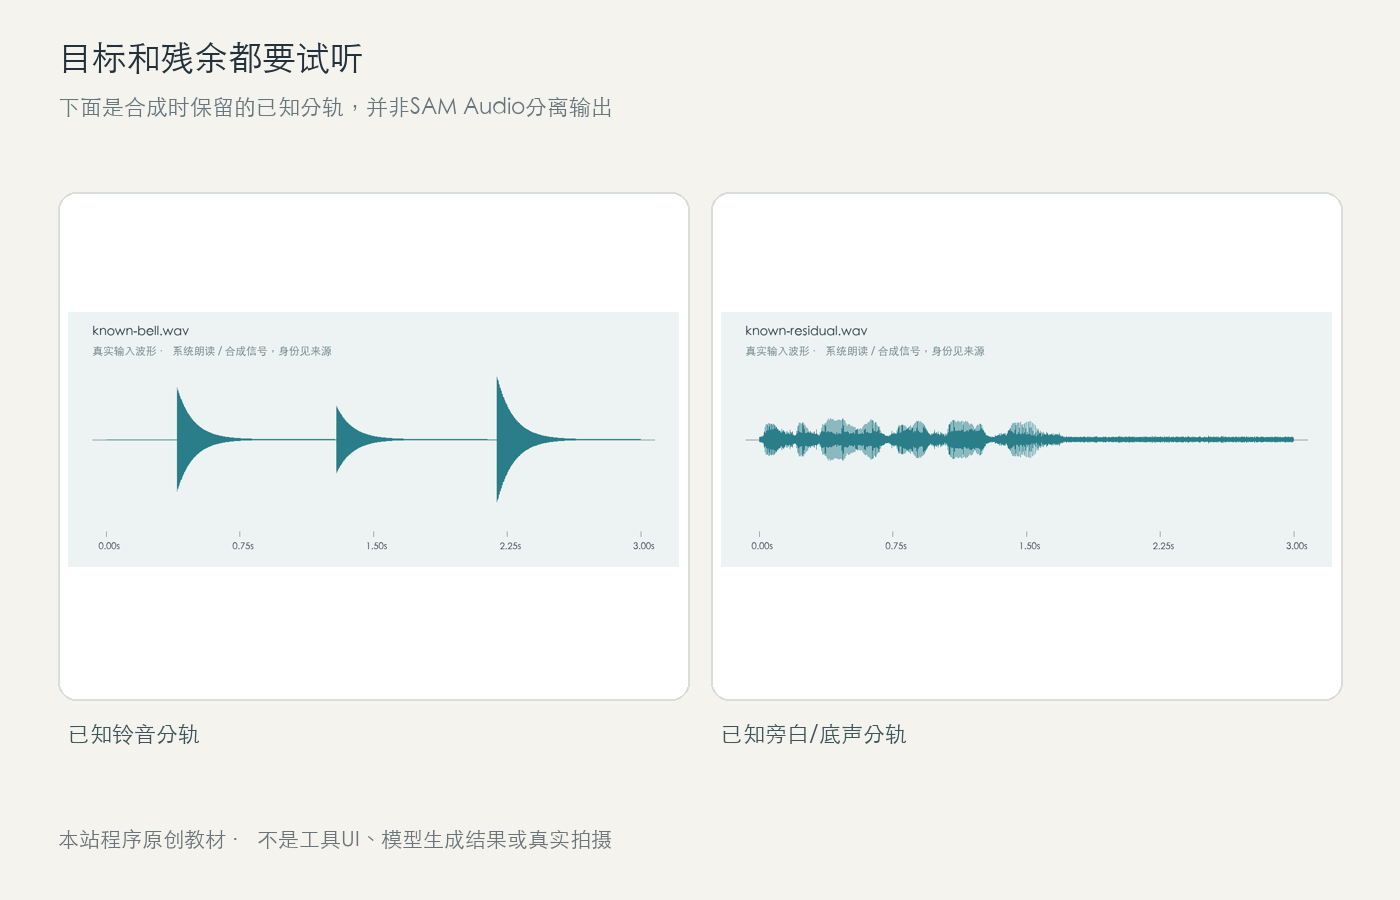
input.wav混合了程序合成的金属衰减音、系统旁白和低幅底声;events.csv给出三次目标事件。known-bell.wav是合成时保留的原分轨,不是真实自行车铃或模型提取轨。
2. 申请并下载正确模型
按官方README申请checkpoint访问,认证后加载准确SAM Audio模型ID。尚未获得访问时先保留本页素材,不能把空target.wav或返回任务名当分离完成。
3. 用短语只描述一个声音
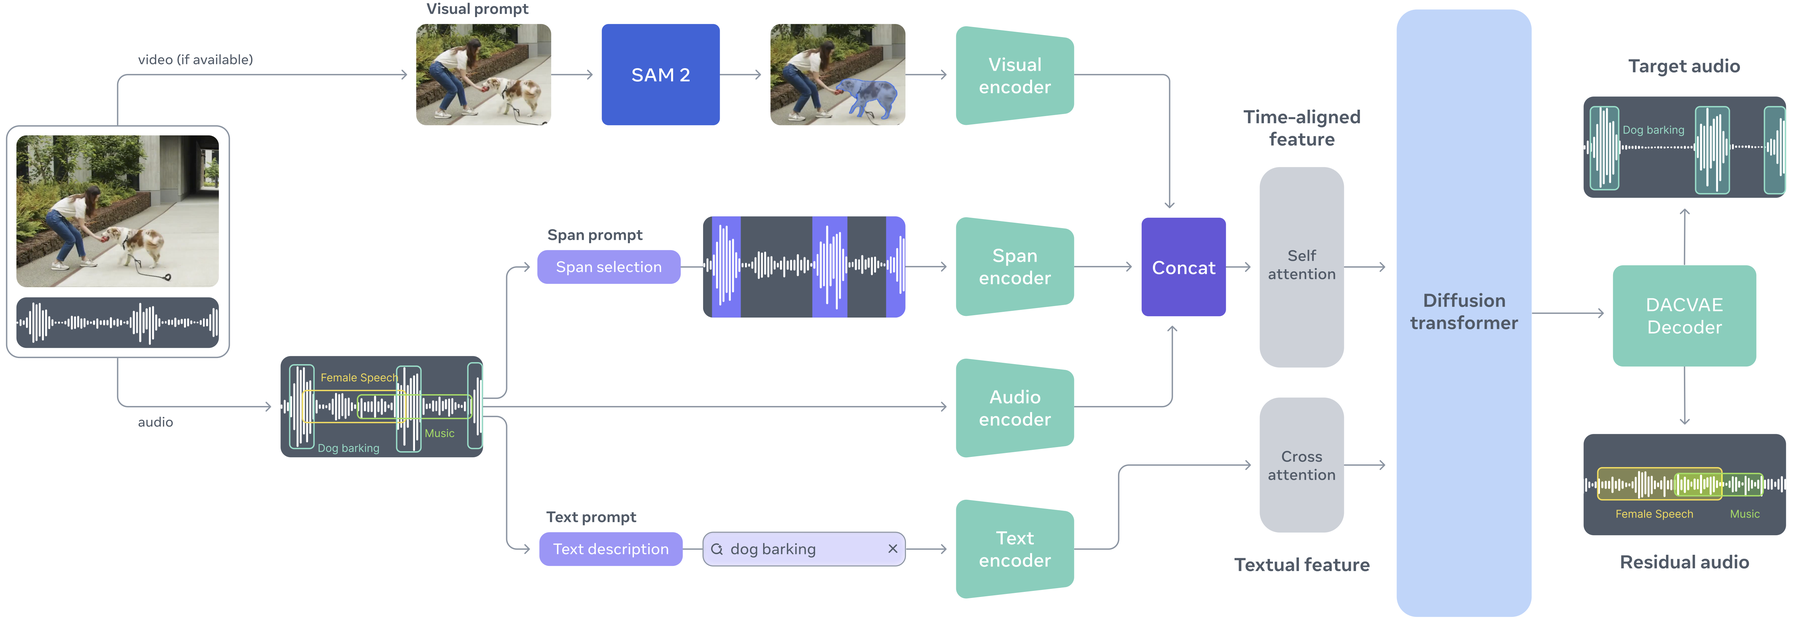
先使用prompt.txt中的lowercase noun phrase,如bell ringing;不要写整段解释或混入man speaking。此题提取铃音,目标不是去掉所有噪声后保留人声。
4. 先用最小分离配置
在已安装官方SAM Audio且获得权重访问的环境运行run-sam.py;它按官方processor输入audios和descriptions,首轮predict_spans=False、reranking_candidates=1。先跑短素材,再决定是否增加候选数。
prompt.txt
bell ringing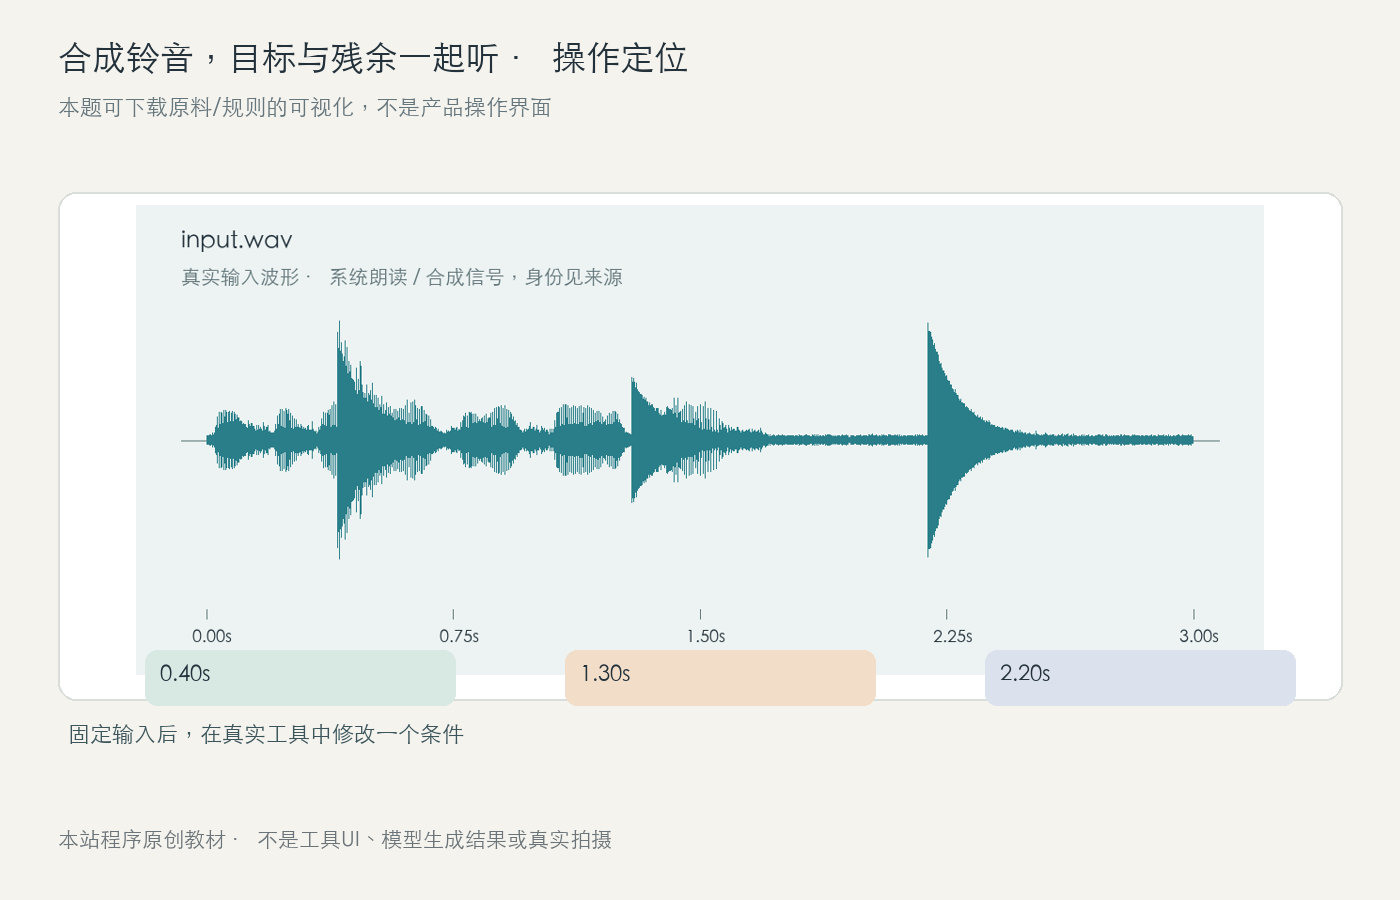
5. 同时保存target与residual
将result.target和result.residual按processor.audio_sampling_rate分别导出。它们各自职责不同;只下载目标轨、不听残余轨,会漏掉铃声仍大部分留在残余中的失败。
6. 逐次铃响核对漏提和串音
按events.csv三处时间回听target.wav是否完整、是否夹人声;再听residual.wav是否仍有明显铃响。波形看起来干净不代表分离正确,必须实际试听。
7. 固定描述后再测试真实素材
通过已知合成事件后,换成自己的真实拍摄声音并重建事件表。不同素材的目标短语与模型配置需重新记录,不能将练习成绩外推任意环境声。
怎样确认已经完成
- 三次目标事件都有记录,不只提取最响的一次。
- 目标轨不明显夹旁白,残余轨没有大量目标残留。
- 官方输出采样率与实际文件一致,已知原分轨另命名。
常见问题
从视频里只提取一个声音,这篇从哪里开始?
先用第1步的具体输入,再按照SAM Audio原生入口操作。在已安装官方SAM Audio且获得权重访问的环境运行run-sam.py;它按官方processor输入audios和descriptions,首轮predict_spans=False、reranking_candidates=1。先跑短素材,再决定是否增加候选数。
保留铃声去掉说话和背景声,怎么确认结果真的完成?
三次目标事件都有记录,不只提取最响的一次。 目标轨不明显夹旁白,残余轨没有大量目标残留。 结构回读不代替播放、试听或逐处检查。
SAM Audio 声音提取是否需要apizt API?
本题主要使用工具原生本地或官方网页能力,不要求apizt Key。Python≥3.11,官方推荐CUDA;sam-audio-small/base/large需申请Hugging Face权重访问并认证,采用自定义SAM License。重排/跨度预测会增加时间和内存。
SAM Audio的英文资料应该搜什么?
可用“SAM Audio text prompt isolate bell target residual”查找对应能力;先确认官方来源中的模型/工作流,再核对本文输入和实际输出,不套用同名第三方服务参数。