
展开本页目录
开始前准备什么
- 官方默认large_44k_v2,Python3.9+、匹配PyTorch/CUDA。官方16bit约6GB是其测试值,三秒练习不同于默认8秒训练长度;作者不保证预训练模型适合商用。
- 解压本页独立练习包,先读README中的素材身份与执行范围;保留原文件并另存实际结果。
- 先标出纸袋的动作和静止
- 准备官方视频到音频环境
- 描述材质而不写台词
- 按实际片长生成短样
- 保留音效和合成视频
- 对齐动作峰值并听静止段
- 只修明确的声音问题
原创输入、提示/参数、7步README、来源与检查表;无模型权重或账号。
分清真实输入、程序参考与待运行的模型输出。
用实际输出填写每一项,不把本地文件检查当效果验收。
教学记录格式,软件原生导入能力另行确认。
1. 先标出纸袋的动作和静止
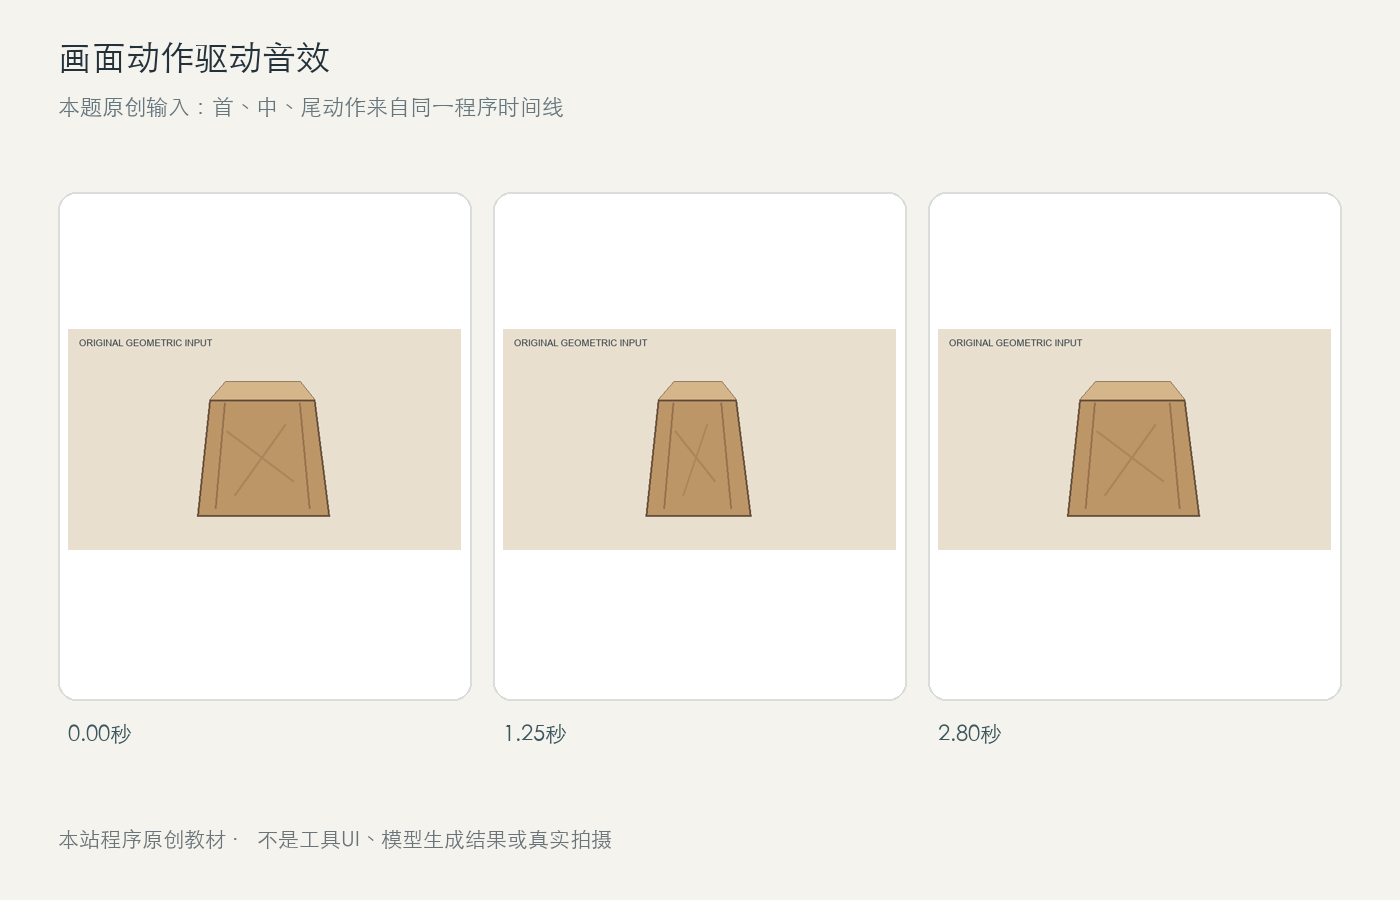
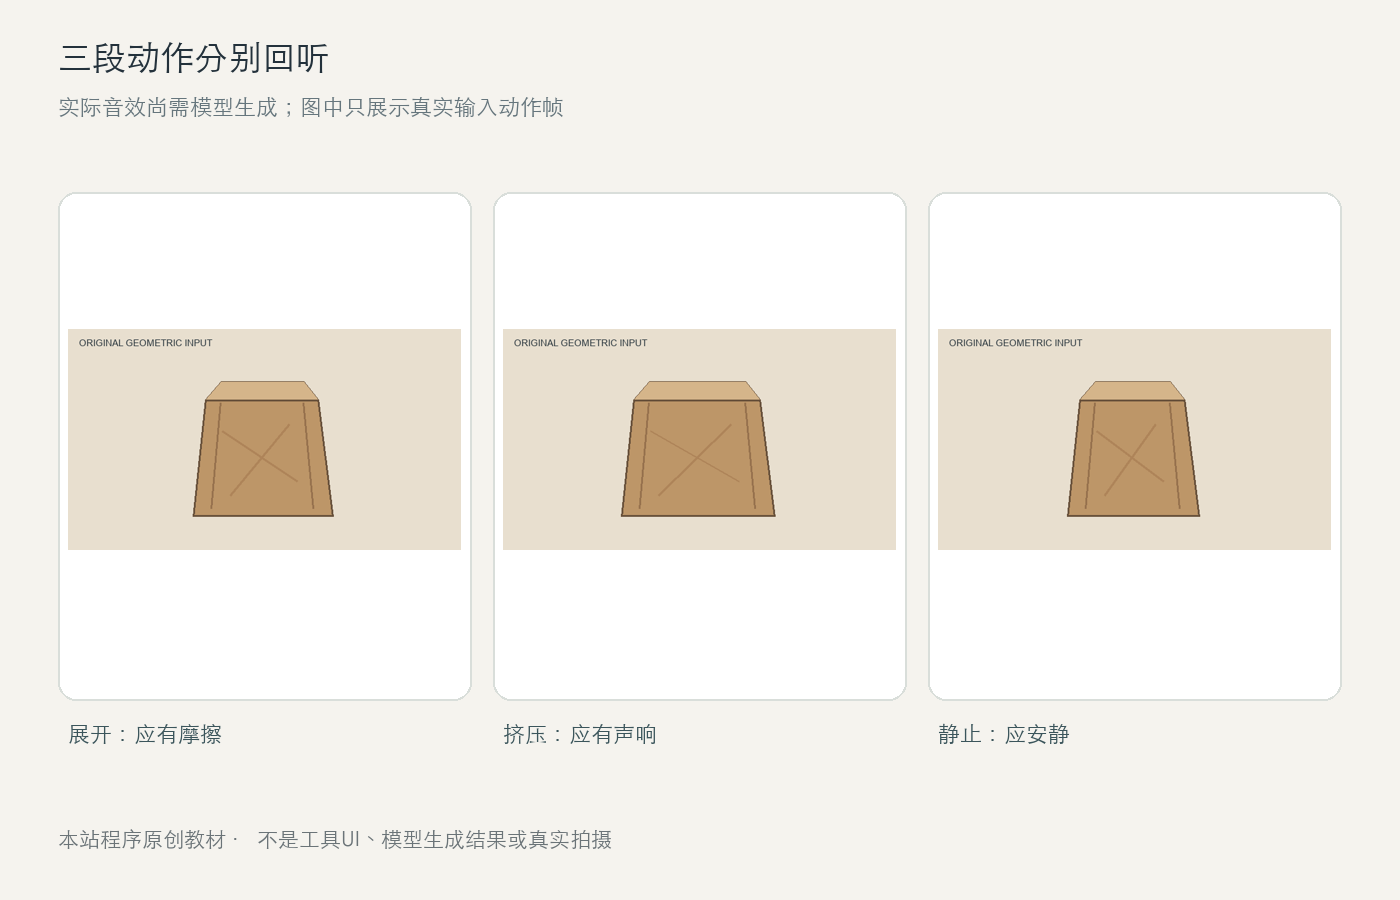
播放input.mp4:这是程序绘制的原创纸袋展开、挤压和停下示意,不是实拍纸袋。actions.csv标记两次动作区间与最后静止段,为后续同步拟音提供明确参照。
2. 准备官方视频到音频环境
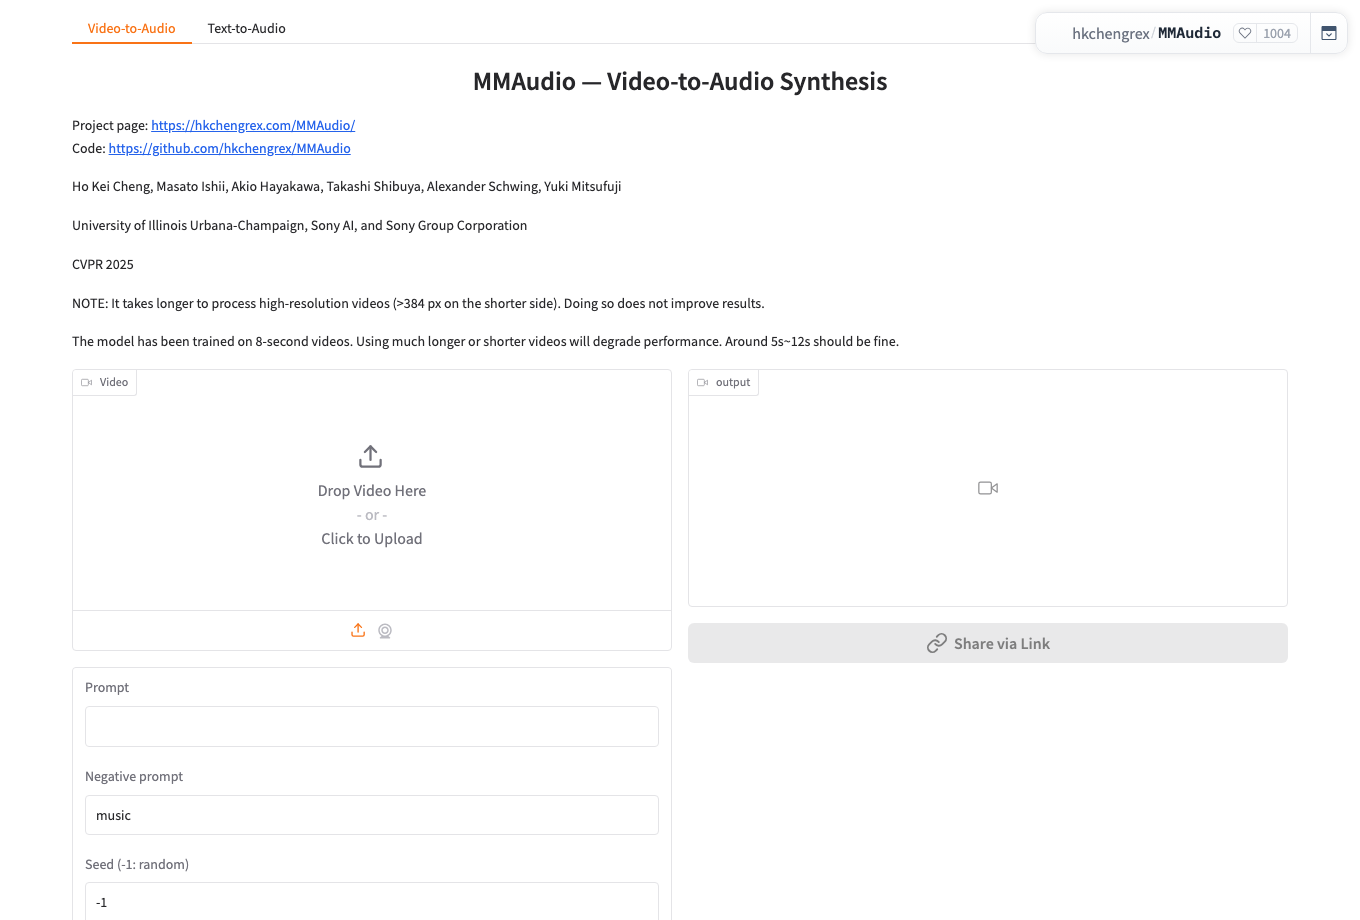
按MMAudio仓库安装PyTorch与依赖,运行时会下载模型;不要把外部API示例当作已安装本地模型。官方Gradio截图只说明video/prompt输入槽,本站未提交生成。
3. 描述材质而不写台词
在prompt.txt使用paper bag rustling等声音描述,避免请求旁白或背景歌曲。保持画面输入,视频条件用于动作同步;只输入文字就是另一条text-to-audio路径。
bash
python demo.py --duration=3 --video=input.mp4 --prompt "Dry paper bag rustling with the visible motion, no speech, no music"4. 按实际片长生成短样
在MMAudio仓库运行demo.py,把input.mp4复制到当前目录或将video参数改为绝对路径,duration设3。官方默认约8秒,偏离时可能变差;如改做8秒素材需明确记录,不能仍称三秒结果。
prompt.txt
A dry paper bag unfolding and being gently crumpled, close detailed paper rustling synchronized with the visible motion, quiet room, no speech, no music.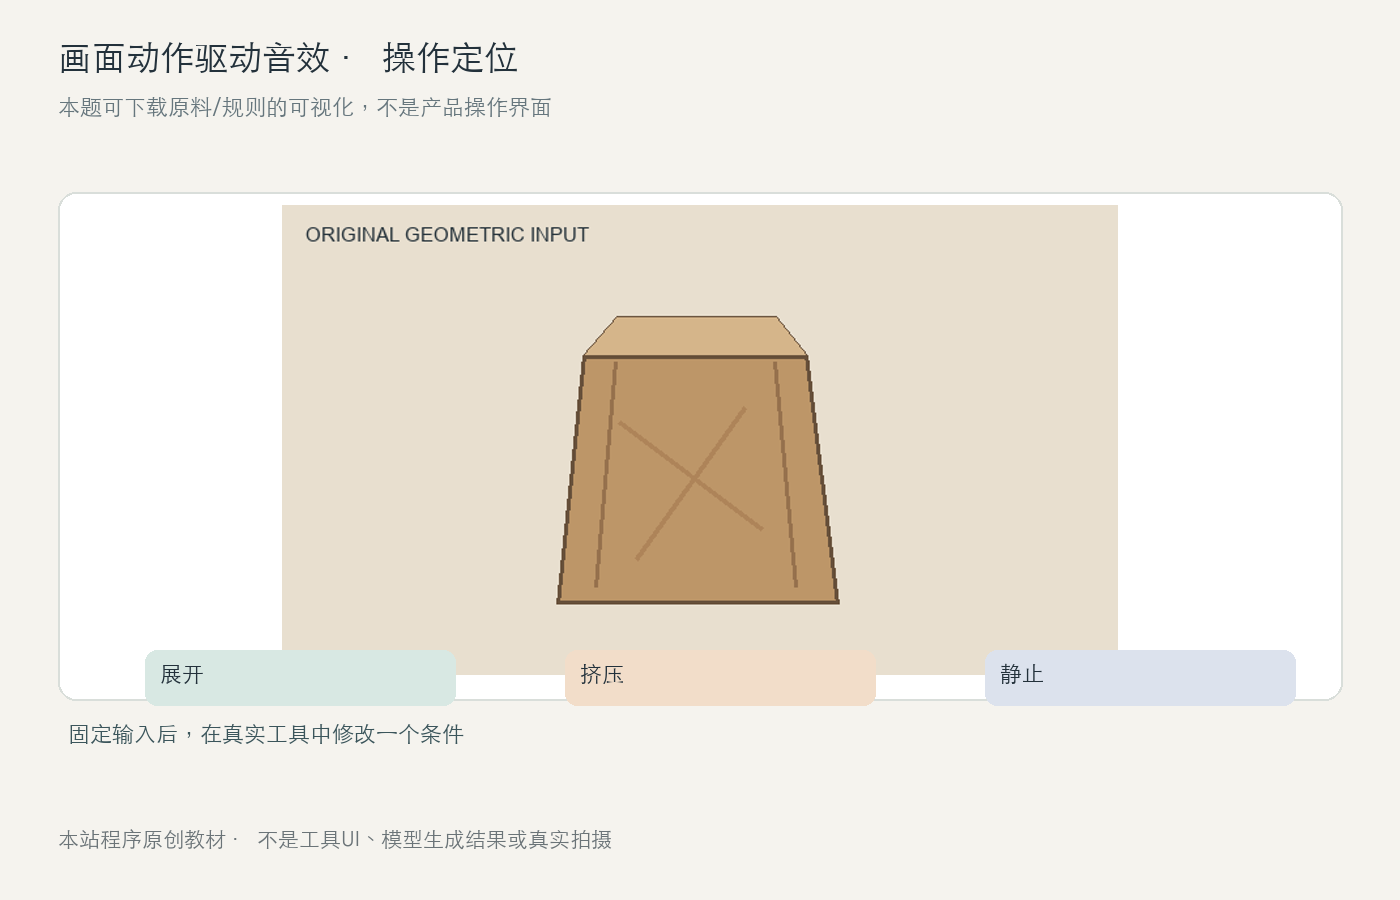
5. 保留音效和合成视频
从真实output目录取FLAC和MP4,记录模型、精度和提示词;不要把模拟噪声或其他库音效放进输出目录冒充MMAudio生成。检查视频是否被截断或重复。
6. 对齐动作峰值并听静止段
按actions.csv回听纸袋展开、挤压的声响是否随动作出现,静止处是否持续乱响;再检查是否夹入不可懂语音或背景音乐,这些是官方列出的可能失败。
7. 只修明确的声音问题
固定画面后修改声音描述再生成短样,逐版保留。它不是任意长视频自动完美拟音;真实商用输出先核对所用模型与训练数据相关许可。
怎样确认已经完成
- 两段动作出现合理声响,最后静止段没有无故大声响。
- 没有意外人声或背景音乐,文件时长与画面一致。
- FLAC和MP4来自真实MMAudio任务,不用合成噪声替代。
常见问题
无声视频自动配音效,这篇从哪里开始?
先用第1步的具体输入,再按照MMAudio原生入口操作。在MMAudio仓库运行demo.py,把input.mp4复制到当前目录或将video参数改为绝对路径,duration设3。官方默认约8秒,偏离时可能变差;如改做8秒素材需明确记录,不能仍称三秒结果。
让音效跟着画面动作走,怎么确认结果真的完成?
两段动作出现合理声响,最后静止段没有无故大声响。 没有意外人声或背景音乐,文件时长与画面一致。 结构回读不代替播放、试听或逐处检查。
MMAudio 视频配音效是否需要apizt API?
本题主要使用工具原生本地或官方网页能力,不要求apizt Key。官方默认large_44k_v2,Python3.9+、匹配PyTorch/CUDA。官方16bit约6GB是其测试值,三秒练习不同于默认8秒训练长度;作者不保证预训练模型适合商用。
MMAudio的英文资料应该搜什么?
可用“MMAudio video to audio synchronized foley paper bag”查找对应能力;先确认官方来源中的模型/工作流,再核对本文输入和实际输出,不套用同名第三方服务参数。