
展开本页目录
开始前准备什么
- 下载本题完整练习包,区分待实现 starter 与作者完成 reference。
- 按README准备本题原生依赖;所有输入均为原创或明确标注的本地fixture。
- 本地练习不需要付费模型Key;真实模型调用未执行,MiniLM题另有明确实际推理说明。
- 准备双语语料
- 下载公开小模型
- 执行真实编码
- 比较同批查询
- 保留所有分数
- 缓存离线重跑
- 说明模型身份
原创输入、待完成starter、作者reference及实际运行产物,依README本地准备依赖。
环境要求、具体操作、产物核对与未运行范围。
1. 准备双语语料
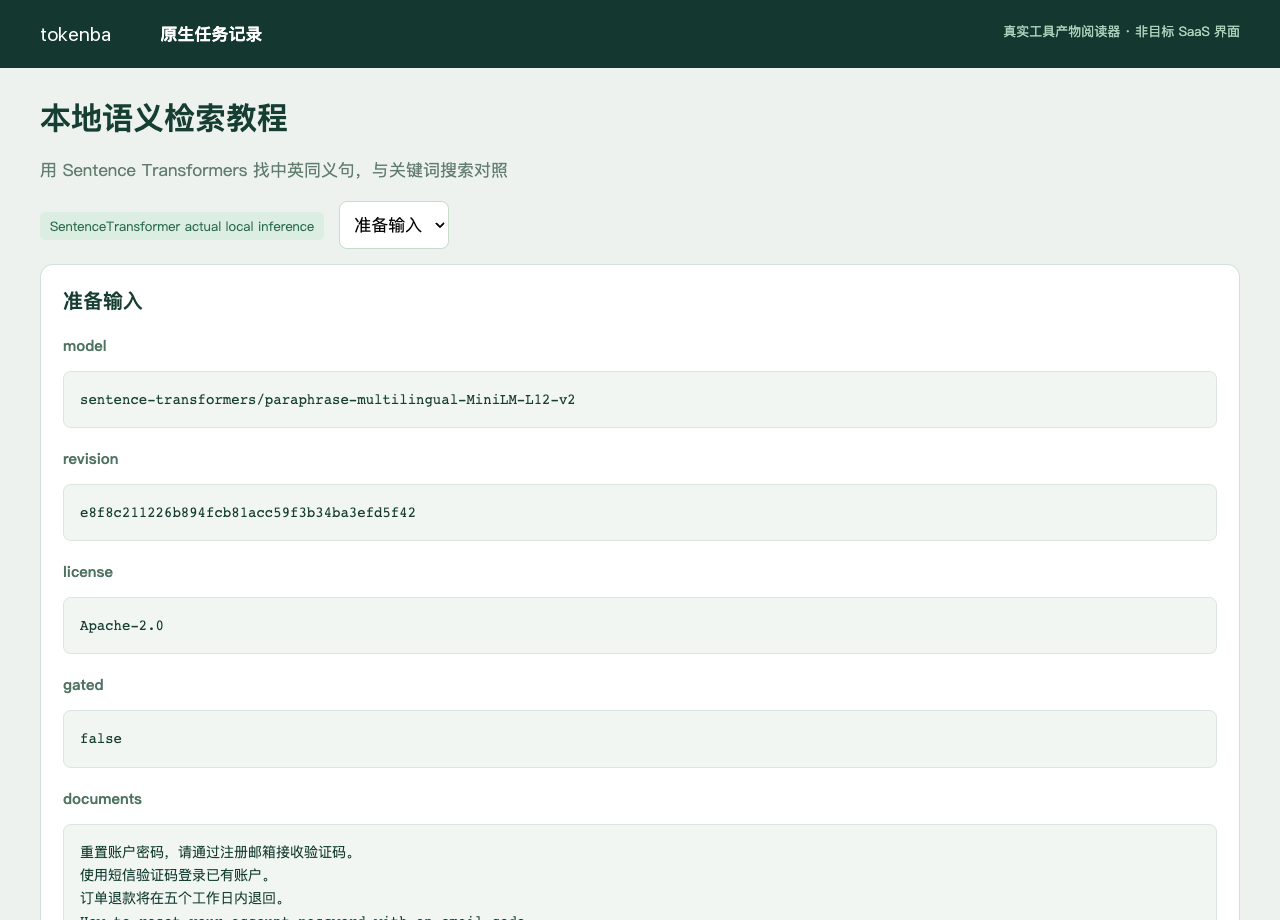
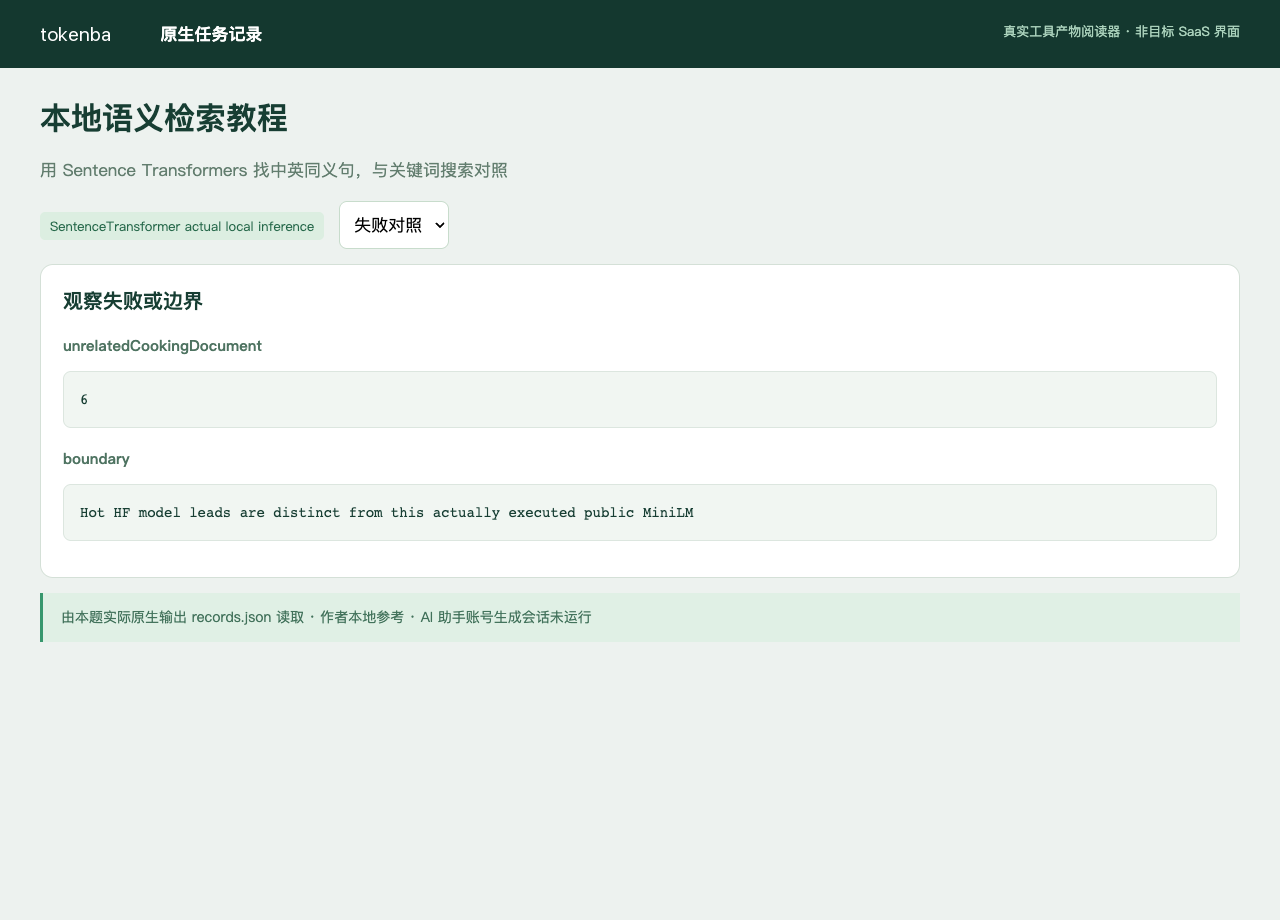
输入为八条原创中英文说明和四个固定查询,包含密码同义说法、发票、导入联系人及无关烹饪条目。先固定语料,不只保留能成功的那几个例子。
2. 下载公开小模型
实际模型为公开免门控的paraphrase-multilingual-MiniLM-L12-v2,许可Apache-2.0,下载固定revision。它与HF热榜中观察到的EmbeddingGemma是不同模型。
本地启动与复现
cd reference
python3 verify.py
3. 执行真实编码
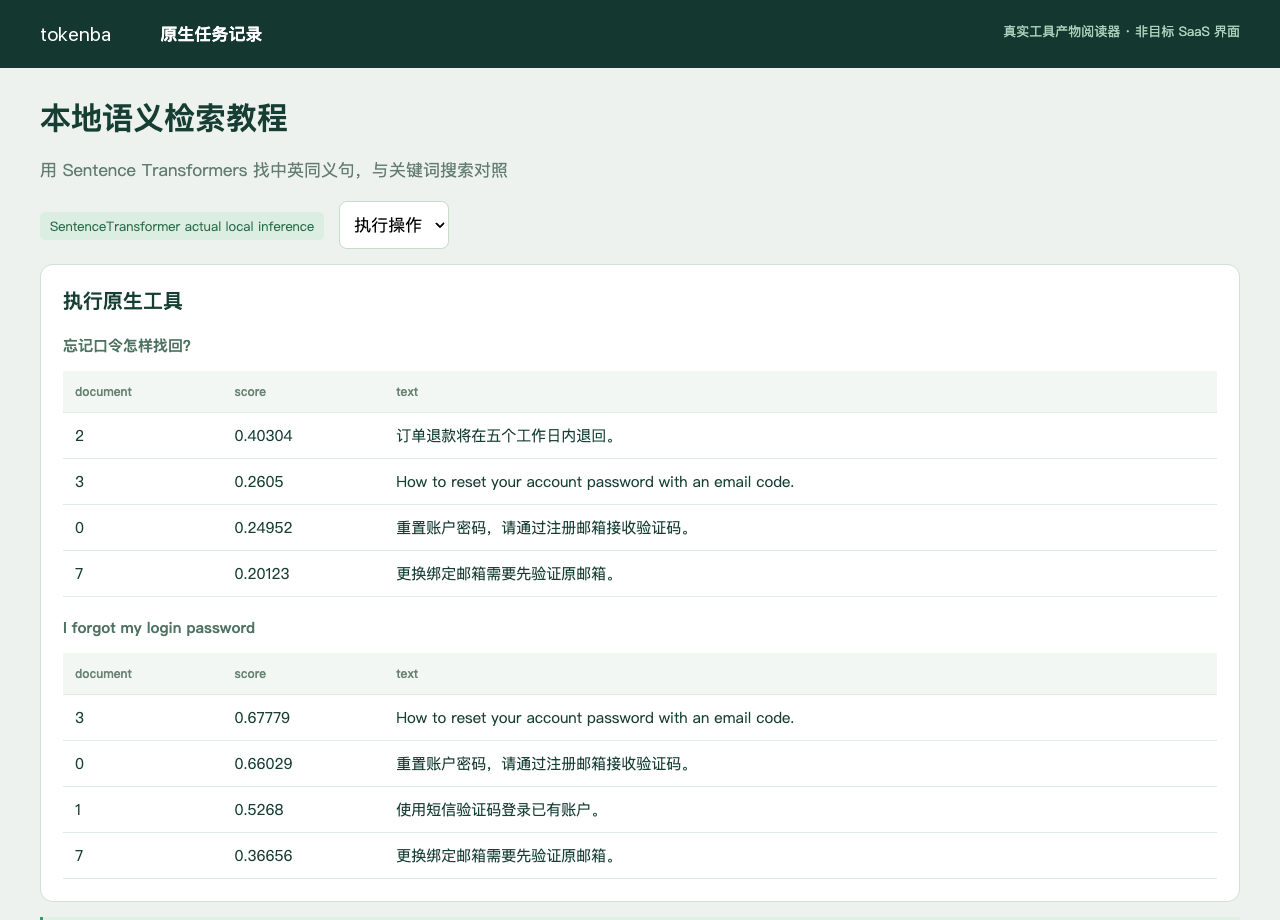
使用SentenceTransformer真正加载权重,分别encode文档和查询,归一化后计算相似度矩阵。本文不是手写分数,也不是仅测试检索界面。
4. 比较同批查询
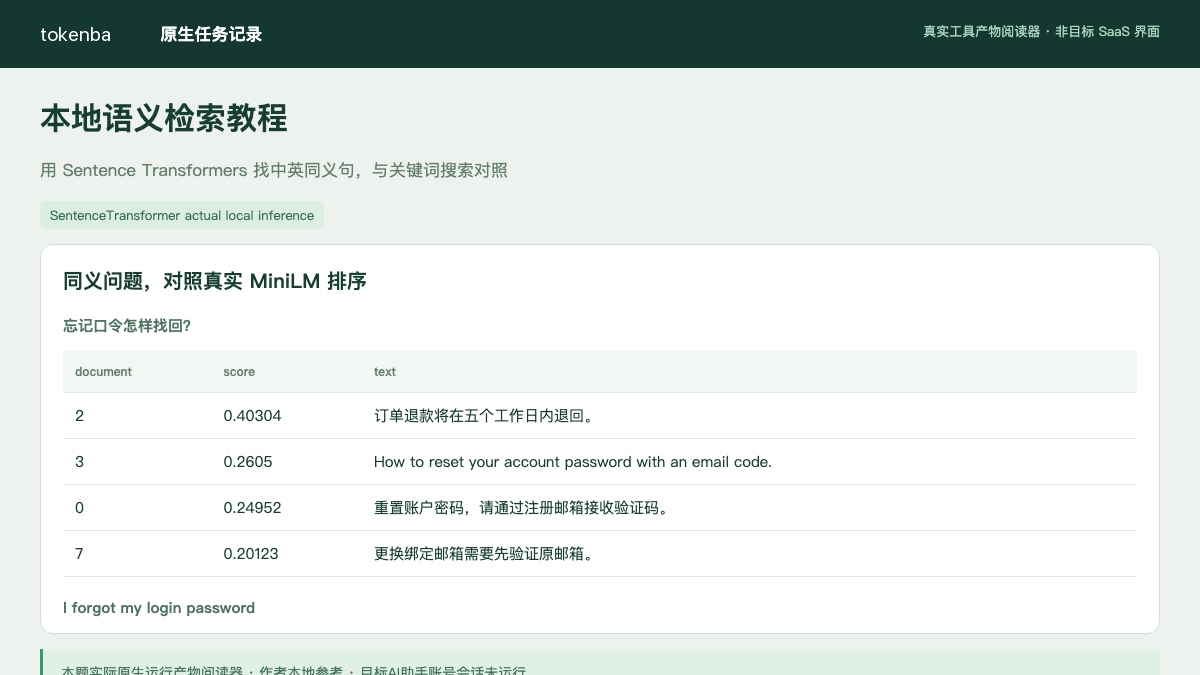
对同一批查询并排保留关键词基线与向量排序。关键词基线仅按小写空格词做子串匹配,中文未分词,不代表强BM25基线。英文忘记密码的查询能匹配密码说明;这说明当前输入的语义关联,不等于所有任务都更好。
5. 保留所有分数
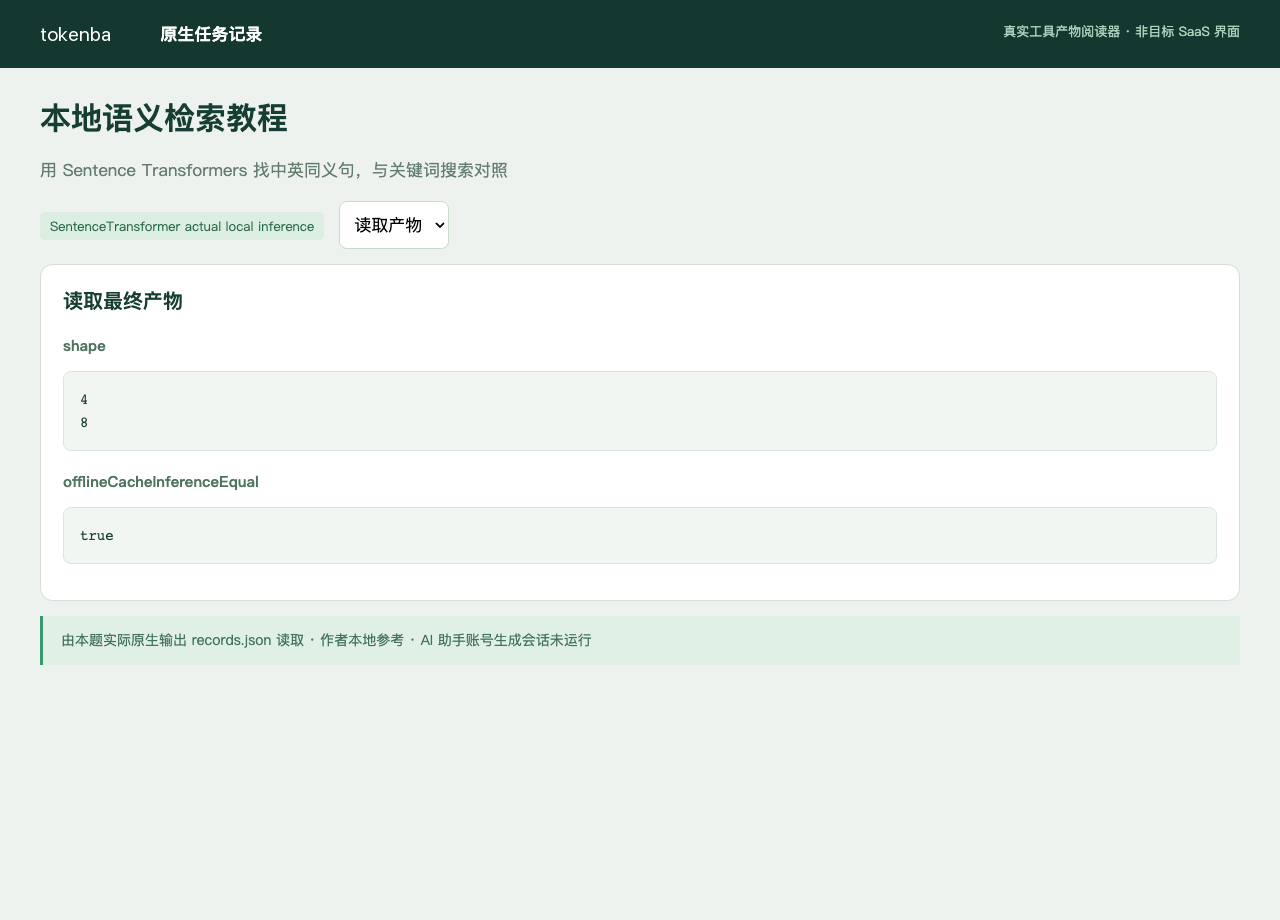
保存完整4×8分数与所有候选,包括无关文档和干扰项。不隐藏低分或不理想结果,也不把单次小样本当作模型评测排行榜。
6. 缓存离线重跑
从本地缓存以local_files_only再次加载同一revision,重复编码并比较数值一致性。首次下载需要网络,权重仅保存在作者外盘缓存,不随练习包分发。
7. 说明模型身份
下载代码、原创语料、完整分数与revision文本,自行运行可再次取权重。教程只声称MiniLM本地推理,不声称运行了热门门控模型、GPU服务或付费API。
怎样确认已经完成
- 公开MiniLM固定revision真实本地encode,完整4×8相似度保留,同缓存离线再推理一致;未运行热榜中的其他模型。
- 本题公开多语MiniLM实际把中英文编码到同一向量空间,能对当前同义密码查询做关联;具体结果仍要看完整排序。
- 对相同语料和四条固定查询同时保存关键词基线与4×8分数,不只展示赢家;这份小样本不代表通用排行榜。
常见问题
中文问题能不能搜到说法不同的英文说明?
本题公开多语MiniLM实际把中英文编码到同一向量空间,能对当前同义密码查询做关联;具体结果仍要看完整排序。
语义搜索真比关键词好在哪里,能做同一批问题的对照吗?
对相同语料和四条固定查询同时保存关键词基线与4×8分数,不只展示赢家;这份小样本不代表通用排行榜。
哪些部分实际运行,哪些需要独立验证?
公开MiniLM固定revision真实本地encode,完整4×8相似度保留,同缓存离线再推理一致;未运行热榜中的其他模型。 目标AI助手账号生成、云平台部署和生产环境不在本次执行范围。