
展开本页目录
开始前准备什么
- 下载本题完整练习包,区分待实现 starter 与作者完成 reference。
- 按README准备本题原生依赖;所有输入均为原创或明确标注的本地fixture。
- 本地练习不需要付费模型Key;真实模型调用未执行,MiniLM题另有明确实际推理说明。
- 准备旧版网页
- 保存选择器特征
- 替换类名
- 读取自适应候选
- 拒绝同名误认
- 核对字段变化
- 保存抓取规则
先下载样例,再完成自己的首次调用
示例不含密钥。API 按实际用量计费;下载和点击不代表调用成功。
原创输入、待完成starter、作者reference及实际运行产物,依README本地准备依赖。
环境要求、具体操作、产物核对与未运行范围。
本次操作和结果
Scrapling 0.4.11 实测(受控样例)。
准备独立样例。安装文章所用客户端,或用 Python 3.11+ 运行标注为本地 HTTP/TOML 的样例。
本例操作:给原案例补一个同名 ID 冲突,核对正确和错误记录的筛选输出。
解压练习包,执行 python3 lab.py --output ./result u13。完整命令、样例输入和输出保存在回执。
打开 result/u13.json,对照实际退出码、请求路径或产物字段。
逐项确认下方通过条件。本例的测试范围以运行回执为准。
- 通过:同名的错误 ID 不进入结果
复跑样例
python3 lab.py --output ./result u13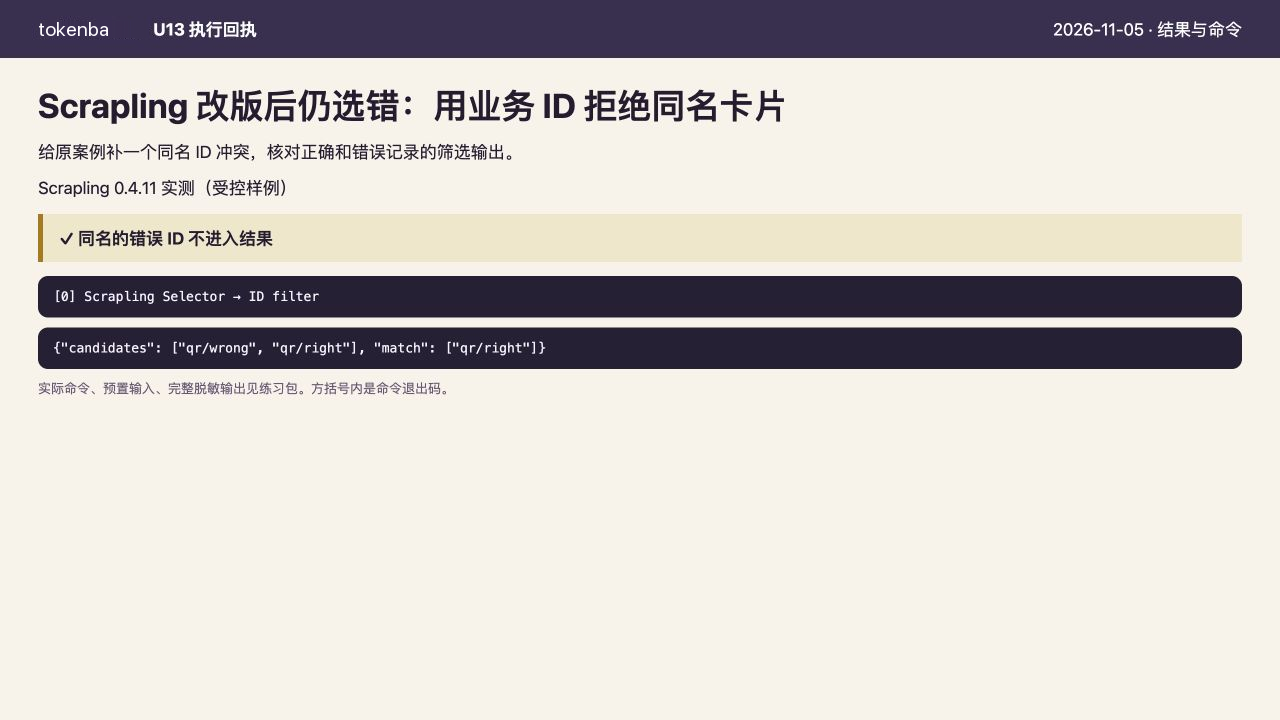
执行回执截图。Scrapling 0.4.11 实测(受控样例)。
1. 准备旧版网页
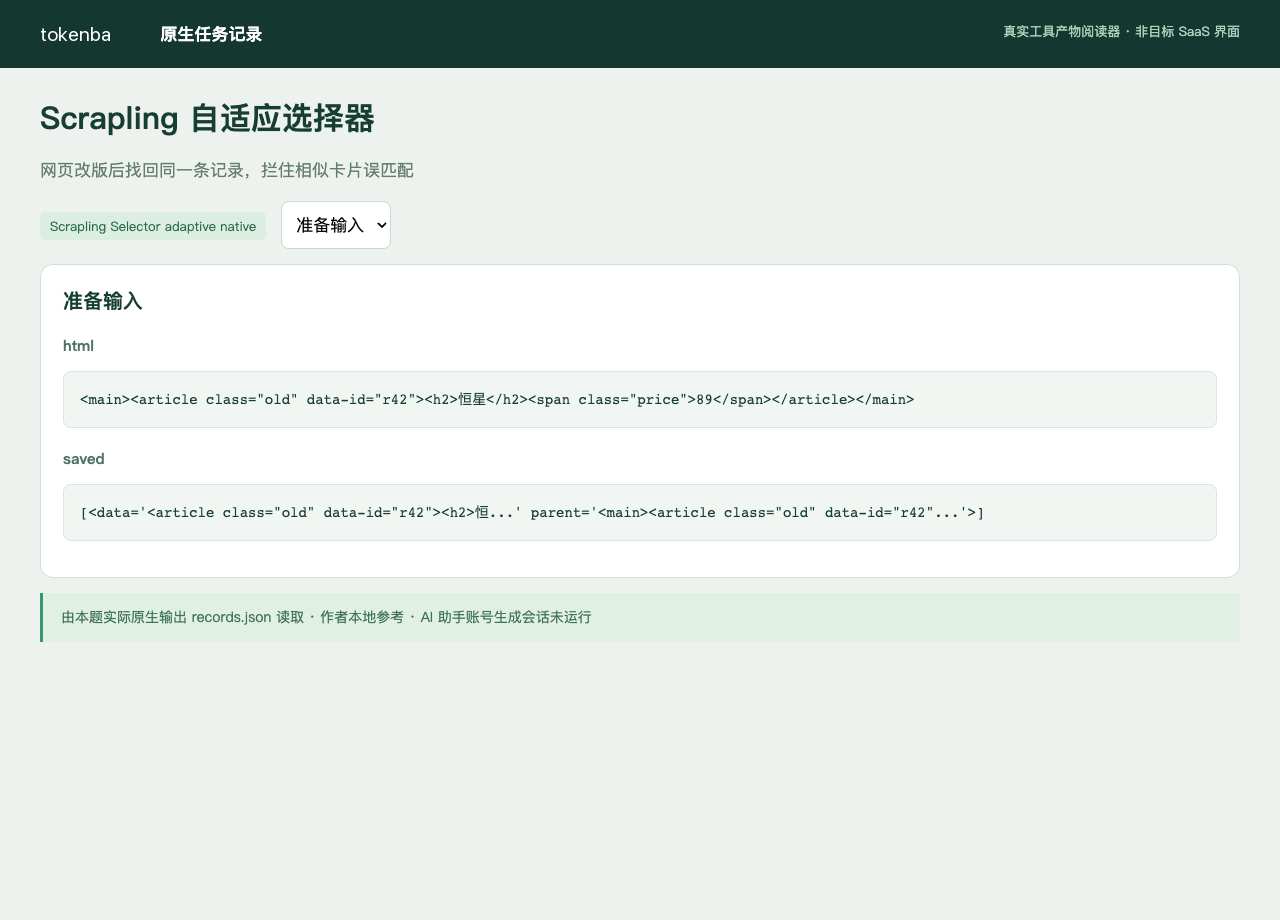
输入是本机原创 HTML:目标业务 ID 为 r42,另有同名的 r99 干扰记录。旧版 article.old 下有名称与价格,所有输入都随练习包提供,不访问第三方站点。
2. 保存选择器特征
使用原生 Scrapling Selector 开启 adaptive,并对旧选择器执行 auto_save。特征存储只在临时目录中产生,下载包不包含运行时数据库。
本地启动与复现
cd reference
python3 verify.py
3. 替换类名
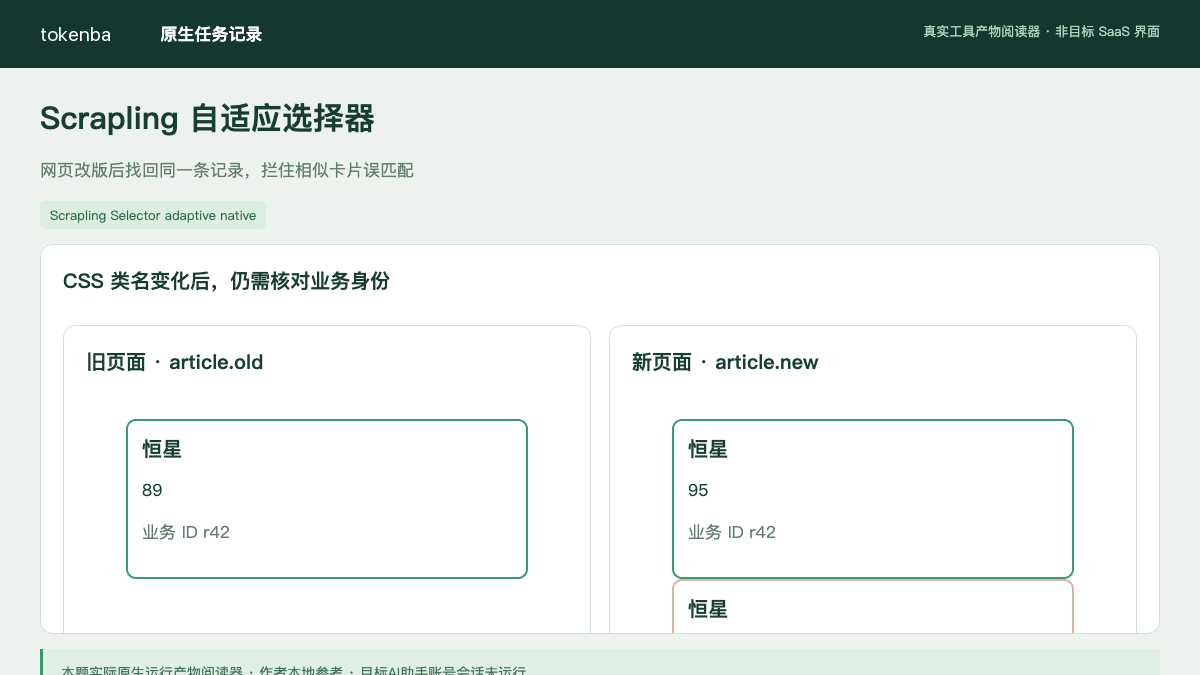
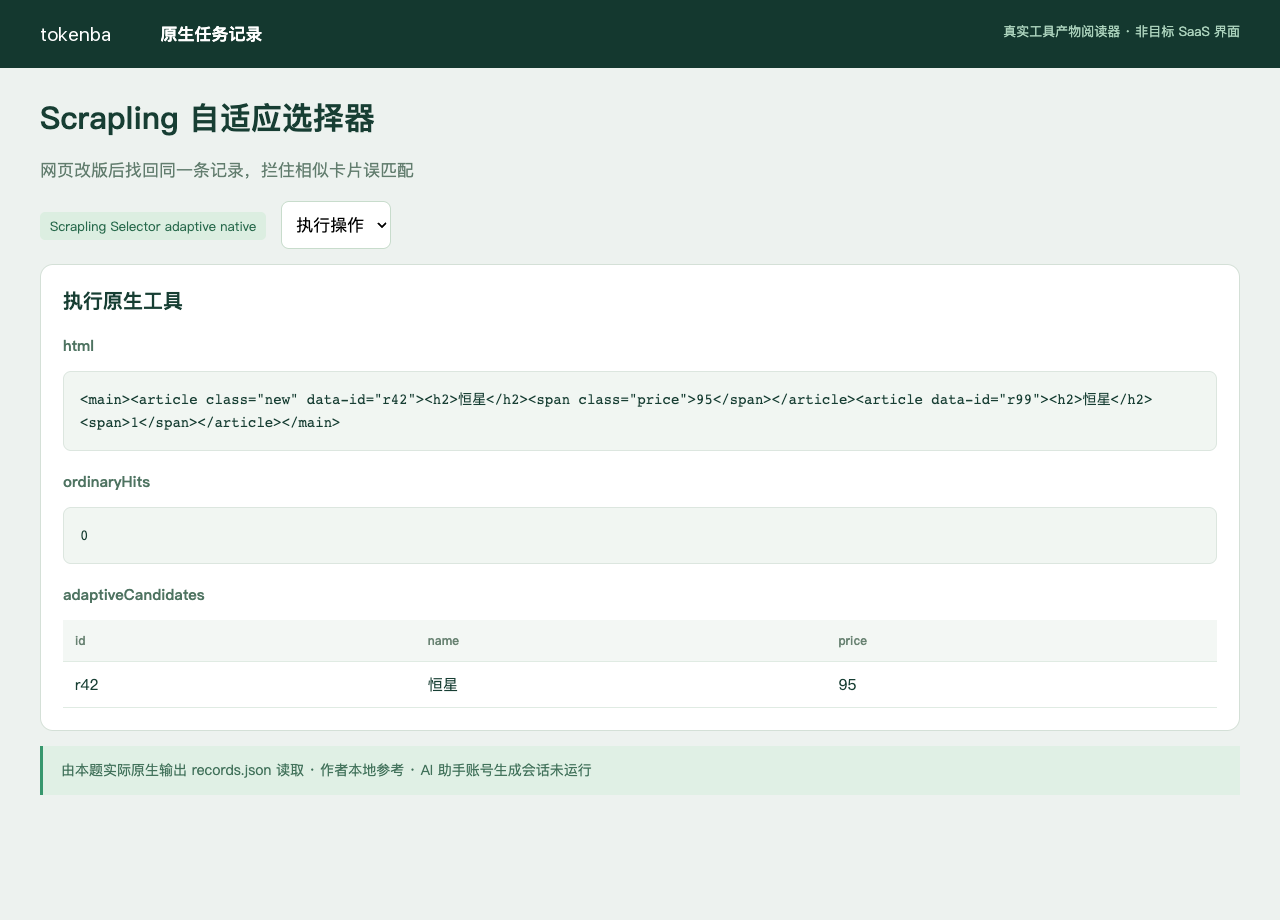
把目标的 CSS 类名从 old 改为 new,并将价格由89改为95。普通 article.old 查询应返回零条,这一步证明旧选择器确实已经失效。
4. 读取自适应候选
对同一 URL 身份运行 adaptive=True,读取真正由 Scrapling 返回的候选。保留业务 ID、名称和价格,不能把页面上第一个同名元素直接当作原目标。
5. 拒绝同名误认
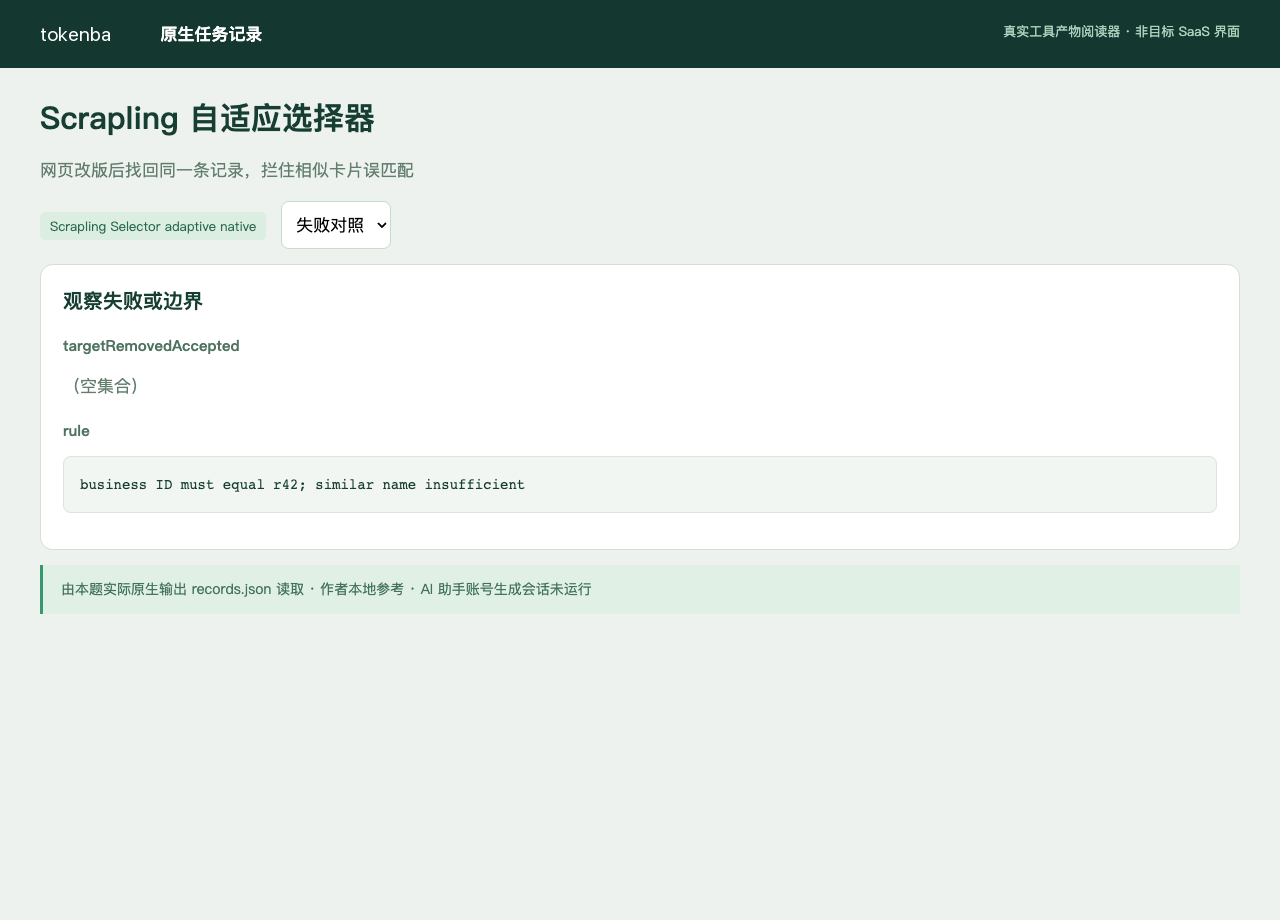
再移除 r42,仅保留同名 r99。即使自适应评分找到相似结构,业务层必须因 ID 不匹配拒绝接纳;候选不是已确认的正确记录。
6. 核对字段变化
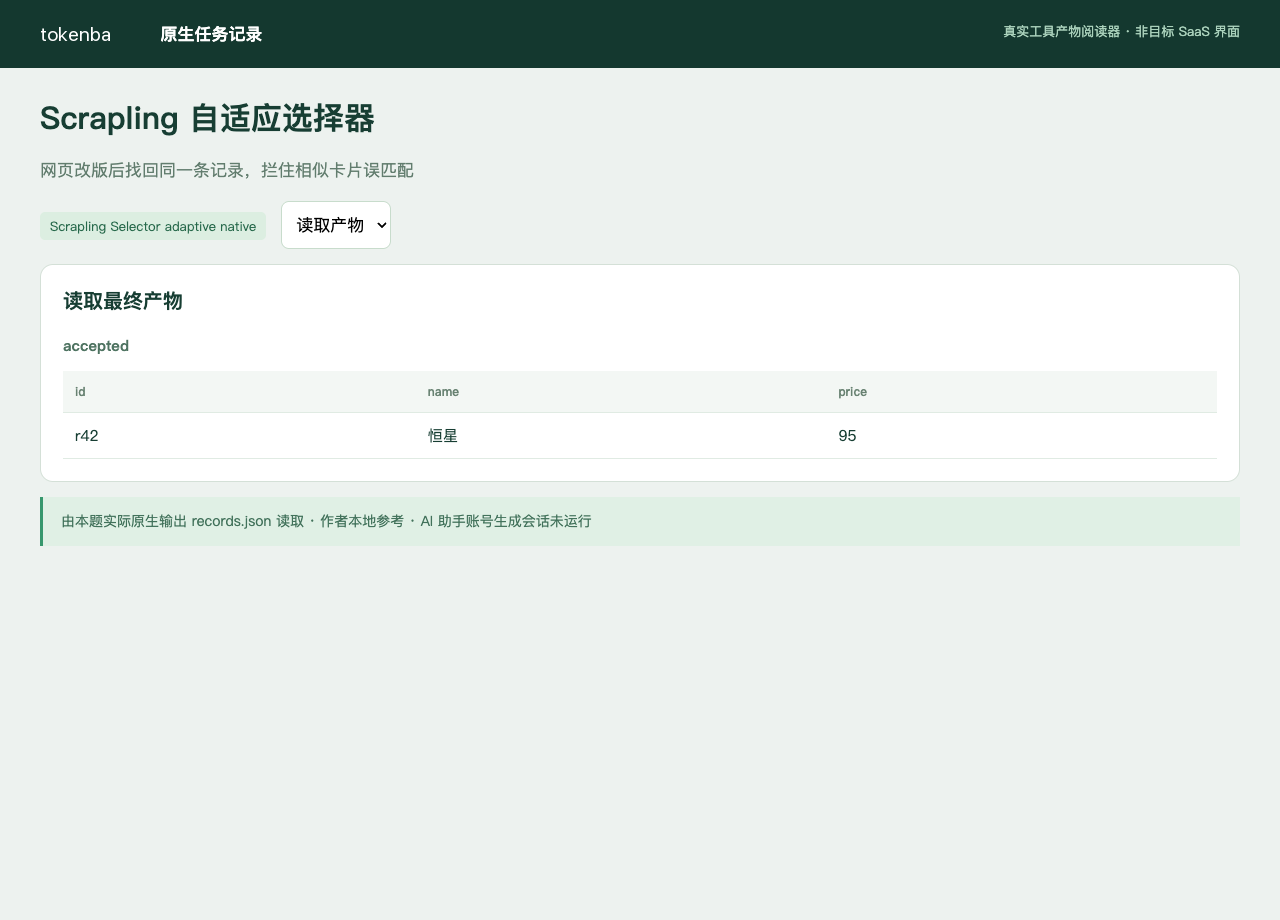
接受的目标必须仍为 r42,名称为恒星,价格为95。通过字段对照确认定位和内容两件事,不把“返回了一个元素”当作正确抓取。
7. 保存抓取规则
阅读 reference/verify.py 中旧页、新页和目标删除三份输入。复跑会重建隔离特征存储;这篇只验证本地解析与身份核对,不提供绕过登录或反爬的操作。
怎样确认已经完成
- Scrapling原生adaptive找回改类名目标,并以业务ID拒绝同名干扰;仅解析本地原创HTML。
- 本题类名old改new后,原生adaptive找回r42,而普通CSS选择器返回0条。不同网页改动程度仍需用实际输入验证。
- 对候选再核业务ID与必需字段。本题删除r42后,即便同名r99还在,也不接受它冒充原记录。
常见问题
网页类名改了,Scrapling还能抓到原来的那条记录吗?
本题类名old改new后,原生adaptive找回r42,而普通CSS选择器返回0条。不同网页改动程度仍需用实际输入验证。
自适应找回的元素怎么确认没有认错人?
对候选再核业务ID与必需字段。本题删除r42后,即便同名r99还在,也不接受它冒充原记录。
哪些部分实际运行,哪些需要独立验证?
Scrapling原生adaptive找回改类名目标,并以业务ID拒绝同名干扰;仅解析本地原创HTML。 目标AI助手账号生成、云平台部署和生产环境不在本次执行范围。