
展开本页目录
开始前准备什么
- 下载到独立练习目录,保留原始输入副本。
- 模型步骤使用自己的已验证配置;离线检查不需要 API Key。
- 先阅读 README 中的运行范围;练习数据均为原创。
- 启动独立练习服务器
- 定位控件和执行范围
- 提取同源链接
- 分别核对锚点与 HTTP
- 修复错误路径再测
- 保存真实输出与截图
- 在自己的环境复跑
1. 启动独立练习服务器
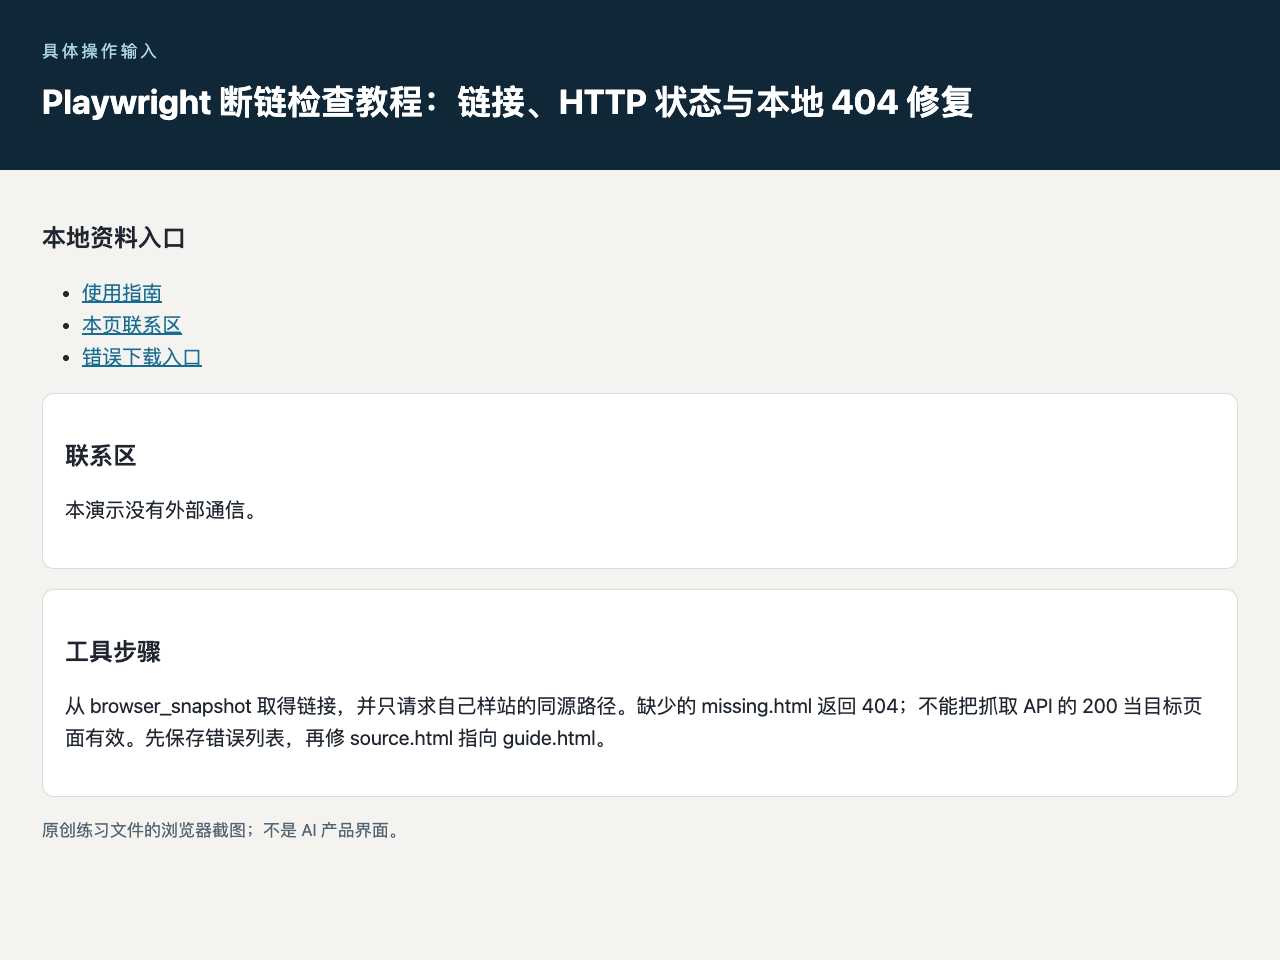
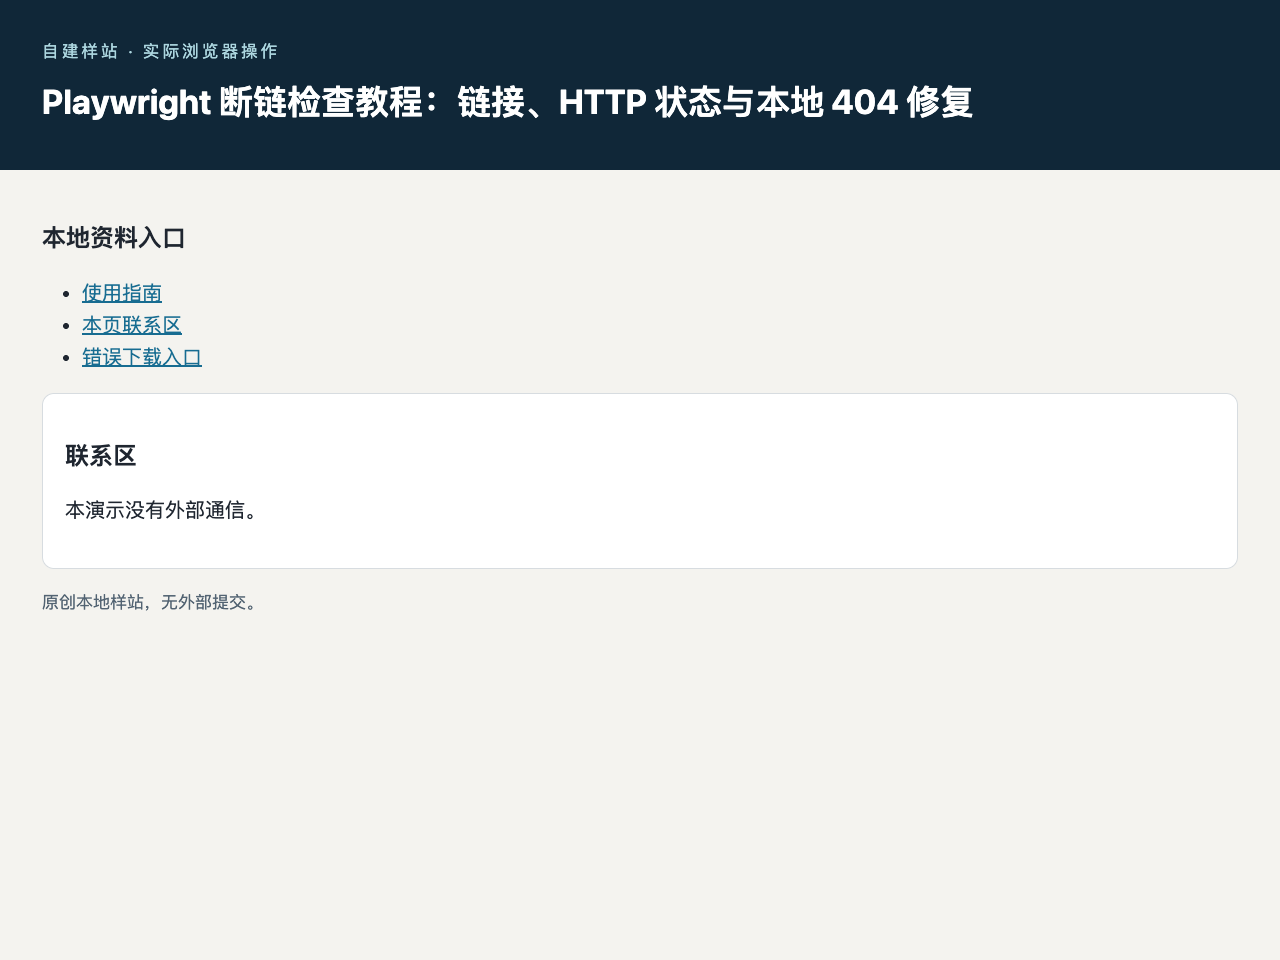
样站只提供 source.html 和 guide.html;missing.html 故意不存在。
2. 定位控件和执行范围
从 browser_snapshot 取得链接,并只请求自己样站的同源路径。缺少的 missing.html 返回 404;不能把抓取 API 的 200 当目标页面有效。先保存错误列表,再修 source.html 指向 guide.html。
3. 提取同源链接
保存 href 原值、链接文字和解析后的绝对 URL;跳过外部站点。
4. 分别核对锚点与 HTTP
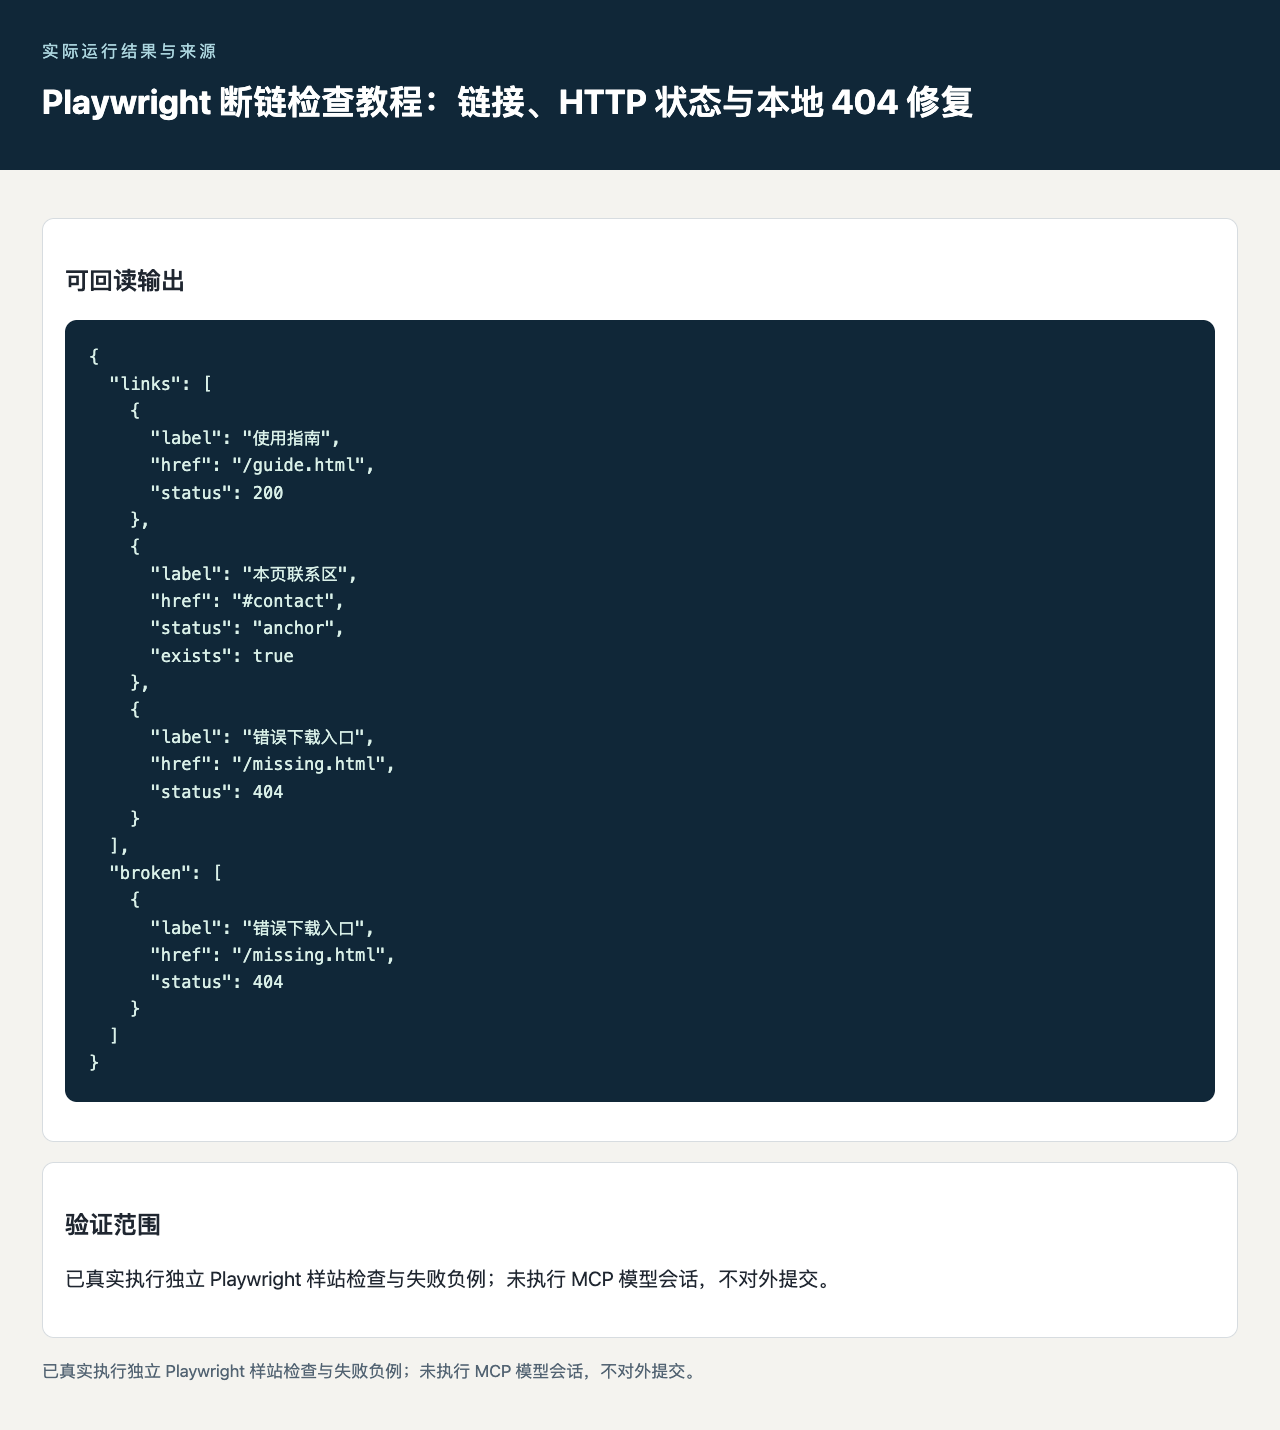
contact 锚点在本页核对节点;guide 与 missing 发真实 GET 查看状态。
5. 修复错误路径再测
把 missing.html 改为 guide.html;重跑你的检查,错误列表应为空。教材保留原错误输入作为负例。
6. 保存真实输出与截图
对照 result.html 与原始 browser-result.json 或 local-result.json。结果必须包含本任务字段与来源,截图不能代替实际输出检查。已真实执行独立 Playwright 样站检查与失败负例;未执行 MCP 模型会话,不对外提交。
7. 在自己的环境复跑
按下载 README 使用独立目录;Playwright 首次需安装库和浏览器。负例退出非零是预期,实际用于 CI 时只将正例作为通过条件。
text
text
npm install --no-save playwright
node check.mjs
node check.mjs --negative
怎样确认已经完成
- 保留href原值、同源解析地址和真实GET状态。
- 页面锚点能定位节点,missing.html被准确报告为404。
- 修复为guide.html后错误清单为空,原负例仍单独保留。
常见问题
截图是官方工具界面吗?
这是自建样站和真实脚本输出的浏览器截图,原始 HTML 与验证脚本均可下载;不假装官方产品界面。
可以直接提交到真实网站吗?
本页先在自己的独立样站验证。迁移时重新确定站点、字段和允许动作,本教材没有外部提交步骤。