
展开本页目录
开始前准备什么
- 下载完整练习包,在独立目录阅读README与已执行范围。
- 安装requirements.txt指定版本或使用文中目标工具;依赖与模型权重不要混入网站工程。
- 只有明确标为已执行的部分有本次证据;真实模型、账号或GPU步骤按自己的环境另行验证。
- 给新增产品标记取得真实token ID
- 审计索引范围与冻结目标
- 设置trainable_token_indices
- 准备包含新标记的真实训练样本
- 训练前后按行检查梯度与差值
- 保存并重新加载适配器及tokenizer
- 交付索引、掩码与真实训练回执
1. 给新增产品标记取得真实token ID
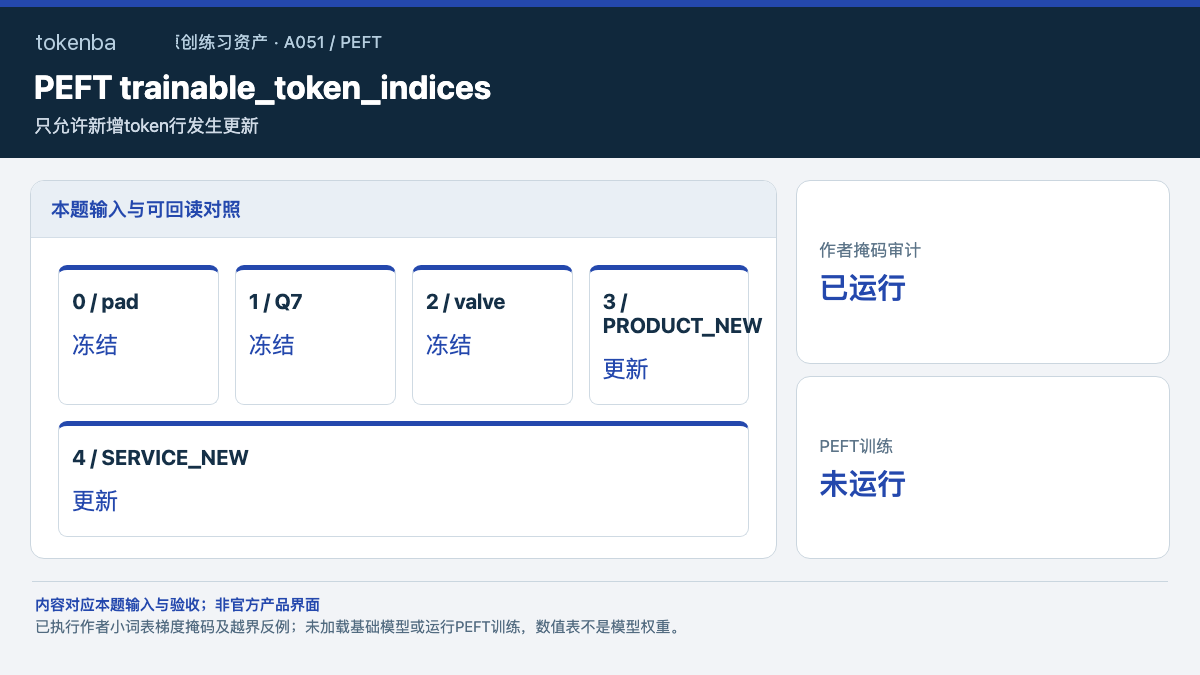
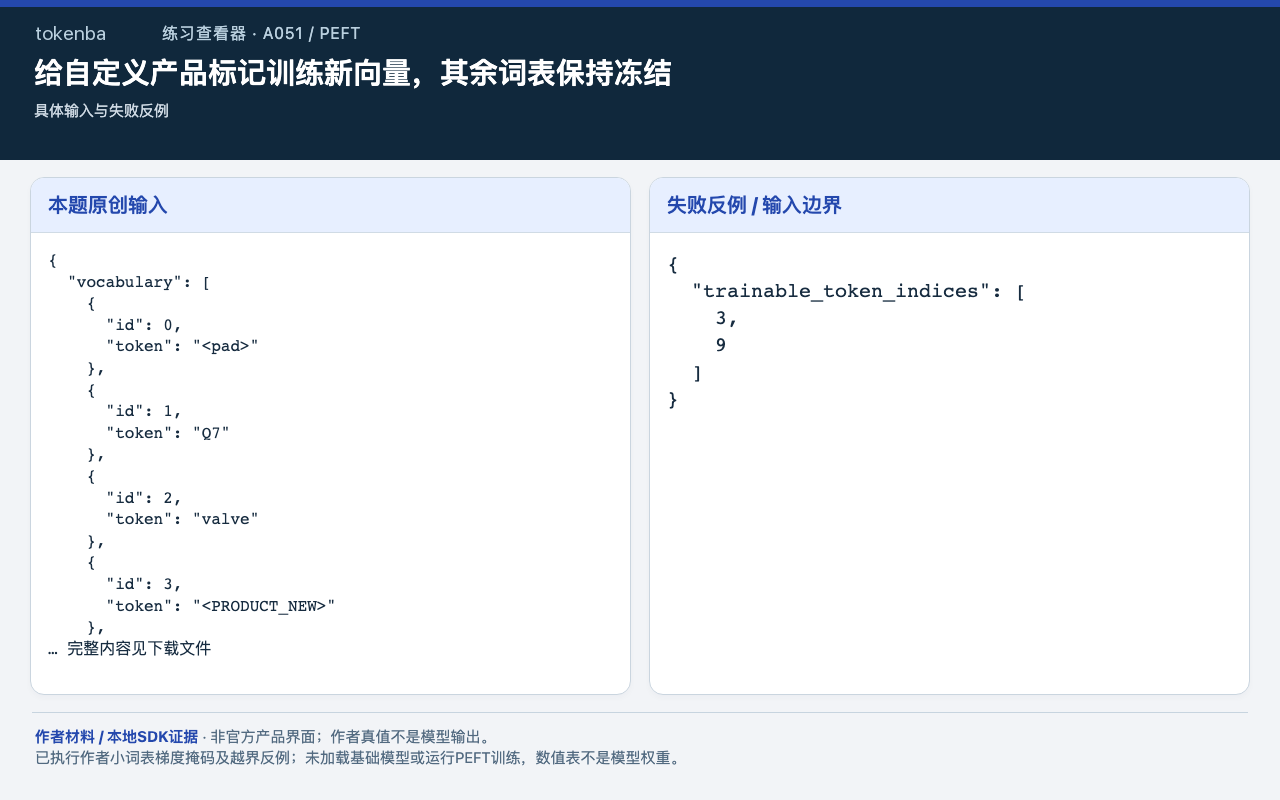
示例词表3/4是作者小词表,生产必须先扩展真实tokenizer并resize embedding,核对新标记是否被切成多个token。
2. 审计索引范围与冻结目标
audit.py只允许3/4发生作者数值更新,0/1/2完全不变;9越界负例应在训练前失败。这不是基础模型权重更新实测。
本题独立目录执行
bash
python reference/audit.py3. 设置trainable_token_indices
在支持该选项的PEFT版本配置新增token索引或对应embedding层映射。保存实际LoraConfig与tokenizer,不能只保存token字符串。
本题SDK或目标环境入口
bash
python reference/run_sdk.py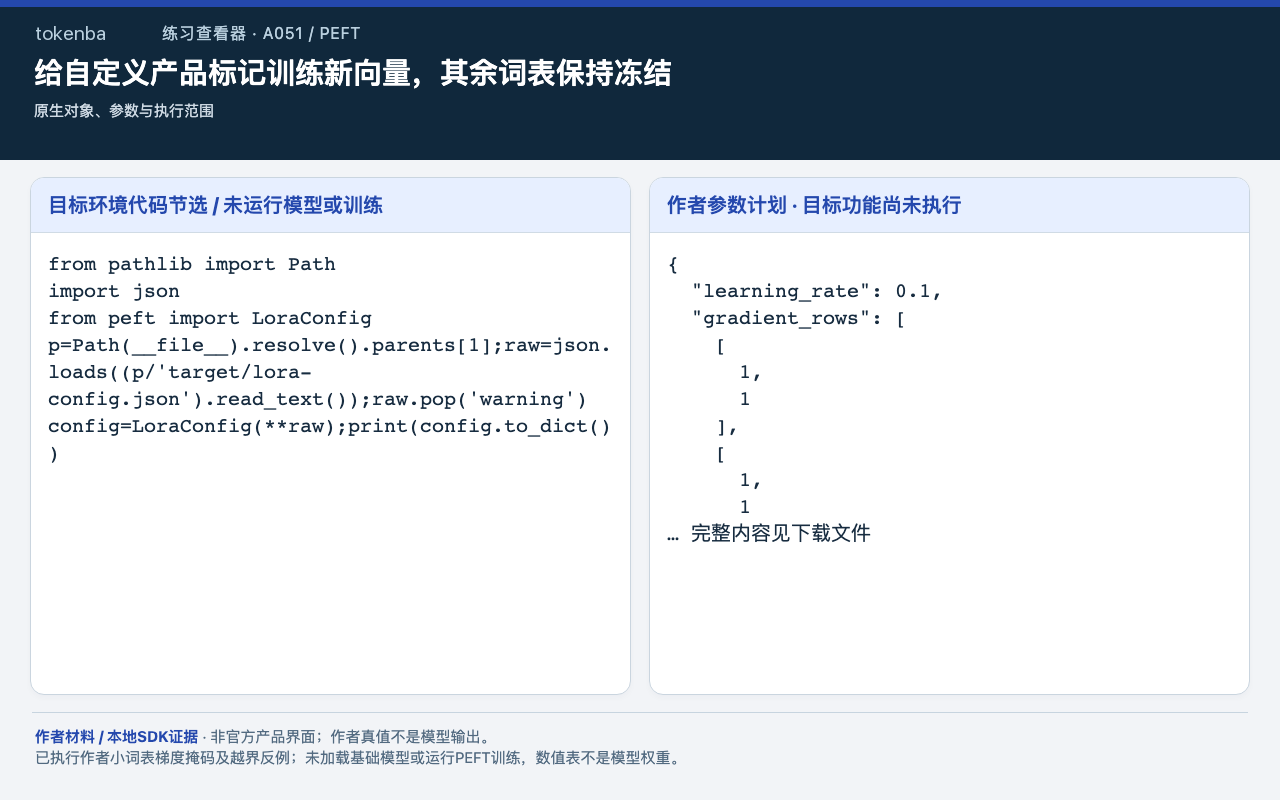
4. 准备包含新标记的真实训练样本
输入输出都保留新标记业务含义,避免训练集中从未出现目标token。使用自有或授权数据并保留样本来源。
5. 训练前后按行检查梯度与差值
目标GPU环境记录可训练参数、目标行梯度和冻结行最大差值;不要因为loss下降就宣称其他词表行冻结成功。
6. 保存并重新加载适配器及tokenizer
验证加载后新token ID没有变化、目标embedding仍在,其他adapter配置兼容。包内无假adapter权重。
7. 交付索引、掩码与真实训练回执
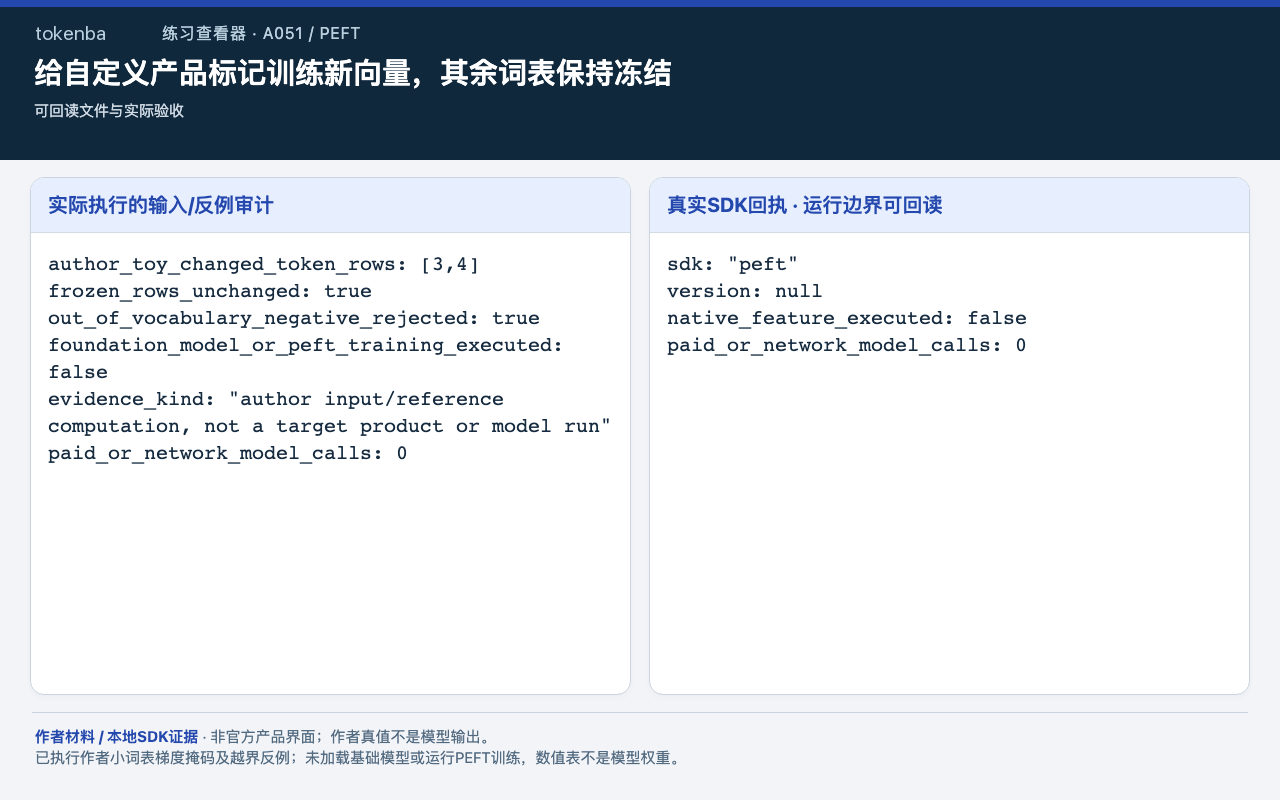
本包提供数据和冻结审计,未进行PEFT基础模型训练。只有实际行差值、加载和任务结果齐全后才认定训练成功。
怎样确认已经完成
- 指定之外词表保持冻结
- 新增词表和适配器一起保存
- 硬件实跑边界注明
- 已执行作者小词表梯度掩码及越界反例;未加载基础模型或运行PEFT训练,数值表不是模型权重。
常见问题
PEFT怎么只训练新加入的几个词元?
先扩展真实tokenizer取得新增ID,再在支持的LoraConfig中设trainable_token_indices。包内只有作者词表、数据和目标配置,未训练基础模型。
trainable_token_indices怎么确认其他词表权重没动?
保存训练前后embedding逐行差值和梯度,目标行可变、其余行应保持冻结范围。作者小矩阵掩码通过不等于真实PEFT冻结已验证。
这篇教程哪些步骤已经真正执行?
已执行作者小词表梯度掩码及越界反例;未加载基础模型或运行PEFT训练,数值表不是模型权重。