
展开本页目录
开始前准备什么
- 下载完整练习包,在独立目录阅读README与已执行范围。
- 安装requirements.txt指定版本或使用文中目标工具;依赖与模型权重不要混入网站工程。
- 只有明确标为已执行的部分有本次证据;真实模型、账号或GPU步骤按自己的环境另行验证。
- 固定三类问题与同一语料
- 建立九格比较计划
- 构造当前QueryParam
- 先保存真实检索上下文
- 再单独记录模型生成
- 识别语料改变的假对比
- 报告差异并保留失败
1. 固定三类问题与同一语料
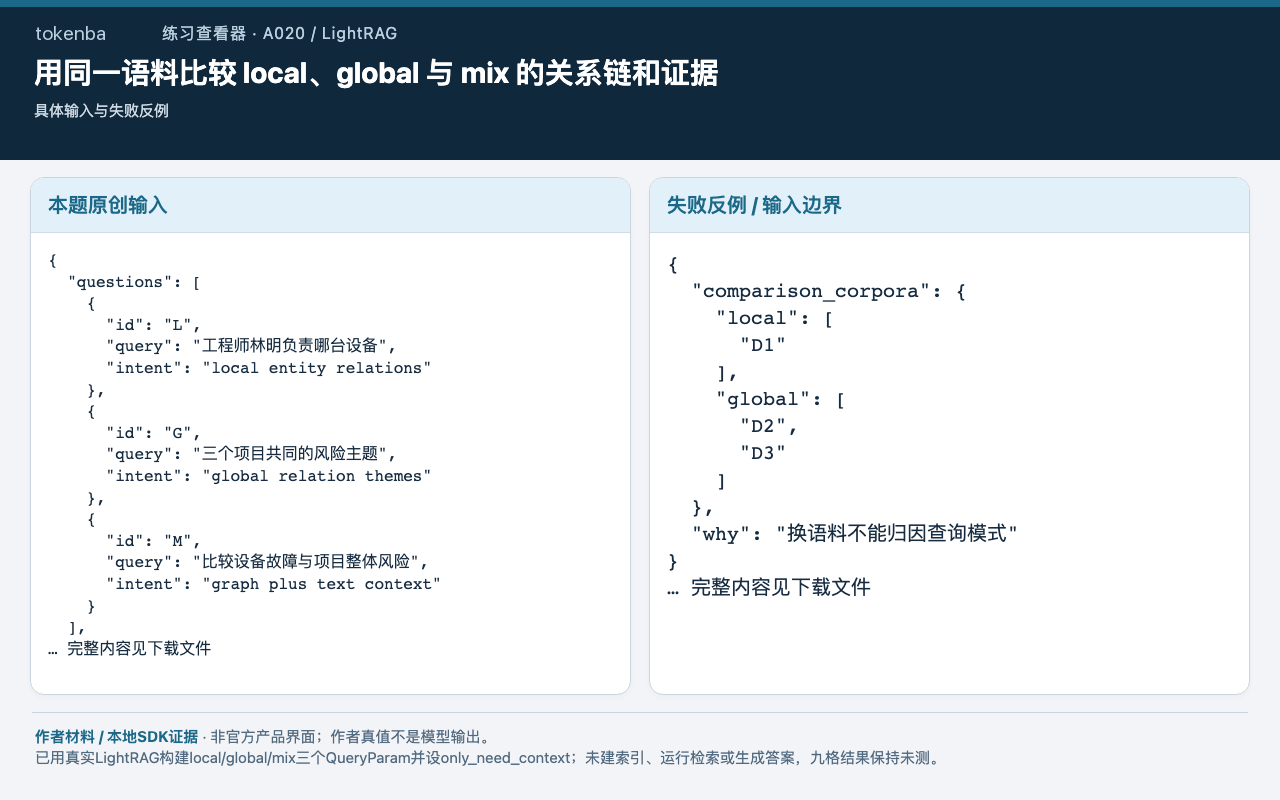
L问局部人物设备关系,G问跨项目主题,M同时需要关系和原文。三种模式必须指向同一个六文档索引。
2. 建立九格比较计划
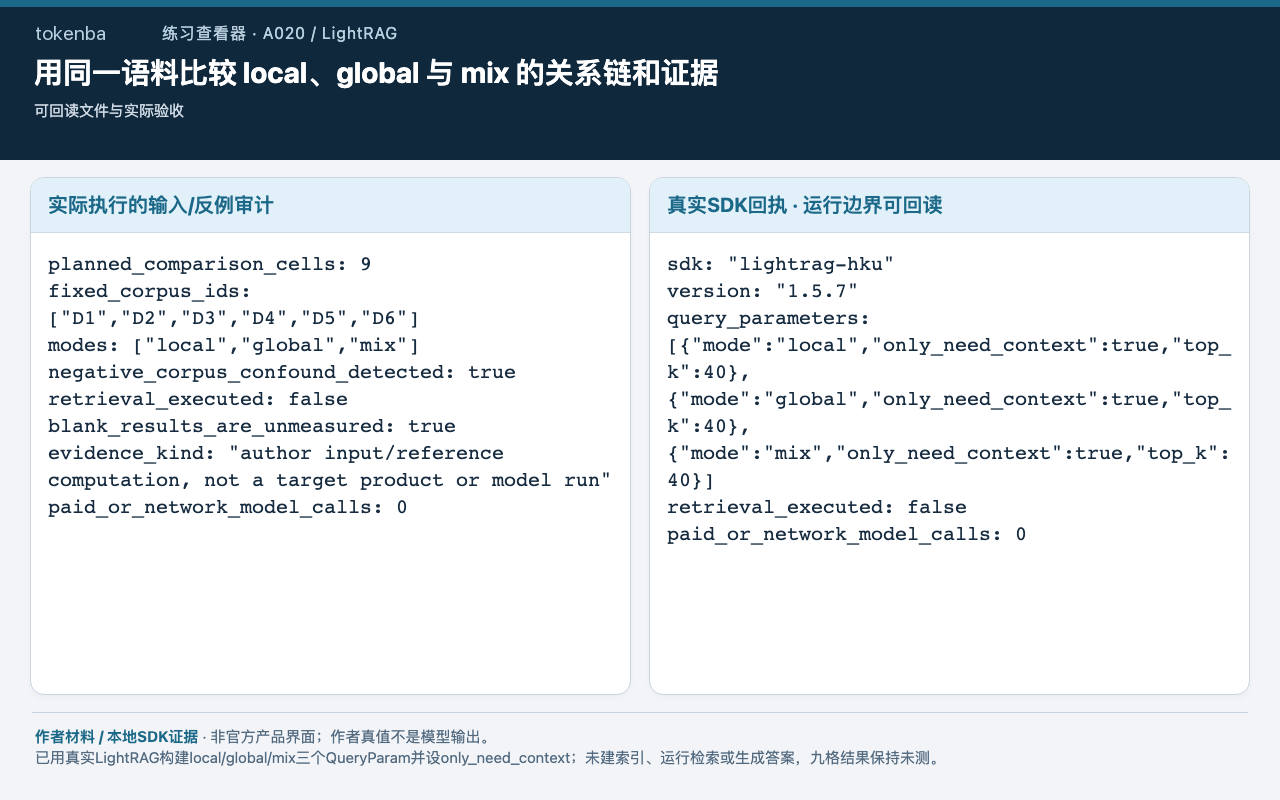
audit.py生成3问题×3模式的实验矩阵;retrieved_context与answer保持None表示未测,不用作者编好的答案填满表。
本题独立目录执行
bash
python reference/audit.py3. 构造当前QueryParam
分别创建mode=local/global/mix的QueryParam,记录top_k、上下文预算与rerank设置。其他参数固定,避免把模式与预算一起改。
本题SDK或目标环境入口
bash
python reference/run_sdk.py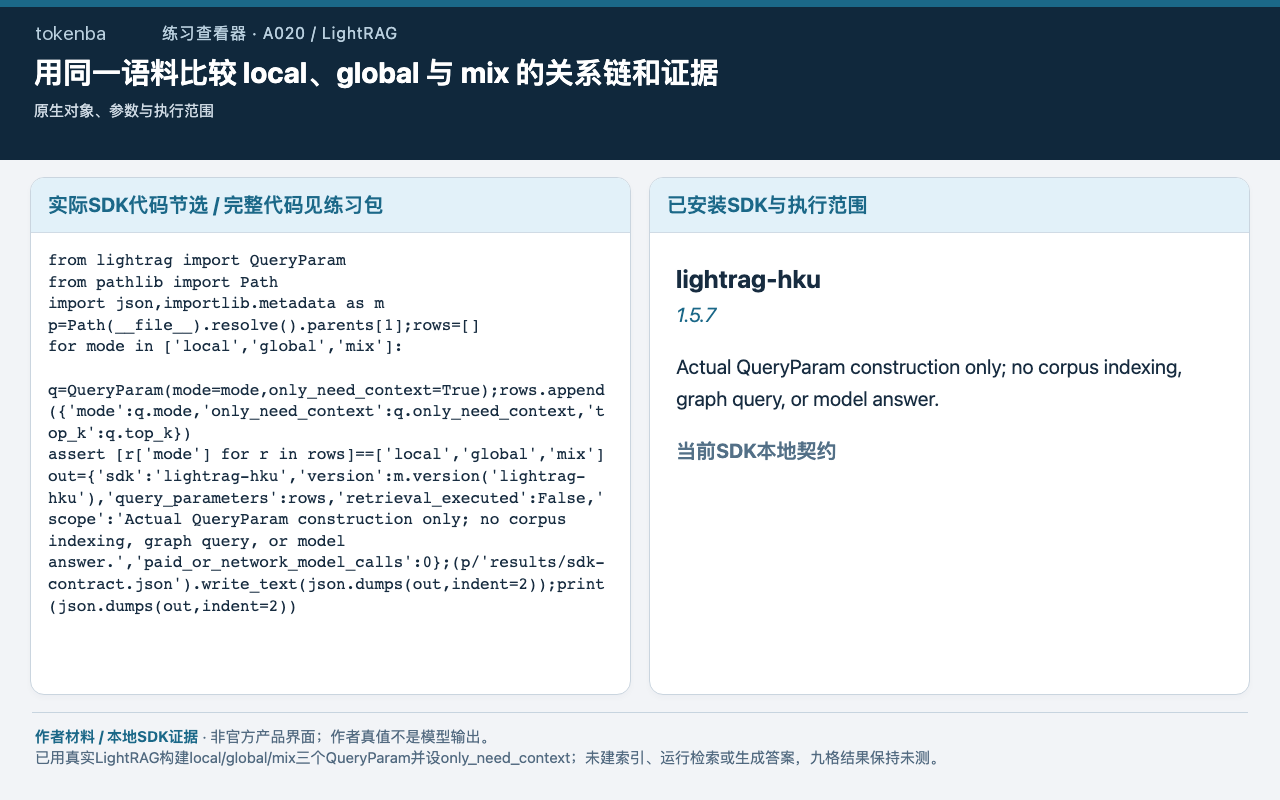
4. 先保存真实检索上下文
在LightRAG查询时先看返回的实体、关系和原文片段;只有最终答案无法解释到底哪层检索发生变化。
5. 再单独记录模型生成
在有模型的授权环境保存每个格子的实际回答及引用。这里的None不是接口空答,是明确未执行占位。
6. 识别语料改变的假对比
negative把local与global放到不同语料,结果不能归因模式。任何索引更新都要重跑全部九格或另建实验。
7. 报告差异并保留失败
按局部关系、全局主题、图文混合三类逐题解释证据差异,不宣称mix必然最佳。本包只审计实验设计,没有检索或模型结果。
怎样确认已经完成
- 不能更换语料后比较
- 答案和检索层分开
- 不承诺mix一定最好
- 已用真实LightRAG构建local/global/mix三个QueryParam并设only_need_context;未建索引、运行检索或生成答案,九格结果保持未测。
常见问题
LightRAG的local、global和mix该怎么选?
按问题需要选局部实体关系、全局主题或混合上下文;本次只真实构造三种QueryParam,未测真实回答质量。
同一个问题换查询模式,检索证据会有什么变化?
固定六份语料、三条问题和其他参数,保存各模式原始context再比较。证据表尚未实测,不能用作者预期填满九格。
这篇教程哪些步骤已经真正执行?
已用真实LightRAG构建local/global/mix三个QueryParam并设only_need_context;未建索引、运行检索或生成答案,九格结果保持未测。