
展开本页目录
开始前准备什么
- 下载完整练习包,在独立目录阅读README与已执行范围。
- 安装requirements.txt指定版本或使用文中目标工具;依赖与模型权重不要混入网站工程。
- 只有明确标为已执行的部分有本次证据;真实模型、账号或GPU步骤按自己的环境另行验证。
- 逐token保存原创二维向量
- 先计算MaxSim参考值
- 建立真实Qdrant多向量集合
- 上传同一组多向量点
- 执行原生query_points
- 加入单向量压缩反例
- 交付逐token贡献和原生排序
1. 逐token保存原创二维向量
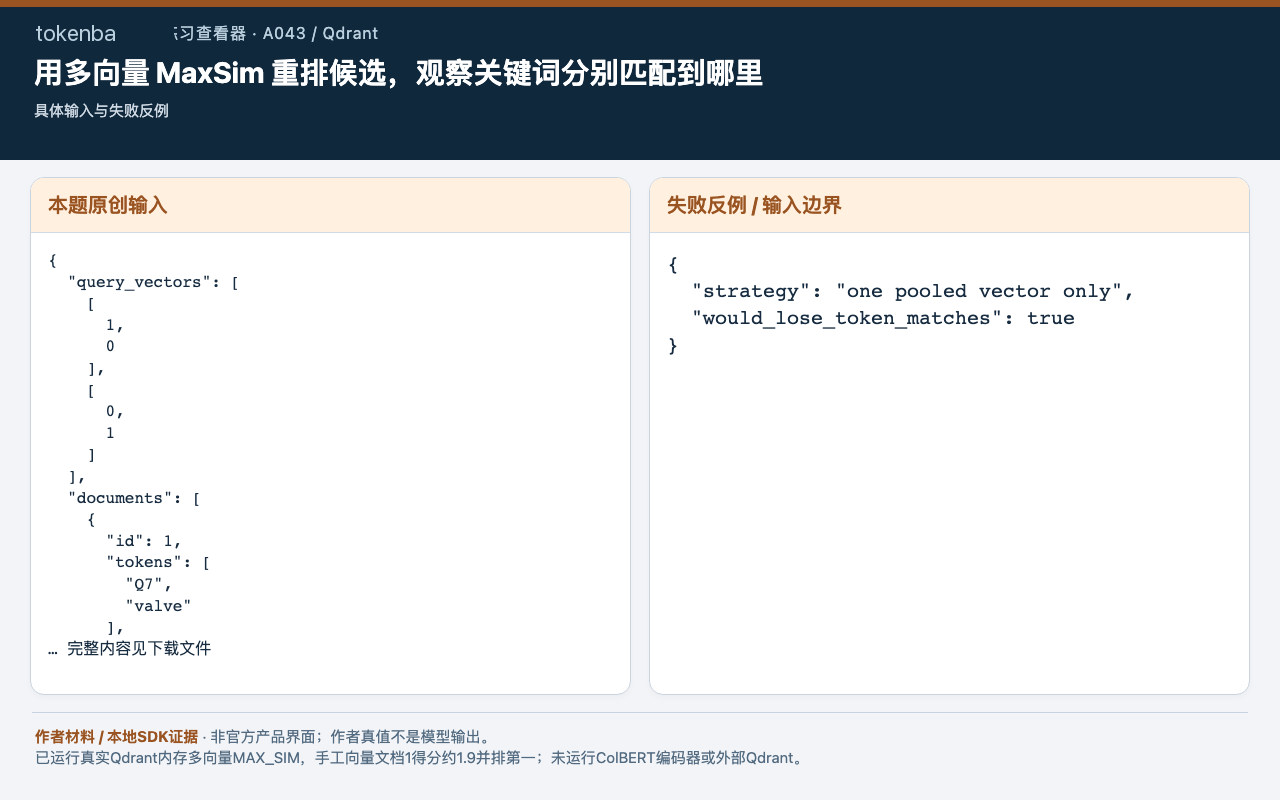
query有Q7与阀门两个方向,文档1分别匹配两个token。向量是作者手工数值,不冒称ColBERT模型编码。
2. 先计算MaxSim参考值
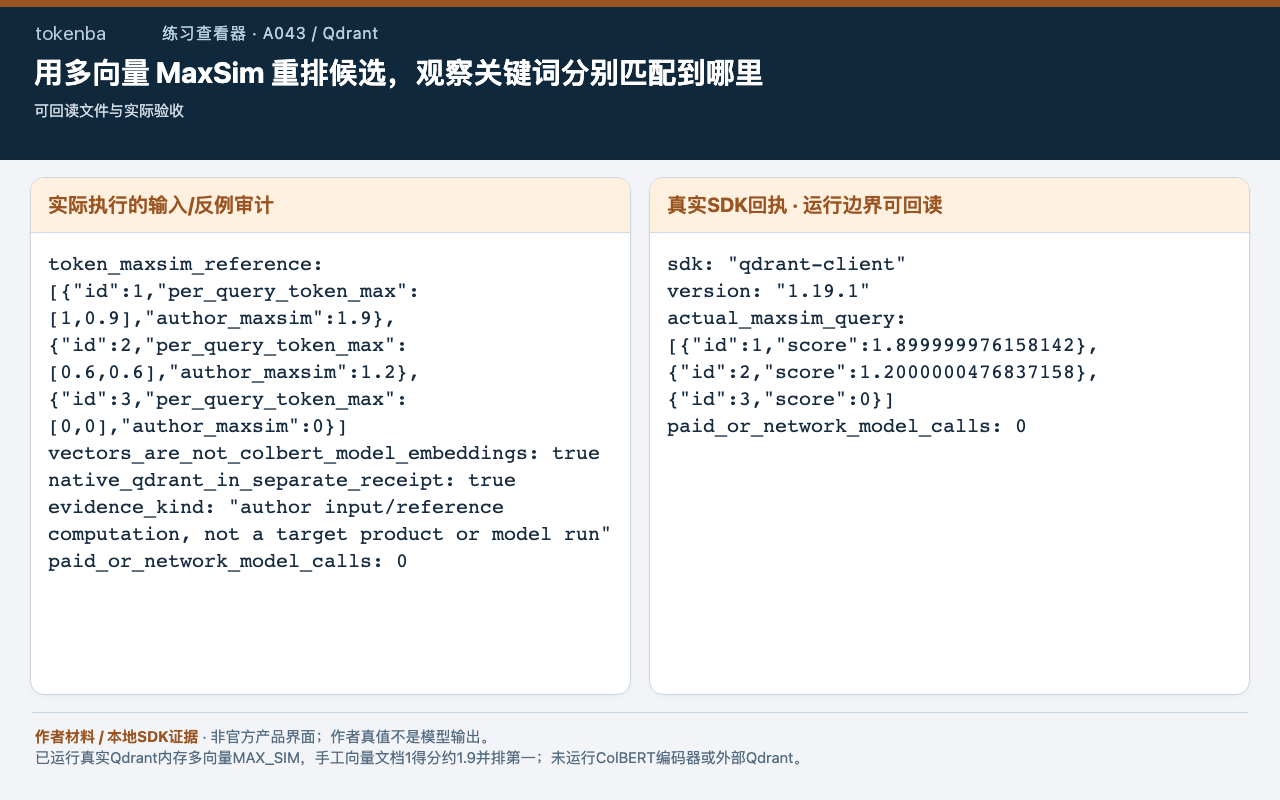
audit.py对每个query token取文档token最大点积再求和,文档1为1.9、文档2为1.2。保留逐token贡献,不能只显示总分。
本题独立目录执行
bash
python reference/audit.py3. 建立真实Qdrant多向量集合
用VectorParams(size=2,distance=DOT,multivector_config=MAX_SIM),不要把二维数组误当单个向量。包内本地内存客户端可不启动服务器。
本题SDK或目标环境入口
bash
python reference/run_sdk.py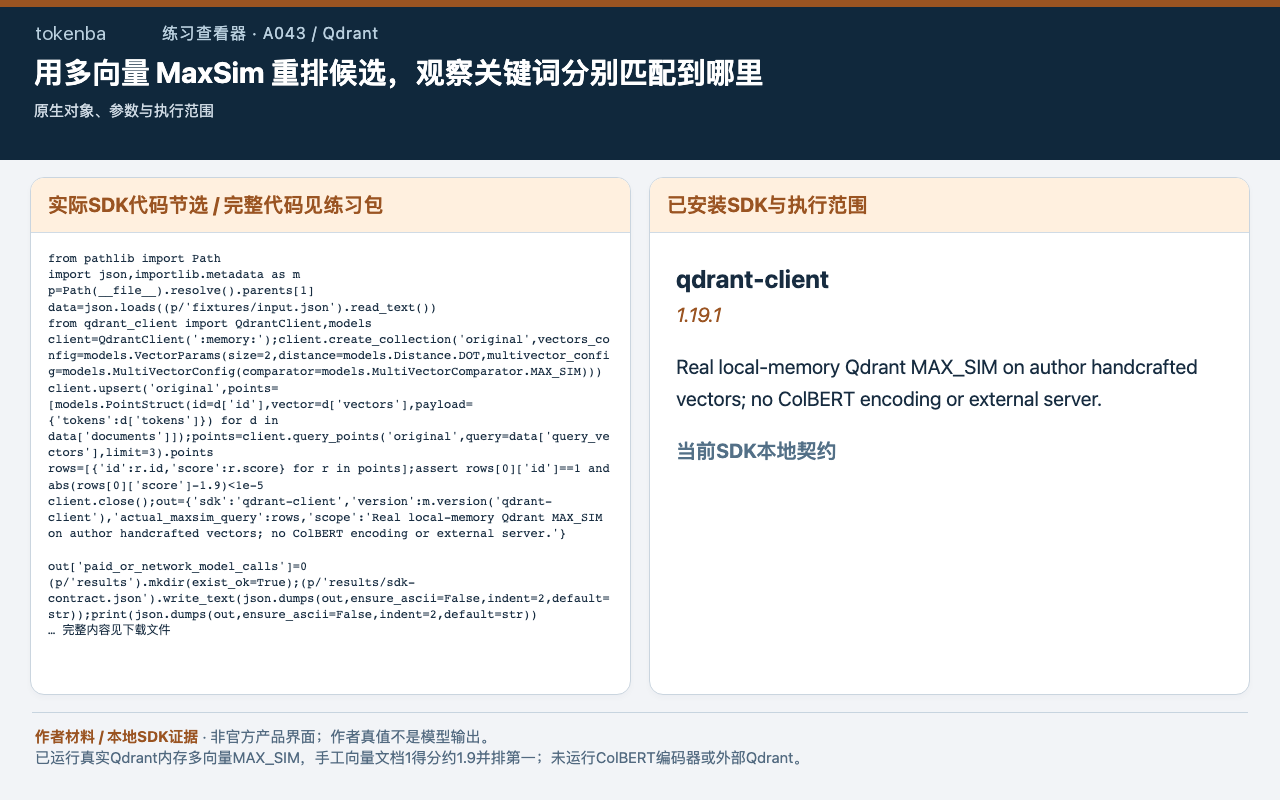
4. 上传同一组多向量点
逐条保存point ID、payload和token向量。生产ColBERT需另用真实模型编码,并核对tokenizer及模型版本。
5. 执行原生query_points
传二维query向量,保存Qdrant实际ID/score,与作者参考并列。匹配分高不等于事实正确或拥有访问权限。
6. 加入单向量压缩反例
把多token均值仅作为比较,观察信息损失;不能把两种分数刻度当成直接可比概率。
7. 交付逐token贡献和原生排序
保留公式、输入、实际SDK回执和版本。本包只验证多向量检索机制,不训练或运行ColBERT编码器。
怎样确认已经完成
- 记录token级向量数量
- 不拿单向量冒充ColBERT
- 精确型号和语义题分开验收
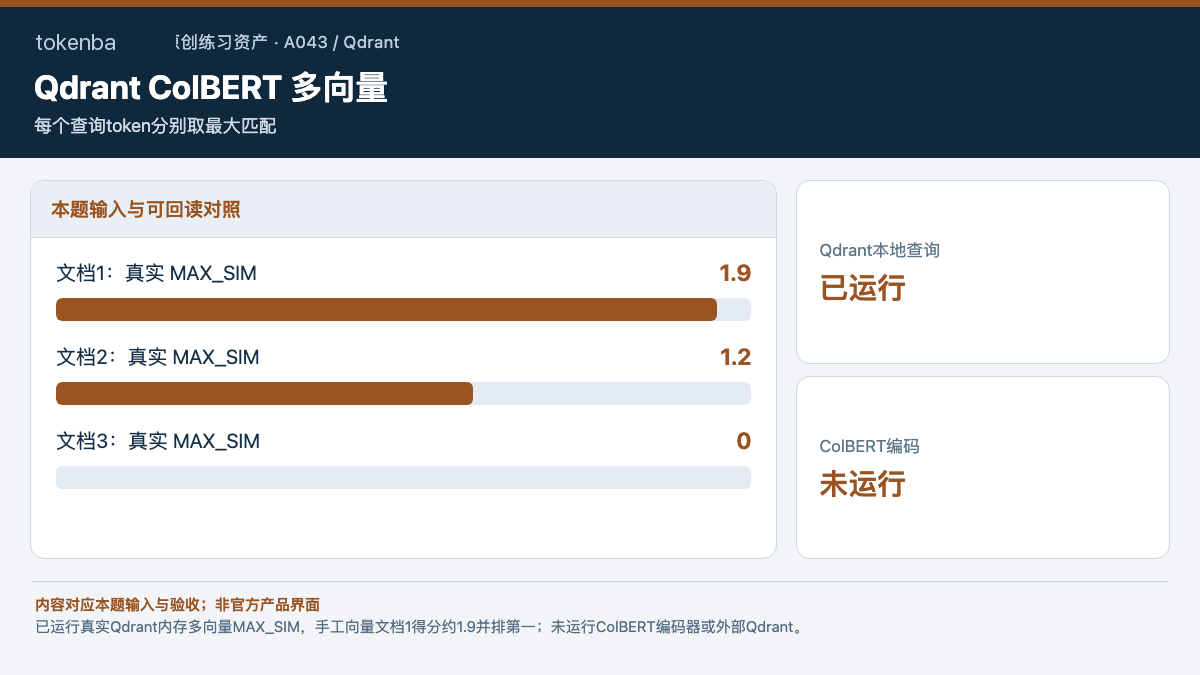
- 已运行真实Qdrant内存多向量MAX_SIM,手工向量文档1得分约1.9并排第一;未运行ColBERT编码器或外部Qdrant。
常见问题
Qdrant ColBERT多向量检索怎么做?
用多向量配置MAX_SIM并给每点上传token向量矩阵,再用查询token矩阵查询。真实Qdrant内存实验已运行,向量手工编写。
MaxSim和普通单向量重排有什么实际差别?
MaxSim逐query token取文档token最大匹配再累加,保留不同词的局部匹配;本包真实分约1.9/1.2/0。未运行ColBERT编码,不能据此宣称生产质量。
这篇教程哪些步骤已经真正执行?
已运行真实Qdrant内存多向量MAX_SIM,手工向量文档1得分约1.9并排第一;未运行ColBERT编码器或外部Qdrant。