
展开本页目录
开始前准备什么
- 需可用Work和代码/文件工具;官方未证明每个账户均开放。
- 使用原创数据,不连接真实用户库;不得推导业务增长结论。
- 已制作并执行作者本地参考;目标ChatGPT Work账号未运行,官方图仅为入口示例。
- 使用原创虚构教学资料,不上传真实敏感信息;SaaS订阅、API服务分别计费,本包无账号或密钥。
- 切到Work并上传两张CSV与固定截止日
- 先让AI复述第7天留存定义及Asia/Shanghai日界线
- 按用户去重访问日,输出可观察与未满期两类名单
- 按注册周计算分子分母,不平均各周百分比
- 生成XLSX和带样本数的热图,要求交付分析代码
- 复查未满期、重复访问与上海日界线
- 下载全部文件,实际打开并核对总人数闭合
原创输入、原生文件、7步README、作者参考、验收表与可运行验证器。
作者本地教材;身份和执行范围见README。
作者本地教材;身份和执行范围见README。
作者本地教材;身份和执行范围见README。
1. 切到Work并上传两张CSV与固定截止日
ChatGPT 留存率分析先打开signups.csv与visits.csv:40名用户、110条访问事件。metric-contract.md固定Asia/Shanghai日界线,D0是注册日,第7天只看D7当日。截止时刻是2026-10-17 00:00,不含该时刻之后的事件。 在ChatGPT选择可用的Work文件任务,并上传这两份CSV和固定截止日。
2. 先让AI复述第7天留存定义及Asia/Shanghai日界线
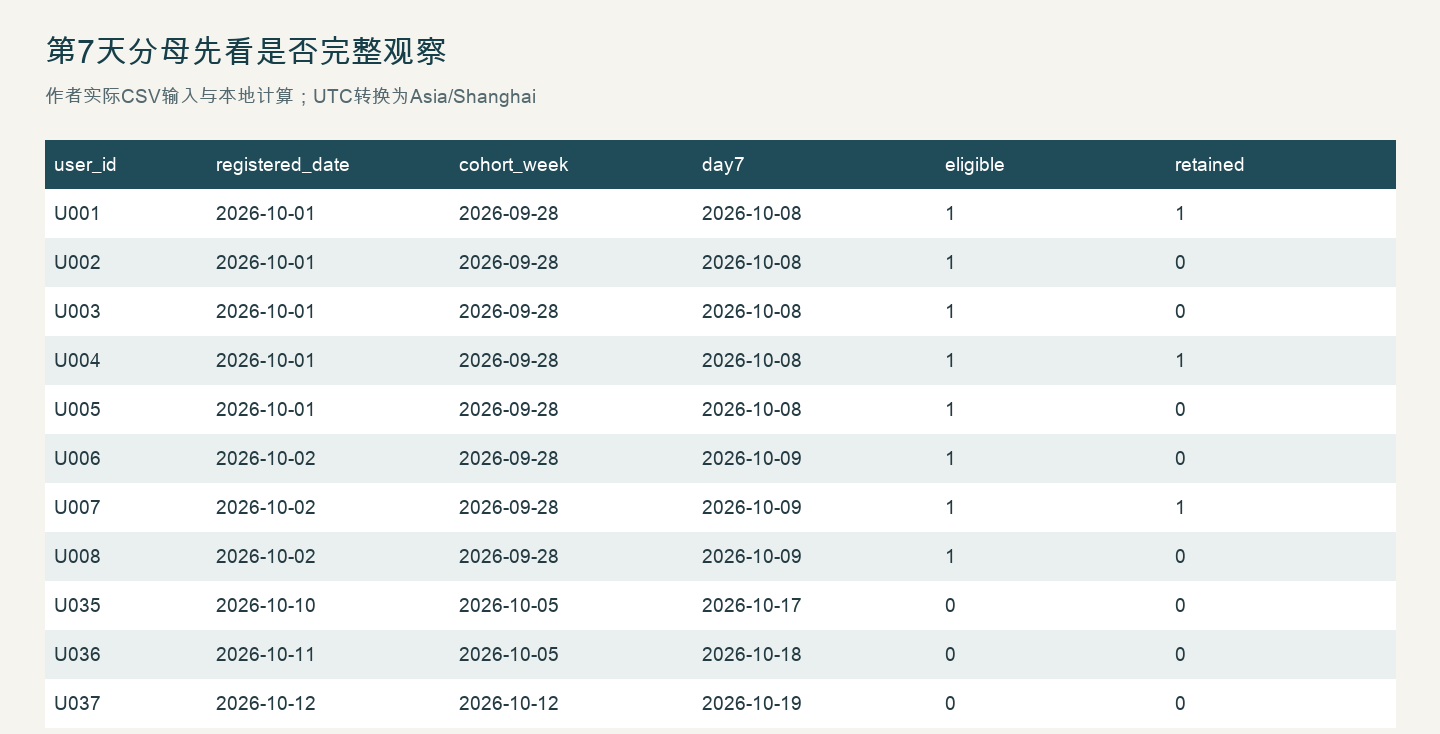
上传后先复述上海日界线与第7天留存定义。先要求复述“完整观察到D7结束才进分母”,再运行。10月10日注册者的D7是10月17日,截止时尚未观察,不能算流失。
3. 按用户去重访问日,输出可观察与未满期两类名单
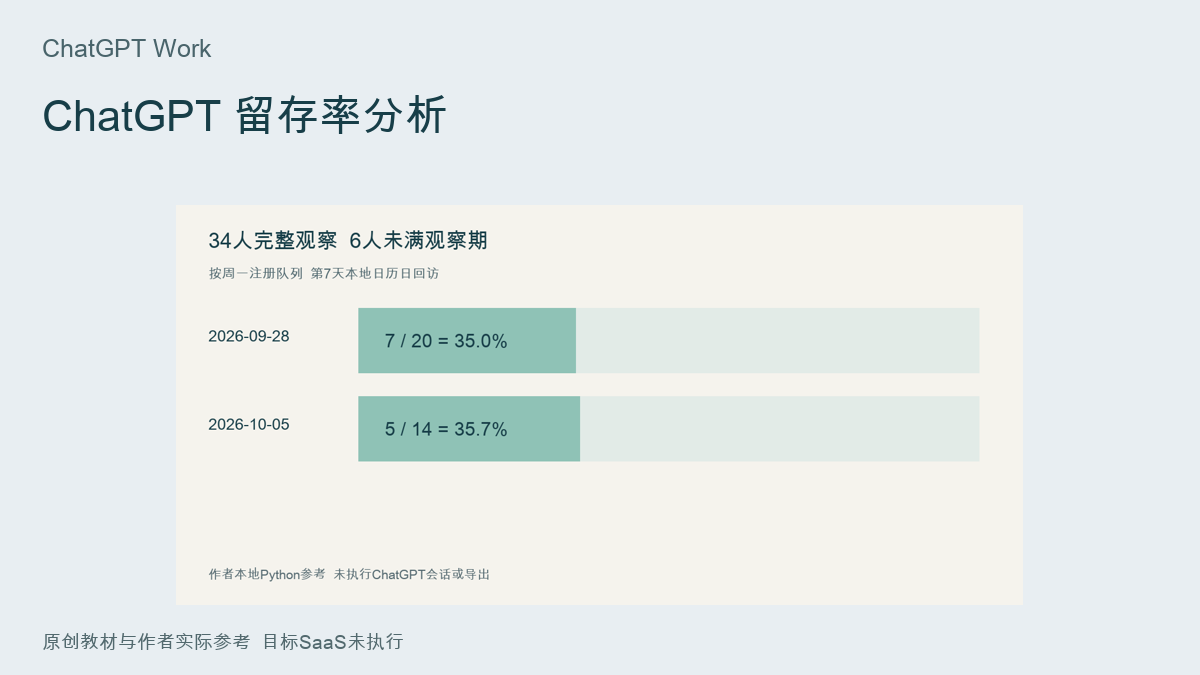
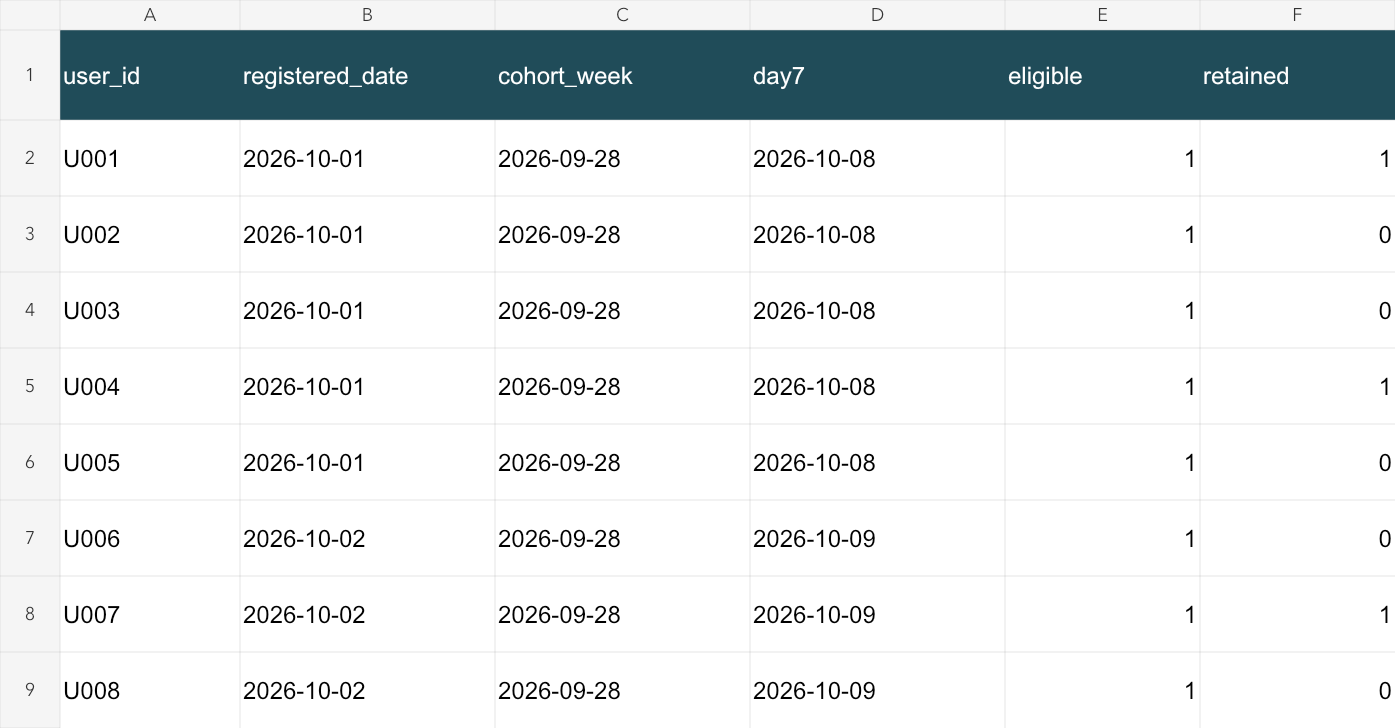
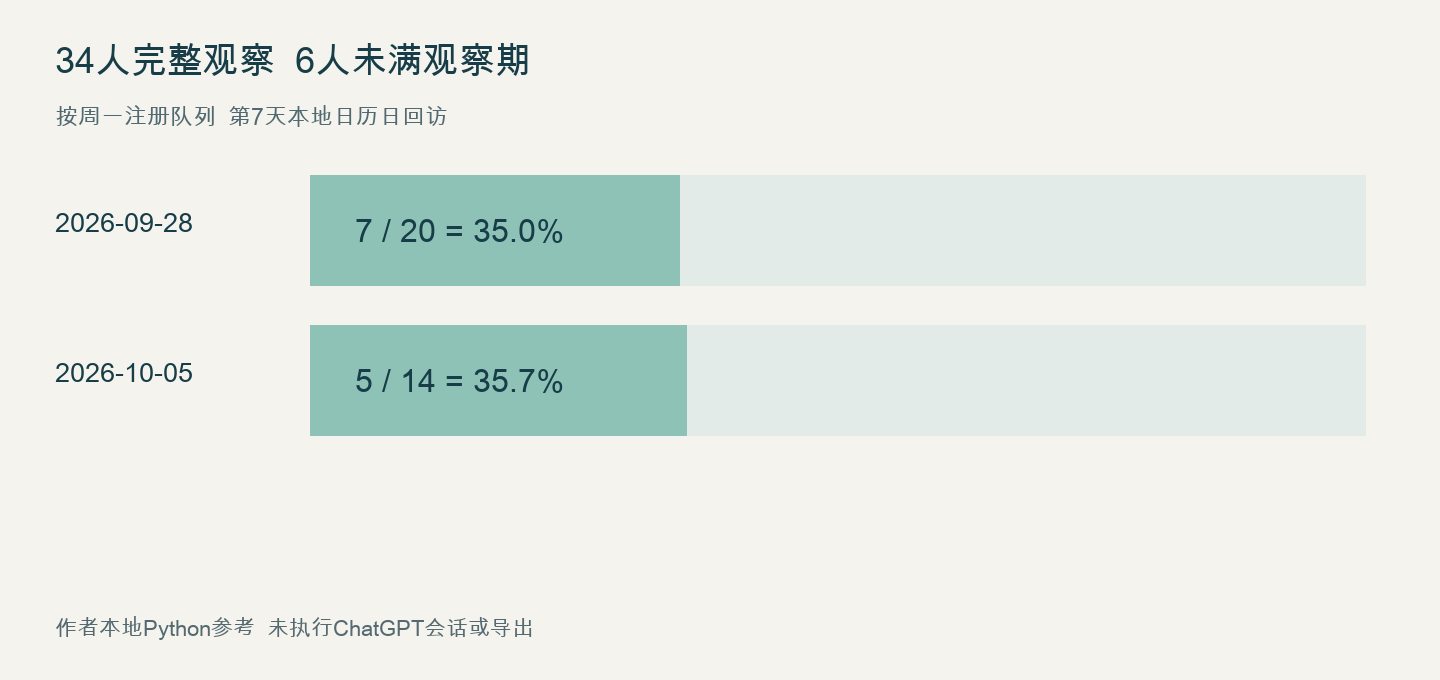
让工具把UTC时间转为上海日期,再按user_id与日期去重。打开user-day7-results.csv看34名可观察与6名未满期;同日两次访问只给同一用户一个留存标记。不能直接对110行事件数做百分比。
4. 按注册周计算分子分母,不平均各周百分比
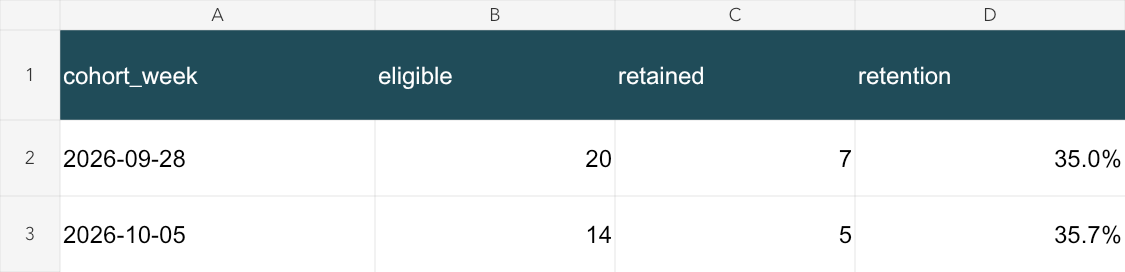
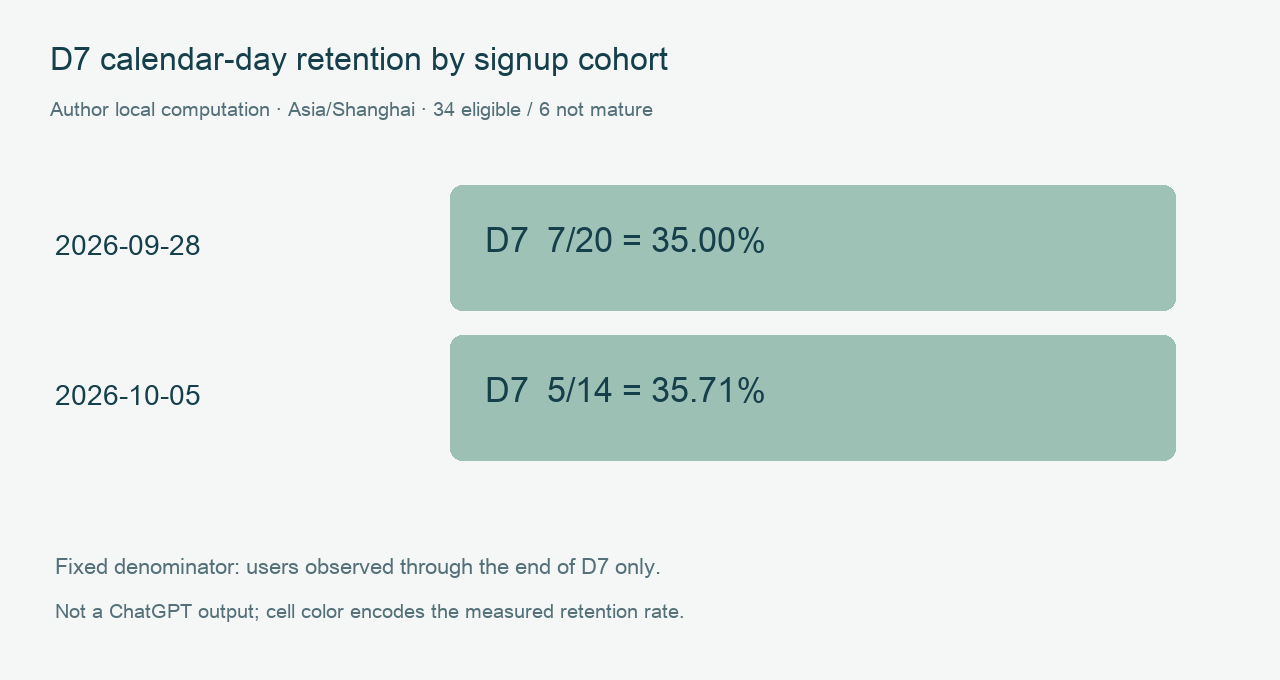
要求按注册周的周一分组,先显示eligible与retained,再除出率。总体率必须总留存人数除以总可观察人数,不能平均两个队列百分比。本包analysis.py实际运行的结果可独立复算。
5. 生成XLSX和带样本数的热图,要求交付分析代码
要求可下载XLSX、带人数的D7热图、队列对照图和代码,并在文件预览里检查数据。本站retention-analysis.xlsx是本地原生工作簿参考;图里的34人/6人来自实际计算,没有运行ChatGPT或伪造会话。
6. 复查未满期、重复访问与上海日界线
把U035与U040放进排除名单回读:它们尚未完整观察到D7。再查同日重复事件、23点注册转UTC和周一起点。运行python3 analysis.py会重算CSV;只验证文件可打开远远不够。
7. 下载全部文件,实际打开并核对总人数闭合
下载自己的文件后,与expected-cohorts.csv比较人数。运行python3 verify.py在临时目录复算并检查40人闭合、110条事件、6名排除和原生XLSX完整性。保留自己会话输出与本地参考的不同身份。
怎样确认已经完成
- 重复访问不增加留存人数,40名用户归属无遗漏。
- 未满观察期用户不进入第7天分母,时区边界符合合同。
- XLSX、热图与CSV分子分母一致,代码在本地固定输入可复算。
常见问题
AI算出来的留存率为什么忽高忽低,分母到底是谁?
分母是截止时完整观察到D7结束的注册用户。本题固定上海日界线,34人可观察、6人未满期;分子是这些人中D7当日回访者,不能用访问事件数或平均队列百分比代替。
刚注册两天的人也算流失吗,怎么让ChatGPT分开?
刚注册两天尚未观察到D7,应列入未满期名单,不能算流失。先要求ChatGPT复述截止日和完整观察条件,再按user-day7-results.csv核对U035、U040等边界用户。
ChatGPT 留存率分析的下载材料是目标AI生成的吗?
已制作并执行作者本地参考;目标ChatGPT Work账号未运行,官方图仅为入口示例。本地原生文件、脚本和实际运行记录用于理解验收。自己的目标账户操作需要另行执行并保存输出。
ChatGPT 留存率分析需要什么账户和费用?
需可用Work和代码/文件工具;官方未证明每个账户均开放;使用原创数据,不连接真实用户库;不得推导业务增长结论 不把apizt API密钥当成独立产品订阅。