
展开本页目录
开始前准备什么
- 没有目标账户权限时保留可操作步骤与真实本地原生参考,明确未实测范围;不把官方产品能力写成作者已跑通。
- 本页使用原创虚构教学材料。已执行本地文件生成、解析或重算;目标SaaS账号未运行,官方图与作者参考分别标注。
- 先读四组分子与分母
- 逐组计算而非平均总百分比
- 保留原始汇总作为对照
- 看清B在两组都更高
- 用共同权重做标准化
- 下载表格、代码与对比图
- 独立复算并限定统计结论
下载完整独立练习包 ZIP
含原始输入、7步README、原生作者参考、参数/检查表与verify.py;不是目标SaaS运行回执。
查看逐步操作与文件身份
原生文件、作者本地运行范围和目标账号步骤分开记录。
下载可打开的原生材料
ab-stratified-reference.xlsx;具体身份见README。
1. 先读四组分子与分母
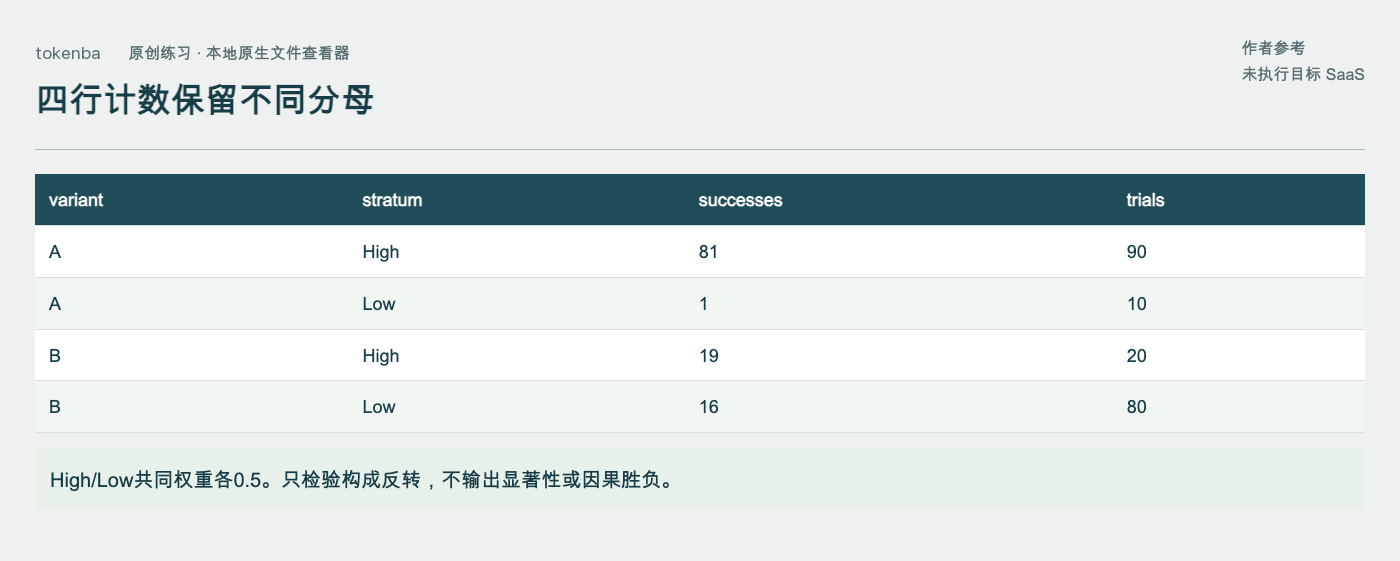
上传4行计数与固定口径,先检查success≤trials、组别无重号。
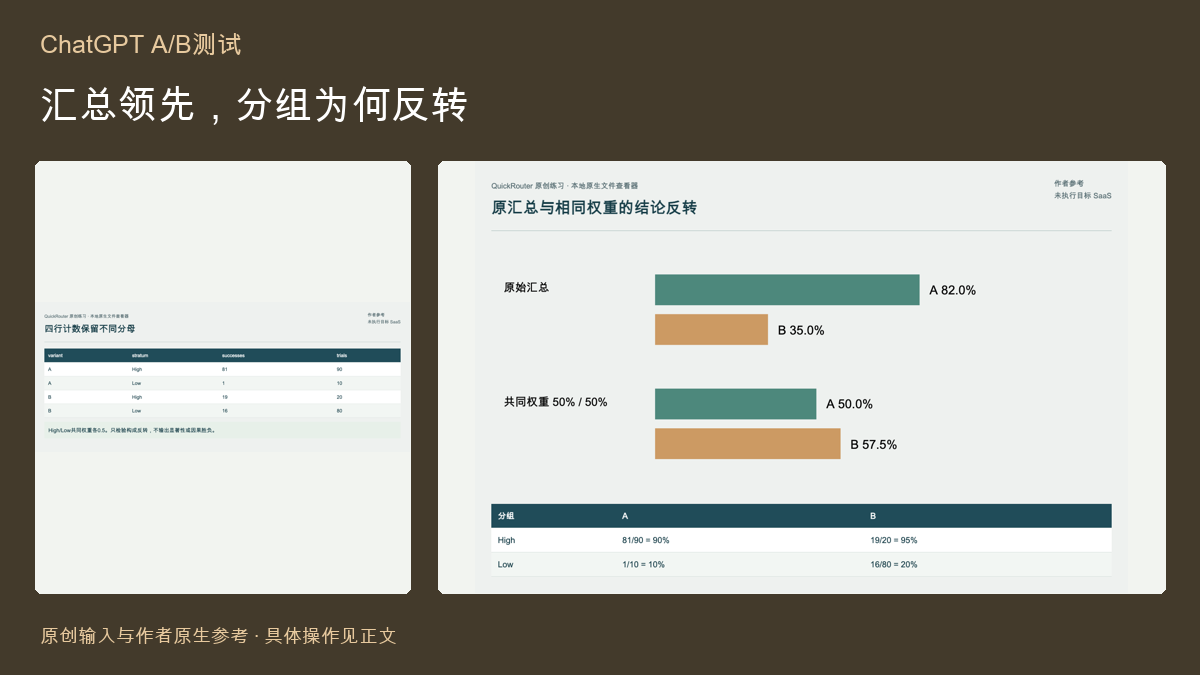
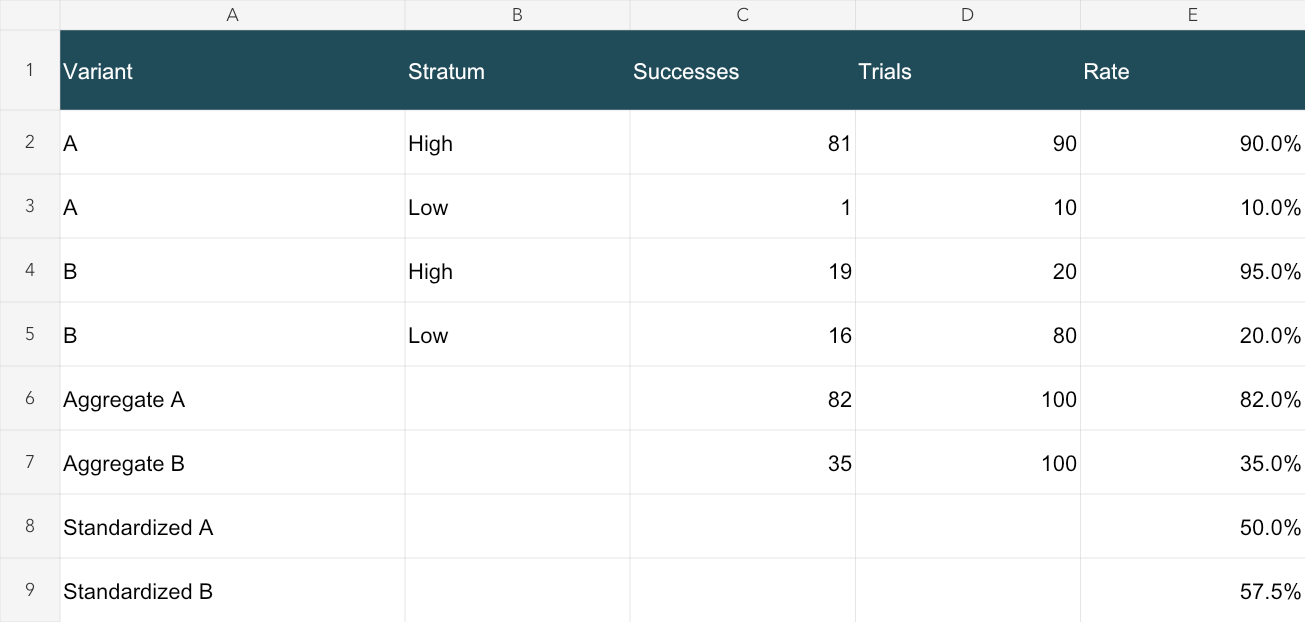
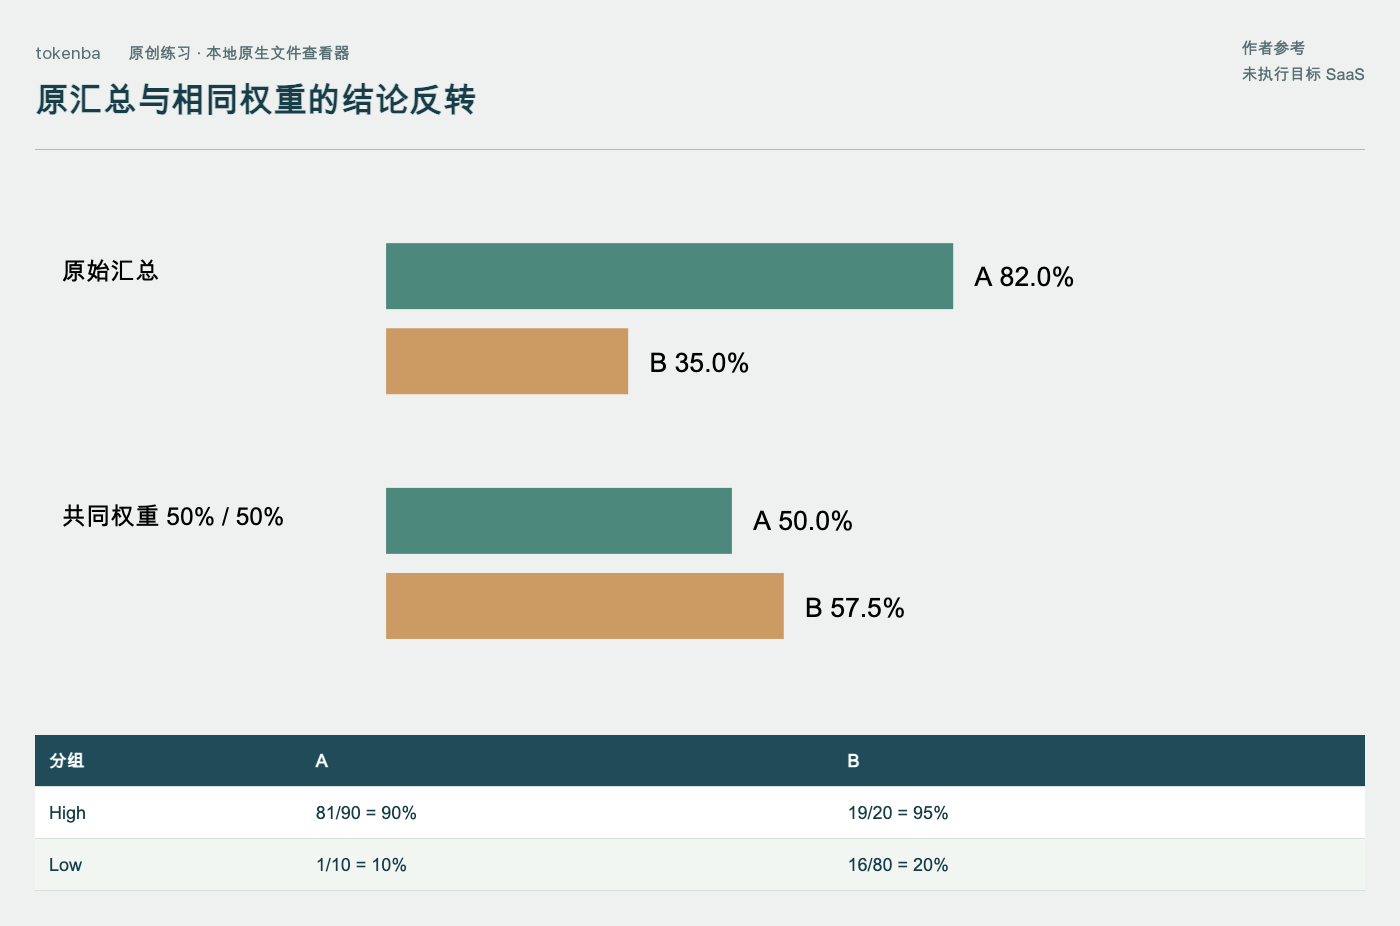
四组真值为A 90%/10%、B 95%/20%;原汇总A82%对B35%,固定50/50权重后A50%对B57.5%。这只演示分组构成反转。
2. 逐组计算而非平均总百分比
要求先列A/B各组分子分母,不从总百分比猜平均。
3. 保留原始汇总作为对照
计算原始汇总:A82/100、B35/100,保留样本构成。
4. 看清B在两组都更高
分别比较两组:B为95%/20%,均高于A的90%/10%。
5. 用共同权重做标准化
以相同50/50权重算标准化率:A50%、B57.5%,写清反转来自构成而非随机实验已证明因果。
6. 下载表格、代码与对比图
导出XLSX、CSV和代码,画原汇总与标准化两组对比图并标权重。
7. 独立复算并限定统计结论
用独立脚本重算四行真值,保留原始汇总,禁止把标准化值回写为原始计数。
在独立副本运行 python3 -B verify.py,检查本题原生对象与数据约束;自己的目标工具结果另存,不覆盖教材原件。
怎样确认已经完成
- 四组率90%/10%/95%/20%、原汇总82%/35%、等权50%/57.5%全部可复算。
- 每张图有分母与权重说明;不同分组构成不被当成可直接选胜者的证据。
- 无p值、显著性、真实收益或因果提升承诺;XLSX包含真实数值和计算说明。
常见问题
标准化后的B更高就能宣布B胜出吗?
不能。本题是确定计数的构成反例,没有随机化、样本估计与显著性检验,也没有证明因果提升。
为什么不平均四个百分比?
分子分母和分组权重不相同。原汇总必须先分别相加计数;标准化则明确采用两组各0.5的共同权重。