
展开本页目录
开始前准备什么
- 下载并解压到独立目录,先阅读README里的真实执行范围。
- 使用自有输入,不把系统朗读、程序合成源或官方截图冒充模型生成。
- 先完成12秒练习,再扩大文件长度;固定实际工具、模型与运行设备。
- 比较有回声录音与干声
- 固定实际UVR与模型版本
- 只输入一条人声录音
- 记录首轮参数再运行
- 检查句尾和弱读字
- 对齐后才做差异分析
- 保留不适用范围
含原创输入、逐步说明、真实检查脚本和已标明身份的实际输出;不含模型权重。
已从原创系统朗读加入四段已知延迟生成混响输入,完成原始与干声参考检查;未运行UVR去混响模型。
读取实际PCM16文件与源hash,拒绝损坏或空音频;不请求任何模型。
已从原创系统朗读加入四段已知延迟生成混响输入,完成原始与干声参考检查;未运行UVR去混响模型。
1. 比较有回声录音与干声
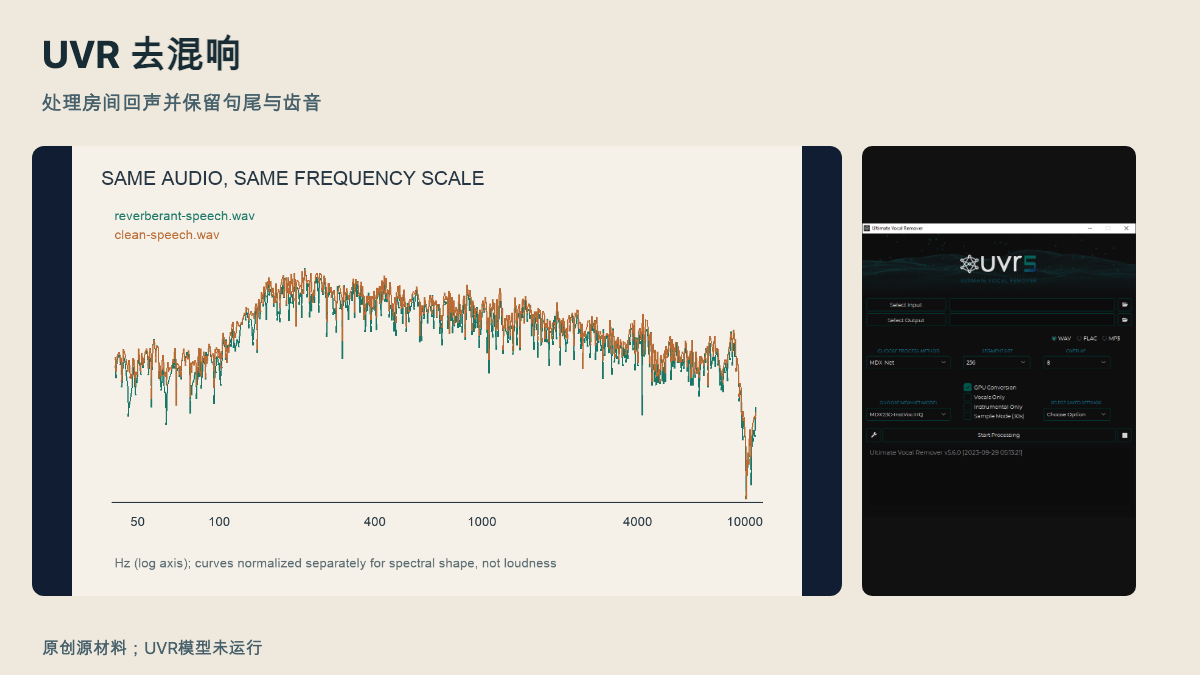
先听reverberant-speech.wav,再听clean-speech.wav。输入由原创系统朗读叠加55、120、210、340毫秒的延迟构成,干声是真值参考,不能称为去混响输出。
bash
python3 verify.py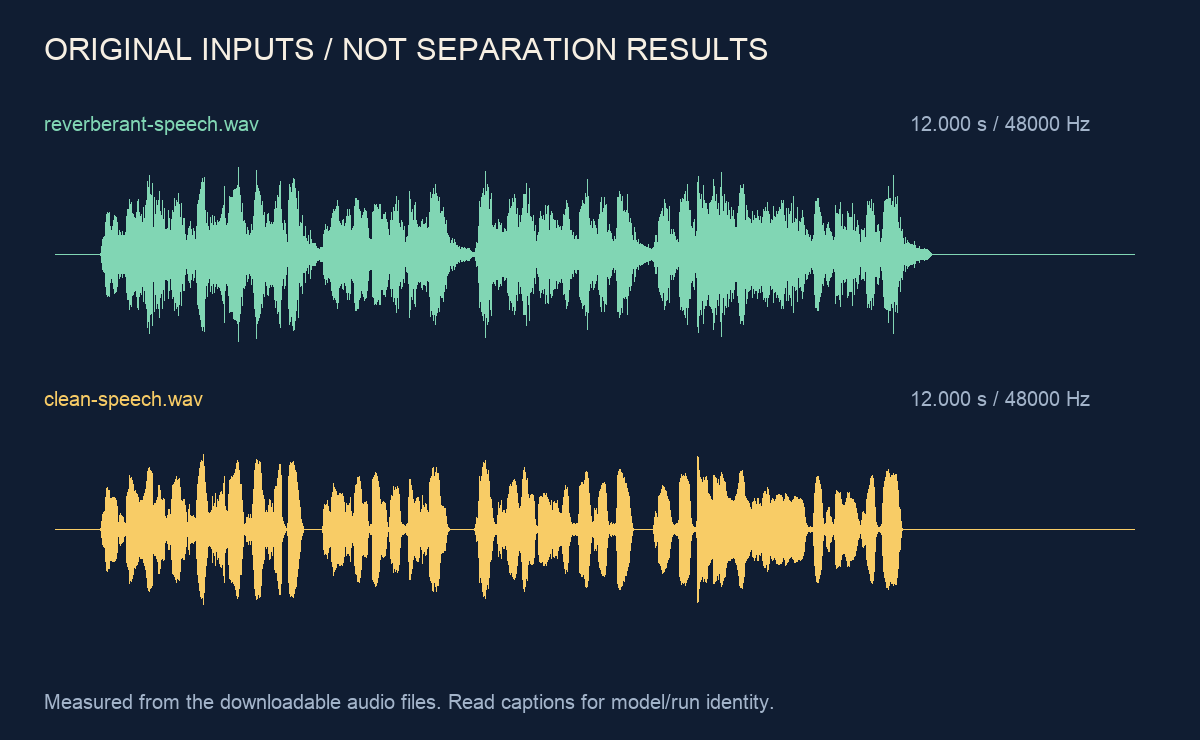
2. 固定实际UVR与模型版本
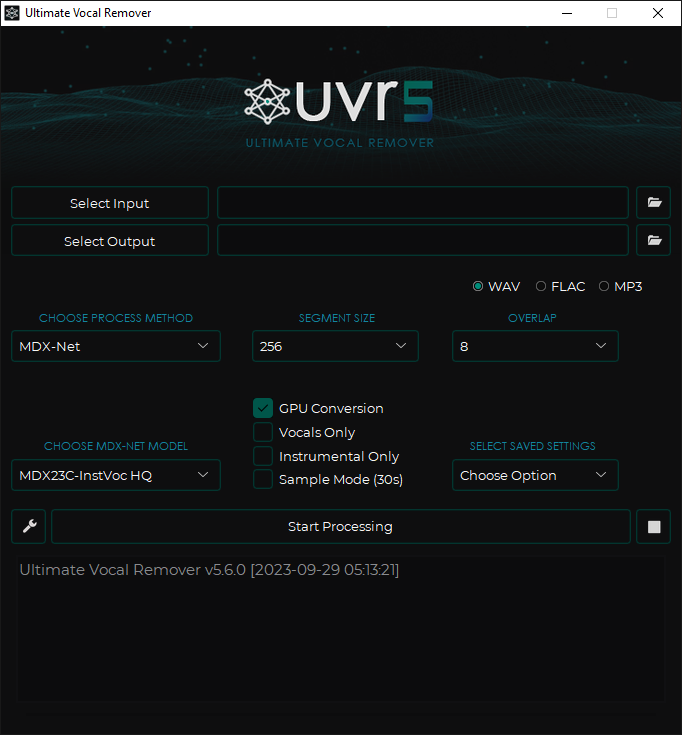
使用官方UVR 5.6系列,在Download Center核对UVR-DeEcho-DeReverb是否仍可下载,并保存完整模型名。该模型属于VR路线,不能在MDX模型框随意选一个同名文件;找不到模型就停止并记录版本。
3. 只输入一条人声录音
先处理不带音乐的原始人声混响,选独立输出目录和WAV。官方初始界面只说明Select Input与输出位置;本页没有本站实际去混响界面截图。
4. 记录首轮参数再运行
固定同一模型和默认参数,先完成一次12秒处理。显存或依赖错误应保留原始错误文本,不能把正常导出干声参考作为故障回退的模型结果。
5. 检查句尾和弱读字
对“设备”“接口”“结果”的句尾逐段回听。回声减弱但辅音被吞掉仍属于失败;文件更安静或峰值更低不等于人声更清楚。
6. 对齐后才做差异分析
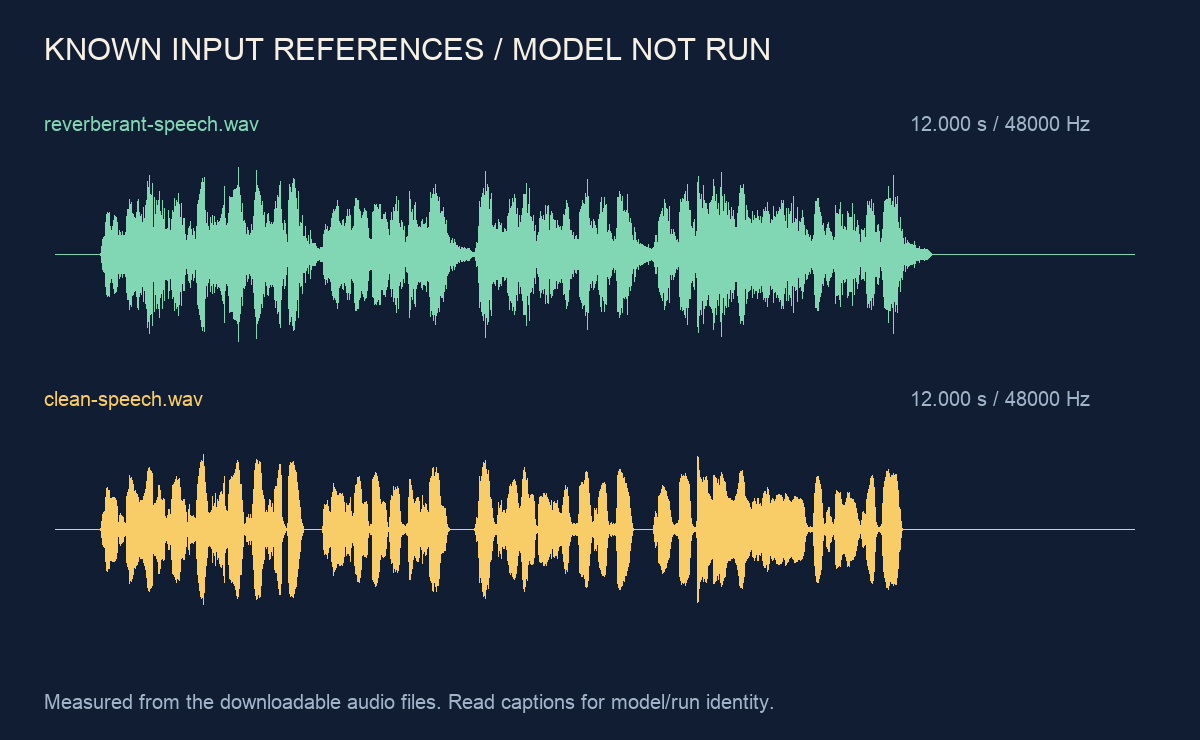
把真实输出与干声参考对齐,再看尾音区域和频谱。本页图展示已知输入与源参考,不包含未运行模型的预期差值。
bash
python3 verify.py --file your-dereverb.wav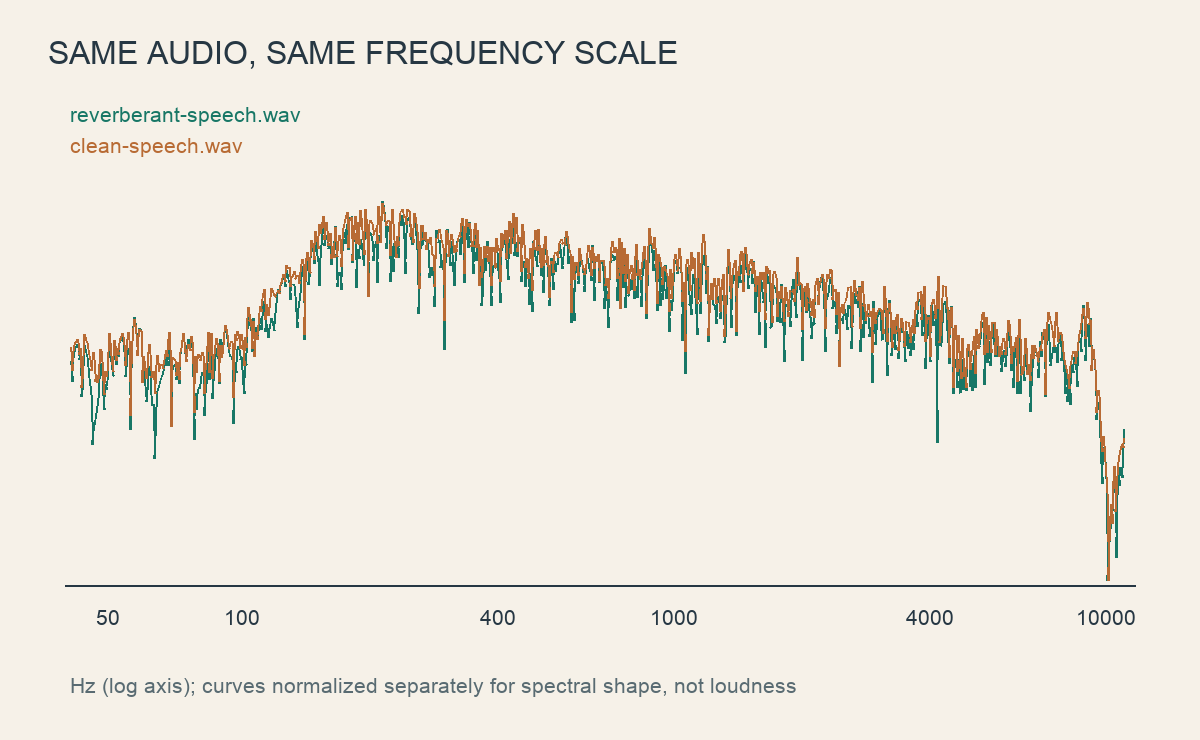
7. 保留不适用范围
记录残留与声音损伤,不承诺去除所有房间回声。后续如果做旁白,应再核对文字完整性;不要把语音降噪、歌曲去伴奏和去混响当作同一模型任务。
怎样确认已经完成
- 实际输入与输出均可解码,采样率、声道、帧数和时长已记录。
- 按指定同一音节/乐句或首尾有声段回听,保留残留、失真和失败区间。
- 已从原创系统朗读加入四段已知延迟生成混响输入,完成原始与干声参考检查;未运行UVR去混响模型。
常见问题
UVR 去混响下载后就是模型成功结果吗?
已从原创系统朗读加入四段已知延迟生成混响输入,完成原始与干声参考检查;未运行UVR去混响模型。 输入预检、已知源参考和模型推理是不同证据,未运行时不提供伪造结果。
录音有回声怎样判断完成?
先核对当前教程中的真实文件、参数和模型身份,再按第六步的同一区间验收;仅文件存在、峰值变小或界面显示完成都不足以证明声音质量。