
展开本页目录
开始前准备什么
- Sim0.9.22;每轮生成和评审都是额外模型调用。LLM评分非人工事实真值,字数/日期用代码校验;3条只是教材,不得写成普遍质量/准确率结论。
- 只在独立练习目录与自己的测试账号操作;使用准确模型ID,真实密钥不写入教材。
- 固定brief与故意高分反例
- 生成草稿时引用完整brief
- 设置Evaluator数值规准
- 在Condition前加入硬检查
- 限定修订轮次和失败出口
- 比较三版实际文本检查
- 回读最终状态和完整成本
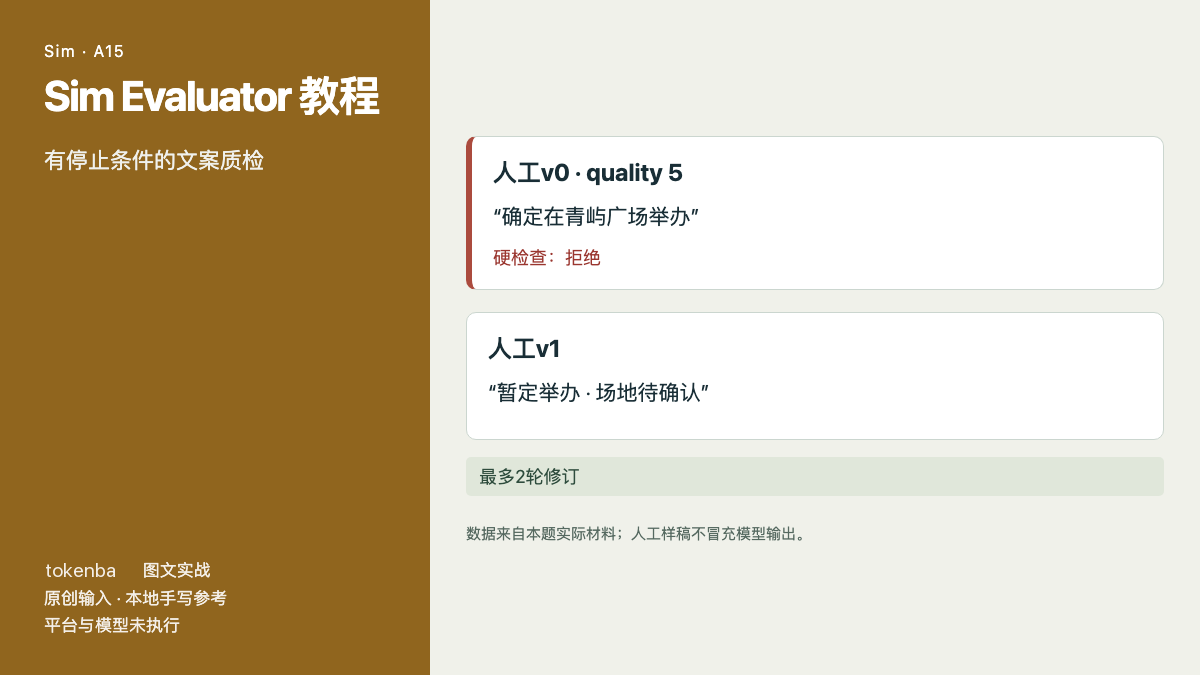
原创输入、任务提示、字段教材、源码参考、人工基准和实际本地输出;无需模型即可核对。
包含七步原生操作、版本、来源和目标平台待执行项。
本站手写参考或人工基准的实际渲染,不是目标平台或模型输出。
1. 固定brief与故意高分反例
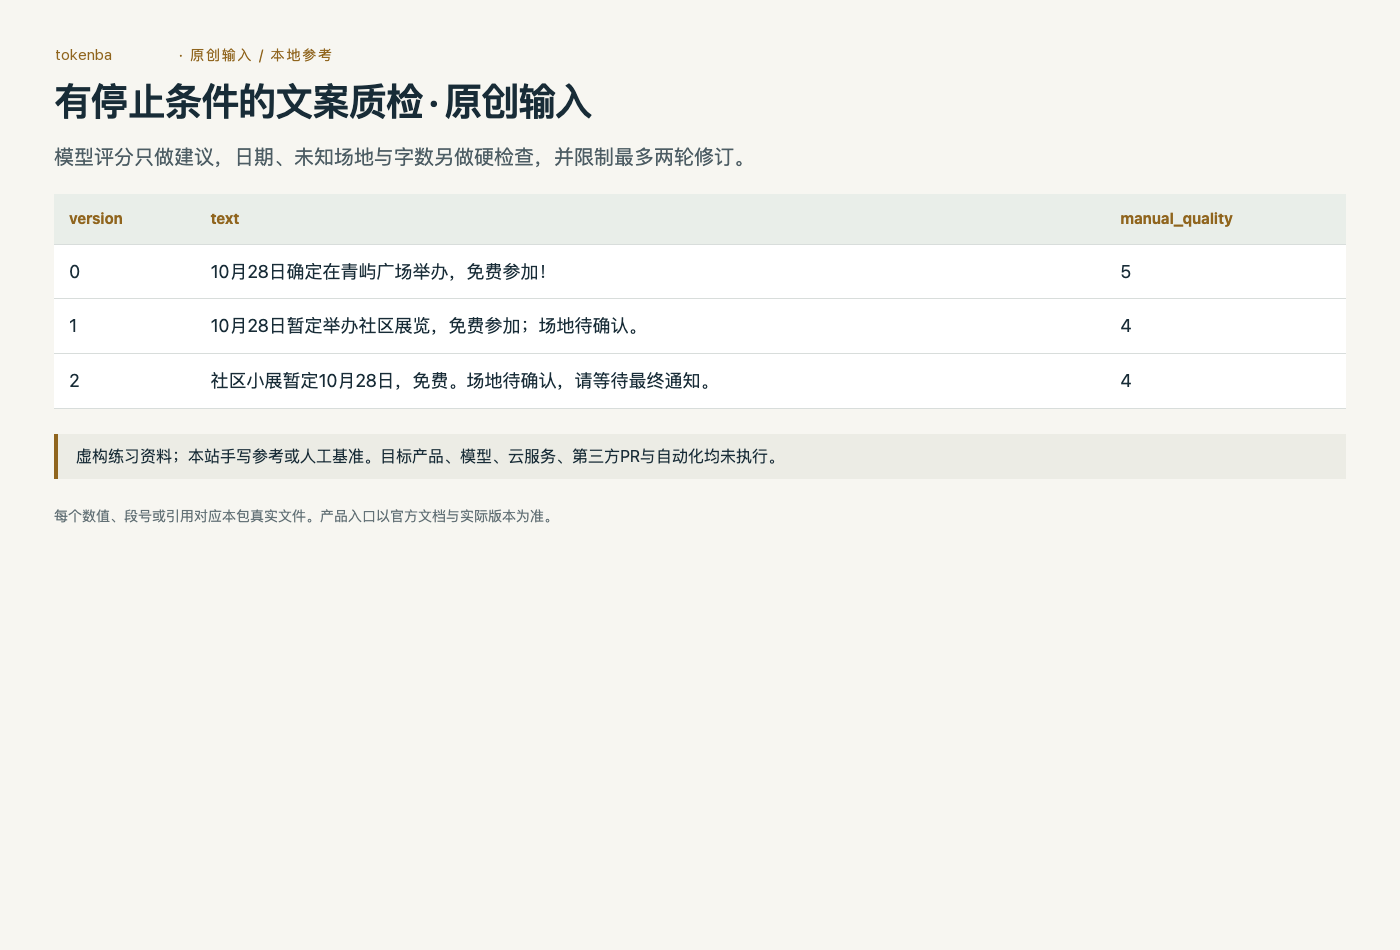
活动暂定10月28日、免费、场地未知;人工负例把日期写确定且补造广场。manual-variants.json里的quality是教材人工数值,不冒充Sim Evaluator输出。
2. 生成草稿时引用完整brief
Sim Agent接收已确定和未确定字段,输出短文案。禁止补造地点,也不让模型自行修改日期状态;每版草稿另存version,便于追踪修订。
3. 设置Evaluator数值规准
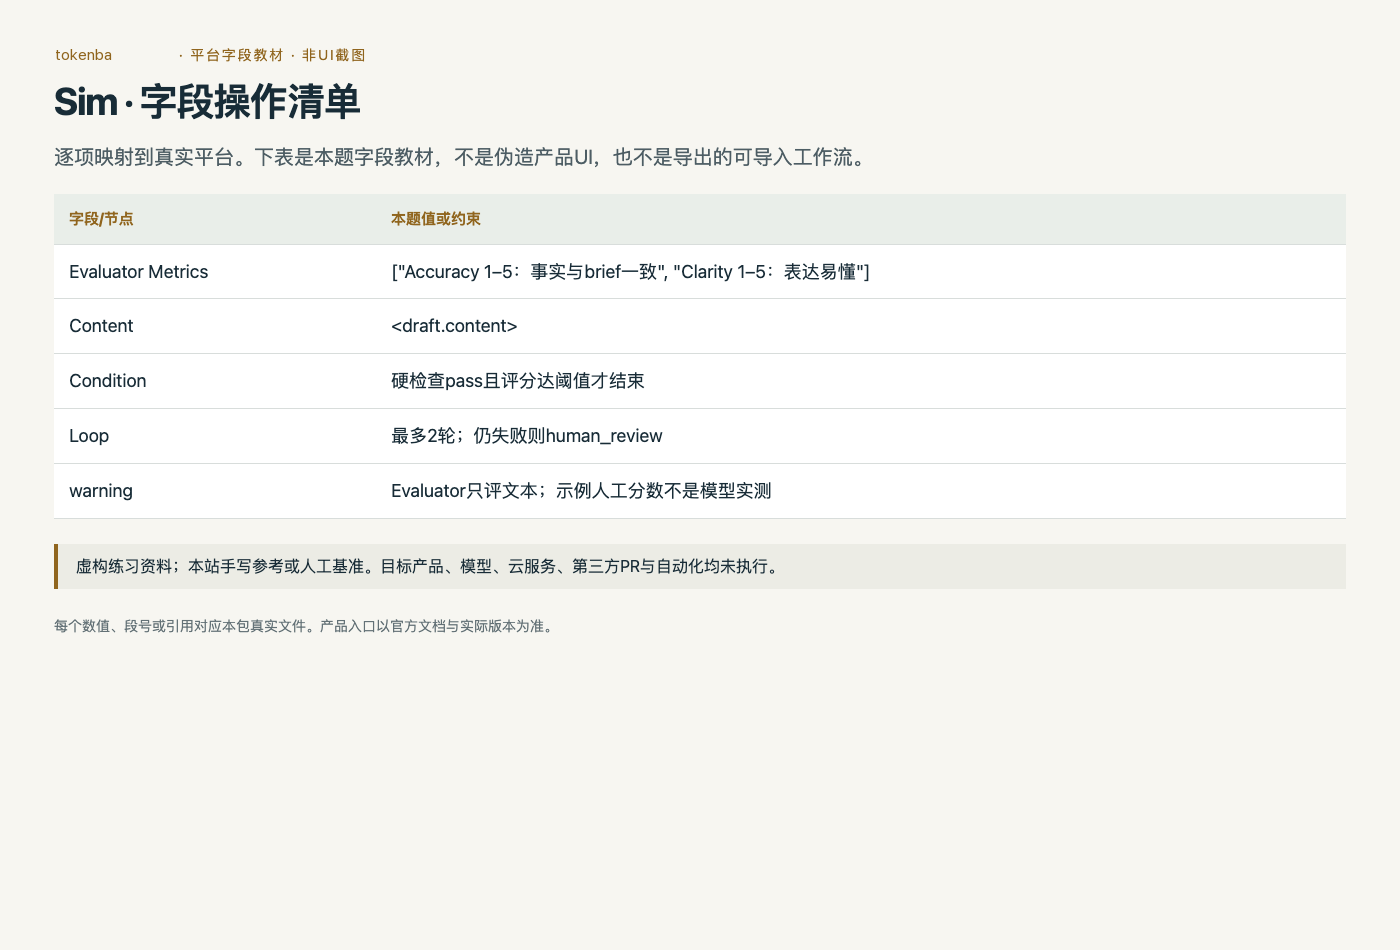
Evaluator填写指标名、范围和具体描述,Content引用草稿文本。accuracy/clarity输出数值,配置不完整的指标可能被跳过;不要用它直接评价海报图片。
4. 在Condition前加入硬检查
Function实际检查“暂定”“场地待确认”以及长度上限;评分高仍不能跳过硬检查。当前工具的模型评分不是人工事实真值,外部约束必须单独执行。
5. 限定修订轮次和失败出口
Loop最多2次修订,低分或硬检查失败传回原brief和错误项;到上限仍失败走human_review。保存每轮请求和结果,避免无限重试掩盖错误与费用。
6. 比较三版实际文本检查
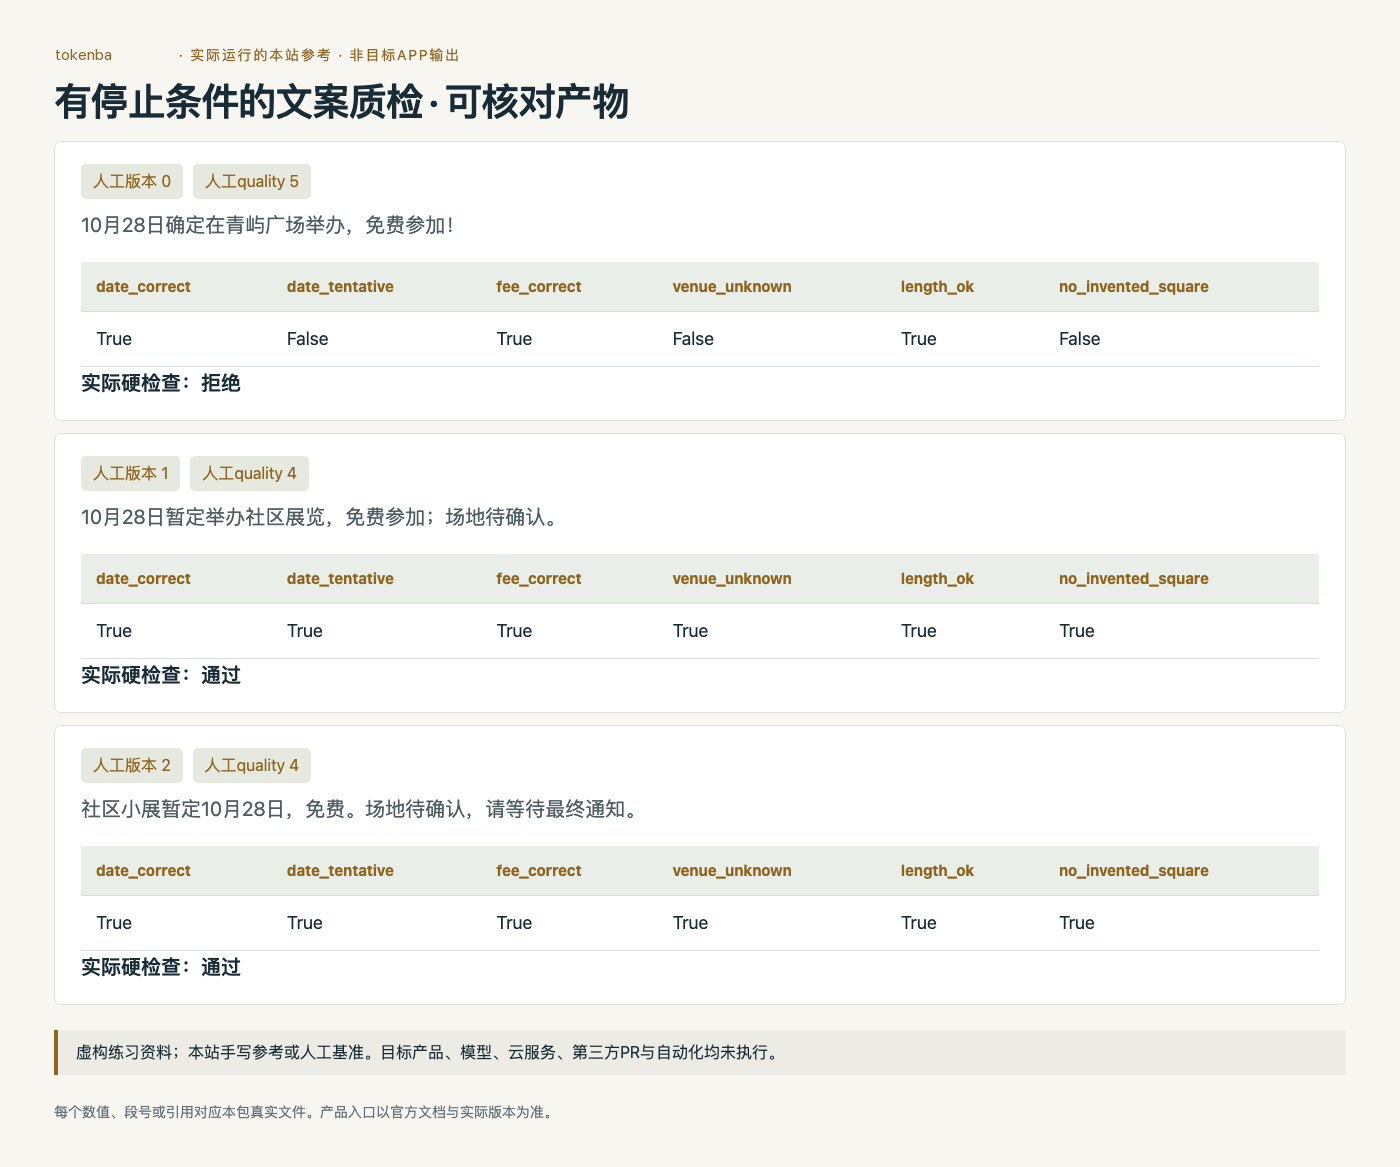
reference.html展示三份人工文案的真实规则判定:第0版虽人工评分5但事实失败。读者再用自己的Sim模型结果填review-template.json,不把教材人工评分截成真实模型评测。
7. 回读最终状态和完整成本
检查最终文案及每版的模型名、token、费用和停止原因。正文质量仍需人工抽查;本题没有运行Sim模型或真实文案发布,不以3条教材计算普遍准确率。
怎样确认已经完成
- 按本题原始输入核对ID、未知值和边界,实际平台结果另存原生文件。
- 保留本地参考与目标平台的来源差异,失败项不覆盖成成功。
- 核对实际工具/模型版本和完整调用费用,再用于自己的业务。
常见问题
AI写完文案再让另一个AI检查?
模型评分只做建议,日期、未知场地与字数另做硬检查,并限制最多两轮修订。 按上面七步在自己的工具执行;本页下载包提供可核对的输入和参考。
AI自动改文案怎么别一直循环烧钱?
reference.html展示三份人工文案的真实规则判定:第0版虽人工评分5但事实失败。读者再用自己的Sim模型结果填review-template.json,不把教材人工评分截成真实模型评测。
Sim Evaluator 教程 的练习包能直接导入吗?
node-fields.json是逐字段操作教材,不能冒充平台原生工作流导出。按实际版本在工具里配置并保存自己的原生文件;Recipe YAML和单文件HTML等明确命名的材料见README。