
展开本页目录
开始前准备什么
- 下载完整练习包,在独立目录阅读README与已执行范围。
- 安装requirements.txt指定版本或使用文中目标工具;依赖与模型权重不要混入网站工程。
- 只有明确标为已执行的部分有本次证据;真实模型、账号或GPU步骤按自己的环境另行验证。
- 准备喜欢与不喜欢的样本
- 检查反馈冲突
- 建立真实Qdrant本地集合
- 先只给positive检索
- 加入negative对照
- 核对推荐策略的适用范围
- 交付用户反馈与排序变化
1. 准备喜欢与不喜欢的样本
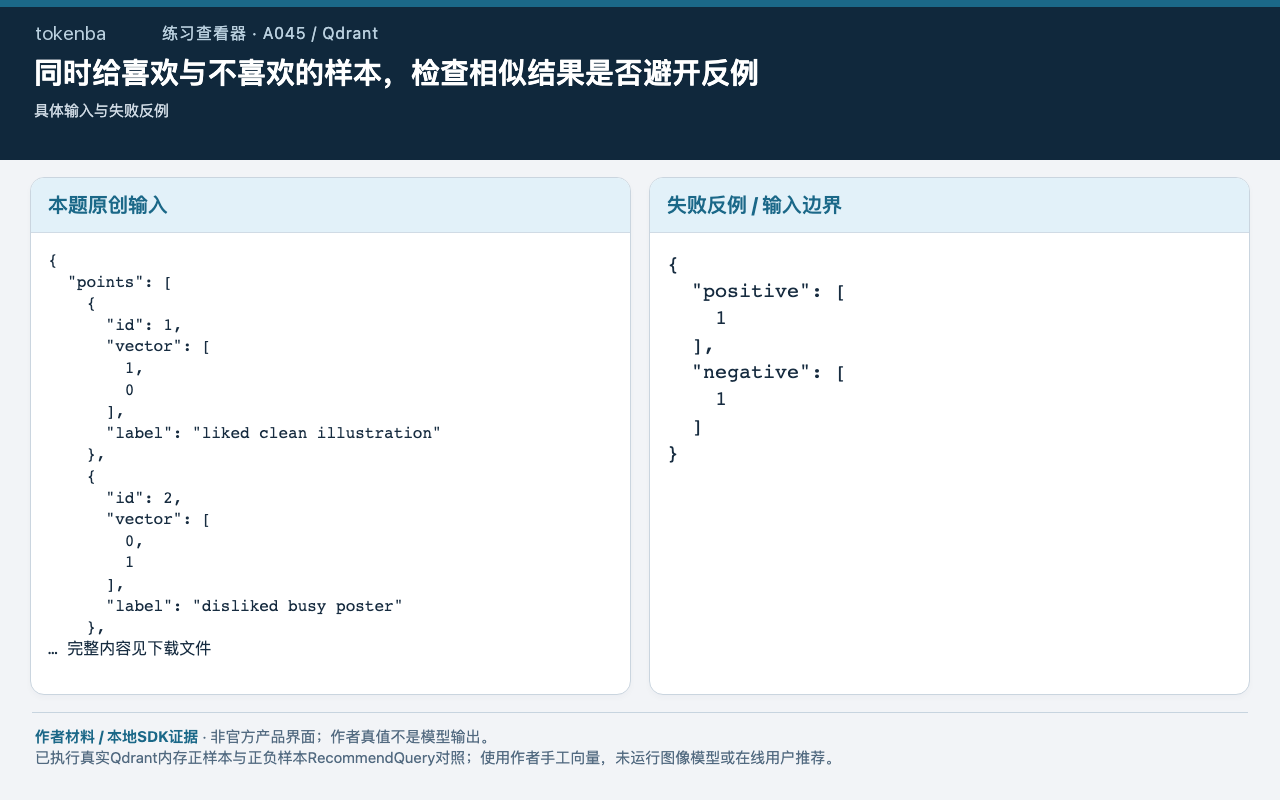
1表示简洁插画,2表示繁复海报;3/4/5为候选。标签和二维向量来自作者,不是图像模型判断。
2. 检查反馈冲突
audit.py要求同一ID不能同时在正负反馈中。negative.json故意冲突,应在发送请求前提醒用户修正。
本题独立目录执行
bash
python reference/audit.py3. 建立真实Qdrant本地集合
用同一向量距离和维度导入五点,记录point ID。实际图像应用还需固定真实embedding模型与版本。
本题SDK或目标环境入口
bash
python reference/run_sdk.py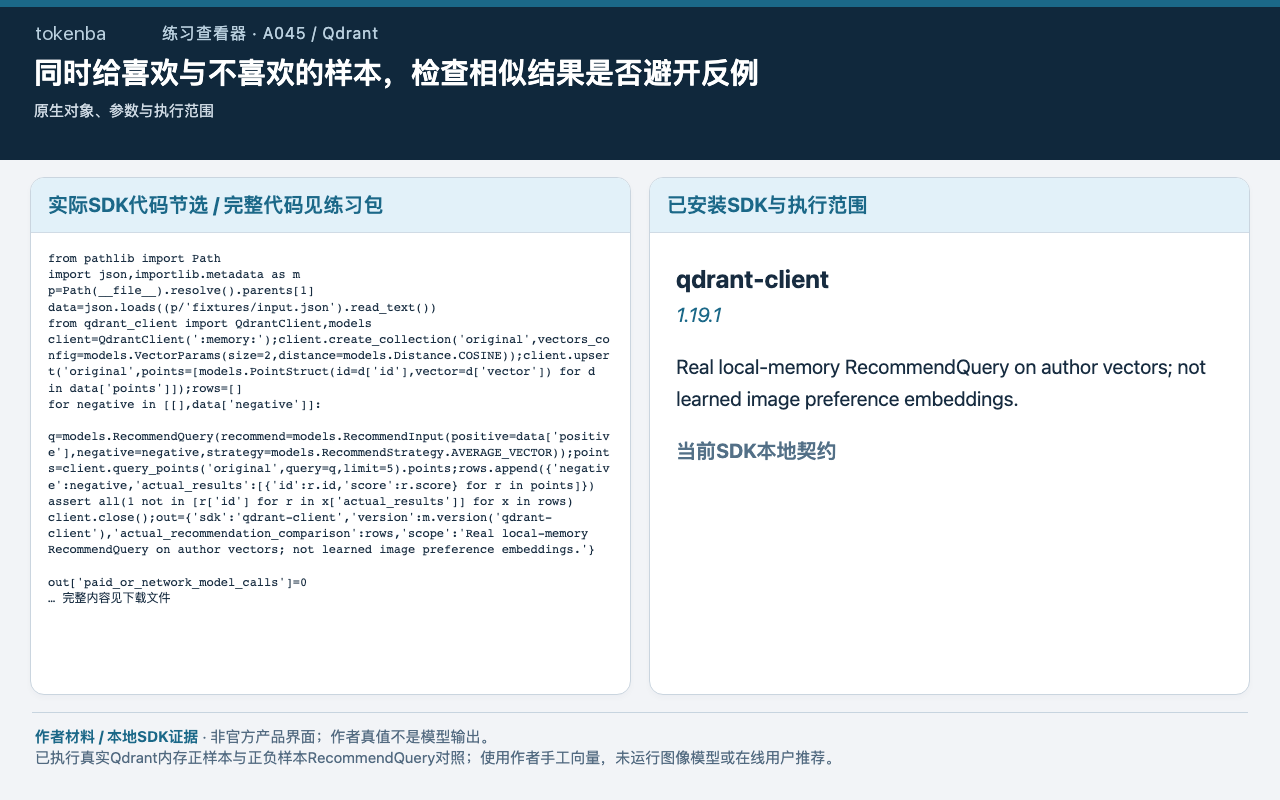
4. 先只给positive检索
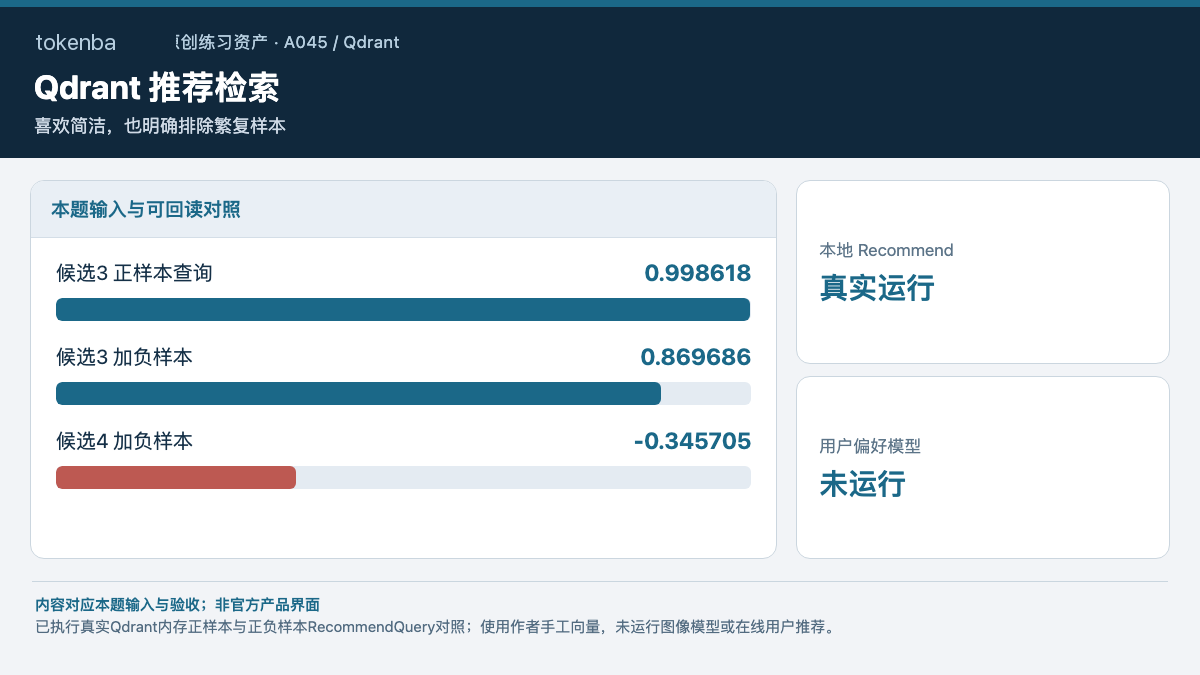
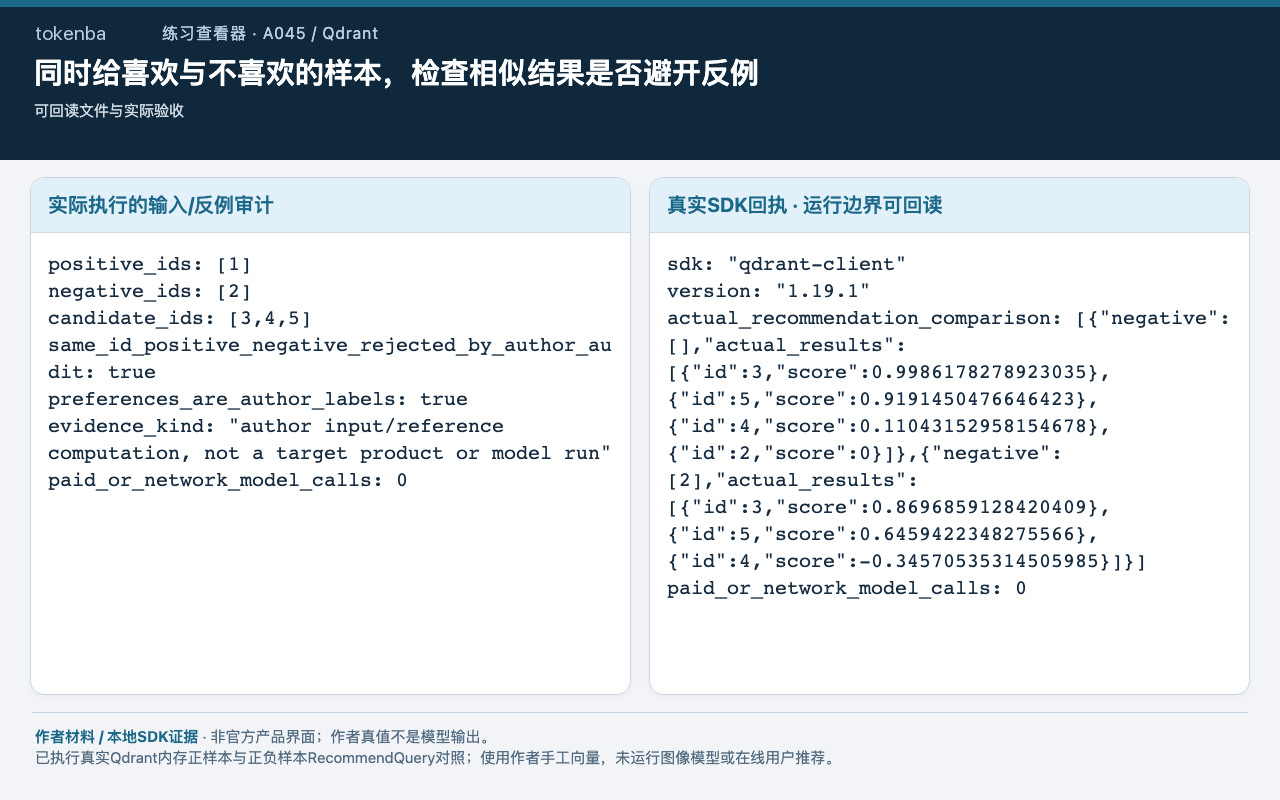
保存RecommendQuery仅正样本的实际排名及分数;推荐API与普通向量query不是同一输入结构。
5. 加入negative对照
使用同样candidate和filter加negative=2,保留真实顺序变化。不要预设所有策略都会将文档4移到最后。
6. 核对推荐策略的适用范围
average_vector与best_score等策略行为不同;记录当前SDK选择,给反馈样本自身设置合适过滤避免混入推荐展示。
7. 交付用户反馈与排序变化
保存实际本地SDK请求和回执,人工标签只解释任务目标,不证明图像理解。本包不运行真实图像编码或在线推荐系统。
怎样确认已经完成
- 明确average_vector或best_score策略
- 负例不能凭标题判断
- 不保证所有反例自动排除
- 已执行真实Qdrant内存正样本与正负样本RecommendQuery对照;使用作者手工向量,未运行图像模型或在线用户推荐。
常见问题
Qdrant推荐检索怎么同时加入正例和反例?
在RecommendInput中分别给positive/negative样本并指定策略;同ID正负冲突先在作者检查拒绝。本包已跑真实本地正负推荐。
加了负样本后,怎么检查结果有没有避开不喜欢的特征?
比较相同候选下加负例前后排名与特征,并回读分数。手工向量能演示机制,但不是图像embedding或用户偏好模型效果。
这篇教程哪些步骤已经真正执行?
已执行真实Qdrant内存正样本与正负样本RecommendQuery对照;使用作者手工向量,未运行图像模型或在线用户推荐。