
展开本页目录
开始前准备什么
- 下载本页 ZIP,保留原始输入和来源;示例材料不是模型输出。
- 按官方说明准备匹配软件/模型、设备或账号权限,权重与账号额度不包含在下载包。
- 本地检查需 Python 3 与 FFmpeg/ffprobe;真实结果需要实际生成并回听/看图。
- 给一个形象建立独立任务目录
- 核对实时配置与模型版本
- 首次准备 Avatar
- 新增配音再关闭重复准备
- 分别保存三条输出和时间
- 检查连续片段的形象与口型
1. 给一个形象建立独立任务目录
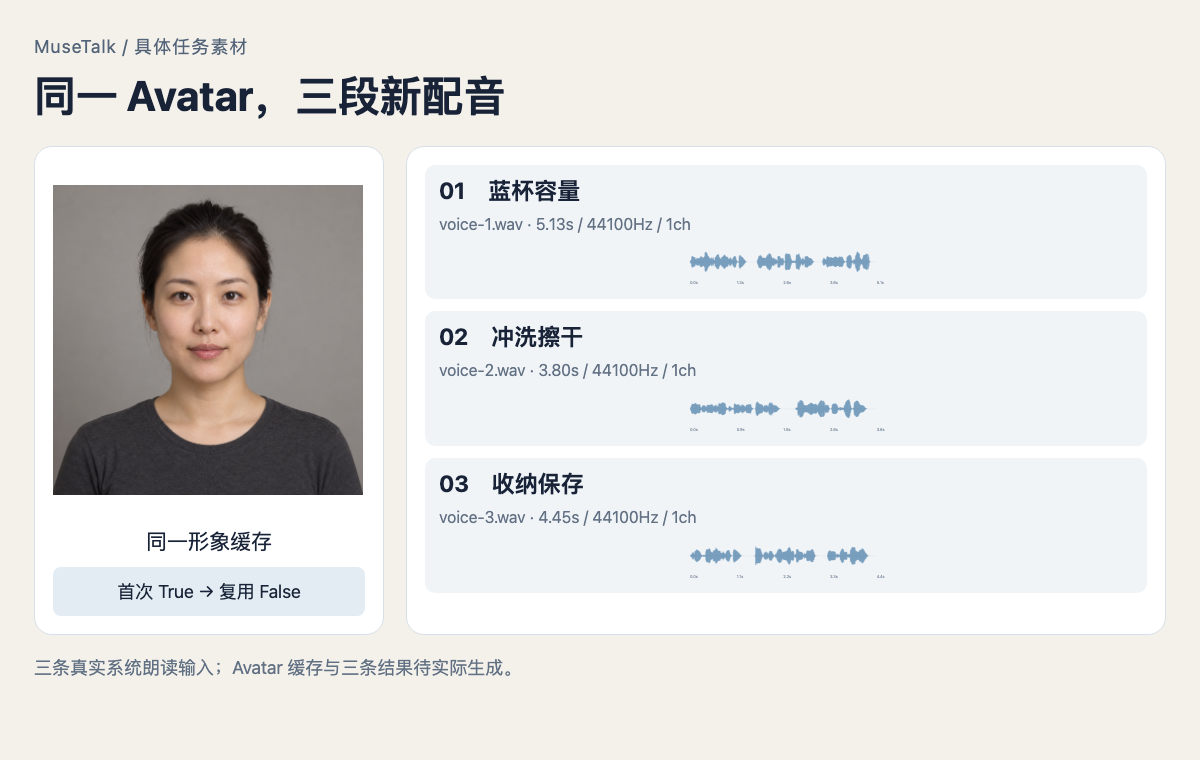
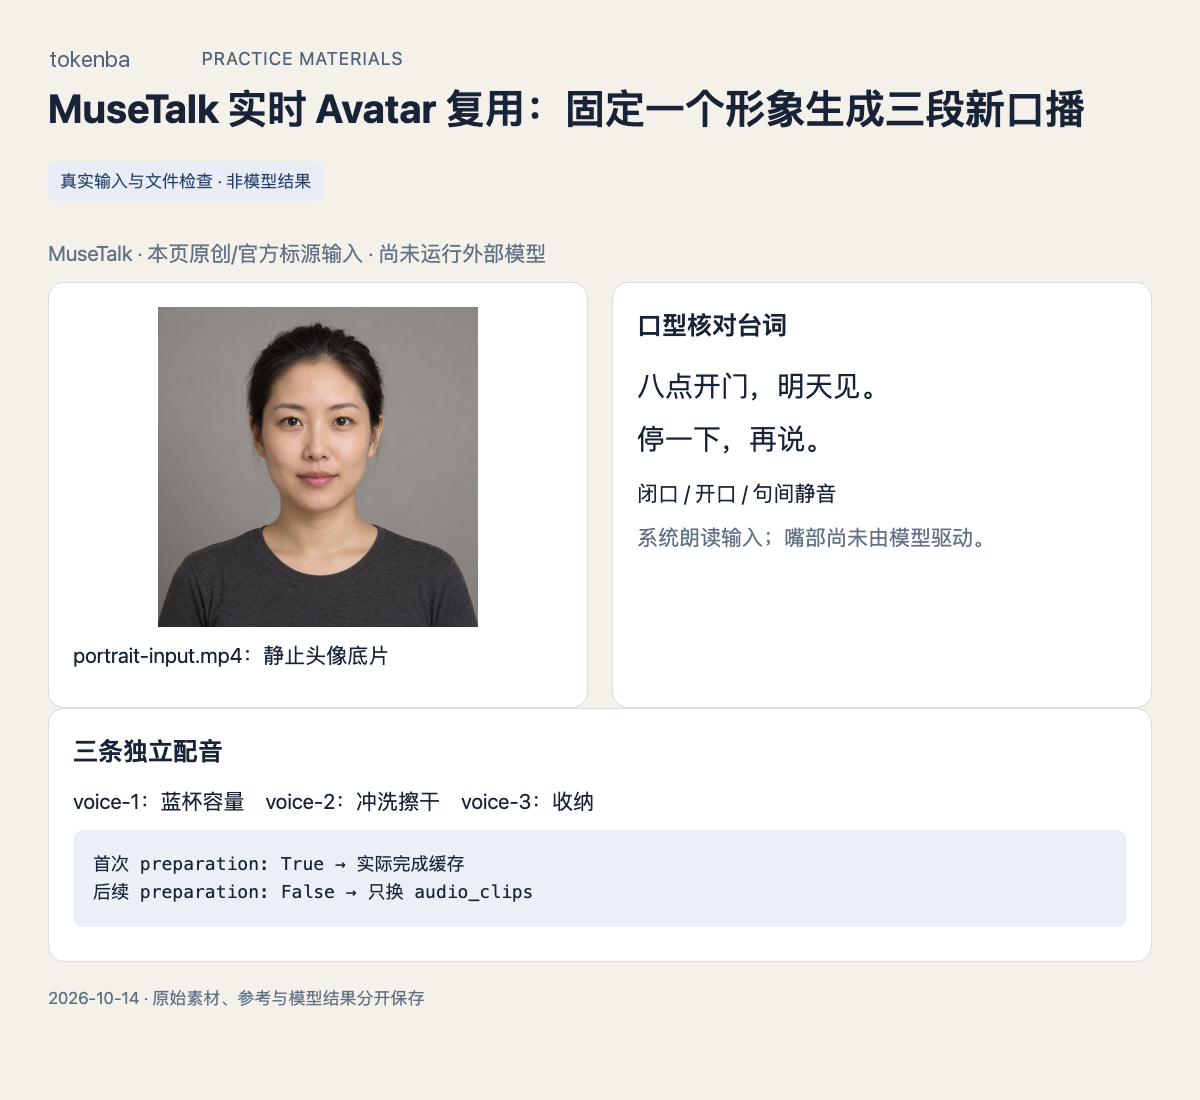
下载头像底片和 voice-1/2/3.wav。三段由系统朗读不同原创短句,每条有独立逐字稿;同一 avatar 的源片固定,不把不同人物素材写进同一缓存目录。
2. 核对实时配置与模型版本
官方 realtime.yaml 使用 preparation、video_path、audio_clips。复制本包 avatar-first.yaml,填绝对路径,保持 v15 模型及 25fps。实时路径需要先有合法缓存,不能一开始就将 preparation=False。
3. 首次准备 Avatar
第一次使用 preparation: True 运行 scripts.realtime_inference。将真实缓存目录、源片 hash、版本和完成时间记录进 avatar-record.json;不手工创建几个空文件伪装预处理完成。
4. 新增配音再关闭重复准备
首次真实成功后,保持 avatar ID 与源视频,改用 avatar-reuse.yaml 中的 preparation: False。只换 audio_clips;源脸或裁切变化就建立新 avatar 并重新准备,不能盲目复用旧缓存。
5. 分别保存三条输出和时间
运行后逐条关联音频 hash、结果路径与错误,记录真实预处理时间和后续生成时间;素材包 timing.csv 初始为空,不伪造节省百分比。一个任务失败不等于其余结果自动合格。
运行步骤
# 在 MuseTalk 仓库,首次配置 preparation: True
python -m scripts.realtime_inference --inference_config /绝对路径/avatar-first.yaml --result_dir ./results/apizt --unet_model_path ./models/musetalkV15/unet.pth --unet_config ./models/musetalkV15/musetalk.json --version v15 --fps 25
# 首次真实成功后,同命令改用 avatar-reuse.yaml
6. 检查连续片段的形象与口型
在三条片中选同一姿态帧与闭口音,比较脸部位置、肤色和接缝,再检查有没有残留上一条音频。缓存复用不代表支持无人值守直播,本页只验证三次独立口播。
7. 实读输入与坏文件,再检查你自己的输出
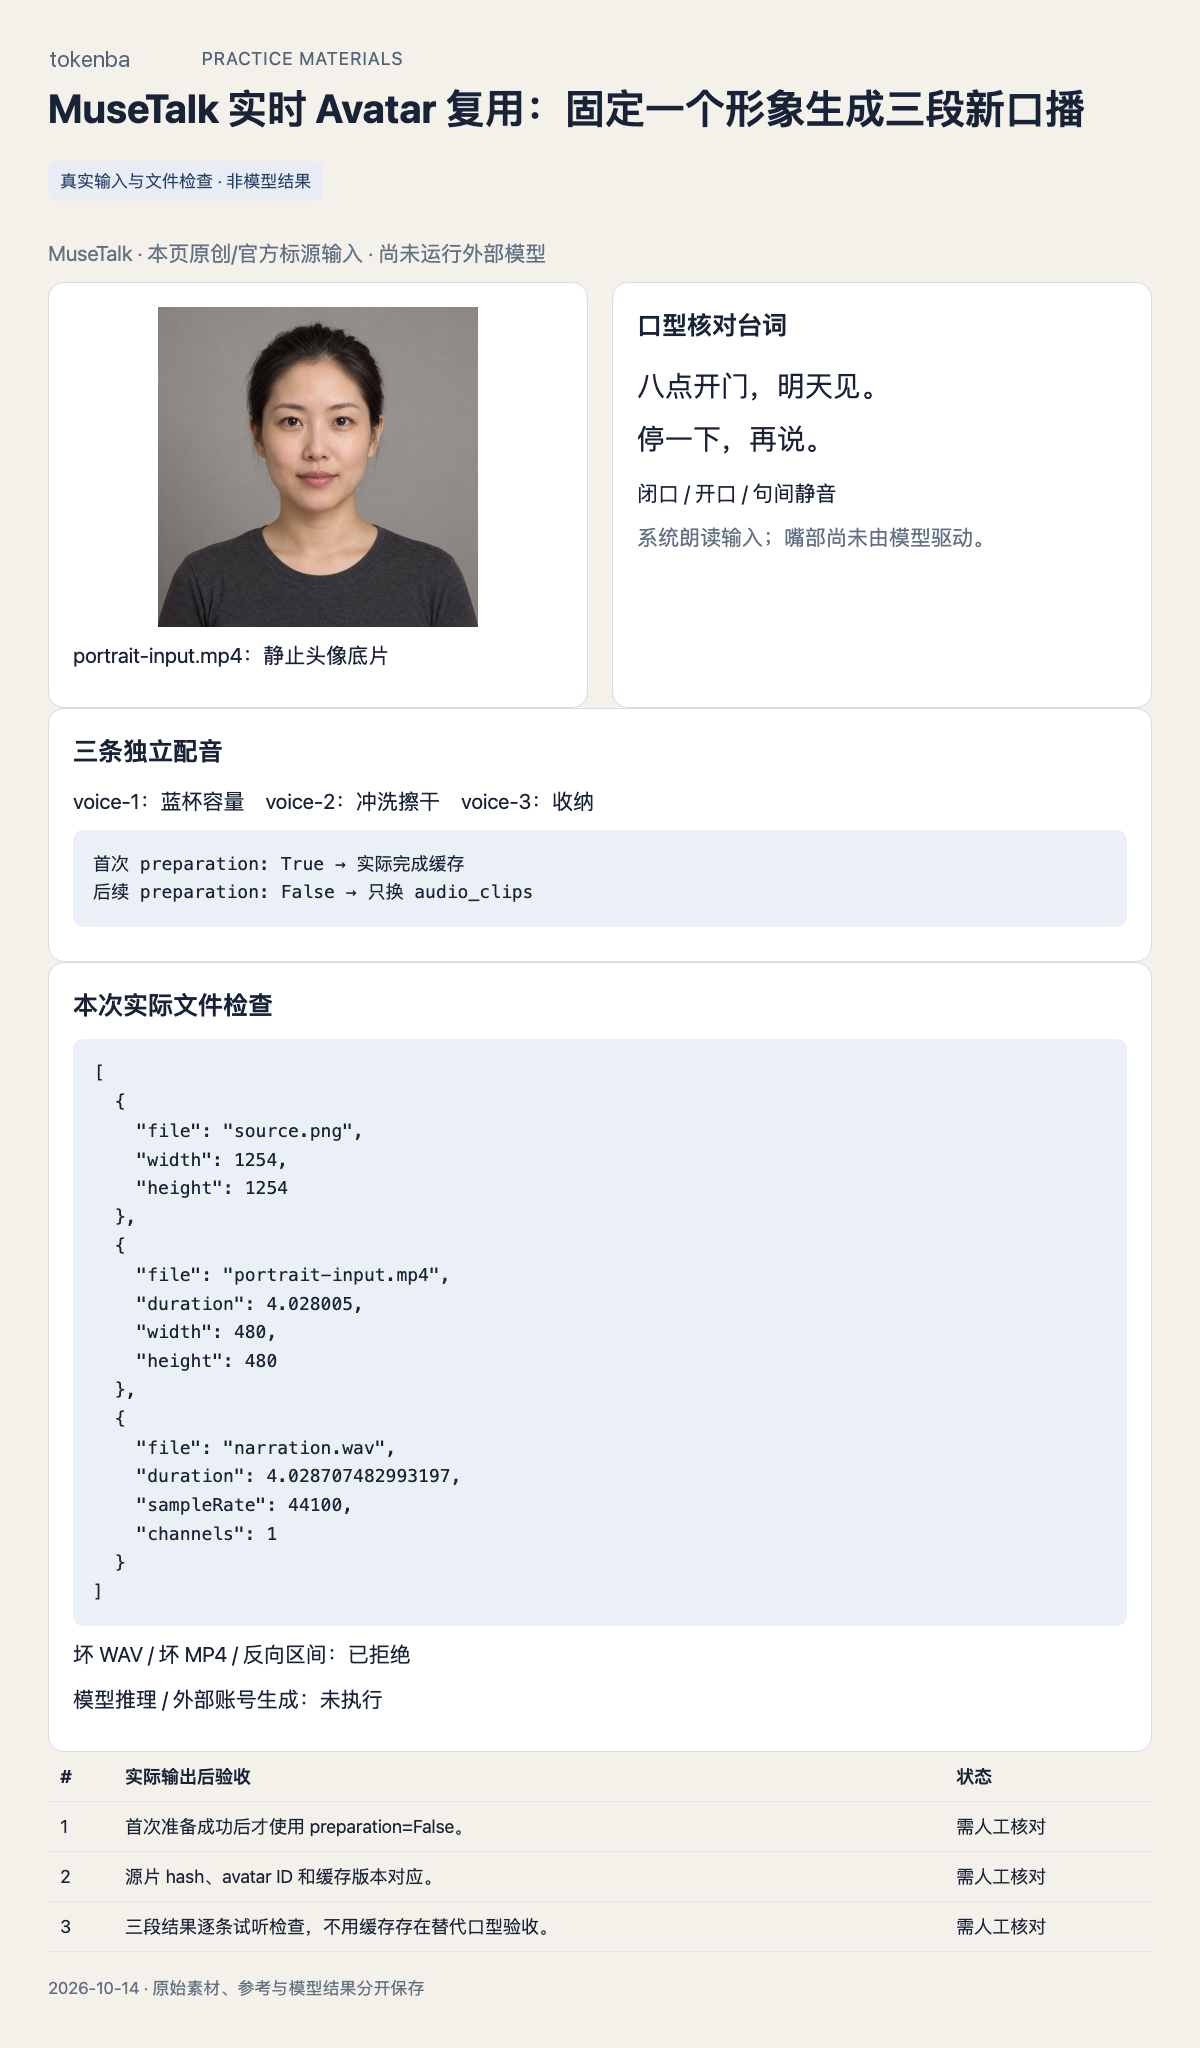
在解压目录运行 python check.py --self-test。脚本读取本页 provenance.json 的输入 hash,检查真实音视频/PNG 和目标区间;坏 WAV、坏 MP4 与反向时间范围应被拒绝。它不会下载模型、请求账号或自动判定口型、音乐质量。输入检查结果见 input-check.json。实际运行后用 --result 指向新文件,并逐项回听/看图。
check.py
python check.py --self-test
python check.py --result 你实际导出的文件.mp48. 交付原始输入、真实输出和待确认项
保留 README、原始输入、parameters.json、provenance.json 和你实际生成的文件;将模型/软件/账号版本、设备和错误写入独立运行记录。review.csv 的 pending 由真实回听/看图后更新,未运行项目不改成 done。配图中的原始参考与官方示例不代表本站已生成同样成果。
怎样确认已经完成
- 首次准备成功后才使用 preparation=False。
- 源片 hash、avatar ID 和缓存版本对应。
- 三段结果逐条试听检查,不用缓存存在替代口型验收。
常见问题
改了源人物还能复用同一 Avatar 吗?
不应直接复用。源片、裁切或人物改变时建立新 ID,并重新执行准备,避免旧人脸缓存污染结果。
素材包是否带有已经生成的 Avatar 缓存?
没有。本次未运行 MuseTalk,提供真实底片、三条配音、两阶段配置与记录模板;缓存必须由实际环境生成。