
展开本页目录
开始前准备什么
- 下载本页 ZIP,保留原始输入和来源;示例材料不是模型输出。
- 按官方说明准备匹配软件/模型、设备或账号权限,权重与账号额度不包含在下载包。
- 本地检查需 Python 3 与 FFmpeg/ffprobe;真实结果需要实际生成并回听/看图。
- 选一段有头部动作的源片
- 准备 Humans 模式和 FFmpeg
- 找到 Retargeting Video 输入
- 把目标 lip-open ratio 设为零做小样
- 执行 Retargeting Video 并保存输出
- 把同一帧的唇线与头部姿态并排
1. 选一段有头部动作的源片
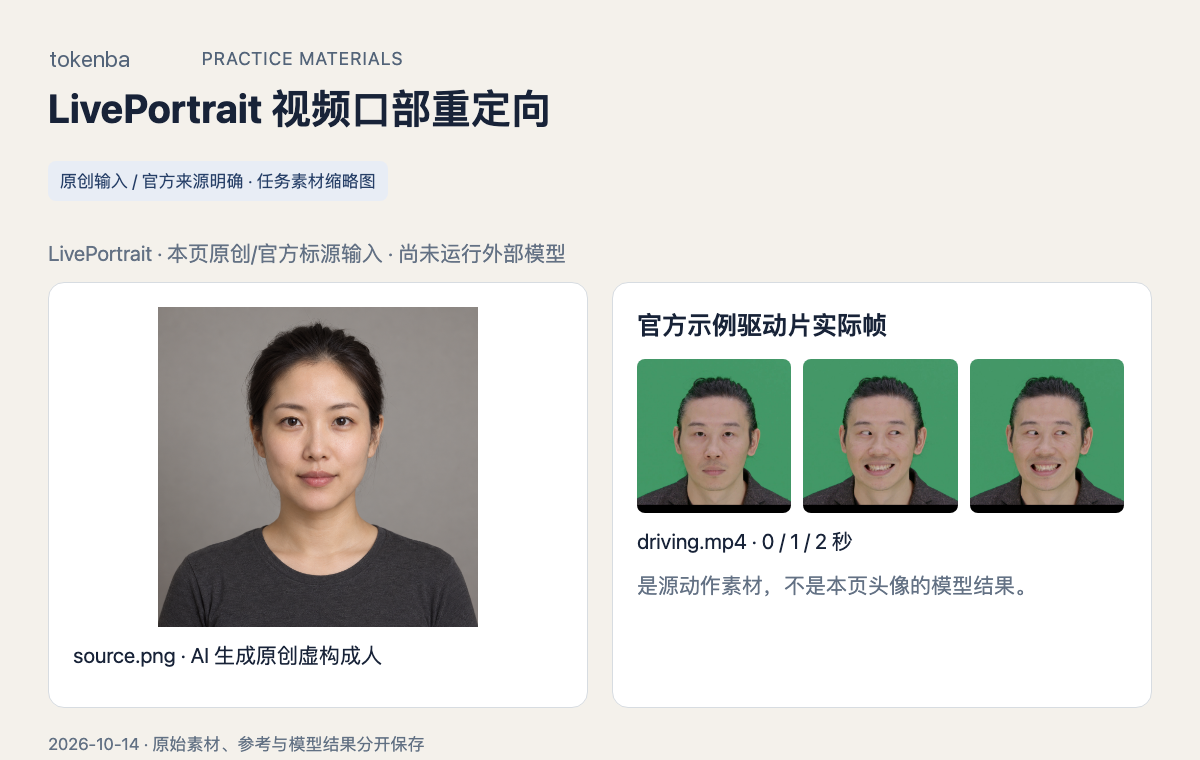
素材包 driving.mp4 是官方源视频,portrait-input.mp4 是静止头像练习片;本题用前者观察动作是否保留,自己的工作换成已授权头肩片。下载后保留原音与原片,不覆盖输入。
2. 准备 Humans 模式和 FFmpeg
按官方仓库配置环境与权重,记录 commit 和设备。先运行 check.py 检查源片帧率、长度和视频流;脚本通过只表示素材可解码,不表示模型可用。
3. 找到 Retargeting Video 输入
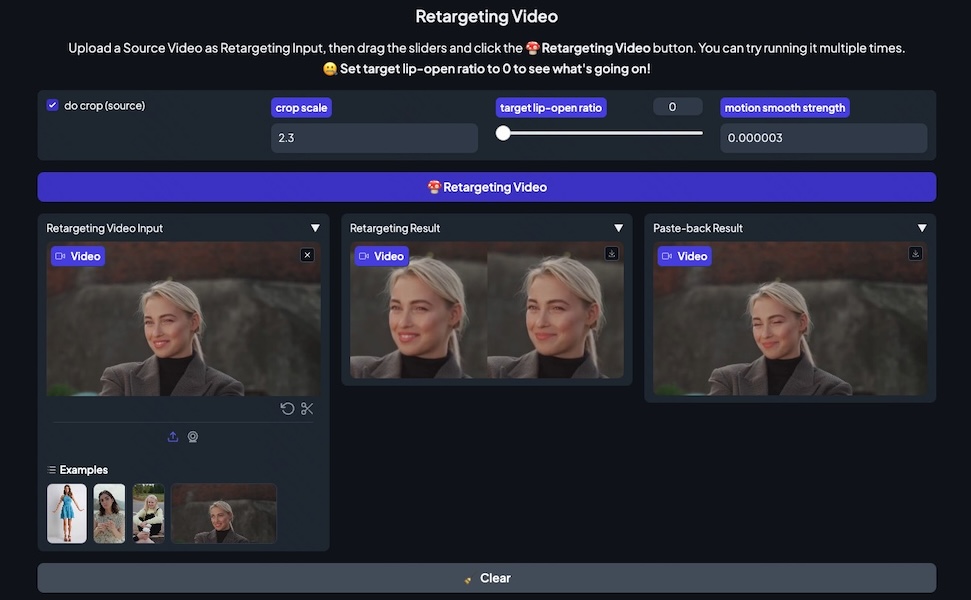
将视频放到 Retargeting Video Input,而不是把静态图片放进视频框。官方视频重定向图展示原版入口;该面板并不提供与静态表情区完全相同的一组眼睛滑块。
4. 把目标 lip-open ratio 设为零做小样
按官方说明先用 target lip-open ratio=0 观察闭口效果,再检查当前版本 silence 选项的含义。保留 source crop 和 smoothing 的默认基线;头部大幅遮挡时不要承诺每帧都能重定向成功。
5. 执行 Retargeting Video 并保存输出
点击 Retargeting Video,将实际 Paste-back 结果另存 idle.mp4。先观看有声版确认画面,再按用途移除音轨;“闭口待机”是视觉目标,不能只把音频静音就声称嘴巴已闭合。
运行步骤
# 原生环境准备完成后在 LivePortrait 仓库启动界面
python app.py
# 在素材包检查你的实际输出
python check.py --result idle.mp4
6. 把同一帧的唇线与头部姿态并排
选最大张口和最大转头处,看唇线是否闭合、下巴是否抖动、发际线与身体是否漂移。图中输入帧和标出的检查区不是本地重定向结果。本次未运行 GPU/模型,须以你实际输出验收。
7. 实读输入与坏文件,再检查你自己的输出
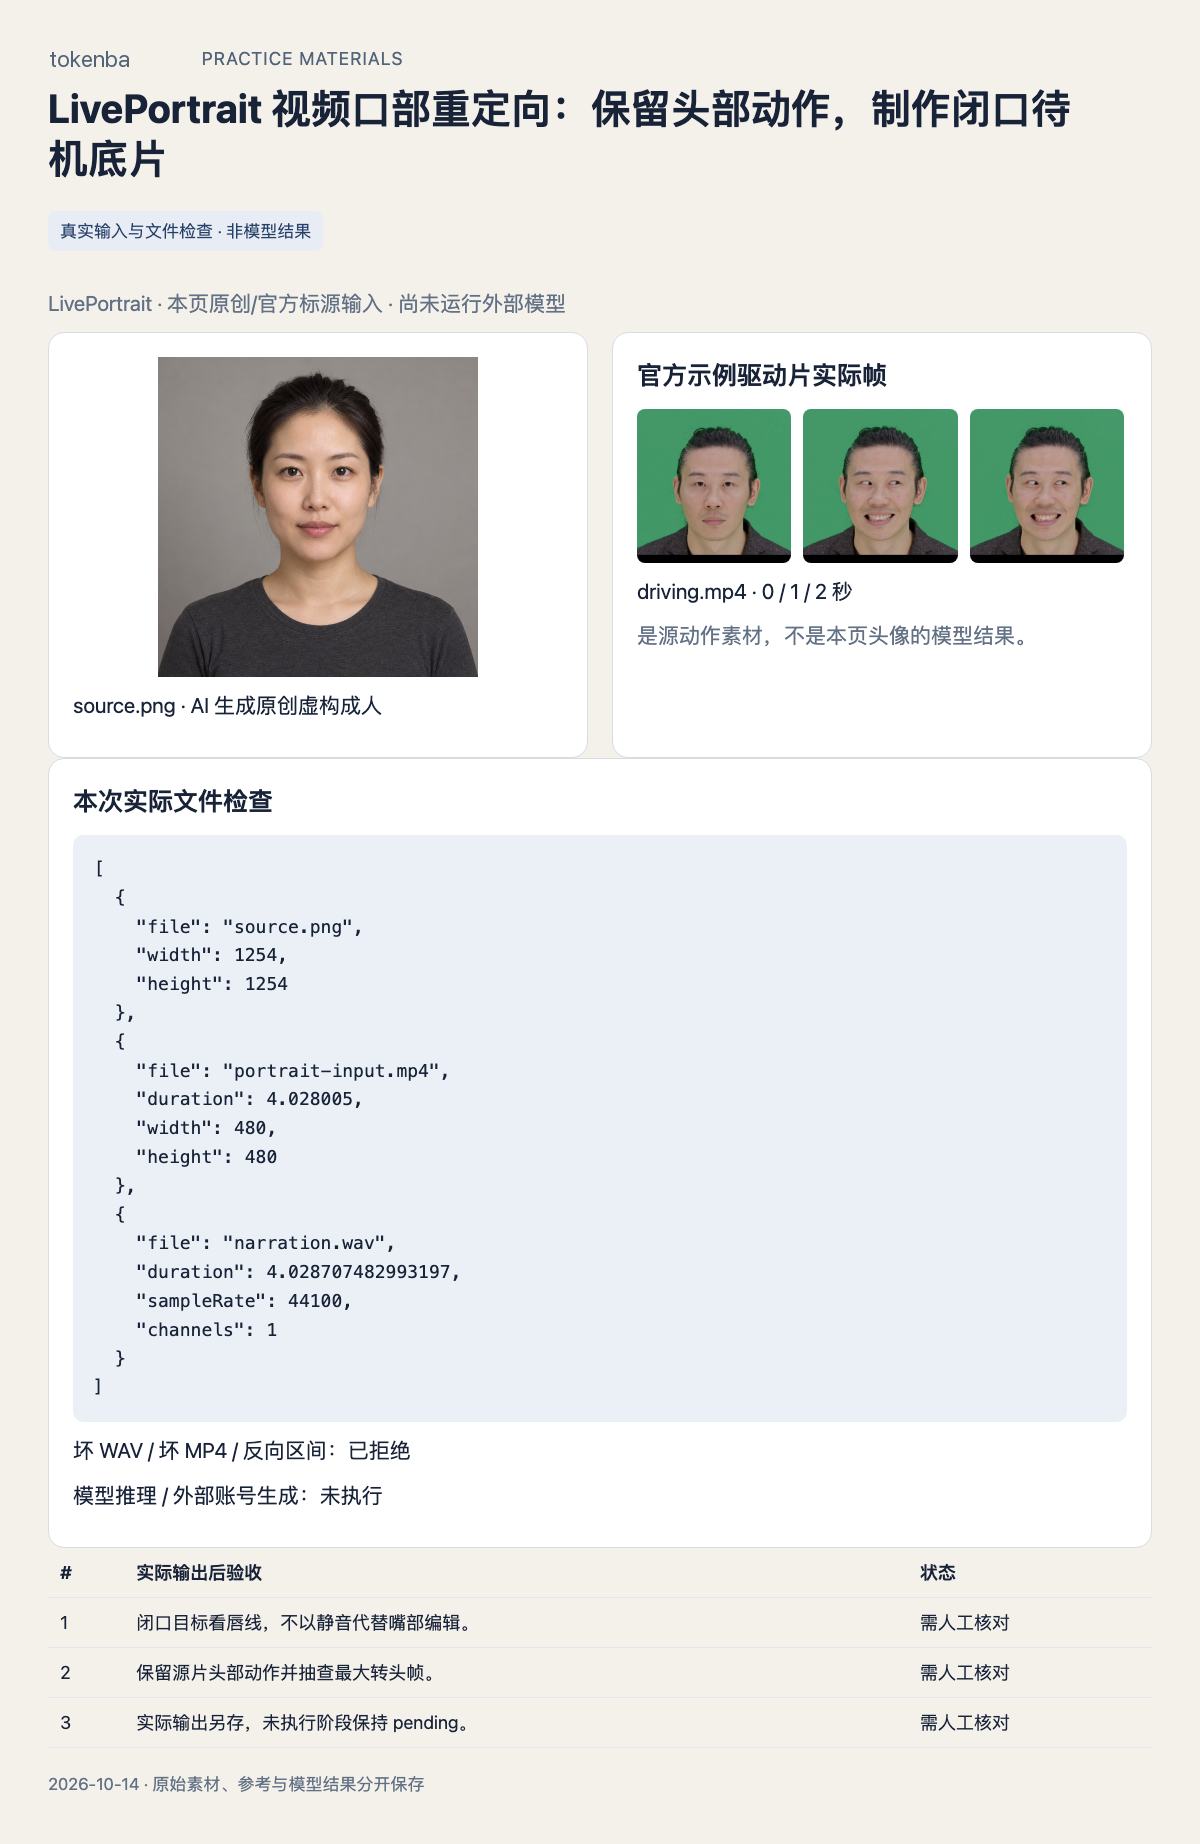
在解压目录运行 python check.py --self-test。脚本读取本页 provenance.json 的输入 hash,检查真实音视频/PNG 和目标区间;坏 WAV、坏 MP4 与反向时间范围应被拒绝。它不会下载模型、请求账号或自动判定口型、音乐质量。输入检查结果见 input-check.json。实际运行后用 --result 指向新文件,并逐项回听/看图。
check.py
python check.py --self-test
python check.py --result 你实际导出的文件.mp48. 交付原始输入、真实输出和待确认项
保留 README、原始输入、parameters.json、provenance.json 和你实际生成的文件;将模型/软件/账号版本、设备和错误写入独立运行记录。review.csv 的 pending 由真实回听/看图后更新,未运行项目不改成 done。配图中的原始参考与官方示例不代表本站已生成同样成果。
怎样确认已经完成
- 闭口目标看唇线,不以静音代替嘴部编辑。
- 保留源片头部动作并抽查最大转头帧。
- 实际输出另存,未执行阶段保持 pending。
常见问题
能直接修复视频所有闭眼帧吗?
本题只使用官方视频嘴部重定向入口,不虚构逐秒闭眼修复功能;静帧眼睛编辑在另一篇教程。
默认头像底片为什么没有真实表情?
它由静态 AI 头像与系统朗读合成,只供格式与口型输入练习。有动作的对照使用明确标源的官方驱动视频,模型结果需另行生成。