
展开本页目录
开始前准备什么
- Langflow1.12.6;评分是辅助反馈,人工规准与金标另保留。每行模型调用可能单独收费;先6条再扩量,不能声称模型评分客观或批次顺序完全代表输入ID。
- 只在独立练习目录与自己的测试账号操作;使用准确模型ID,真实密钥不写入教材。
- 阅读题目和三项人工规准
- 用Read File读取Table
- 连接Batch Run与语言模型
- 填写统一规准和结果字段
- 先运行六行并Inspect结果
- 对照人工评分和原句
- 导出复核表并保存原始结果
原创输入、任务提示、字段教材、源码参考、人工基准和实际本地输出;无需模型即可核对。
包含七步原生操作、版本、来源和目标平台待执行项。
本站手写参考或人工基准的实际渲染,不是目标平台或模型输出。
1. 阅读题目和三项人工规准
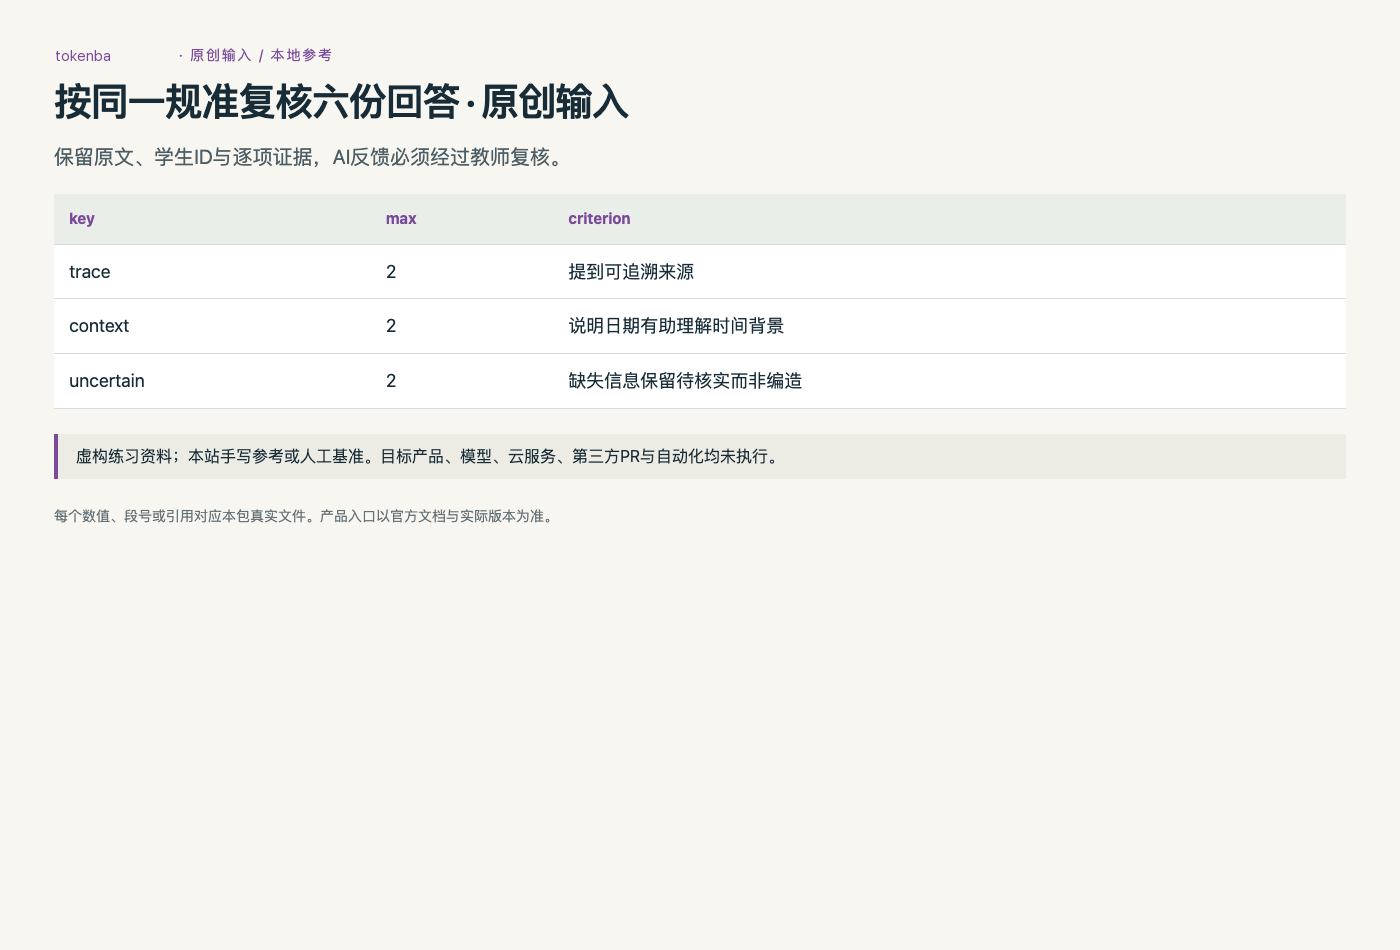
rubric.json有trace/context/uncertain三项,各0–2分;answers.csv含6份虚构回答,ST05空白。人工基准不作为伪造的模型答复,教师有权修正规准与得分。
2. 用Read File读取Table
Langflow1.12.6中Read File上传answers.csv,选择Structured Content/Table输出,Inspect确认id和answer两列都在。不要先清理掉空回答。
3. 连接Batch Run与语言模型
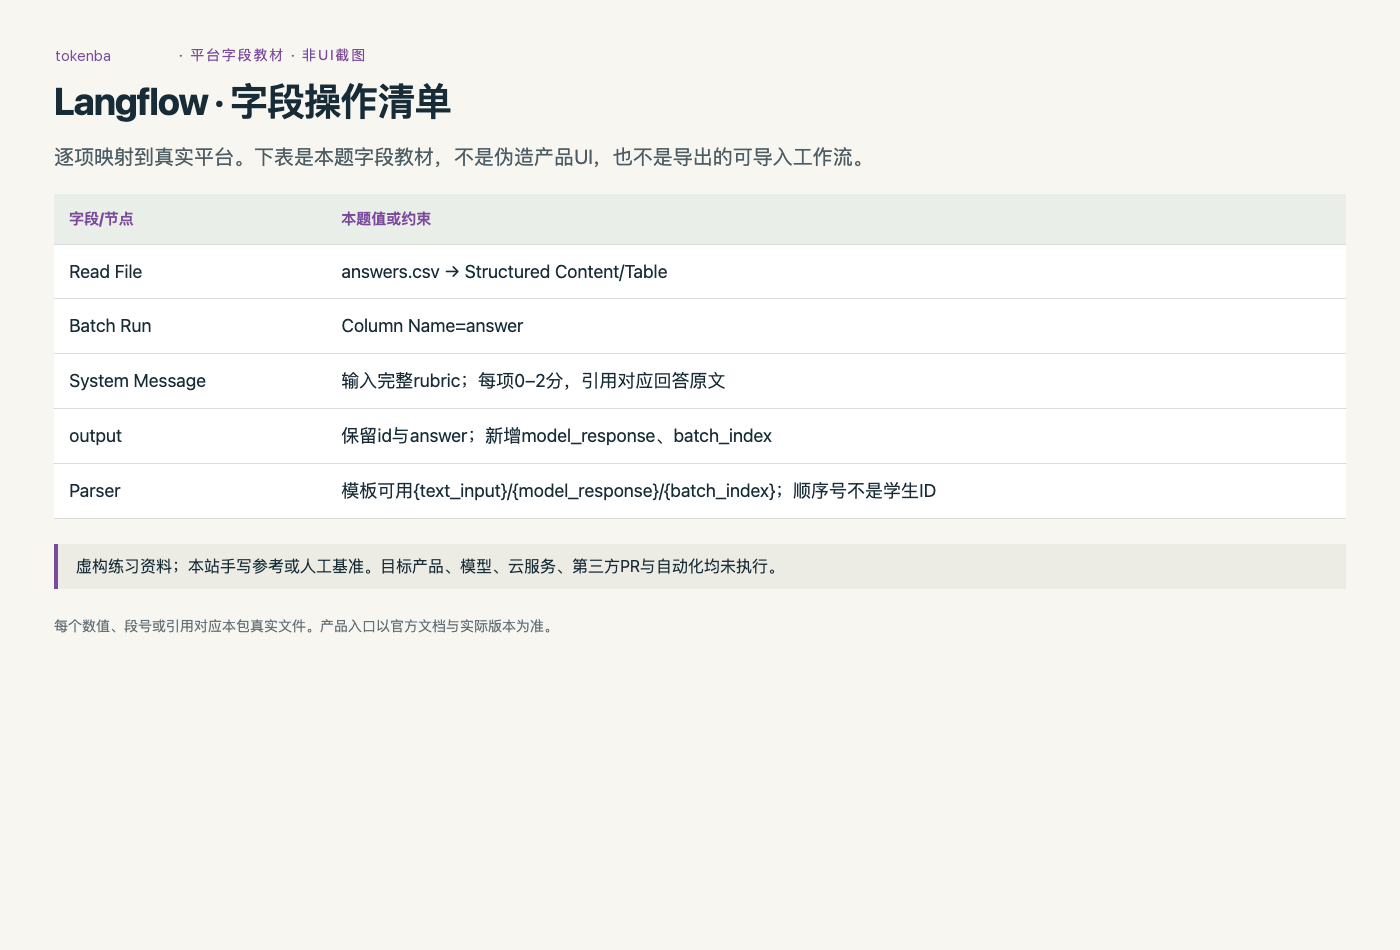
语言模型的LanguageModel端口接Batch Run,Table接DataFrame;Column Name明确填answer。若留空,所有列可能转TOML,不符合本题单一正文输入约束。
4. 填写统一规准和结果字段
启用System Message并粘贴prompt.md,要求三项分数、原文依据和改进建议。输出后把原始id并回结果,batch_index从0开始,不是ST01的学号。
5. 先运行六行并Inspect结果
观察每行model_response是否对应当前回答,空回答也有记录。失败行记录状态,不用其他学生的答案补齐;扩量前核对模型/组件版本及每行费用。
6. 对照人工评分和原句
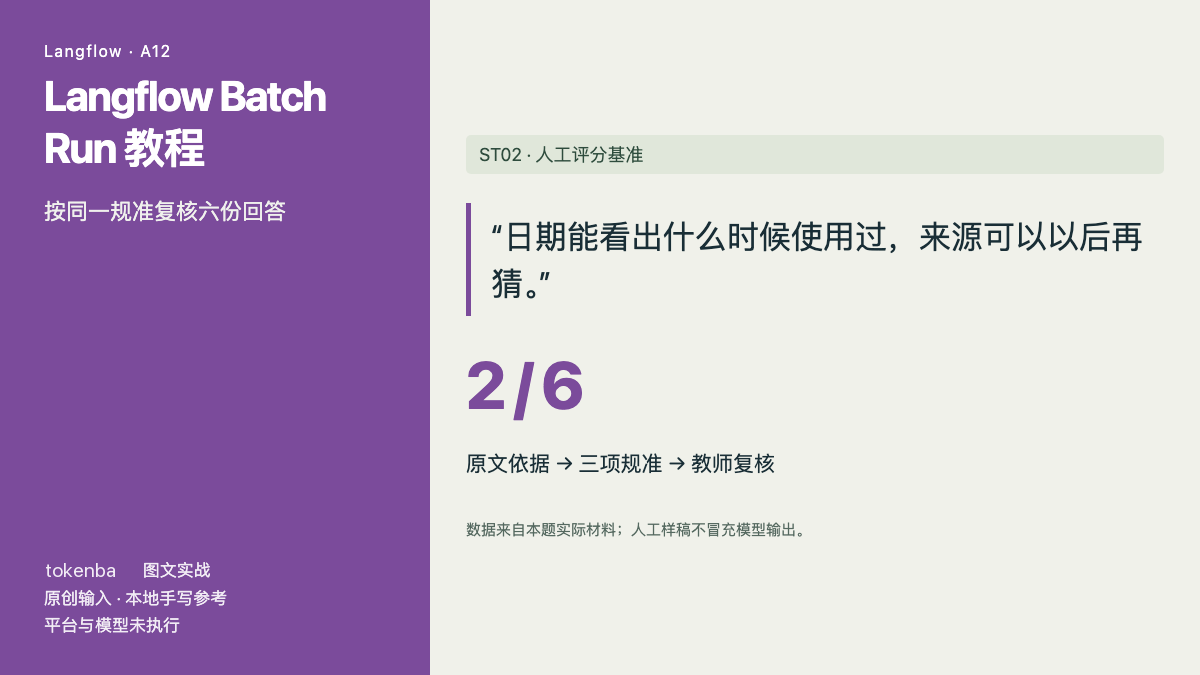
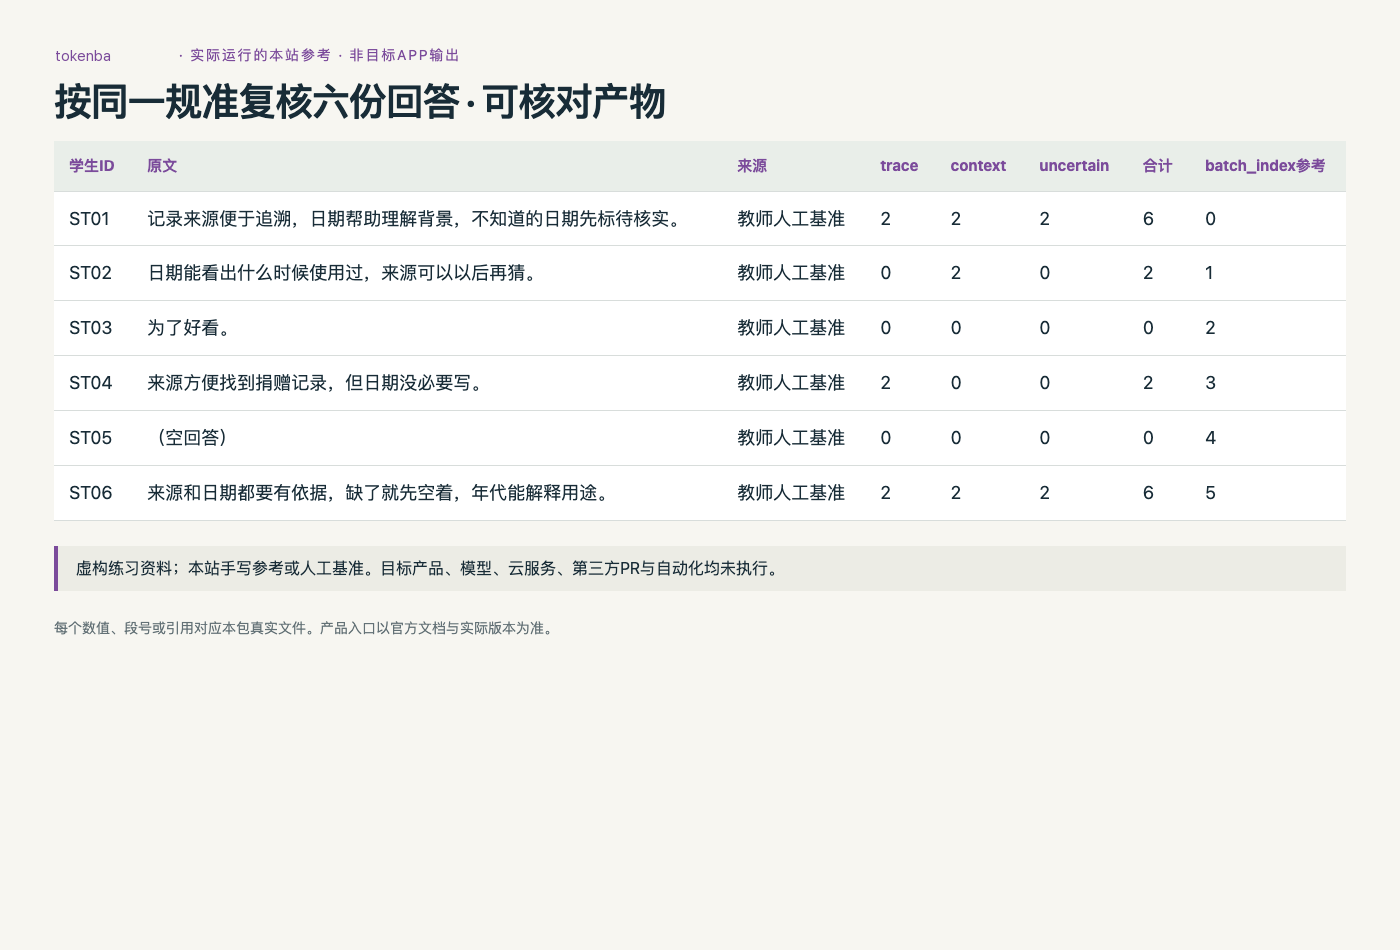
reference.html实际渲染六条人工评分及原文,ST02“以后再猜”是待纠正内容。把自己的AI结果放入review-template.json,逐项人审,保留至少一项分歧,不能把模型分数叫客观成绩。
7. 导出复核表并保存原始结果
保留原文、模型原分、人审分、理由和ID。非敏感练习可用于流程学习,真实学生资料先按所在机构规则处理;本题不是高风险考试自动终审系统。
怎样确认已经完成
- 按本题原始输入核对ID、未知值和边界,实际平台结果另存原生文件。
- 保留本地参考与目标平台的来源差异,失败项不覆盖成成功。
- 核对实际工具/模型版本和完整调用费用,再用于自己的业务。
常见问题
六份作业按同一标准让AI先批一遍?
保留原文、学生ID与逐项证据,AI反馈必须经过教师复核。 按上面七步在自己的工具执行;本页下载包提供可核对的输入和参考。
AI批改能不能指出原文哪句扣分?
reference.html实际渲染六条人工评分及原文,ST02“以后再猜”是待纠正内容。把自己的AI结果放入review-template.json,逐项人审,保留至少一项分歧,不能把模型分数叫客观成绩。
Langflow Batch Run 教程 的练习包能直接导入吗?
node-fields.json是逐字段操作教材,不能冒充平台原生工作流导出。按实际版本在工具里配置并保存自己的原生文件;Recipe YAML和单文件HTML等明确命名的材料见README。