
展开本页目录
开始前准备什么
- 下载本页素材,使用有权处理的声音,保留原始输入。
- 为对应工具建立独立 Python 环境,核对实际模型与版本。
- 先在小样中试听并保留失败记录,再处理长录音。
- 读取长录音实际时长
- 按固定边界切片并记录 offset
- 逐块识别与即时落盘
- 合并时加回绝对时间
- 回听每个切片边界前后
- 保存覆盖报告与机器稿
本任务输入、脚本、原始输出或明确待运行模板、原文、校验与损坏负例;不含模型权重。
macOS say 合成的本站原创任务输入;不是模型生成成功证明。
朗读输入与回听依据,独立于机器实际稿。
包含具体命令、步骤、来源与未运行范围。
保留原始文件;准确性需回听,脚本存在不代表模型已运行。
1. 读取长录音实际时长
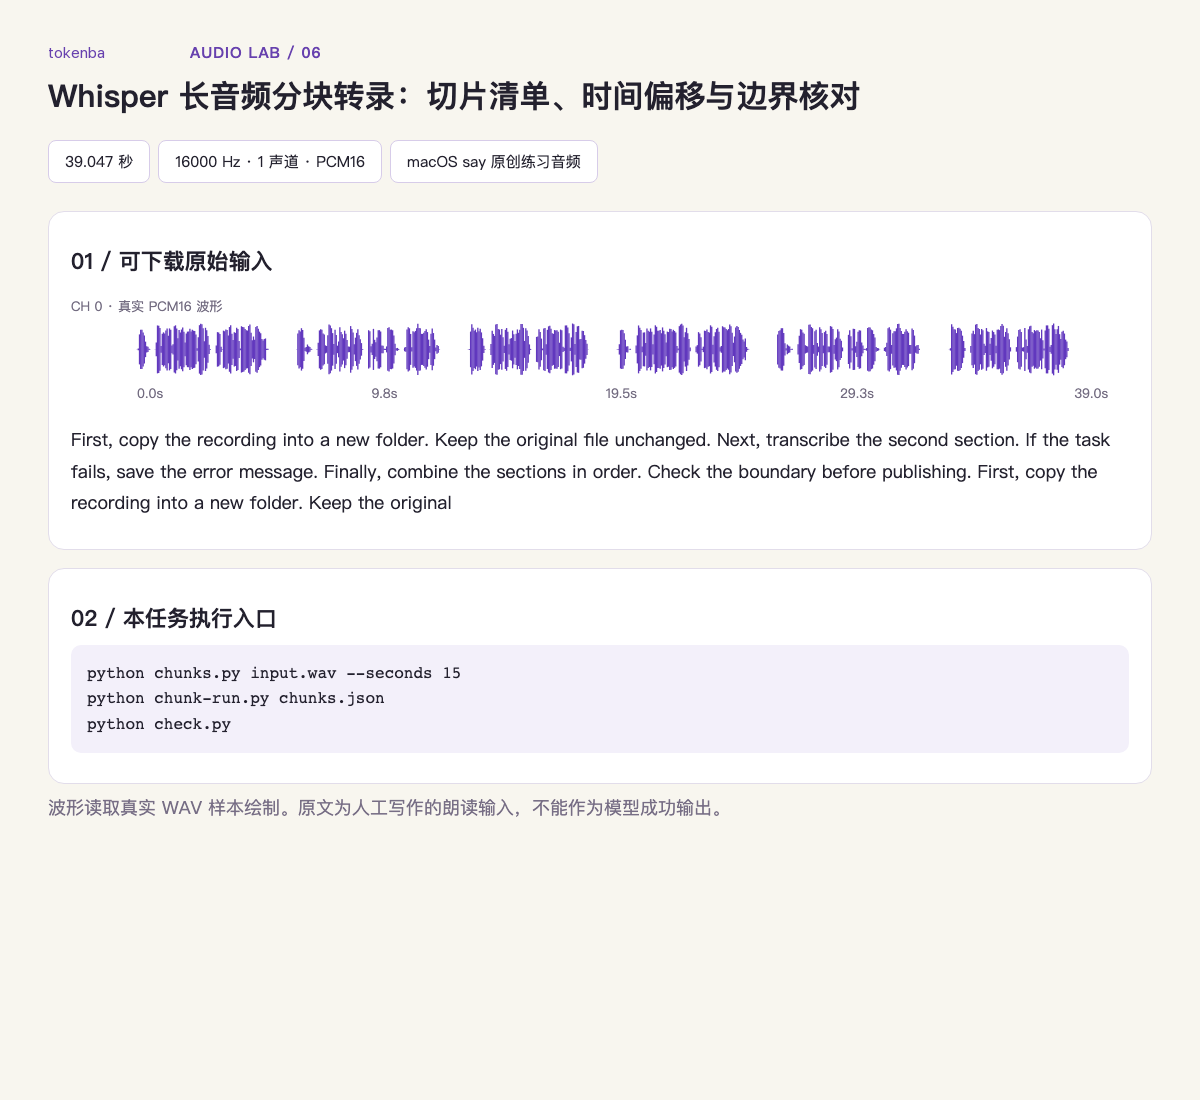
素材约数十秒,用六段原创短句模拟分块流程,不能把它说成数小时会议已实测。下载 chunks.json,逐行查看 start/end 与原音覆盖范围。
2. 按固定边界切片并记录 offset
运行 chunks.py,用 15 秒小块演示。每个切片保存源 hash、chunk_id、offset 和 frames;本例无重叠,实际讲话跨边界时可调整到停顿位置,不能只机械切割后宣称无漏字。
3. 逐块识别与即时落盘
每块独立输出 JSON,读取生成器后才原子保存。执行 run.py 或 chunk-run.py,模型不需要每块重新下载;保留每块失败状态以便下一页续跑。
run-commands.sh
python chunks.py input.wav --seconds 15
python chunk-run.py chunks.json
python check.py
4. 用 chunk offset 恢复绝对时间
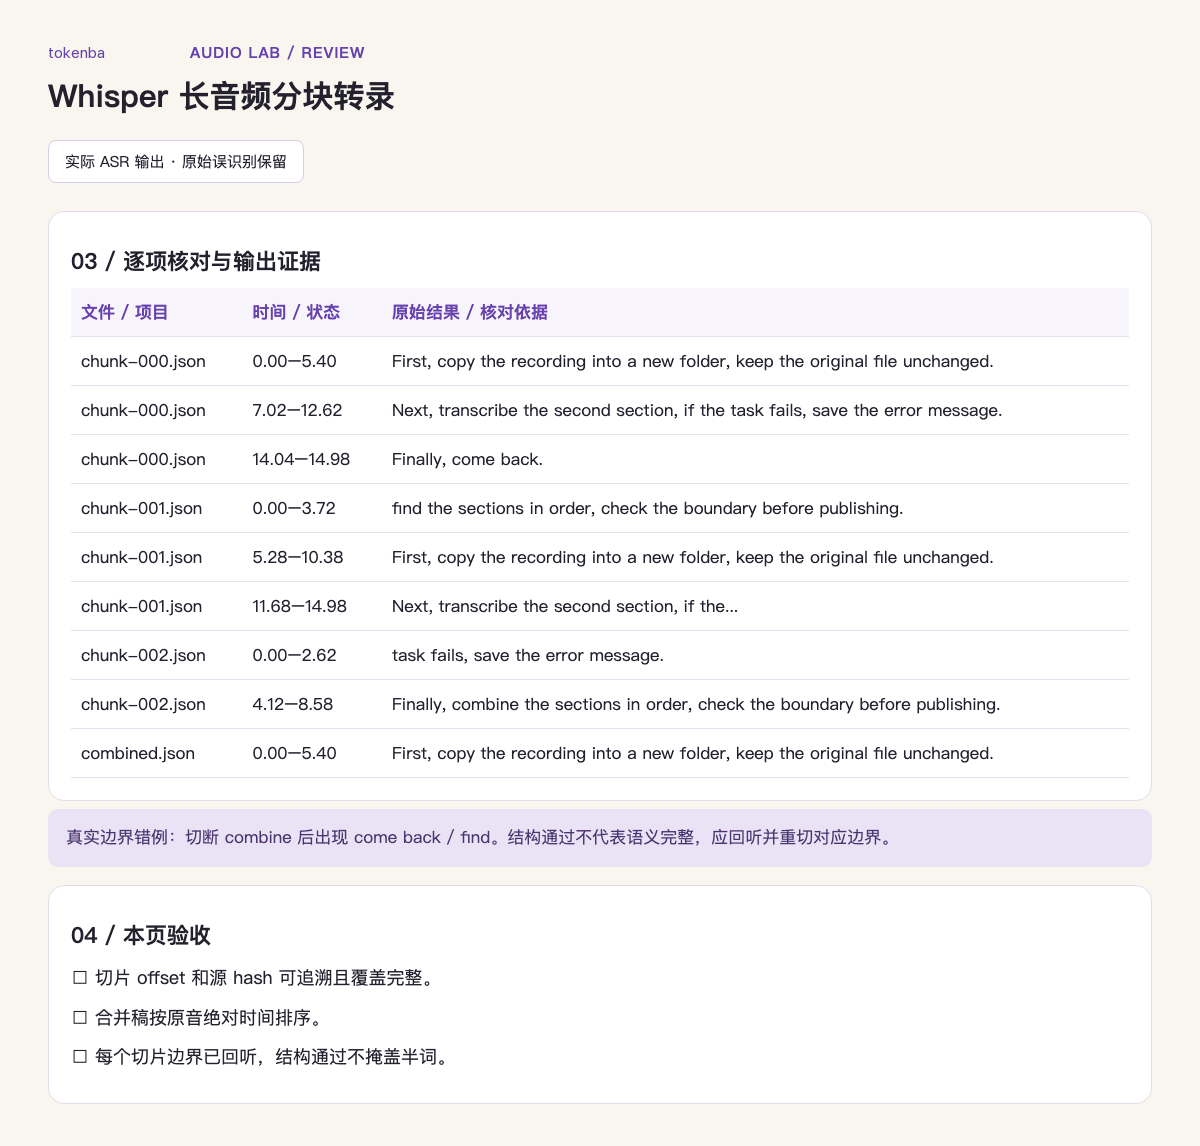
每条绝对 start/end = 该块相对 start/end + chunk.offset。沿原录音顺序合并到 combined.srt,保留 chunk_id,出错时能回到对应切片。
先检查切片清单是否覆盖原音,再回听每个边界前后一秒。区间无缝不代表句子无漏词;机械切到单词中间时,只重切或重识别对应区间。
5. 回听每个切片边界前后
对每个边界前后一秒回听,标记半个单词、重复和空白。没有 overlap 的本例可能切断词,校验结构通过仍不证明文本完整;出现问题只重切对应区间。
6. 保存覆盖报告与机器稿
check.py 验证切片连续覆盖、不越界,机器稿 JSON/SRT 时间一致。保留 chunk 文件和合并记录,放大到真实长音频前先测试内存与处理时长。
7. 下载材料、检查负例与继续操作
解压素材包后先运行 python check.py,再运行 python check.py --self-test。前者读取真实 WAV / JSON / SRT 与源 hash;后者拒绝损坏 WAV、倒置时间、越界时间和缺失词时间。文件通过不代表文字、情绪或说话人判定已通过。
怎样确认已经完成
- 切片 offset 和源 hash 可追溯且覆盖完整。
- 合并稿按原音绝对时间排序。
- 每个切片边界已回听,结构通过不掩盖半词。
常见问题
这份练习证明能处理几小时会议吗?
没有。素材是数十秒的实际分块练习,检验时间偏移和输出结构;真实长音频还需测资源、速度和边界准确性。
重叠分块能直接拼接文字吗?
不能。重叠会重复时间和文字,需要按已知重叠区间回听并去重;本页先用无重叠清单演示绝对时间恢复。