
展开本页目录
开始前准备什么
- 下载到独立练习目录,保留原始输入副本。
- 模型步骤使用自己的已验证配置;离线检查不需要 API Key。
- 先阅读 README 中的运行范围;练习数据均为原创。
- 对照双栏输入
- 按官方参数准备独立环境
- 导出结构与 Markdown
- 按完整段落核对顺序
- 回查 provenance 与漏段
- 读取文件检查而非只看截图
- 保存来源与错误样本
原创输入、可运行脚本、预期对照、截图原始 HTML 与验证记录。
对应本页任务与验证范围。
与原始 HTML 对应的带文字层 PDF。
章节、段落或表格验收条件。
关闭 OCR,但版面模型仍需环境准备。
读取输出文件检查顺序、空值与原文覆盖。
本次真实转换,保留原文项目与来源坐标。
与人工 expected.json 分开;可能有版面误判。
真实 HierarchicalChunker 输出,未人工改动。
CPU、无 OCR、Heron、Fast 设置及输入 SHA。
故意删除段落,检查必须非零。
原始失败与审核后检查分开记录。
1. 对照双栏输入
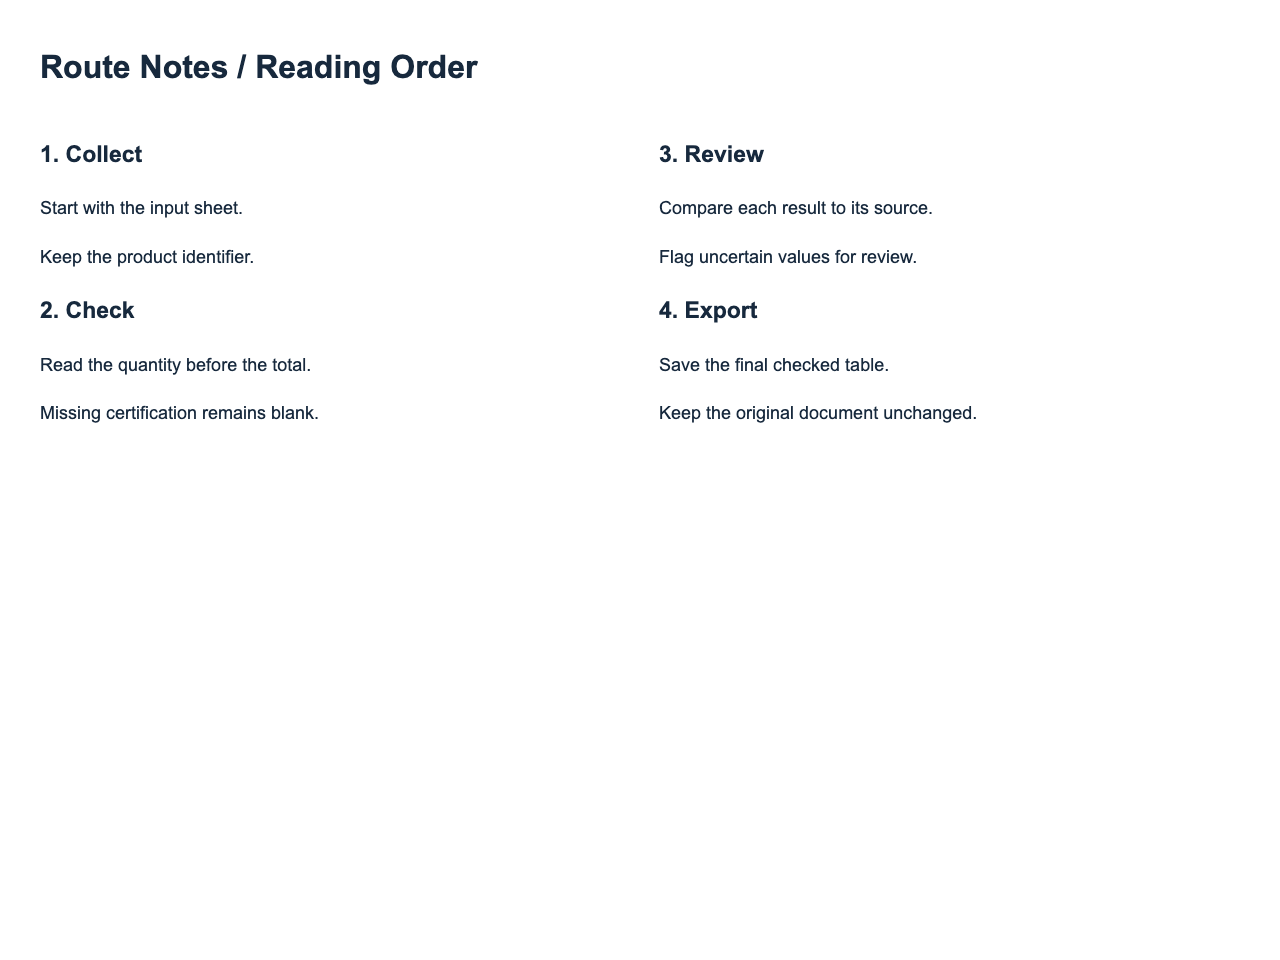
source.pdf 左侧是 Collect/Check,右侧是 Review/Export;expected.json 保存人工期望章节与段落顺序。
2. 按官方参数准备独立环境
本次实测使用 CPU、2 线程、Heron 版面与 Fast 表格模式,关闭 OCR;首次仍需模型文件。数字 PDF 的完整顺序检查通过;不推广为任意扫描件准确。
3. 导出结构与 Markdown
用 DocumentConverter 保存 result.md 和 document.json,保留原 PDF,不删除布局来源。
bash
# 与本页保存的 Fast 实测一致
python3 run-docling.py --fast
4. 按完整段落核对顺序
期望先左栏四段再右栏四段,比较完整句而不是只看出现了哪些关键词。
5. 回查 provenance 与漏段
对错误段落用 document.json 中来源坐标回查原 PDF;文本完整但顺序交替仍应判失败。
6. 读取文件检查而非只看截图
check-output.py 从 result.md 检查完整段落与章节顺序。删除首段的 negative-result.md 会使同一脚本失败。已真实运行 Docling 2.138.0 CPU、无 OCR:4 章节与 8 段正文顺序通过;反转段落负例被拒绝。仅本页数字 PDF,不代表扫描件。
text
python3 run-docling.py
python3 check-output.py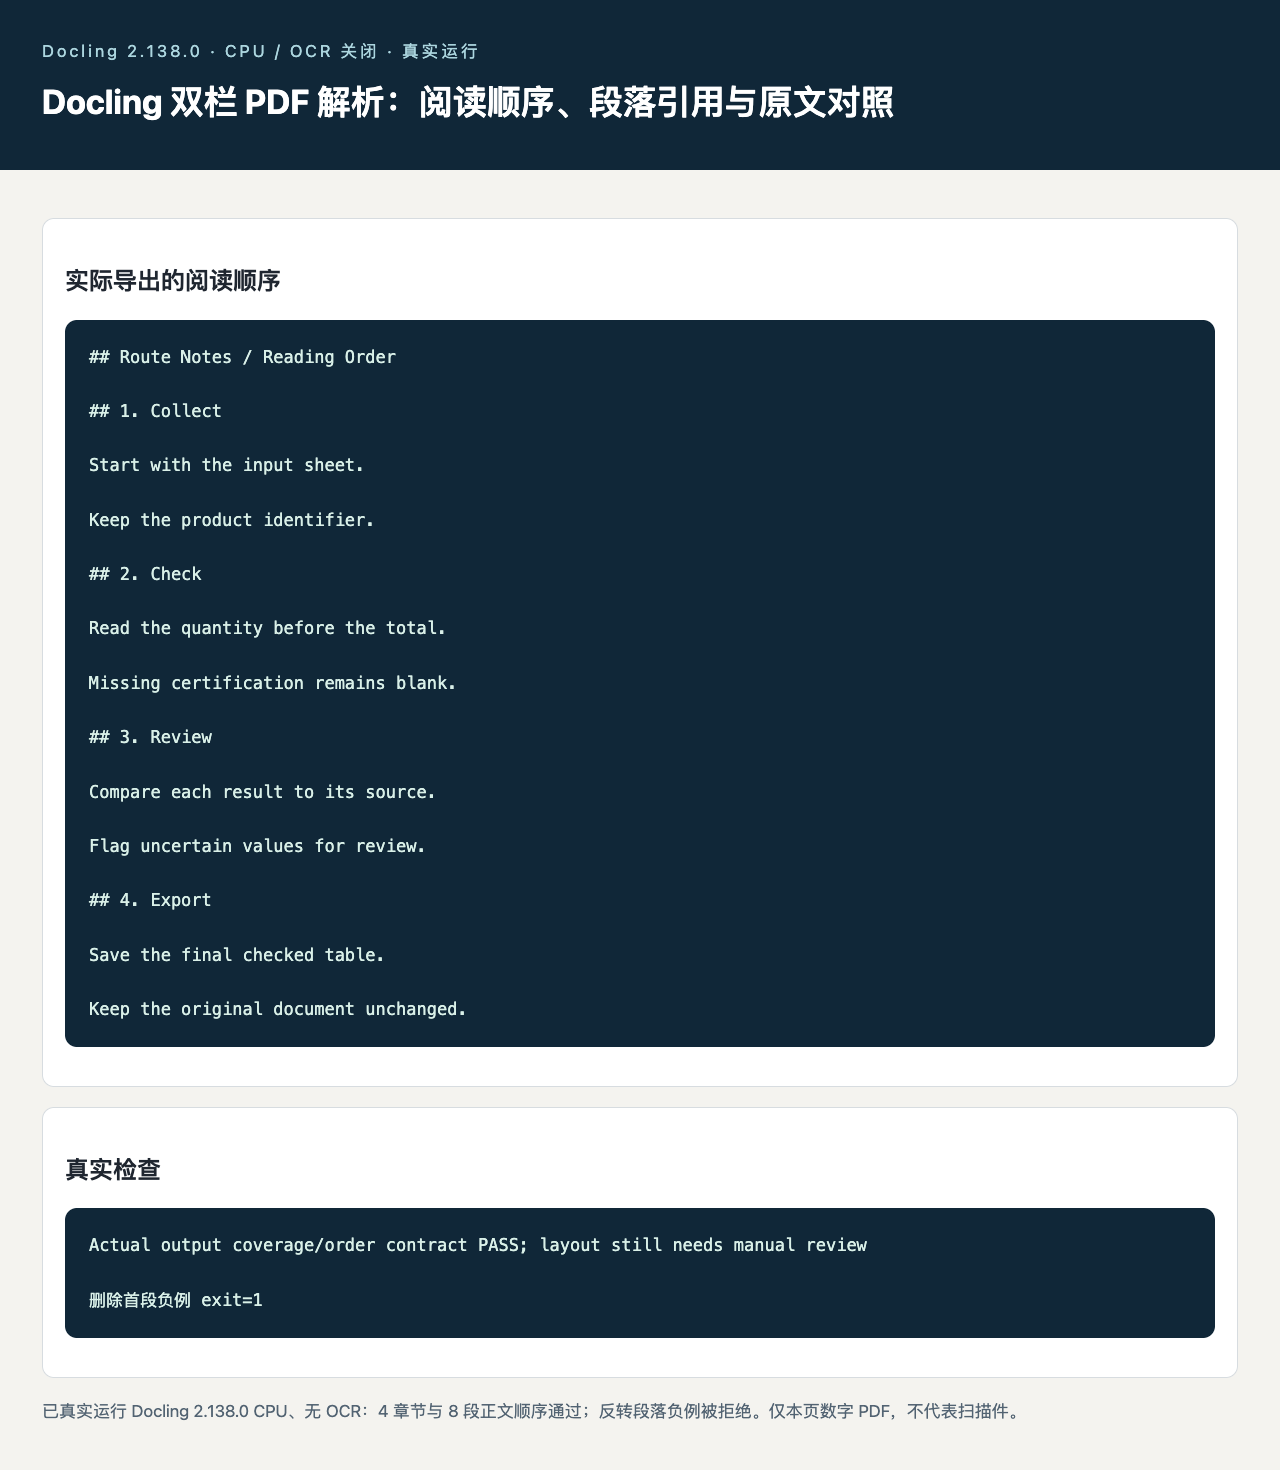
7. 保存来源与错误样本
保留 source.pdf/source.png、原始 JSON、软件版本和人工核对记录。自动结构检查只验证本教材约定,仍需检查布局与语义。
怎样确认已经完成
- 文字、数字与原输入逐项对应,人工预期和实际运行输出分开。
- 输出来源可以回查原图/PDF;漏行、错序、空格位移不能忽略。
- 已真实运行 Docling 2.138.0 CPU、无 OCR:4 章节与 8 段正文顺序通过;反转段落负例被拒绝。仅本页数字 PDF,不代表扫描件。
常见问题
可以把人工预期当识别结果下载吗?
不可以。expected.json 是核对基准;只有实际工具运行得到的 output/document.json 才是本次推理输出,必须分别保存。
结构检查通过代表所有内容正确吗?
不代表。脚本只验证约定的文字、顺序、字段与来源,真实文档中的版面、标点、表格合并格和其他语义仍要对照原文。