
展开本页目录
开始前准备什么
- 下载本页素材,使用有权处理的声音,保留原始输入。
- 为对应工具建立独立 Python 环境,核对实际模型与版本。
- 先在小样中试听并保留失败记录,再处理长录音。
- 固定同一台词与参考音频
- 核对 CosyVoice3 支持的指令
- 用 inference_instruct2 而非旧版 instruct
- 为两版输出建立独立编号
- 试听台词完整度再听情绪
- 只重做失败版本并留记录
本任务输入、脚本、原始输出或明确待运行模板、原文、校验与损坏负例;不含模型权重。
macOS say 合成的本站原创任务输入;不是模型生成成功证明。
朗读输入与回听依据,独立于机器实际稿。
包含具体命令、步骤、来源与未运行范围。
保留原始文件;准确性需回听,脚本存在不代表模型已运行。
1. 固定同一台词与参考音频
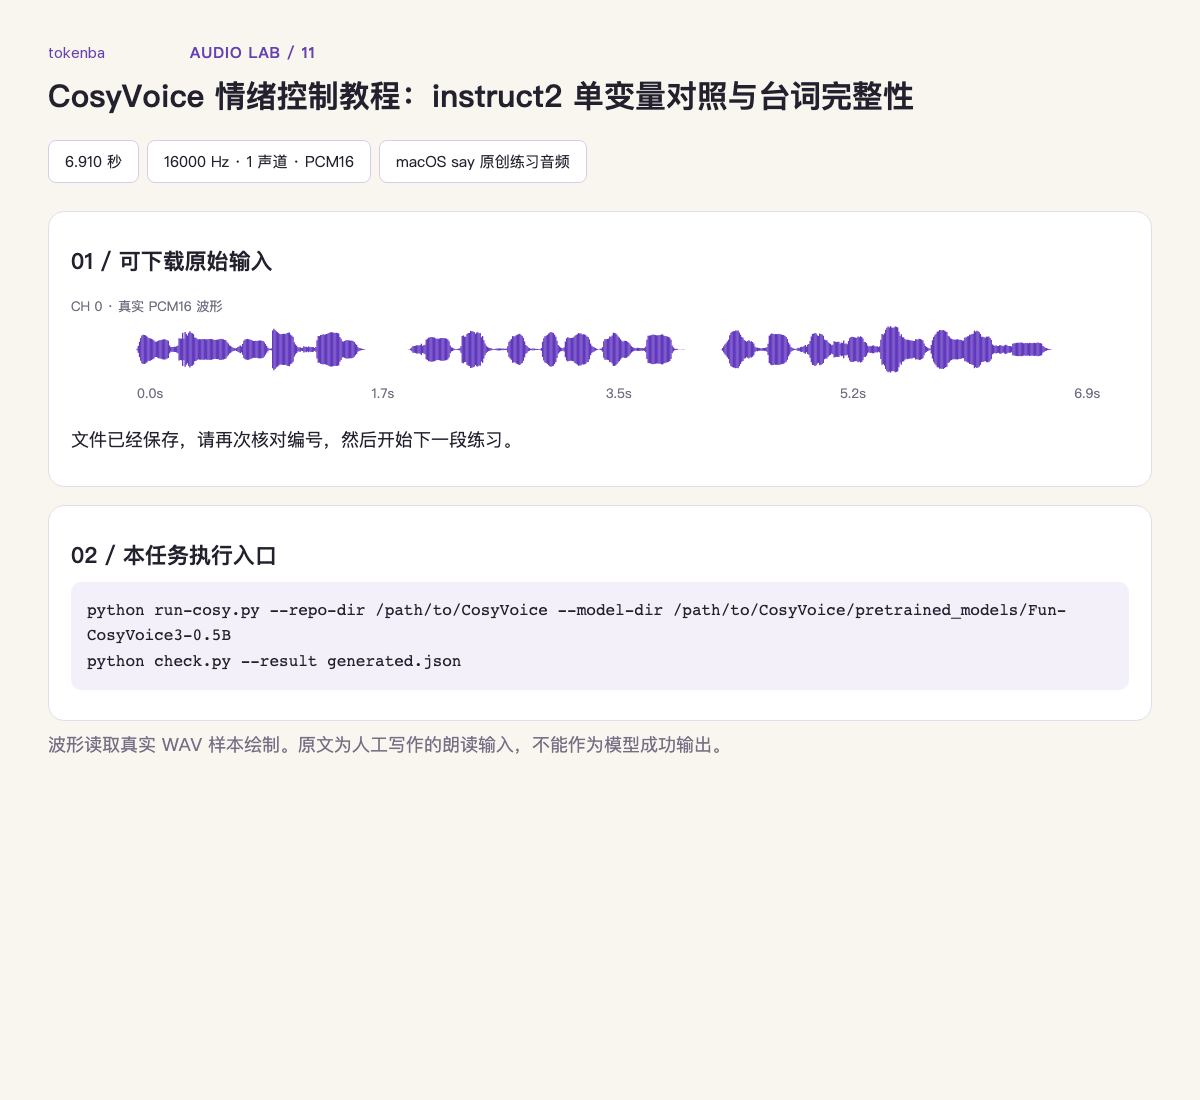
target.txt 固定一段原创台词,reference.wav 来自系统合成输入。两版只改变 instruct 文本,保持模型、台词和参考一致;输入示范不是情绪合成成片。
2. 核对 CosyVoice3 支持的指令
官方 common.py 列出开心、伤心、快慢语速等示例。素材用中性与开心两个任务,不堆叠多种情绪;指令能力存在不代表该练习效果已通过。 将 --repo-dir 设为已安装依赖的 CosyVoice 克隆目录;--model-dir 使用该目录中实际模型的绝对路径。运行脚本的数据文件仍从素材包所在目录读取。
3. 用 inference_instruct2 而非旧版 instruct
run-cosy.py 调用 AutoModel 后用 inference_instruct2(target,instruct,reference)。CosyVoice 1 的 inference_instruct 与 CosyVoice2/3 路径不同,不能直接只改模型名。
run-commands.sh
python run-cosy.py --repo-dir /path/to/CosyVoice --model-dir /path/to/CosyVoice/pretrained_models/Fun-CosyVoice3-0.5B
python check.py --result generated.json
4. 为两版输出建立独立编号
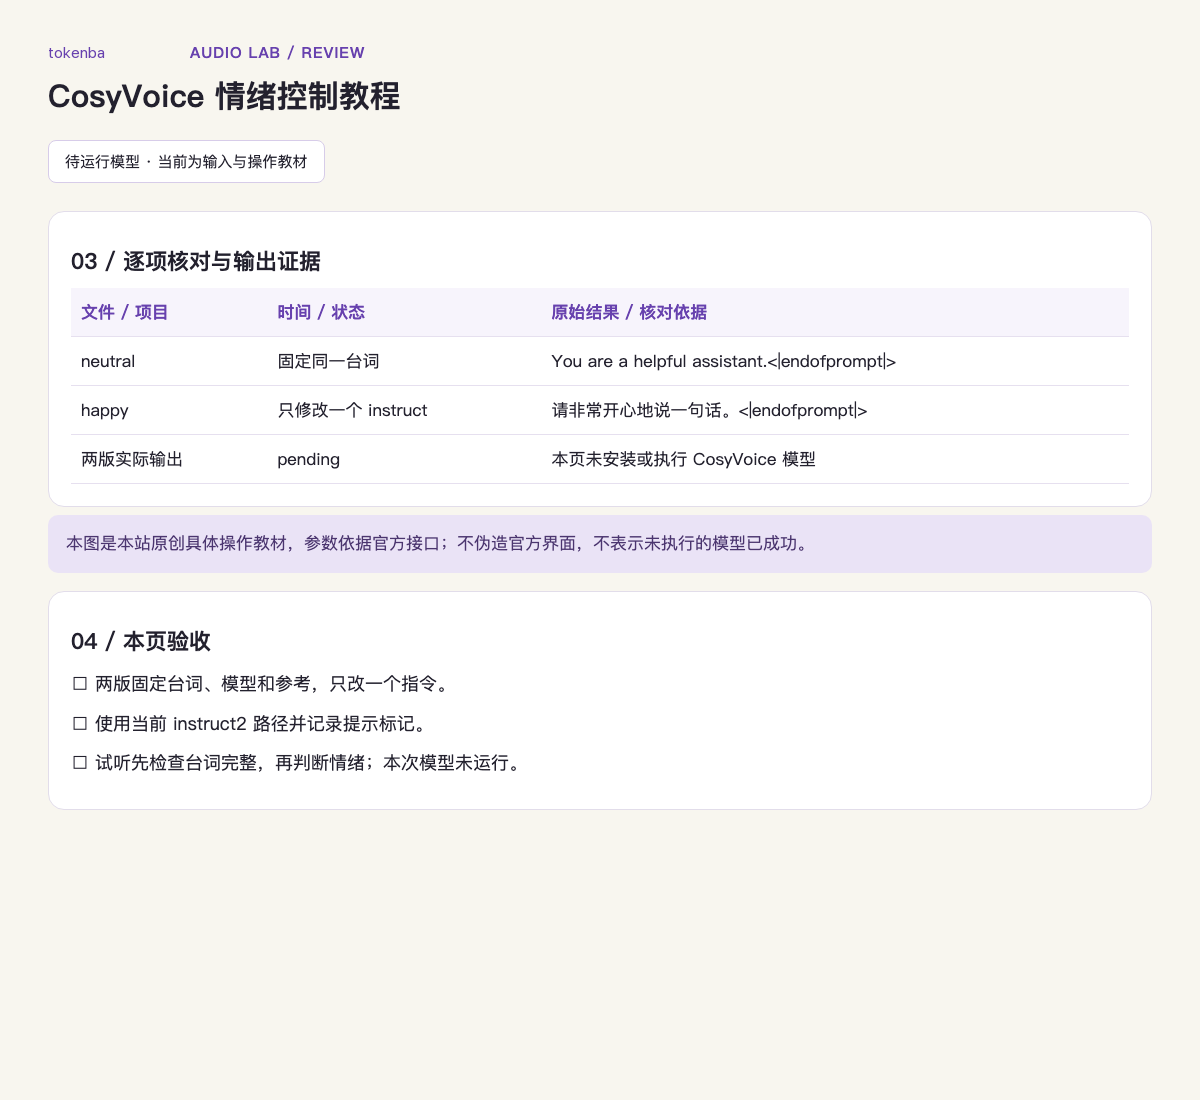
jobs.json 记录 neutral/happy 的指令,输出各自生成 WAV 与 hash。不得把系统朗读的 input.wav 改名成 happy.wav 表示成功。当前生成状态明确 pending。
5. 试听台词完整度再听情绪
review.csv 先检漏字、重复、数字和段尾,再判断情绪强弱;语速快时也不能漏读文本。情绪是人工听感评审,文件校验不自动判定成功。
6. 只重做失败版本并留记录
如果开心版遗漏数字,修改一个指令或台词规范后另存版本。不覆盖中性基线,保存完整参数和失败理由;最终音频接剪辑器前完整试听。
7. 下载材料、检查负例与继续操作
解压素材包后先运行 python check.py,再运行 python check.py --self-test。前者读取真实 WAV / JSON / SRT 与源 hash;后者拒绝损坏 WAV、倒置时间、越界时间和缺失词时间。文件通过不代表文字、情绪或说话人判定已通过。
怎样确认已经完成
- 两版固定台词、模型和参考,只改一个指令。
- 使用当前 instruct2 路径并记录提示标记。
- 试听先检查台词完整,再判断情绪;本次模型未运行。
常见问题
指令写得越多情绪越明显吗?
不一定。多个控制可能冲突,先做一个因素的中性对照,按实际试听记录效果。
如何证明开心版没有漏字?
回听并逐句对照 target.txt,保存人工评审;WAV 可解码、响度或时长相近都不能证明台词完整。