
展开本页目录
开始前准备什么
- 下载练习包并解压到独立目录,保留原件。
- 使用自己有权限的目标工具;AI建议与Word/Excel/PPT等原生命令分别执行、分别验收。
- 作者参考的执行范围见本页结果和README;未运行的目标账号、云端权限或界面操作不计为已完成。
- 导入评论ID与原文
- 建立受保护否定短语词典
- 先检查comment_id唯一性
- 先按最长受保护短语匹配
- 生成词频与每个词对应的评论ID
- 将“不好用”改成“好用”重跑
- 导出字典版本、词频与原句索引
1. 导入评论ID与原文
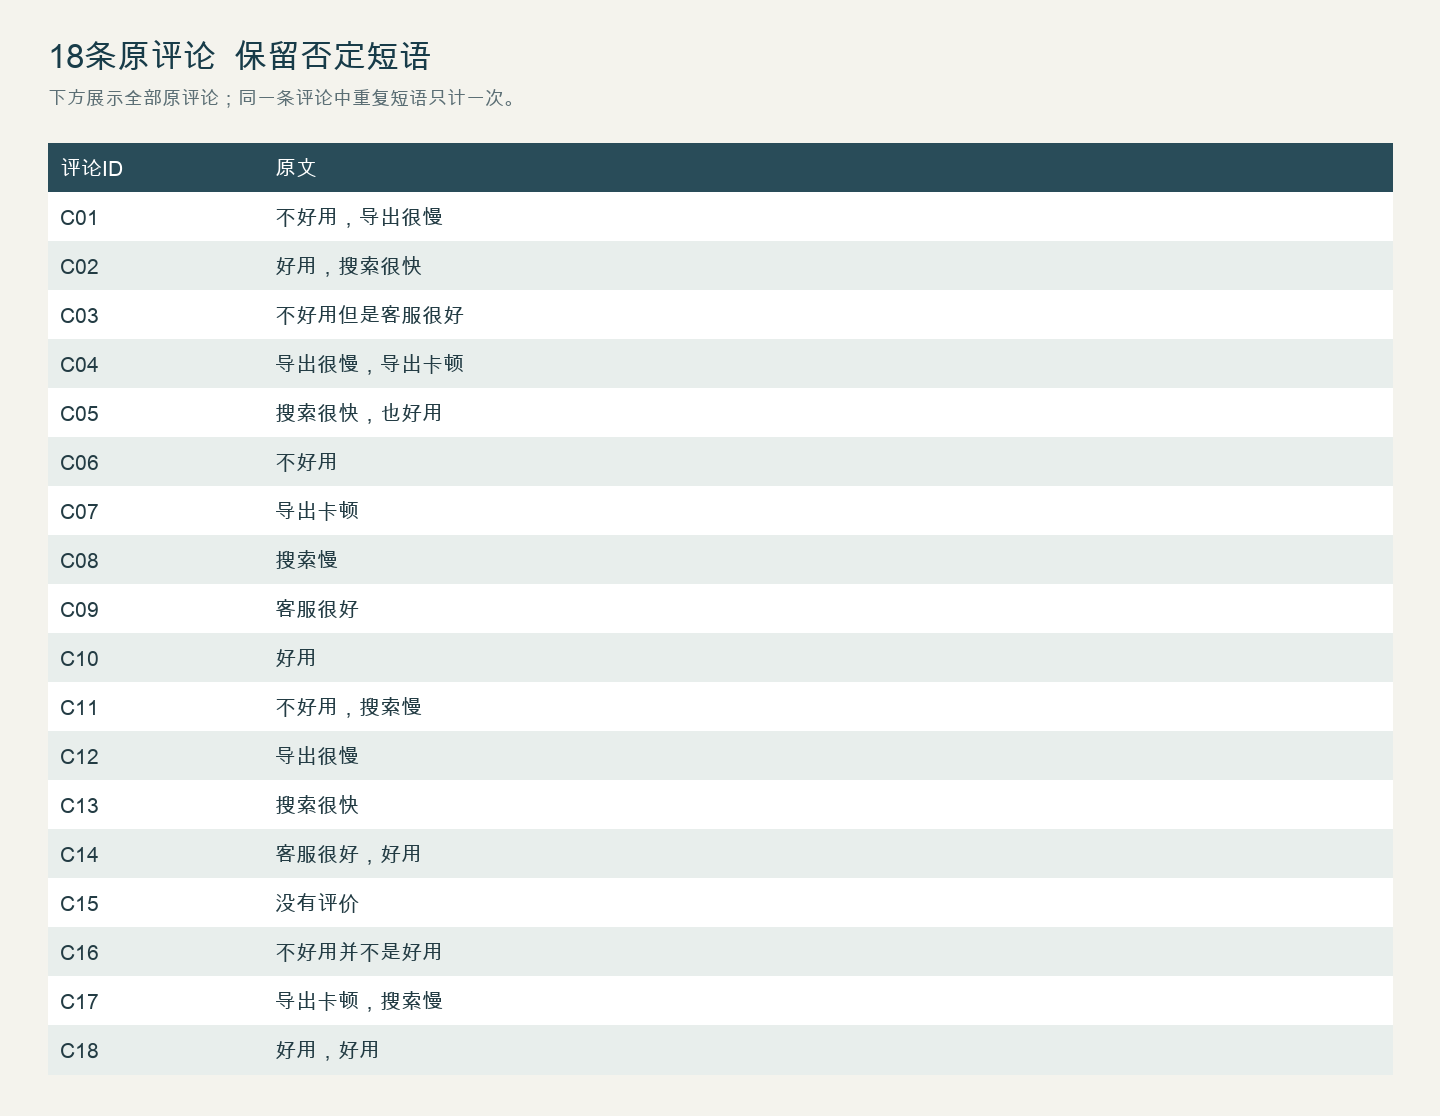
导入评论ID与原文,先看原句而不立即画词云。
本页练习输入:18条原创产品反馈,含好用/不好用、导出慢/导出卡顿、否定与同一评论内重复短语。
2. 建立受保护否定短语词典
建立受保护否定短语词典,列出导出很慢/导出卡顿等可合并表达。
3. 先检查comment_id唯一性
先检查comment_id唯一性;如出现重复ID,单列核实,不把同文本不同人的评论混为一条。
text
text
任务:ChatGPT 中文词频分析:把“不好用”与“好用”分开,保留短语和原评论出处
输入:18条原创产品反馈,含好用/不好用、导出慢/导出卡顿、否定与同一评论内重复短语。
请保留原件,并只对副本工作。按以下顺序执行:
1. 导入评论ID与原文,先看原句而不立即画词云。
2. 建立受保护否定短语词典,列出导出很慢/导出卡顿等可合并表达。
3. 先检查comment_id唯一性;如出现重复ID,单列核实,不把同文本不同人的评论混为一条。
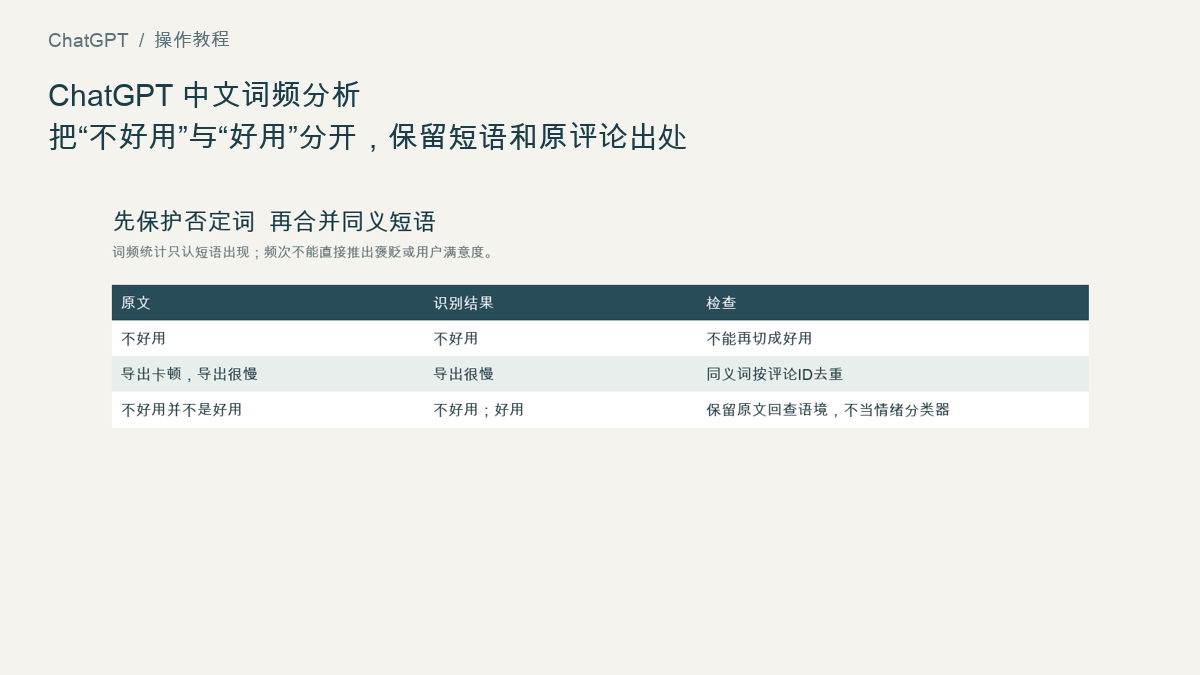
4. 先按最长受保护短语匹配,再按同义映射合并;本题不用自动分词替代短语边界。
5. 生成词频与每个词对应的评论ID,不把高频自动解释成正面。
6. 将“不好用”改成“好用”重跑,核对两条计数变化。
7. 导出字典版本、词频与原句索引,附明显局限。
交付:原评论CSV;受保护短语与同义映射JSON;按评论计数的词频表和原句出处CSV。
遇到缺失信息或不可执行的原生功能,明确列出,不用编造结果填补。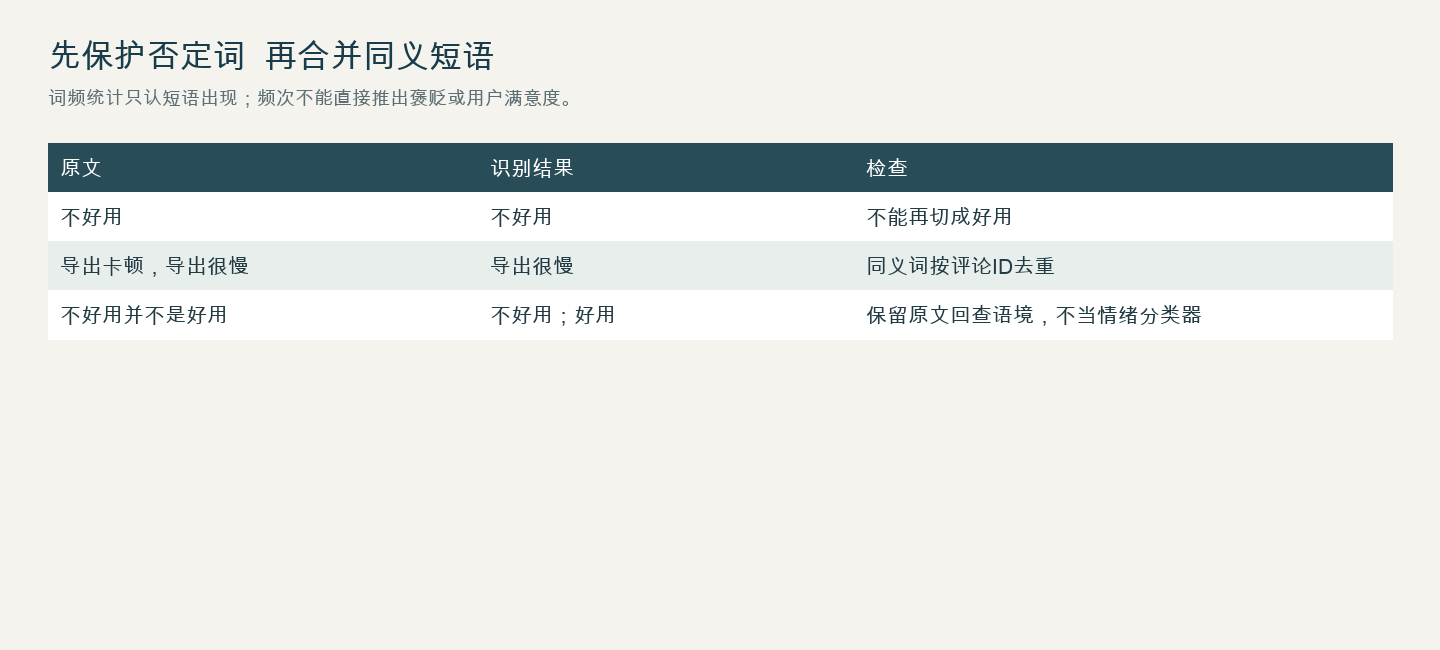
4. 先按最长受保护短语匹配
先按最长受保护短语匹配,再按同义映射合并;本题不用自动分词替代短语边界。
5. 生成词频与每个词对应的评论ID
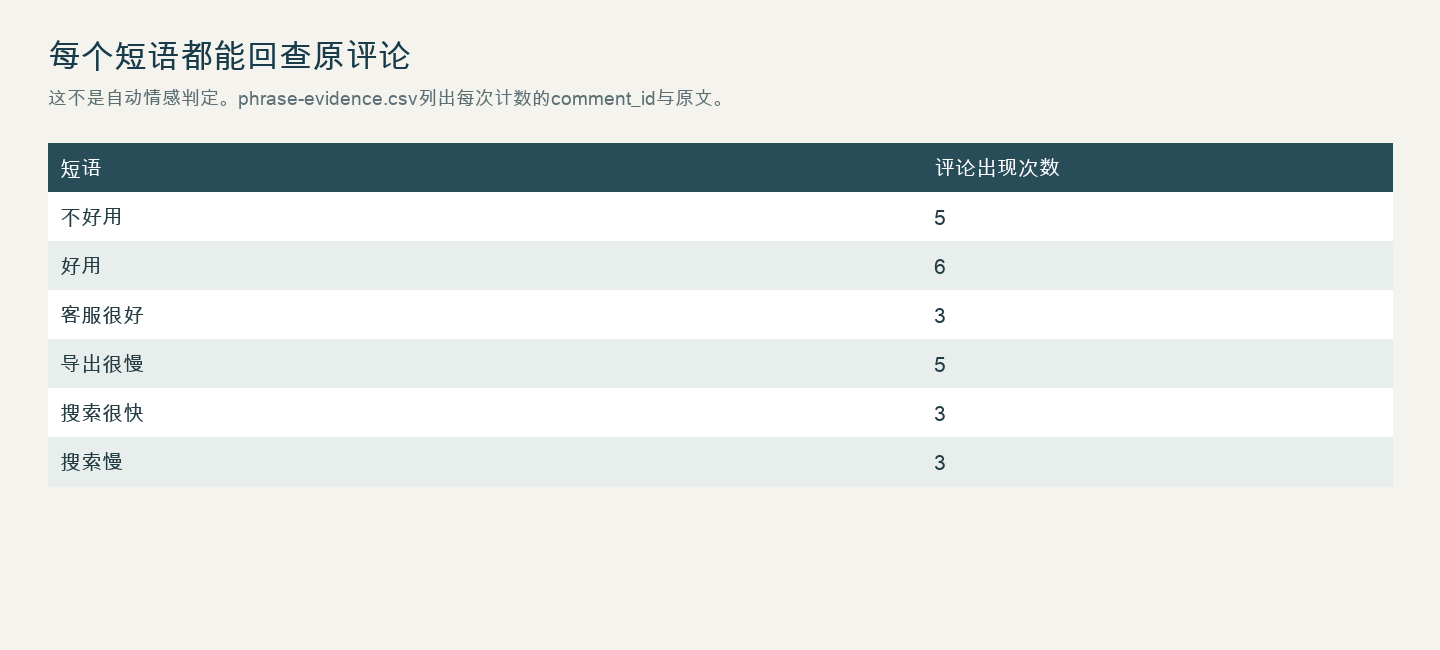
生成词频与每个词对应的评论ID,不把高频自动解释成正面。
本地参考与核对结果:原始18条评论中,不好用出现于5条,好用出现于6条;每个短语都保留原评论ID,未把词频冒充情绪判断。
6. 将“不好用”改成“好用”重跑
将“不好用”改成“好用”重跑,核对两条计数变化。
7. 导出字典版本、词频与原句索引
导出字典版本、词频与原句索引,附明显局限。
下载ZIP保留原始输入与作者参考两种身份;先按本页步骤完成自己的结果,再运行verify.py核对。具体依赖和已执行范围见README。
bash
bash
python3 verify.py怎样确认已经完成
- 不好用不拆成好用计入正面词。
- 产品名保持完整。
- 任何频次能回到具体评论ID。
常见问题
AI词云里全是“好用”,为什么原评论却在抱怨?
直接搜索好用会把不好用里面的两个字也数进去。先识别并保护最长否定短语,再计算不重叠命中;本题不好用在5条评论中,不能因此给好用增加5次。
中文分词怎样保住“不推荐”和产品名称,不只数单字?
先给产品名和否定短语词典,再按最长优先匹配保留原文位置;本页示例保护不好用,并按评论ID追溯。每评论去重计数不是总出现次数,也不能直接等同满意度。