
展开本页目录
开始前准备什么
- Python 3.13+ 与独立练习目录;默认离线重放不需要 Key。
- 发起新请求时使用自己的 apizt Key;先核对当前模型权限和价格,Key 不写入教材。
- 材料为原创合成样例;相关第三方项目仅作方法参考,真实执行范围以本页记录为准。
- 核对输入
- 保存响应
- 执行本地处理
- 验收文件和负例
原始输入、真实请求与响应、业务脚本、正反例检查及已生成的结果文件;不含 Key。
1. 准备这份输入,先确定不能猜的字段
避免同一句话在不同租户间错误复用结果。先将下面的原创合成材料保存为 input.json;不要一开始接正式客户资料。
本例与已有教程的区别:已有Prompt Caching是上游前缀;这里是用户级结果存储规则
input.json(较长时显示节选,完整文件在资料包)
{
  "requests": [
    {
      "tenant": "A",
      "prompt_version": "1",
      "model": "M",
      "text": "同一问"
    },
    {
      "tenant": "B",
      "prompt_version": "1",
      "model": "M",
      "text": "同一问"
    },
    {
      "tenant": "A",
      "prompt_version": "2",
      "model": "M",
      "text": "同一问"
    }
  ]
}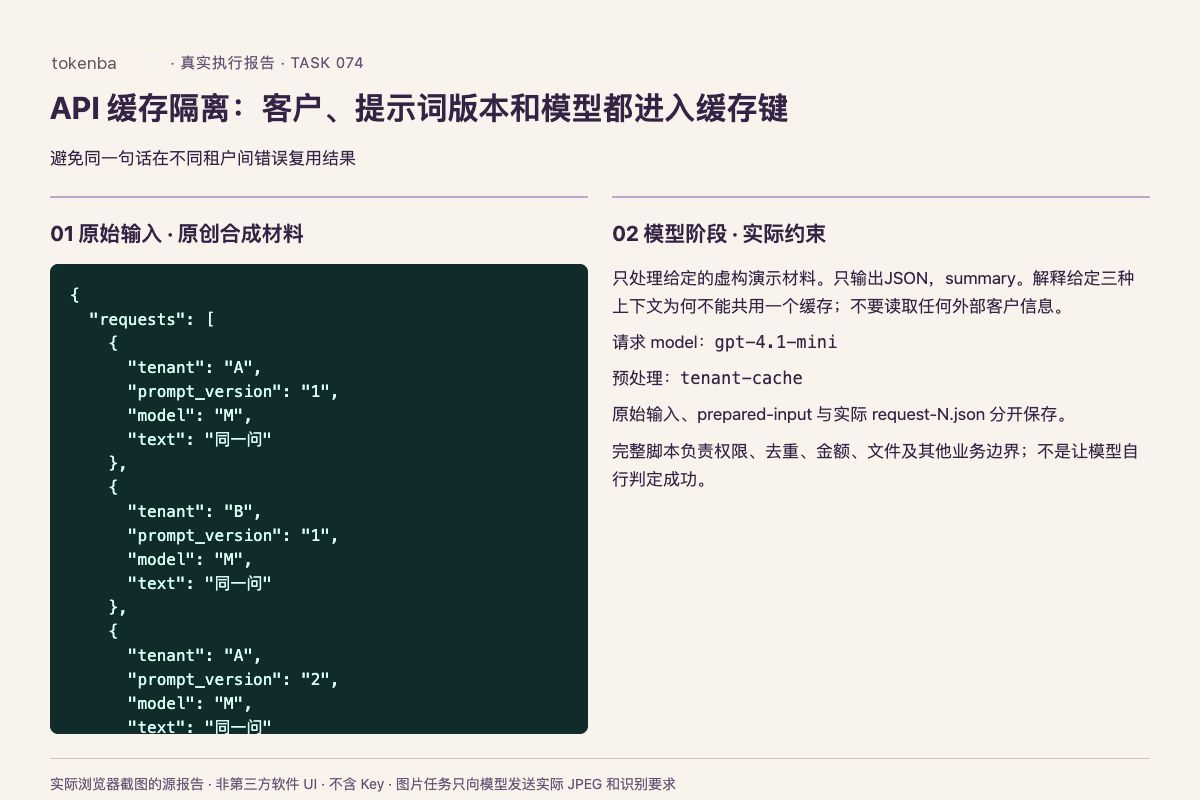
实际浏览器截图:原创合成输入及本次请求参数;不是第三方软件界面。
2. 发送一次小请求,保留原始响应
下载并解压资料包,按 README 创建独立 Python 环境。python run.py 默认仅离线复核已保存回执;显式运行 python run.py --live 才发起新请求并可能计费。
模型阶段使用下面的任务约束。若存在预处理,prepared-input.json 是去重、分页收集或过滤后的真实输入;完整原始材料仍保留。识图任务发送实际 JPEG,不把人工真值放入提示词。
对应任务的请求参数说明;完整实际 request-N.json 见资料包
{
  "model": "gpt-4.1-mini",
  "messages": [
    {
      "role": "system",
      "content": "只处理给定的虚构演示材料。只输出JSON,summary。解释给定三种上下文为何不能共用一个缓存;不要读取任何外部客户信息。"
    },
    {
      "role": "user",
      "content": "{\n  \"requests\": [\n    {\n      \"tenant\": \"A\",\n      \"prompt_version\": \"1\",\n      \"model\": \"M\",\n      \"text\": \"同一问\"\n    },\n    {\n      \"tenant\": \"B\",\n      \"prompt_version\": \"1\",\n      \"model\": \"M\",\n      \"text\": \"同一问\"\n    },\n    {\n      \"tenant\": \"A\",\n      \"prompt_version\": \"2\",\n      \"model\": \"M\",\n      \"text\": \"同一问\"\n    }\n  ]\n}"
    }
  ],
  "temperature": 0,
  "max_tokens": 1024,
  "provider": {
    "sort": "success_rate"
  },
  "response_format": {
    "type": "json_object"
  }
}3. 执行本例的本地处理,模型字段还要再验算
以下节选来自这次实际执行的 verify-task.py 分支。完整函数和辅助方法均在资料包;运行 python run.py 会使用原始回执重放这段业务操作,而不是让模型自己宣布成功。
包含租户版本和模型的缓存键互不相同;本地反例:只按文字会产生跨租户碰撞
verify-task.py · tenant-cache 分支节选,需在完整脚本上下文运行
keys = [hashlib.sha256(json.dumps(row, sort_keys=True).encode()).hexdigest() for row in data['requests']]
naive = [hashlib.sha256(row['text'].encode()).hexdigest() for row in data['requests']]
check('包含租户版本和模型的缓存键互不相同', len(set(keys)) == 3)
check('本地反例:只按文字会产生跨租户碰撞', len(set(naive)) == 1)
result = {'unique_keys': len(set(keys)), 'naive_collision': True, 'explanation': output}
4. 查看真实结果、文件与验收记录
本次 4/4 项通过。模型返回与最终业务结果分开保存;以下是本地处理后的 result.json。
最后一次实测时间:2026-10-24T15:21:39.609330+00:00;HTTP 200;请求型号 gpt-4.1-mini;返回型号 gpt-4.1-mini;本次返回用量 245。中断或超时不会补造用量,多个尝试不合并成一次成功。
实际产物:checks.json、result.json。
| 检查项 | 本次结果 |
|---|---|
| 真实 apizt 响应 HTTP 200 | 通过 |
| 原始响应 content 可直接解析 JSON | 通过 |
| 包含租户版本和模型的缓存键互不相同 | 通过 |
| 本地反例:只按文字会产生跨租户碰撞 | 通过 |
- 检查项
- 真实 apizt 响应 HTTP 200
- 本次结果
- 通过
- 检查项
- 原始响应 content 可直接解析 JSON
- 本次结果
- 通过
- 检查项
- 包含租户版本和模型的缓存键互不相同
- 本次结果
- 通过
- 检查项
- 本地反例:只按文字会产生跨租户碰撞
- 本次结果
- 通过
verified/result.json(节选)
{
  "unique_keys": 3,
  "naive_collision": true,
  "explanation": {
    "summary": "三种上下文不能共用一个缓存的原因在于:1) 不同租户(tenant A和tenant B)之间的数据隔离需求,防止数据泄露和保证隐私;2) 不同提示版本(prompt_version 1和2)可能导致生成结果不同,缓存混用会导致结果不准确;3) 虽然模型相同,但不同租户和版本的组合需要独立缓存以保证响应的正确性和安全性。"
  }
}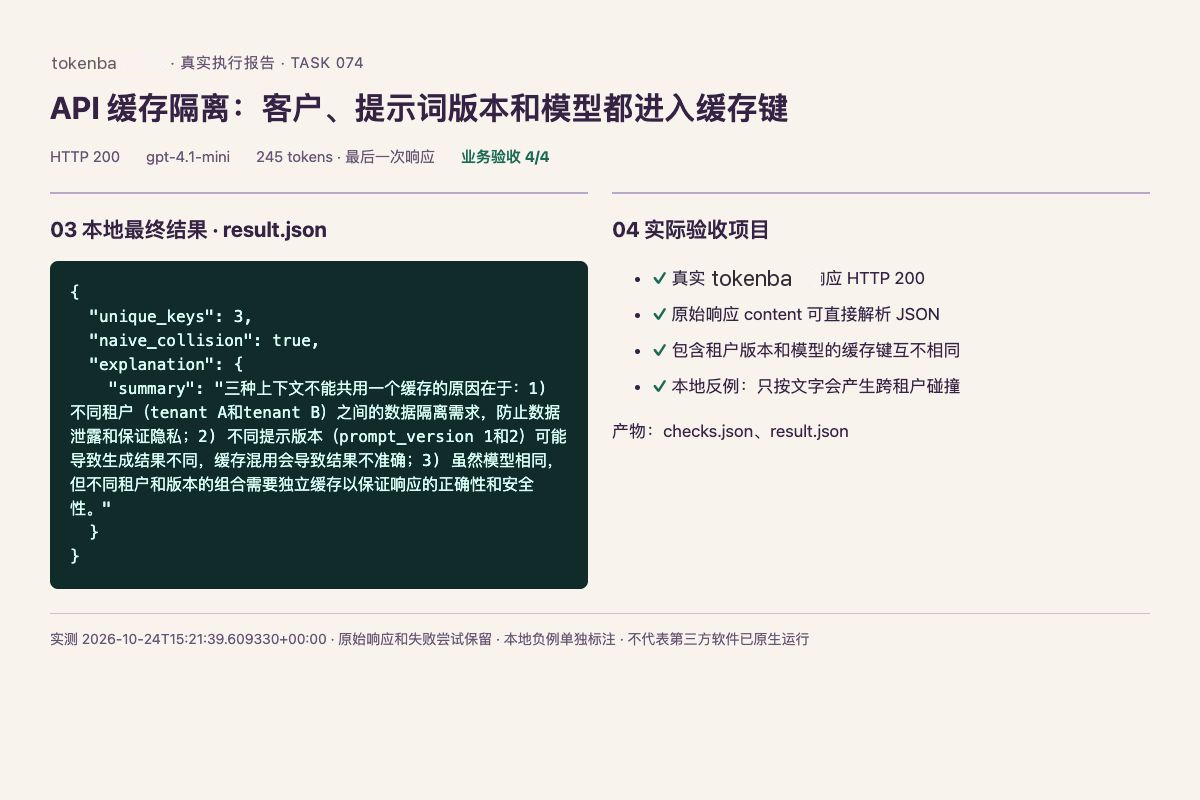
浏览器实拍执行报告;原始 API 响应与本地验收分别保存。
5. 换自己的材料时,先检查失败分支
本地反例用于验证业务边界,已在检查表中明确标记;不能把本地构造的错误状态写成网关真实故障。原始回执及失败尝试不删除。
本例是小样验证;替换输入后必须重新检查字段、事实和实际费用。
只把本篇标注的任务作为本次验收范围。第三方软件、未测模型、工具调用能力和真实用户数据都需要另行验证;没有调用视频生成模型。
- 包含租户版本和模型的缓存键互不相同
- 本地反例:只按文字会产生跨租户碰撞
解压目录中运行;第一条离线,第二条显式发起新请求
python run.py
# 安全设置自己的 tokenba_API_KEY 后,才执行下面这一条
python run.py --live
怎样确认已经完成
- 真实 apizt 响应 HTTP 200
- 原始响应 content 可直接解析 JSON
- 包含租户版本和模型的缓存键互不相同
- 本地反例:只按文字会产生跨租户碰撞
常见问题
API 缓存隔离只看 HTTP200 就完成了吗?
还需要按本页独立规则检查事实、缺失项及最终文件。模型阶段成功与本地工作流成功分别记录。
可以不登录其他平台运行本例吗?
可以。本例使用 apizt API 和本地 Python 脚本;离线复核也无需 API Key。第三方软件的原生 UI、插件和账号权限不在本次验收范围。
更换输入后还能沿用本页的通过结果吗?
不能。原始事实断言只适用于本页合成材料。替换输入后必须同步调整 expected、业务规则与负例,再检查输出。