
展开本页目录
开始前准备什么
- Python 3.10或更新版本;脚本只使用标准库
- 有权处理的资料与原始备份;本篇使用虚构业务样本
- 重跑时使用自己的apizt Key;离线复核无需Key
- 下载资料包
- 核对来源和合同
- 小样本调用文本模型
- 检查并人工确认
- 交付与复用
先下载样例,再完成自己的首次调用
示例不含密钥。API 按实际用量计费;下载和点击不代表调用成功。
中文说明、可编辑输入、脚本、原始响应、校验与交付文件;不含Key
本次样本的审校成果,不等于生产系统已导入
先看本篇能交付什么
从给定候选词挑选相关词,去重后实际编码计数;演示中文字符与英文字符的字节差异。
字符数不是字节数;本例80bytes是演示预算,不宣称提交后台后已收录。
| 交付物 | 用途与边界 |
|---|---|
| export.csv | 实际输出的审核稿,不会自动写入生产系统 |
| run.py + case.json | 修改自己的资料后可重跑;默认离线复核不调用API |
| response.json + receipt.json | 核对原始模型返回、用量、时间与内容摘要 |
- 交付物
- export.csv
- 用途与边界
- 实际输出的审核稿,不会自动写入生产系统
- 交付物
- run.py + case.json
- 用途与边界
- 修改自己的资料后可重跑;默认离线复核不调用API
- 交付物
- response.json + receipt.json
- 用途与边界
- 核对原始模型返回、用量、时间与内容摘要
第一步:固定输入、来源与缺项
把候选词放进 allowed;先剔除无来源的品牌和不相关词。
虚构业务样本;实际调用 apizt API。不是商店、客户或游戏生产数据。
| id | facts | allowed |
|---|---|---|
| K1 | 500 mL不锈钢旅行杯 | ["travel", "cup", "camping", "stainless", "便携", "水杯"] |
| K2 | 可调节桌面手机支架 | ["desk", "phone", "stand", "adjustable", "手机", "支架"] |
- id
- K1
- facts
- 500 mL不锈钢旅行杯
- allowed
- ["travel", "cup", "camping", "stainless", "便携", "水杯"]
- id
- K2
- facts
- 可调节桌面手机支架
- allowed
- ["desk", "phone", "stand", "adjustable", "手机", "支架"]
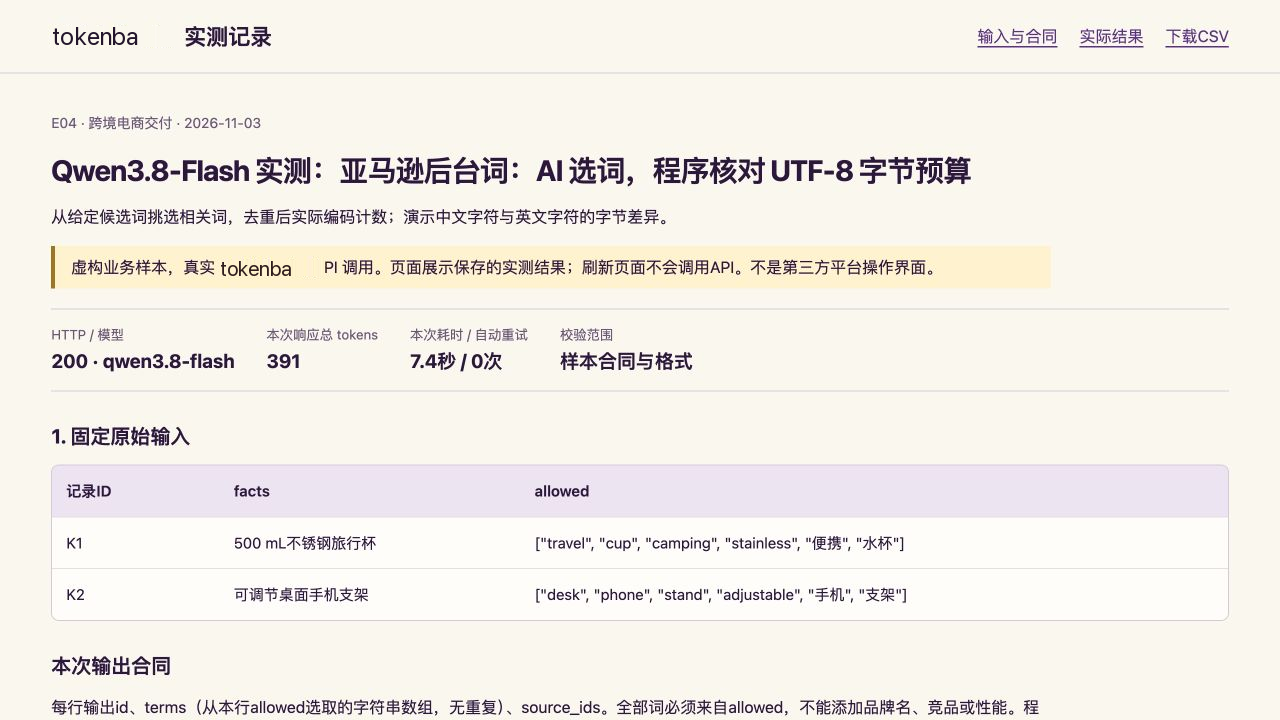
本篇实际运行报告截图。业务资料为虚构样本;不是第三方平台界面。
第二步:用 apizt 只跑一次文本任务
模型只给 terms 数组,程序按空格拼接并执行 len(text.encode('utf-8')),不让模型猜字节数。
下载并解压资料包,先执行 python3 run.py 离线核对保存结果。要调用自己的API,复制一份工作目录,按README修改case.json,再执行 --run --new-output ./my-run;新目录不会混入旧响应或旧人工改动。Key只在终端本次进程中使用。
默认使用本篇资料包指定的低成本文本模型,输出上限1536 tokens,45秒超时,不自动重试;若返回401/429或截断,先核对凭据、额度、路由或输出预算,保留失败记录。
本地复核与运行
python3 --version
python3 run.py
# 阅读README并在工作副本中修改case.json后,才运行下一行
python3 run.py --run --new-output ./my-run第三步:核对真实返回与交付结果
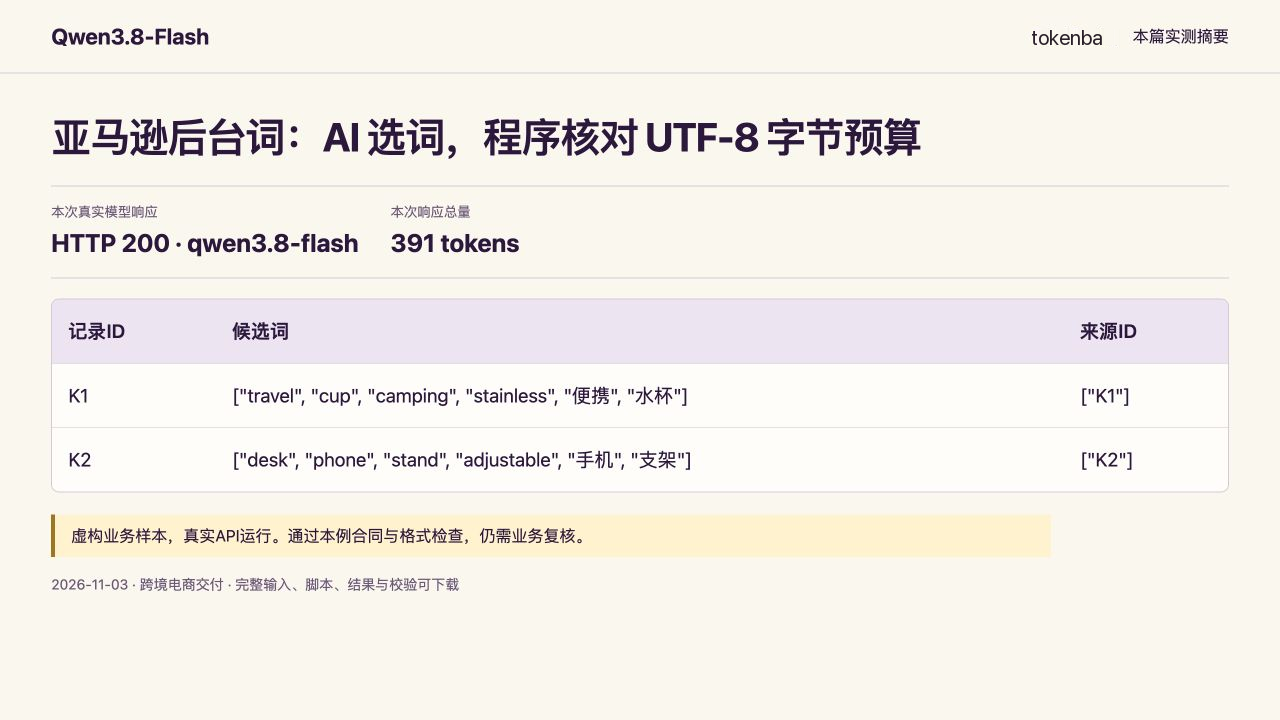
这次运行返回 HTTP 200,模型 qwen3.8-flash,响应总量 391 tokens,耗时 7.4 秒。本例合同与格式检查通过,业务解释与外部适用性仍需人工复核。
查看 byte-budget.json;再把一个词替换成长中文字符串,确认离线负例触发预算错误。实际站点字段限制仍需运营核对。
| 记录ID | 候选词 | 来源ID |
|---|---|---|
| K1 | ["travel", "cup", "camping", "stainless", "便携", "水杯"] | ["K1"] |
| K2 | ["desk", "phone", "stand", "adjustable", "手机", "支架"] | ["K2"] |
- 记录ID
- K1
- 候选词
- ["travel", "cup", "camping", "stainless", "便携", "水杯"]
- 来源ID
- ["K1"]
- 记录ID
- K2
- 候选词
- ["desk", "phone", "stand", "adjustable", "手机", "支架"]
- 来源ID
- ["K2"]
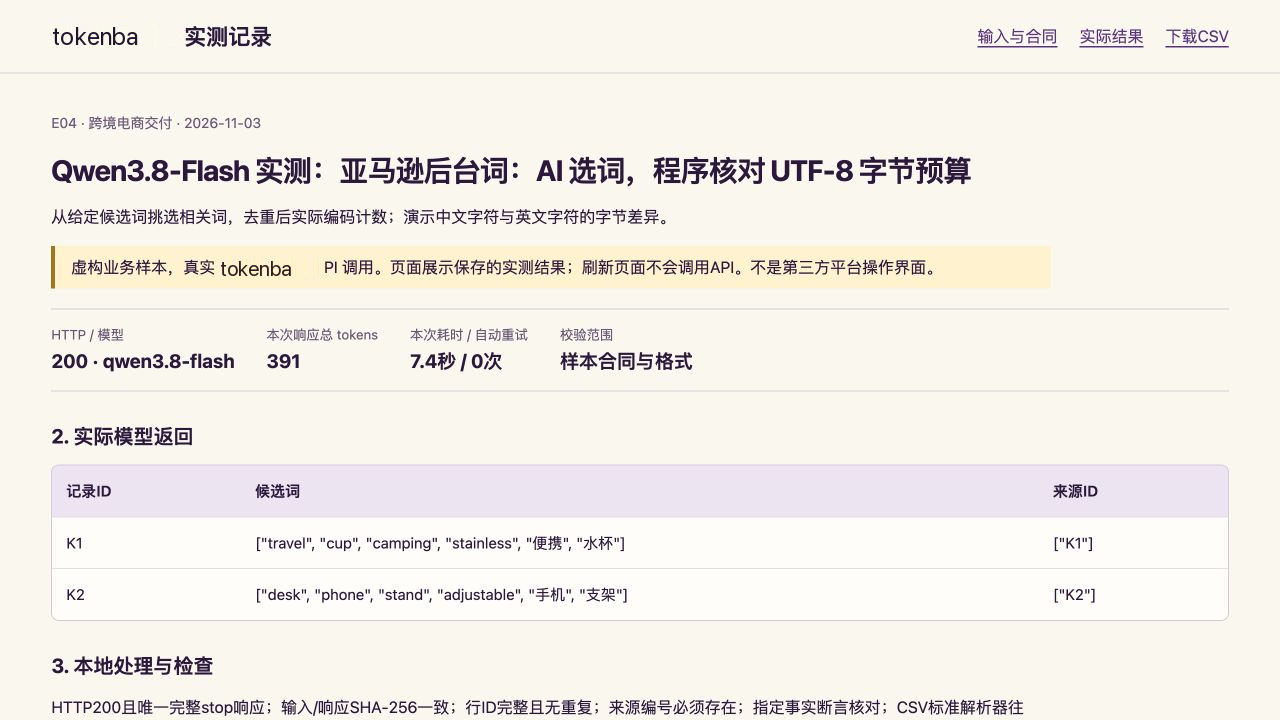
本篇实际运行报告截图。业务资料为虚构样本;不是第三方平台界面。
第四步:程序检查与人工确认分开
只校验本例合同、编号、指定事实与格式;不证明业务事实在现实世界成立。
脚本实际测试了改坏行ID与伪造来源ID两个负例,均被拒绝。它们证明这两个错误分支能被检测,不代表所有幻觉、格式或业务错误都已覆盖。
- HTTP200且唯一完整stop响应
- 输入/响应SHA-256一致
- 行ID完整且无重复
- 来源编号必须存在
- 指定事实断言核对
- CSV标准解析器往返:行数一致
- 重复30次便携的负例:UTF-8字节数超过80
local-result.json
{
  "K1": {
    "text": "travel cup camping stainless 便携 水杯",
    "utf8_bytes": 42,
    "budget": 80
  },
  "K2": {
    "text": "desk phone stand adjustable 手机 支架",
    "utf8_bytes": 41,
    "budget": 80
  }
}
第五步:用自己的小样本验收,再进入业务流程
先把资料换成有权处理的脱敏样本;保留原文件和审核副本,逐项核对来源、条件、未知项与最终输出。
当前页面和结果包没有任何私密Key;不需要登录其他AI平台。配置apizt后先完成一次低成本调用,再判断该任务是否值得复用。
搜索词按具体工作任务组织;本批没有取得这些词的Google或抖音搜索量,不标注虚构热度,也不承诺收录、排名或业务收益。
怎样确认已经完成
- 字符数不是字节数;本例80bytes是演示预算,不宣称提交后台后已收录。
- 未知项没有补成事实
- 原始模型输出与人工审校文件分开保存
- 没有执行线上写入或第三方发布
常见问题
样本和截图是真实的吗?
业务输入是明确标注的虚构样本,API响应、耗时、usage、结果文件与报告截图来自这次实际运行;不是客户生产数据,也不是第三方后台截图。
需要登录其他AI平台吗?
不需要。浏览器任务台直接调用apizt,或用资料包里的Python脚本;API按实际用量计费,默认不自动重试,不跑视频模型。
检查通过后能直接用于生产吗?
字符数不是字节数;本例80bytes是演示预算,不宣称提交后台后已收录。 还要使用真实且有权处理的资料,复核当前平台规则与自己的业务约束。