
发布解读,非本站实测。 本文依据公开资料整理,未完成本文模型的付费接口测试。厂商基准只适用于其公布的版本、数据集与条件;未提供可复核来源、原始值及换算方法的衍生评分已撤下。 2026 年上半年,国产开源模型在文生图领域终于啃下了一块硬骨头:图里的中文字。智谱 AI 发布的 GLM-Image,在中文文字渲染的准确率上做到了 SOTA——海报、信息图、商品图上的中文不再乱码,这在国产开源模型里是头一遭。
但"文字对"不等于"图好看"。公开第三方评测的横向对比里,GLM-Image 是一个典型的特长生:文字渲染一骑绝尘,画面质感、风格多样性、复杂场景理解却仍落后于闭源旗舰 GPT Image 2 和 Nano Banana Pro。这篇评测把它放进当前主流图像模型的对比里,看它到底强在哪、短板在哪、什么时候该选它。
说明
本文的能力描述来自智谱官方发布与公开第三方评测,非本站实测。价格数据为各平台公开值。
一、GLM-Image 的核心:把中文文字渲染做到 SOTA
文生图模型长期有个"老大难":生成的图片里,英文还凑合,中文基本是鬼画符。原因是大部分模型的训练数据里,带中文文字标注的图像占比极低。
GLM-Image 的突破在于智谱针对中文场景做了专项训练:
- 中文文字准确率 SOTA:在 公开第三方评测里,GLM-Image 生成带中文的电商海报、信息图、社交配图,文字准确率领先 Qwen-Image、甚至逼近 GPT Image 2。
- 开源可商用:作为开源模型,企业可以私有化部署,数据不出域,这对金融、政企、医疗等合规敏感场景是刚需。
- 成本可控:自部署只需 GPU 成本,没有按次/按 token 的调用费。
智谱官方在 GitHub 发布的 CVTG-2K / LongText-Bench 文字渲染准确率对比,是 GLM-Image "特长生"定位的最直接证据:
| 基准 | 指标 | GLM-Image | 对比开源竞品 |
|---|---|---|---|
| CVTG-2K(英文) | 平均词准确率 | 0.9116 | 领先 SD3 / FLUX |
| LongText 英文 | 词准确率 | 0.9524 | 开源最高 |
| LongText 中文 | 词准确率 | 0.9788 | 开源最高 |
来源:github.com/zai-org/GLM-Image(MIT 开源仓库),官方 README 基准表
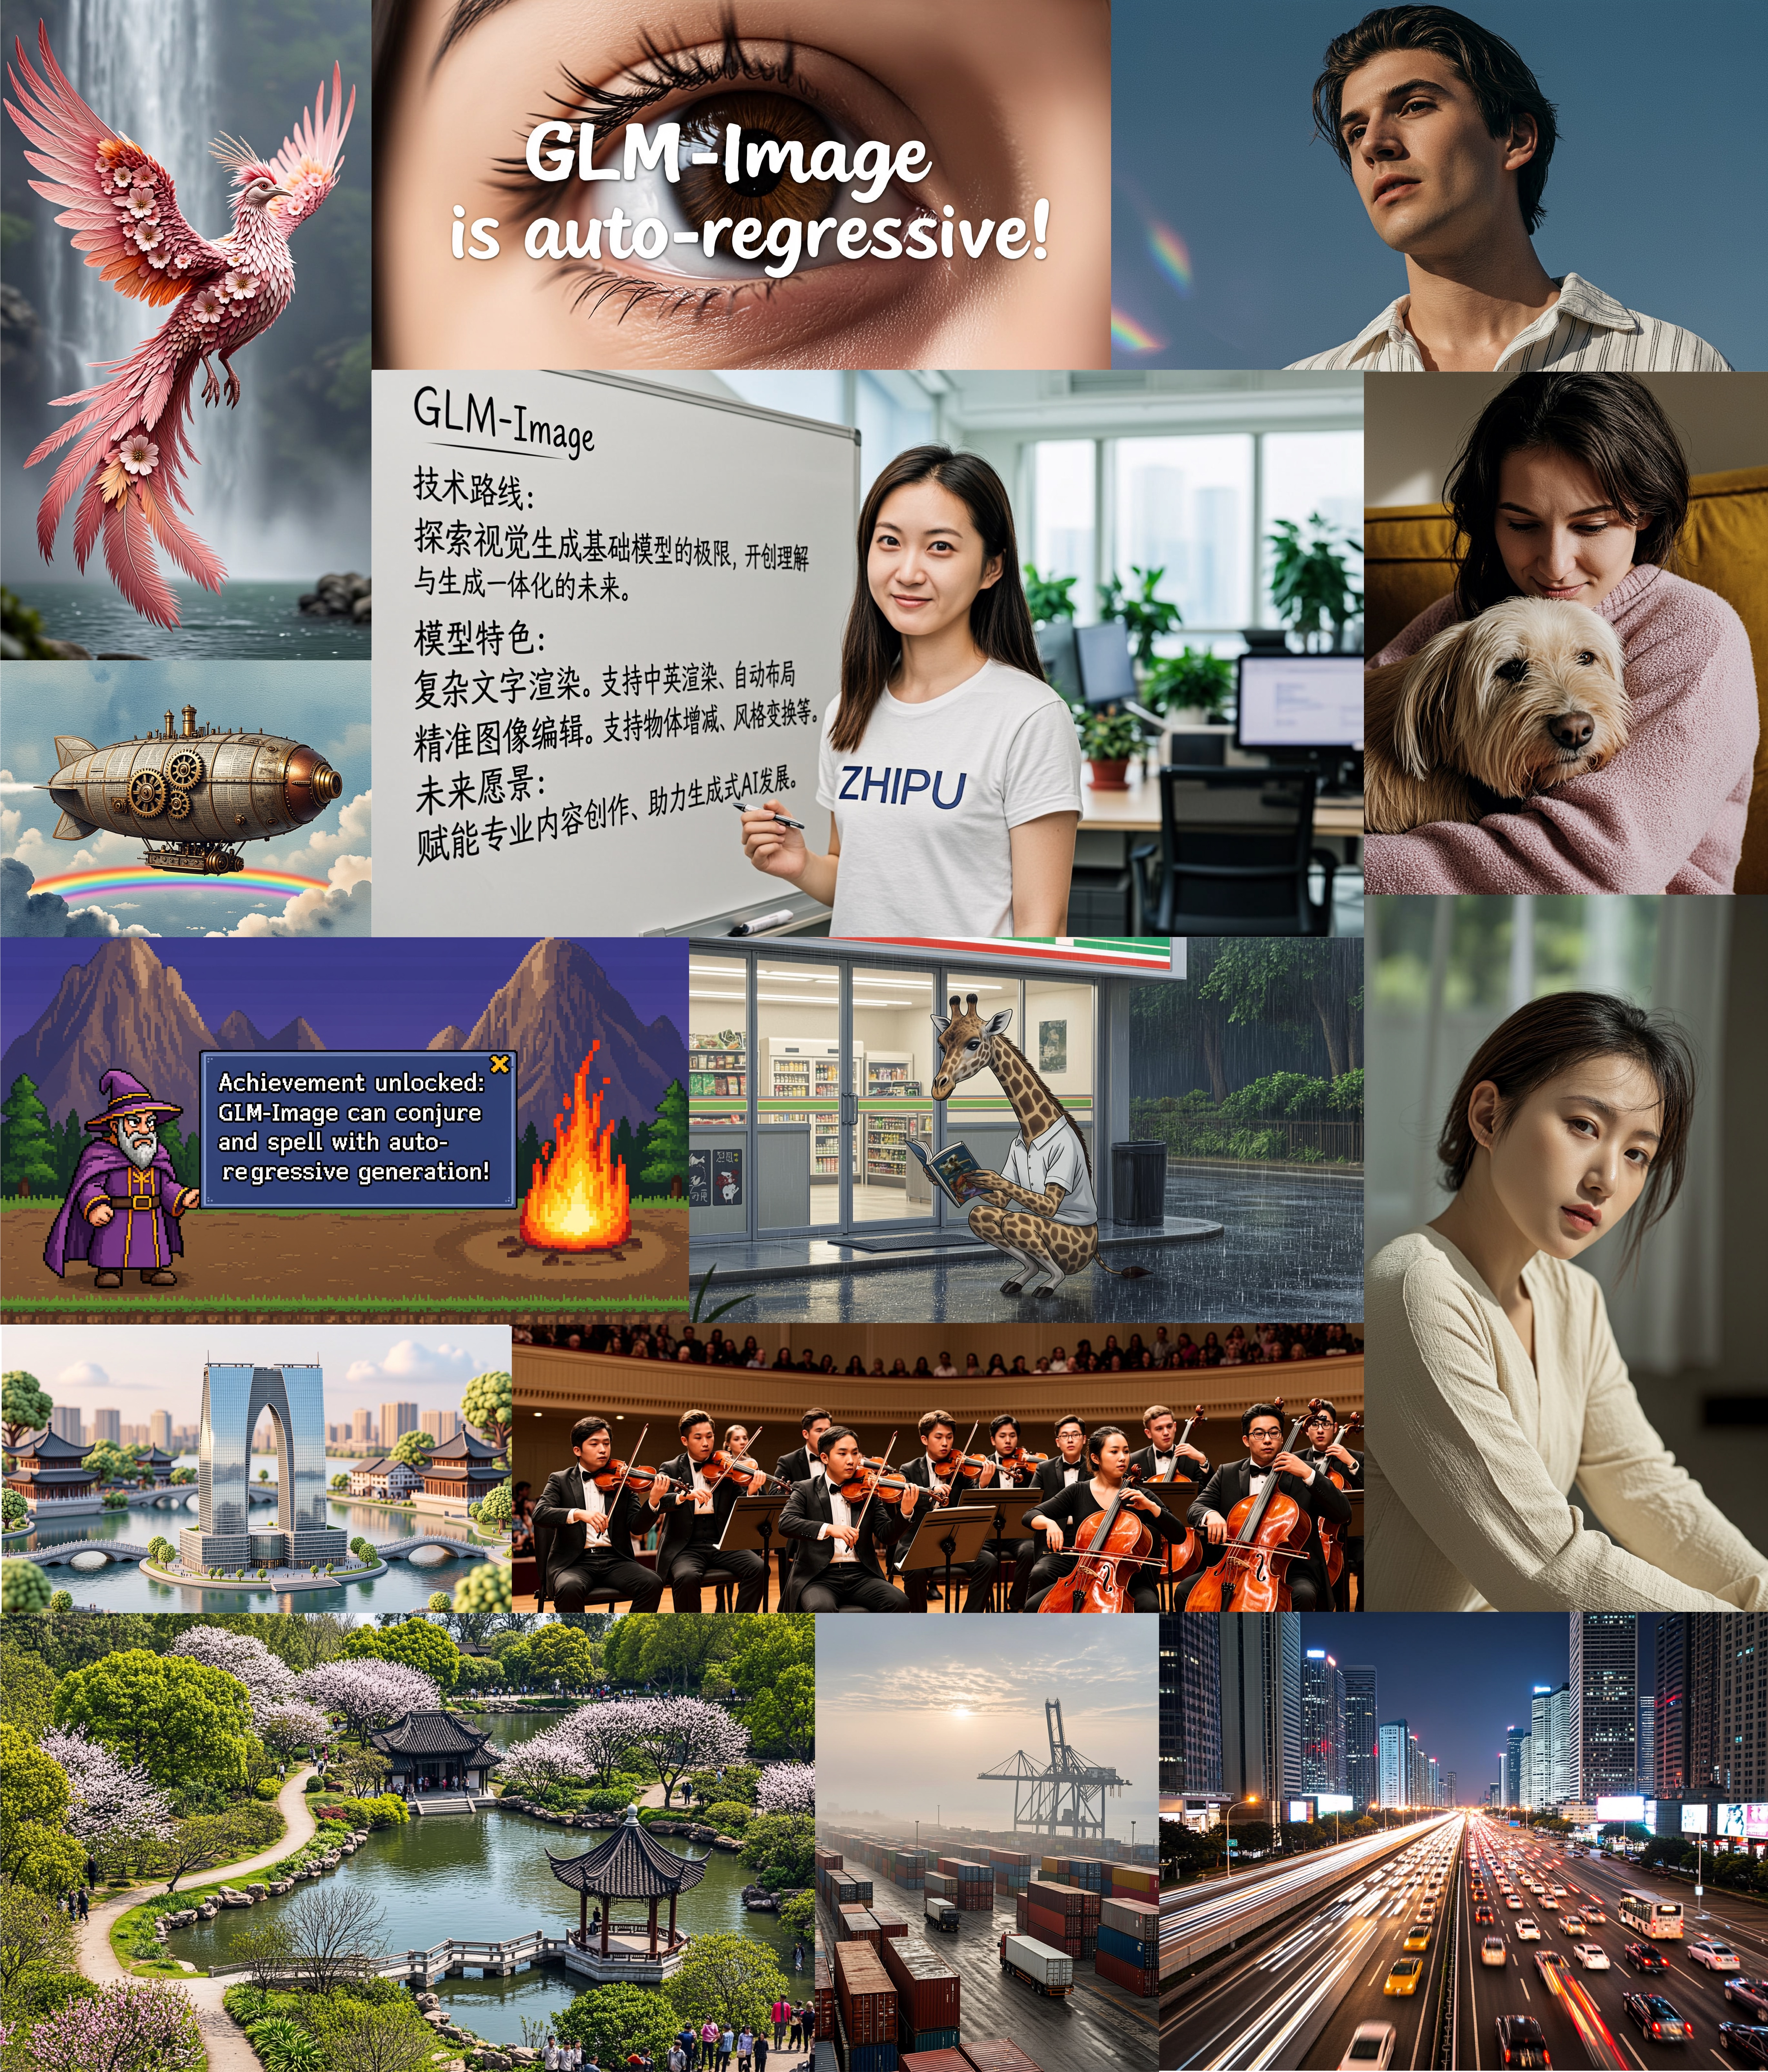
官方放出的文生图样例展示(show case),能看到 GLM-Image 在信息图、海报、商品图等带文字场景的实际表现:
三、横向实测:特长生 vs 全能选手
根据公开第三方评测的横向对比,我们能看到清晰的定位差异:
中文文字渲染(GLM-Image 的主场)
| 模型 | 中文准确率 | 英文准确率 |
|---|---|---|
| GLM-Image | ⭐ SOTA | 良好 |
| GPT Image 2 | 良好 | ⭐ SOTA |
| Nano Banana Pro | 优秀 | 优秀 |
| Qwen-Image | 一般 | 良好 |
GLM-Image 在中文场景反超 GPT Image 2,这是国产模型在"中文理解"上的传统优势延续到了图像领域。
画面质感(GLM-Image 的短板)
- 光影与材质:GLM-Image 的写实人像仍有轻微"塑料感",不如 Nano Banana Pro 的照片级细节。
- 风格多样性:动漫、赛博朋克、水彩等非写实风格,表现中规中矩,不如 Midjourney V7 的审美爆发力。
- 复杂指令:多主体、多约束的复杂 prompt("三个人,左红右蓝中间绿,背景夕阳"),GLM-Image 偶尔会漏约束。
四、价格与可获取性
GLM-Image 的自部署和通过 API 使用图像模型是不同接入方式。选择 API 时,先核对当前目录中的图像模型 ID、对应端点与输出文件;本页没有验证 glm-4.6 的图像生成调用:
主流图像模型价格对比(含 Nano Banana Pro / GPT Image 2 / Seedream 5.0 等)
美元基准价 · token 价按每百万标注;其他计费方式见价格页
| 模型 | 厂商 | 类型 | 输入 | 输出 |
|---|---|---|---|---|
| gemini-3-pro-image | — | — | —/百万token | —/百万token |
| gemini-2.5-flash-image | — | — | —/百万token | —/百万token |
| doubao-seedream-5-0-260128 | — | — | —/百万token | —/百万token |
| gpt-image-2 | — | — | —/百万token | —/百万token |
| qwen-image-2.0-2026-03-03 | — | — | —/百万token | —/百万token |
选型建议
- 要中文文字 + 开源自部署 → GLM-Image 是目前唯一答案(金融/政企合规场景刚需)。
- 要中文文字 + 顶级画质 → Nano Banana Pro(以当前价格页为准)综合更强。
- 要英文文字 + 商用排版 → GPT Image 2(Arena 榜首)。
- 极致省钱 → 初代 Nano Banana(以当前价格页为准)或 Seedream 5.0(以当前价格页为准)。
五、适合谁用?
| 场景 | 推荐 | 理由 |
|---|---|---|
| 中文海报 / 信息图(自部署) | ✅ 强烈推荐 | 文字 SOTA + 数据不出域 |
| 金融 / 政企合规文生图 | ✅ 推荐 | 开源可审计、私有化部署 |
| 电商中文商品图 | ✅ 可用 | 文字准,但质感需后期 |
| 超写实人像 | △ 不推荐 | 画面质感落后旗舰 |
| 艺术创作 / 风格化 | △ 不推荐 | 风格多样性一般 |
总结
GLM-Image 是一个定位极其清晰的特长生:它不追求"全能最强",而是把"中文文字渲染"这个国产模型的痛点做到 SOTA。对于需要开源自部署、中文合规、且预算敏感的企业场景,它是当前最务实的选择。但如果你的需求是"画质优先"或"风格化创作",闭源旗舰仍然是更稳的选择。
国产开源模型在"中文理解"上的优势,终于从文本领域延伸到了图像领域。这是值得记录的一步。
本文能力数据来自智谱官方发布与公开第三方评测,价格为各平台公开值。
核对这个型号的请求与结果
本站绘制的内容说明图:本文是 GLM-Image 发布解读,未提供该型号的完整 apizt 请求示例。本图仅说明准确版本、当前通道接口与输入格式需分别核对,不把文字模型或其他图像型号的协议作为 GLM-Image 接口证明。
操作与使用问题
GLM-Image 中文海报文字应该怎么验收?
给模型一份固定文案清单,对照最终图逐字检查错字、漏字和数字。文字正确后再检查对齐、主体和阅读顺序,不能只凭整体观感判断。
GLM-Image 文字效果好就代表商品画质也好吗?
文字渲染与商品纹理、材质和参考一致性是不同检查项。使用同一商品参考图分别打分,保留失败样例,避免由一种优势推断全部画质。
把选好的模型,接入你的应用
从 Claude、GPT、Gemini 等模型中选择所需能力。获取 API Key,按工具配置接口地址,再用一个小请求确认结果和费用。
创建 API Key
在控制台创建令牌,选择需要使用的模型权限。
填写接入配置
按工具要求填写 API Key、接口地址与模型 ID。
发起第一次调用
确认收到有效结果,再到控制台查看用量与费用。
继续阅读
GPT-6 Astra 评测解读:推理基准、Computer Use 与证据
GPT-6 Astra 评测需要把推理基准和 Computer Use 分成各自的能力范围。本文整理既有公开资料;使用搜索或电脑工具前应确认客户端与通道,实际操作保留执行与恢复记录。
Wan 3.0 Video 评测解读:长镜头、音画与按秒费用
Wan 3.0 Video 评测应把长镜头、音画同步和参考素材的目标写成验收表。本文整理原有视频公开资料;榜单位置与当前通道稳定性不同,真实成片需下载播放并按时长核对费用。
DeepSeek V4 Pro 0813 评测解读:版本快照、长上下文与接口
DeepSeek V4 Pro 0813 评测按 0813 快照资料阅读稀疏注意力、长上下文和编码任务。快照名称与网关 ID 的关系必须单独核对,不能把公开原生 Responses 能力当作当前网关已透传。